不做生成、只做判断:TypeSafe 拿下 8.7 亿美元 A 轮,Jev 上线三周估值 75 亿
TypeSafe 完成 8.7 亿美元 A 轮,投后估值 75 亿美元。旗舰模型 Jev 9 月 15 日才发布——它不输出文本,只输出概率。a16z 领投、Sequoia 与 DCVC 参投,“判断”正在从“生成”中剥离,成为 agent 基础设施的新品类。
一笔需要读两遍的融资
2026 年的 AI 融资新闻已经多到让人麻木,但这一笔还是值得你把咖啡放下重读一遍:TypeSafe 宣布完成 8.7 亿美元 A 轮融资,投后估值 75 亿美元。领投的是 Andreessen Horowitz,Sequoia 参投,老股东 DCVC 继续加注,a16z 的 Martin Casado 直接进入董事会。
离谱的不是金额本身——今年比这大的轮次也有。离谱的是时间:Jev,TypeSafe 的旗舰模型,今年 9 月 15 日才发布。一个模型上线三周多,拿下近 9 亿美元,估值一步干到 75 亿。上一次看到这种节奏,还是 foundation model 刚爆发的那两年,OpenAI 和 Anthropic 轮番刷新纪录的时候。
公司自称,"a third of Fortune 500 companies are already using the model"——三分之一的财富 500 强已经在用 Jev。这句话先打个问号存着,后面我们会回来算这笔账。但资本市场显然已经投票了:a16z 的 infra 老将 Casado 亲自下场进董事会,说明在他们眼里这不是一次普通的模型发布,而是一条新赛道的开赛枪。Casado 是什么人?他是 a16z 基础设施投资的门面,投过 Databricks 那一挂。他的入场姿态等于在说:这家公司卖的不是模型,是基础设施。
还有一个被很多人忽略的细节:Jev 在 9 月 15 日上线当天,公司还同步拿了 DCVC 领投的 4000 万美元种子轮。种子轮的钱还没捂热乎,A 轮 8.7 亿就已经 close 了。二十多天,两轮融资,中间还隔着一个产品发布。这不是融资,这是资本在抢跑道,生怕上车晚了。
Jev 到底是什么:一台"判断机器"
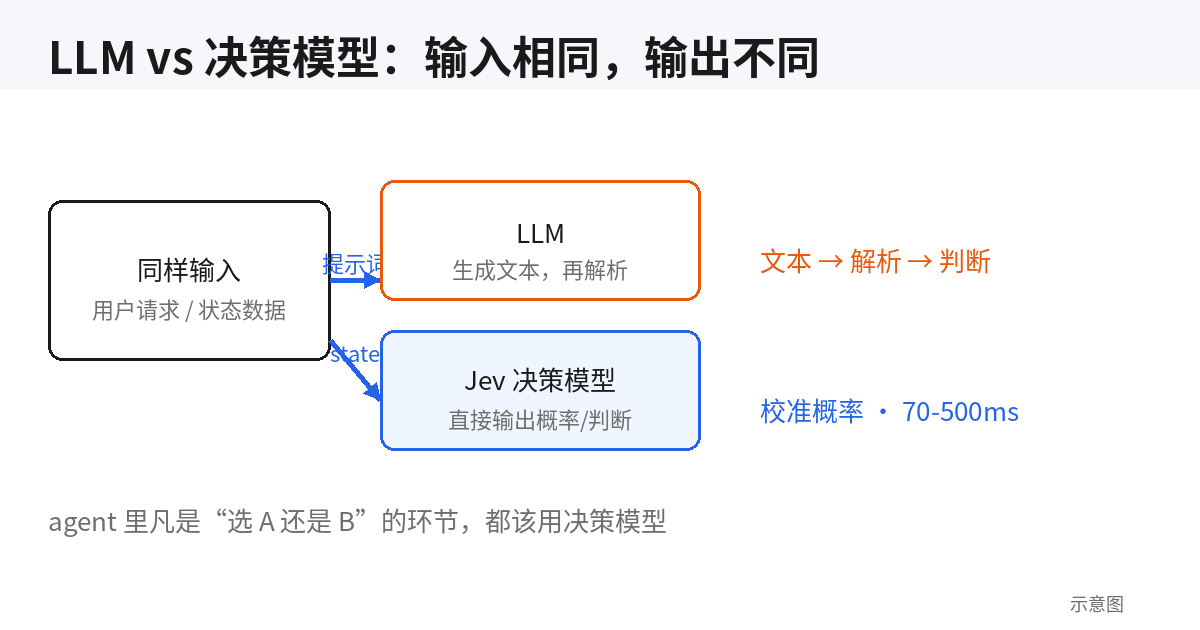
先把最重要的概念钉死:Jev 不是 LLM。它确实用的是 transformer 架构,但它不输出文本。它输出的是概率——公司自己的说法是"calibrated decisions",校准过的判断。
翻译成大白话:你给 Jev 一段上下文和一个问题,它不跟你写小作文,它直接告诉你"选项 A 的概率是 0.83,选项 B 是 0.12",或者"这条内容违规的概率是 0.07"。没有 token-by-token 的自回归生成,没有采样温度,没有"让我想想"。输入进去,判断出来,延迟在 70 到 500 毫秒之间。
这家公司 2024 年创立,三个创始人履历很正:Diogo Almeida 之前是 OpenAI 的研究员,Sasha Sheng 是前 Meta 研究工程师,还有 Erik Gafni。典型的"大厂核心研究员出来单干"剧本——但这次他们单干的方向不是"再做一个更强的生成模型",而是把生成这件事整个扔掉。
这个取舍值得品味。过去三年,几乎所有明星创业公司都在回答"怎么生成得更好":更长的上下文、更强的推理、更便宜的 token。TypeSafe 反其道而行之,问了一个被忽视的问题:agent 系统里真正高频的动作,到底是"写",还是"选"?他们的答案是后者——于是他们造了一台专门用来"选"的机器。
为什么这不是"又一个小模型"
过去两年,agent 圈子里有个公开的秘密:大家一直在用 LLM 干它不擅长的事。
想想你写的 agent 代码。意图路由:让 LLM 输出"A/B/C"再正则解析。内容审核:让模型生成"违规/合规"几个字再做字符串匹配。排序打分:让它吐出一串数字再 parse 成 float。RAG 里的重排:让模型给每篇文档打个分。Agent 里每一个"选 A 还是 B"的环节,背后都是一次完整的文本生成——几百上千个 token 生成出来,只为了提取其中几个比特的信息。
这相当于你为了称一下苹果多重,先把它做成苹果派,再从派里把苹果挑出来称。荒谬,但过去没得选:除了 LLM,没有别的模型能理解复杂上下文并给出判断。分类器太笨(只能处理固定 schema),LLM 太贵(为了几个比特烧掉几百个 token)。整个行业就卡在这个中间地带,凑合了两年。
Jev 的赌注是:"判断"值得成为一个独立的模型品类。就像当年推荐系统从搜索里独立出来、向量数据库从数据库里独立出来一样。当一个环节的使用频率足够高、形态足够特殊,它就不再是"LLM 的一个用法",而应该是一块专门的部件。历史总是押韵的:每一次基础设施成熟的标志,就是通用工具里长出专用工具。
这是我的判断:这是 agent 基础设施的范式转移,不是模型能力的渐进式提升。生成模型解决"怎么写",判断模型解决"选什么"。过去三年整个行业都在卷"怎么写得更好",而"选什么"这个环节一直裸奔——用生成模型客串,贵、慢、还不稳定。Jev 是第一个把"选什么"做成正经产品的人。品类一旦成立,后面跟进的就不是一家两家。
一个具体的场景
想象一个电商客服 agent。用户说"我的包裹三天没动了",agent 要先判断:这是物流查询、退货申请,还是投诉?以前的做法是把用户消息塞进一个 prompt,加几个 few-shot 示例,让 LLM 输出"物流查询"四个字,再用字符串匹配走分支。一次判断,800 个输入 token 起步,输出 10 个 token,延迟 1 到 2 秒,还时不时输出"这看起来像是物流查询呢"让你 parse 失败。
换成判断模型:输入就是用户消息加三个候选项,输出是三个概率,70 毫秒。没有 few-shot,没有 instruction 开销,没有 parse 失败,没有重试逻辑。省下来的不只是钱,还有一整层胶水代码和异常分支。
成本账:当 output 免费
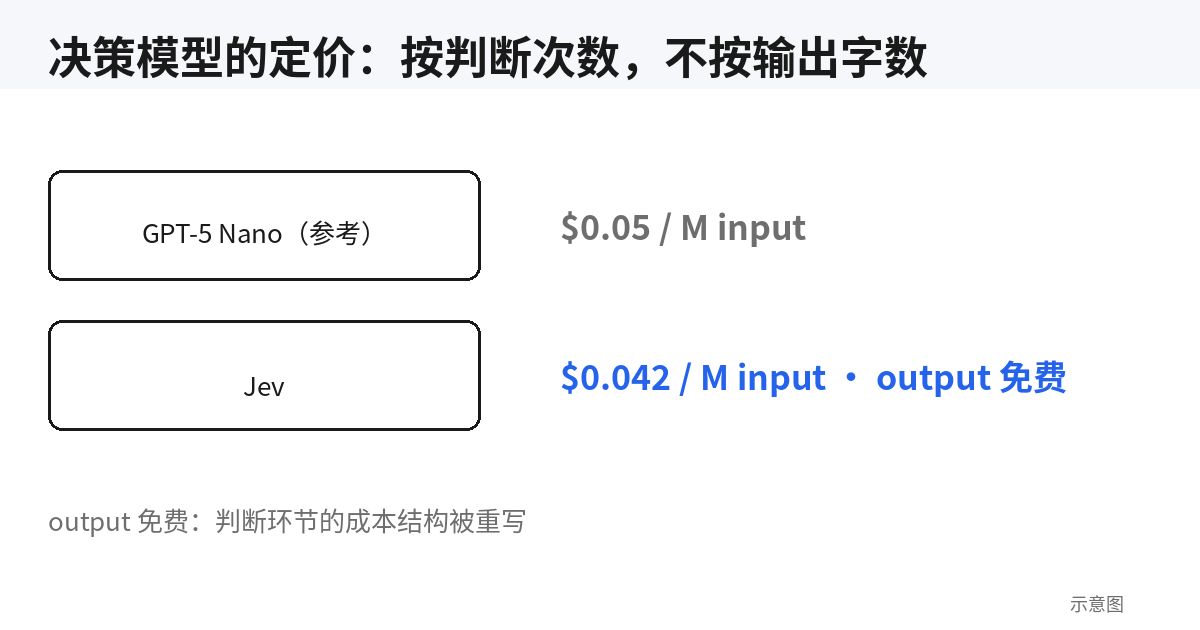
来看价格,因为价格才是这篇稿子里最锋利的部分。第三方资料显示,Jev 定价是每百万输入 token 0.042 美元,输出免费。对比一下:GPT-5 Nano 的输入价是 0.05 美元/M。Jev 比它还便宜,而且输出侧直接零元购。
算一笔具体的账。假设你的客服 agent 每天要做 10 万次意图分类:用 LLM 做,每次 prompt 加上 few-shot 示例算 800 token 输入、输出 20 token,一天就是 8000 万输入 token,按 GPT-5 Nano 的价格一天 4 美元,一个月 120 美元。换成 Jev:输入可能只需要 200 token(不需要 few-shot,不需要"请输出 JSON 格式"这种 instruction 开销),一天 2000 万 token,一天 0.84 美元,一个月 25 美元。省 80%,延迟还从秒级降到百毫秒级。
但这笔账真正的意思不在"省钱",而在成本结构被重写:按判断计价,而不是按 token 计价;输出免费,因为输出本来就不是产品,判断才是。这会改变 agent 的设计直觉——以前你会为了省 token 把多个判断塞进一次 LLM 调用里做 batch,现在你可以奢侈一点:每个环节都调一次判断模型,又快又便宜。架构会从"能省则省"变成"该调就调"。
还有一个隐性成本:稳定性税。用 LLM 做判断,你得写"解析失败重试"的逻辑,得处理模型偶尔的发挥失常,得为每个判断环节写测试用例覆盖各种输出格式。这些工程成本不会出现在账单上,但每个 agent 团队都在交。判断模型输出的是结构化概率,这笔税直接免了。
我的判断是:未来 12 个月,"单次任务的决策成本"会成为 agent 团队的核心指标,就像今天大家盯着 token cost 一样。而第一批把路由、分类、打分环节从 LLM 迁移到判断模型的团队,会获得实实在在的成本和延迟优势——这不是理论优势,是下个月账单上就能看到的数字。
追兵已经全部出发
一个品类是不是真品类,看有没有人跟进。Jev 这边枪声一响,追兵来得比预想中快得多:
- OpenAI 紧急跟进 Decisions API——当老大开始抄你的作业,说明作业是对的。OpenAI 的入场等于给"判断模型"这个品类盖了个官方认证章,也意味着这条赛道从"创业公司讲故事"变成了"巨头必争之地"。
- Perplexity 不仅跟进,还直接把 27B 参数的 Decider 开源了(这事我们另写了一篇:六天降价一半,价格战已经开打)。开源玩家的入场,把"判断模型"的门槛从"调用 API"降到了"自己部署"。
- Cloudflare、AWS 也在入场——这两家的出现最有信号意义。它们不做模型,它们做水电。当云厂商开始卖"判断"这种水电,说明这个品类正在进入基础设施标配序列,就像当年的向量检索、对象存储一样。
注意这个跟进速度:Jev 9 月 15 日发布,10 月 9 日融资官宣时,对手们已经全部下场。一个三周大的品类,长出了完整的竞争格局。这在 AI 历史上都少见——通常一个新品类要经历 12 到 18 个月的"只有一家在讲故事"阶段。
为什么这么快?因为需求是现成的,不需要教育市场。每个 agent 团队的代码库里都躺着几十个"让 LLM 输出选项再解析"的 hack,Jev 只是第一个把这坨 hack 产品化的人。对手们跟进的不是 Jev 的技术,而是 Jev 指出来的那个位置:agent 架构里"判断层"那个空位。空位一旦被看见,所有人都会往里挤。
给开发者的信号:你代码里"选 A 还是 B"的地方正在变成标准件
说点能直接动手的东西。今晚你就可以对自己的 agent 代码库做一次"判断审计":
- 凡是 prompt 里写着"请只输出 A/B/C"、"请输出 1 到 10 的分数"、"请回答是或否"的地方——那就是一次判断调用,被你用生成模型高价代打了。
- 凡是后面跟着正则、JSON 解析、字符串匹配来提取模型输出的地方——那就是解析开销,是本来不该存在的胶水代码。
- 凡是加了"如果解析失败就重试"逻辑的地方——那就是生成模型做判断不稳定的税,你一直在交,只是没记账。
这些环节正在变成标准件。就像你今天不会自己写 HTTP 解析器、不会自己实现连接池一样,明年你大概也不会自己用 LLM prompt 拼一个分类器。判断模型的 API 长什么样,agent 框架的中间层就会长什么样——LangChain、CrewAI 这些框架的下一个大版本,大概率会原生支持 decision model 作为一等公民。
我的具体建议:新项目直接按"生成层 + 判断层"双层架构设计,路由、分类、打分、审核走判断模型,写作、总结、代码生成走 LLM。老项目别一次性全迁,先挑调用频率最高的 1 到 2 个判断环节做迁移试点,跑两周对比成本和延迟。判断模型的生态还在早期,API 形态可能还会变,但方向不会变——早试点,早拿到数据。
质疑同样要说在前面
把掌声放一放,质疑有三条,每条都硬。
第一,"三分之一财富 500 强在用"是公司自称,没有第三方审计。Jev 上线才三周,三分之一的 500 强完成采购、集成、上线?这个速度即使对免费产品都夸张。更可能的口径是"有员工注册试用就算在用"。资本可以为故事付费,但你做技术选型时要按最严的口径打折——先当成"有几十家大企业在试点"来理解。
第二,75 亿美元是期望定价,不是验收定价。三周时间,任何关于留存、续费、expansion 的数据都不存在。a16z 赌的是"判断层"这个品类的终局位置:赌赢了,75 亿是地板价;赌输了,就是一轮游。别把估值当成技术验证——估值验证的是资本的焦虑,不是产品的成熟度。
第三,护城河问题。输出概率分布、校准——这些是工程 know-how,但有多深?Perplexity 六天就拿出了 85.71% 对 84.51% 的自报成绩(见我们另一篇),开源权重一放出来,"校准"这件事的神秘感就去掉一半。判断模型可能比 LLM 更快进入 commodity 阶段:它的输出空间小、评测标准清晰——好测量的东西,就好被追上;好被追上的东西,就难收垄断租。
但这三条质疑都不动摇我的核心判断:品类是真的,估值是赌的。对开发者来说,重要的不是 TypeSafe 值不值 75 亿,而是从今天起,"判断"有了专门的模型为你服务,而你代码里那些用 LLM 生成文本再解析的环节,正在变成上一代的做法。至于是用 Jev、Decider 还是 Cloudflare 的 Clef——选型指南我们另一篇细说。
生成模型教会机器写作,判断模型正在教会机器做决定。Agent 的下半场,可能从"写得更好"变成"选得更准"。而这一次,率先把"选"做成独立生意的人,三周就拿到了 8.7 亿美元。
本文一手来源:TechCrunch 10 月 9 日报道(Bloomberg 同日首报,公司官方公告同步)。
原始来源
相关文章
蝴蝶效应完成超 5 亿美元融资,博裕、IDG 领投,腾讯、红杉中国、真格加持,目标估值约 40 亿美元。从 Meta 20 亿美元收购告吹到恢复独立一个月,Manus 2.0 与个人智能体 Cue 同步发布,国产通用 Agent 上演绝地反弹。
Perplexity 发布开源决策模型 Decider:27B 参数、Apache 2.0,V1 定价 0.04 美元/M,六天后 V1.1 降到 0.02 美元/M。自报基准 85.71% 对 Jev 的 84.51%,“闭源 vs 开源”的剧本在新赛道重演。
智谱旗舰模型 GLM 5.3 在 Amazon Bedrock 上正式 GA:753B 参数 MoE、百万 token 上下文,CyberGym 安全基准拿下 84.5 的领先分数。AWS 甚至用它默认驱动的开源渗透测试 agent Strix 做了一场授权安全测试演示。背后是按调用量分成的 revenue share 模式——中美模型同在一个云货架上售卖,消息传出后智谱港股涨超 7%。