NVIDIA 开源“双金牌”炼丹配方:Nemotron IOI 超人类最高分、2.2 万道编程题训练集全公开
NVIDIA 的 Nemotron 系统在 IOI 2026 拿下 535.4/600(非官方跑分,超过人类最高分 498.27)、在 IMO 2026 拿下 30/42(官方阅卷,越过 29 分金牌线),并把整套配方全部开源:SFT 与 RL 的 checkpoint、两份训练数据集、全新的 200 道奥赛级数学 benchmark、推理管线与 prompt。核心方法是模型、数据、推理循环的协同设计:GenCorrect 的生成-评估-改进循环把 291 分的模型推过 438.3 的金牌线。对一人公司而言,这是一份生产级的测试驱动 agent 循环模板。
奖牌是标题,配方才是正文
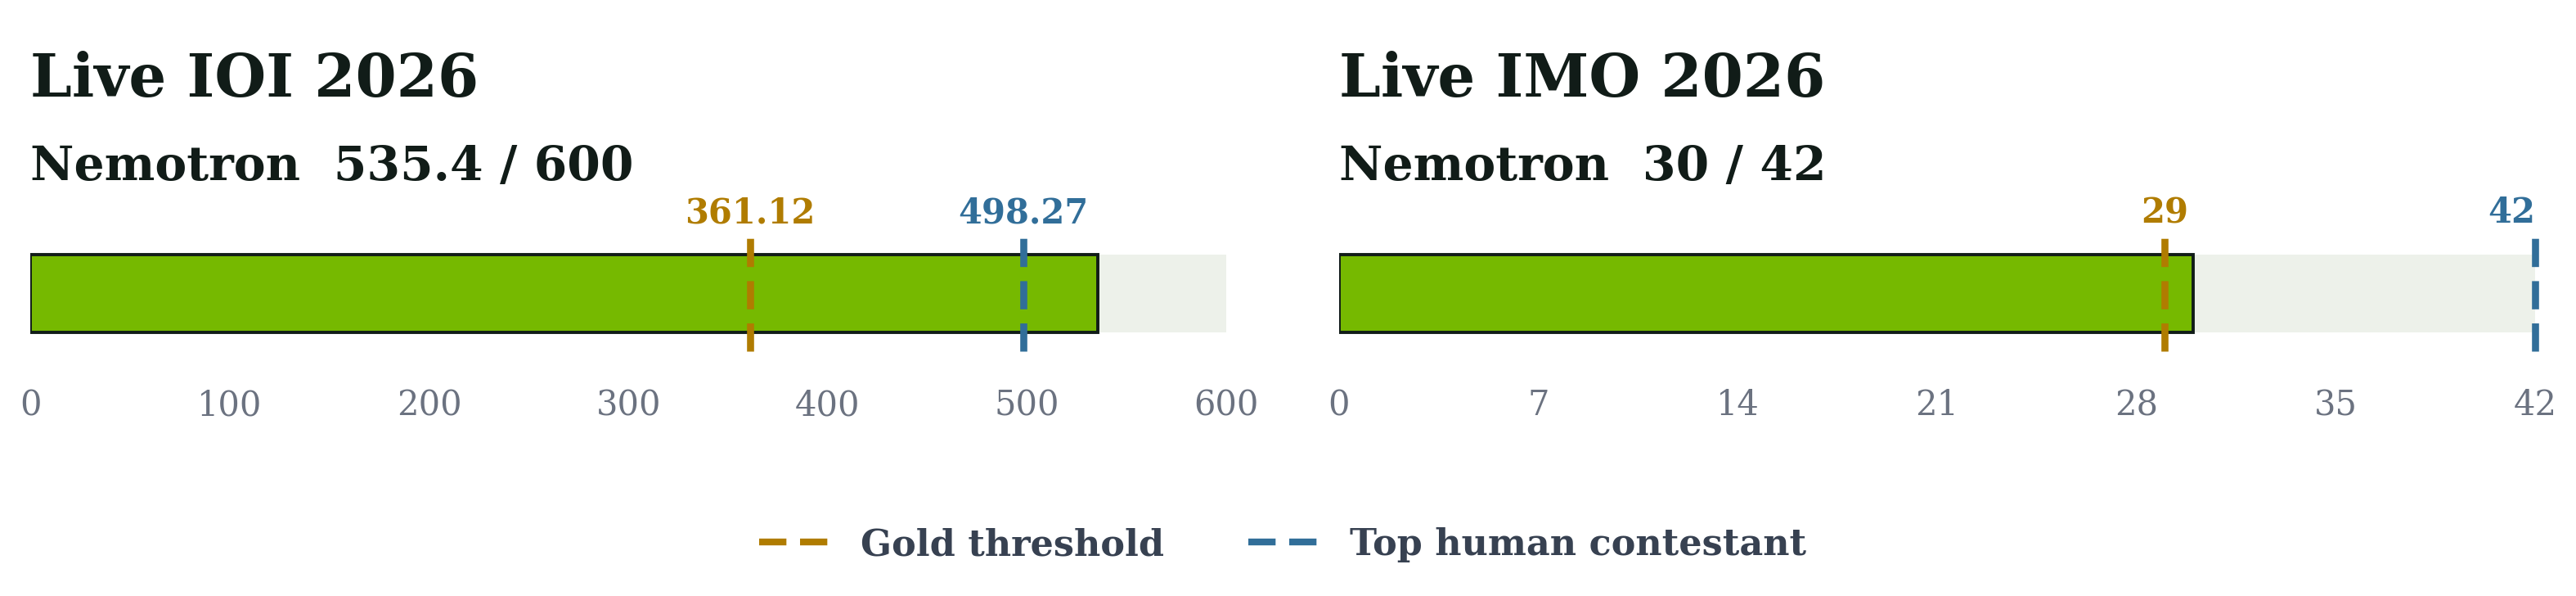
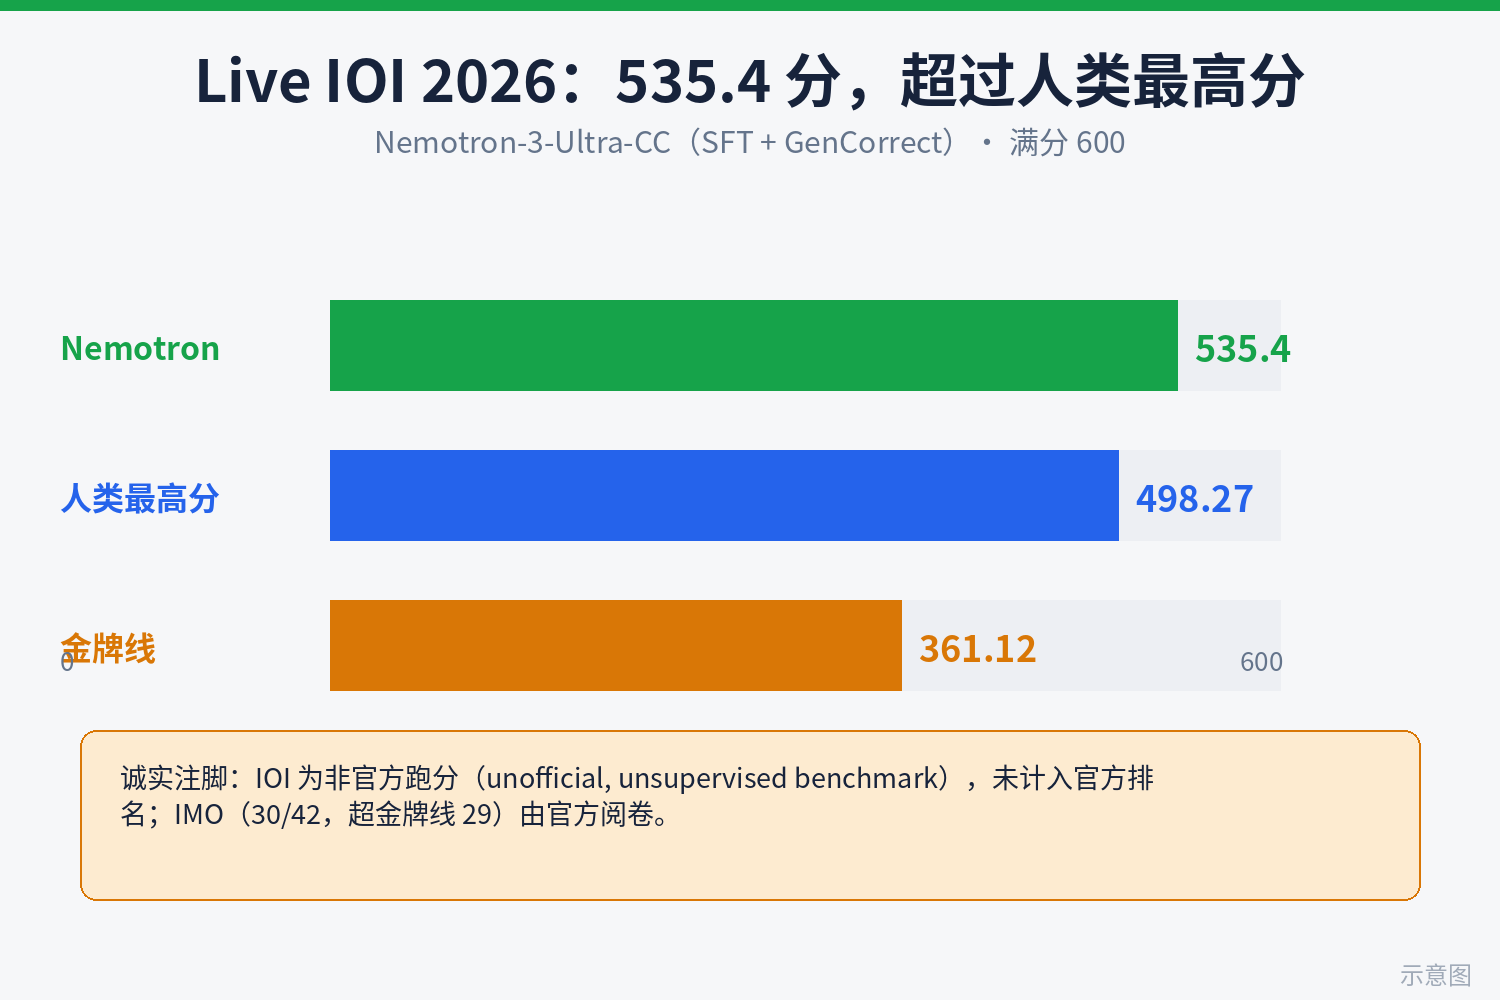
先把最刺激的数字摆出来:IOI 2026,Nemotron-3-Ultra-CC 拿了 535.4/600。金牌线是 361.12,而当年全场人类选手的最高分是 498.27。机器不仅越过了金牌线,还把人类最高分甩在身后近 37 分。同一周的另一条战线,IMO 2026,Nemotron 系统 30/42,越过 29 分的官方金牌线。
但这不是一篇"AI 又赢了人类"的爽文。恰恰相反——如果你只盯着奖牌看,你会错过这篇 Hugging Face 博客(NVIDIA 团队发布)里真正值钱的东西:他们把整套炼丹配方开源了。SFT 和 RL 的 checkpoint、两份训练数据集、一个全新的 200 道奥赛级数学题 benchmark、推理管线、prompt、甚至 IMO 提交的证明原文,全部公开。
对 VibeFix 的读者来说,这才是重点。我们不缺"某某模型又破纪录"的新闻,缺的是一份可复用的、把通用基座炼成领域专家的完整手册。NVIDIA 这次给的,正是这个。
先说一个需要透明交代的细节:博客页面本身没有显式日期戳。"2026 年 10 月 7 日"这个日期来自 smartchunks、tpsreport 等多家媒体的交叉确认——它们都写道 "NVIDIA published a report on Hugging Face on October 7, 2026"。我采用这个日期,但如实告诉你它的来源。
两块"金牌",含金量各不相同
先做阅读理解,因为这两块金牌的"官方程度"完全不一样,混为一谈就是标题党。
IOI 那块,是"准金牌"。原文写得非常诚实:"It was an unofficial, unsupervised benchmark and was not included in the official IOI ranking." 翻译一下:这是一次前瞻性的实况跑分,机器和人类选手遵守同样的时间、断网、提交次数限制,但成绩没有计入 IOI 官方排名,也没有现场监督。所以"超人类最高分 498.27"是真实的数字对比,但它不是官方纪录。NVIDIA 自己把这句话放在成绩表下面第一段——这种诚实值得一个赞,也提醒我们:看 AI 竞赛新闻,第一件事永远是看脚注。
IMO 那块,是"真金牌"。"The IMO system's submitted proofs were graded by official IMO graders." 提交的证明是 IMO 官方阅卷人打的分,30/42,超过 29 分的官方金牌线,6 道题里 4 道拿了满分。注意这套系统"worked in natural language, with no formal prover, external tools, or internet access"——纯自然语言,没有形式化证明器、没有外部工具、没有联网。也就是说,它是用"人话"写证明、被人类的阅卷标准判了金牌。
一个非官方跑分、一个官方阅卷——这个区分不是公关话术,是理解整件事的钥匙。它告诉你:代码竞赛靠的是"生成-运行-修正"的工程闭环,而数学证明靠的是"生成-批判-改进"的推理闭环。两种闭环,同一个思想,NVIDIA 把它们做成了同一套方法论。
四步配方:奖牌不是炼出来的,是"拼"出来的
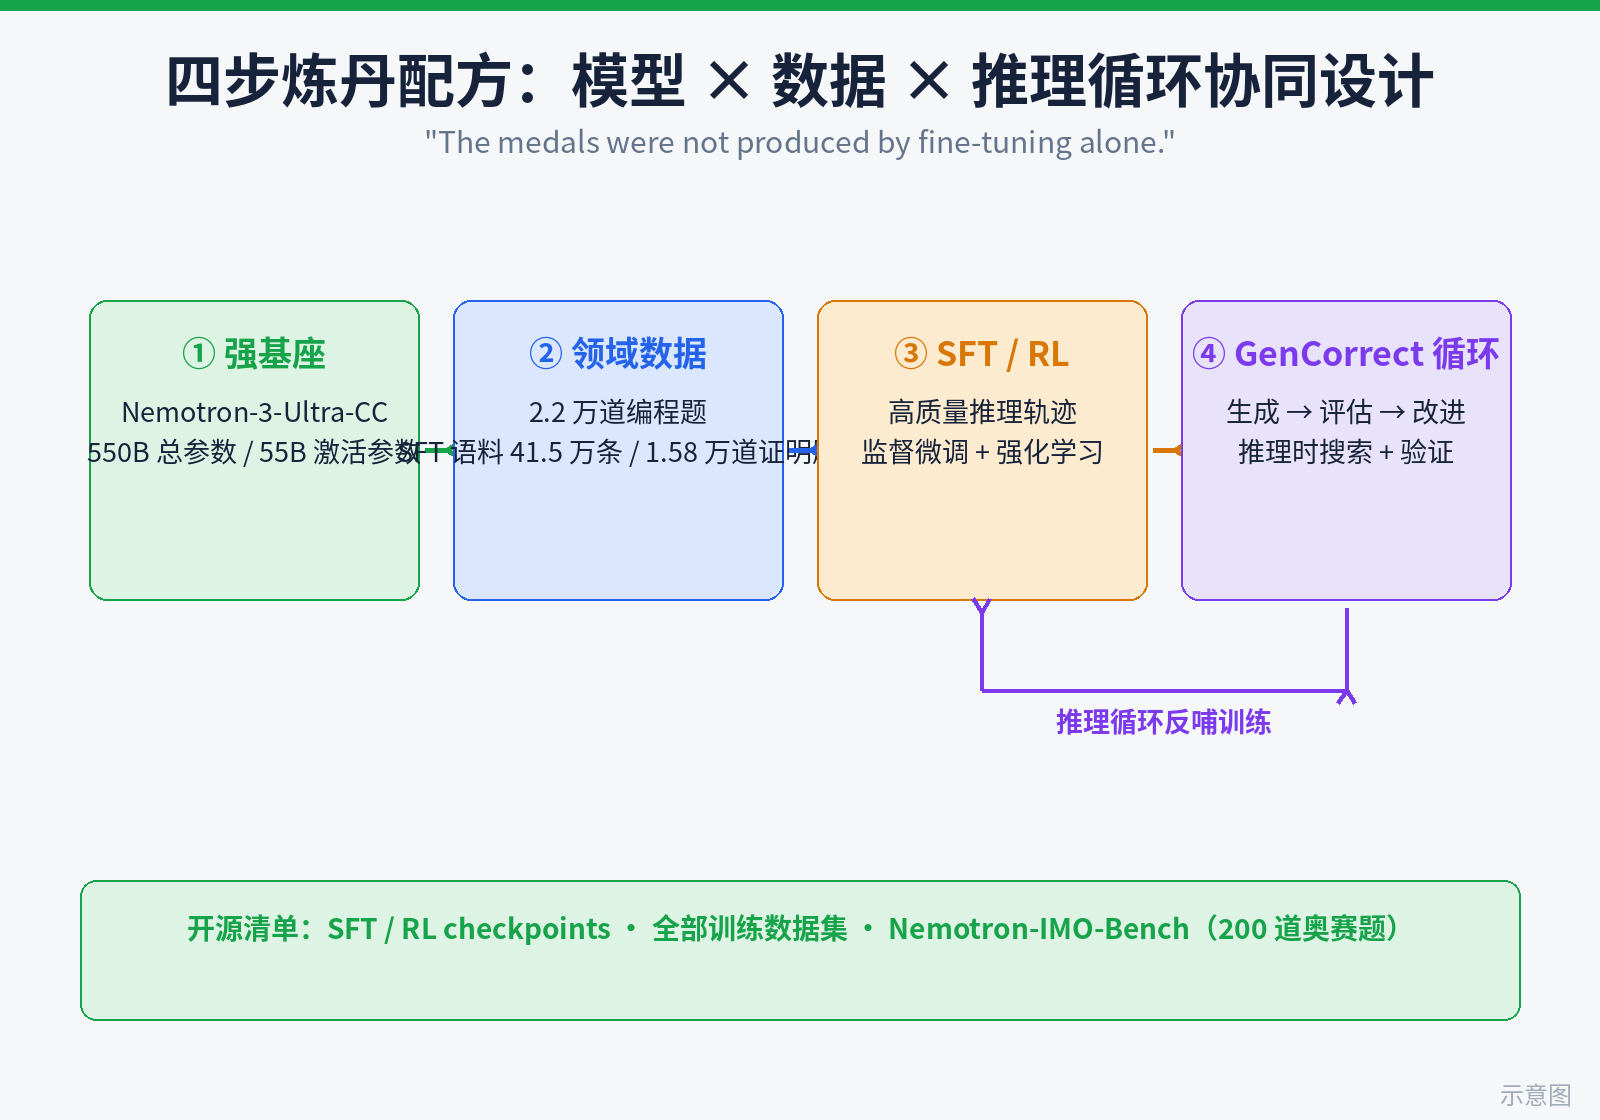
博客里最值得抄的一段,是 NVIDIA 自己总结的"a reusable specialization recipe"(可复用的 specialization 配方)。四步:
第一步:从一个强的基座出发。两边用的都是 Nemotron 3 系列。编程侧是 Nemotron-3-Ultra-CC(5500 亿总参数、550 亿激活参数)和 Nemotron-3-Nano-CC(300 亿总参数、30 亿激活参数);数学侧是 Nemotron 3 Ultra。没有为每个比赛从头训一个 foundation model——"We did not need to build a new foundation model for every challenge. We specialized Nemotron for the task."(我们不需要为每个挑战重建一个基座模型,我们把 Nemotron 特化到任务上。)
第二步:准备领域问题 + 高质量推理轨迹。编程侧精选了 22,000 道题目并生成合成推理轨迹;数学侧的 SFT 语料是 414,890 条质量过滤后的样本,覆盖 15,818 道不同的证明题。注意这个数字的量级:不是"几百万条通用数据",而是"一万五千道高质量证明题、每题多条轨迹"。质量密度比数据量重要。
第三步:标准后训练,SFT,必要时加 RL。没什么黑魔法,就是 SFT + RL。但有一个反直觉的发现:对更强的 Ultra 模型,只做一轮 SFT epoch,效果就超过了完整后训练(SFT+RL)的 Nano 模型——在 IOI、ICPC、LiveCodeBench Pro 上全面超越。基座越强,特化越便宜。这对预算有限的团队是个好消息:选对基座,比堆后训练轮数重要。
第四步:给专家模型配一个"生成-评估-改进"的推理循环。编程侧叫 GenCorrect,数学侧叫 generate-verify-refine。IOI 2025 的数据最能说明问题:Nano 模型后训练前 130 分,SFT 后 280,RL 后 291——然后 GenCorrect 一开,468 分,直接越过 438.3 的金牌线。Ultra-CC 同样策略拿到 502。也就是说,推理时循环带来的提升(291→468),比 SFT+RL 加起来(130→291)还要大。
金句背后的方法论:co-design
博客里有一句我认为是全文的题眼:"The medals were not produced by fine-tuning alone, and they were not produced by brute-force sampling alone. They came from co-designing the model, the data, and the inference loop."(奖牌既不是单靠微调炼出来的,也不是单靠暴力采样 brute force 撞出来的。它们来自模型、数据、推理循环三者的协同设计。)
这句话是在点名批评两种流行的偷懒思路。第一种是"微调万能论":找个开源模型,喂点领域数据 SFT 一下,就指望它变成专家。第二种是"采样万能论":模型不行就多采样,best-of-N 抽几千次,总有一个能过。NVIDIA 的数据说:单用任何一种都到不了金牌。Nano 的 SFT+RL 只到 291,离金牌线 438.3 还差得远;是 GenCorrect 的迭代循环把 291 推到了 468。
更细的洞察在 IMO 那边:用互补的 SFT 和 RL checkpoint 组合,比从单个 checkpoint 暴力多采样更有价值。SFT 版第一轮搜索最强,RL 版单 checkpoint 总体最优,两者能力互补,最终系统把通用模型、SFT 专家、RL 专家三个一起用。翻译成工程语言:多样性比数量重要。一个能批判、一个能构造、一个打底——这已经是一个微型"委员会"了。
我的判断是:2026 年的模型竞争,正在从"训更大的基座"转向"设计更好的推理循环"。基座越来越商品化(连 NVIDIA 都在说不需要为每个挑战重建基座),真正的差异化在数据配方和推理时的系统设计上。这篇博客的价值在于,它把"系统设计"这一层彻底摊开给你看——管线、prompt、证明原文全在 NeMo-Skills 仓库里。
给一人公司的启示:GenCorrect 是"测试驱动的 agent 循环"的学院派版本
说点能直接用的。GenCorrect 的本质是:生成候选 → 用某种方式评估(跑测试、打分、批判)→ 针对反馈改进 → 重复。对做 AI 编程工作流的一人公司来说,这不就是你每天在写的东西吗?
你的 agent 写完代码跑测试,测试挂了,把报错喂回去让它修,修完再跑——这就是 GenCorrect 的草根版。NVIDIA 的版本只是在三个地方做得更讲究:第一,评估器本身也是训出来的(IMO 的数据覆盖了 proof generation、refinement、verification、meta-verification,模型学会了"判断证明是否完整");第二,候选是多样化的(多个互补 checkpoint 并行生成);第三,改进是结构化的(先打分、再批判、再精修最有希望的几个,而不是无脑重试)。
所以可借鉴的清单很具体:
- 把"验证器"当成一等公民来建设。大多数人的 agent 循环里,验证就是"跑一下测试看看"。NVIDIA 的做法是专门训练模型去做 verification 和 critique。对一人公司来说,低成本版本是:为你的核心任务写一套高质量的评测集 + 让一个独立的模型实例专门做代码评审(reviewer 和 generator 用不同的 prompt 甚至不同的模型)。
- 多样性优先于采样量。与其让同一个模型抽 20 次,不如用 2-3 个不同配置/不同 prompt 策略的实例各抽几次,再做筛选。IMO 的经验证明了这一点。
- 基座选择比后训练投入更重要。Ultra 一轮 SFT 超过 Nano 完整后训练——映射到你的工作流就是:先花时间选对主力模型,而不是在提示词上雕花。提示词工程有天花板,基座选择决定地板。
- 记录你的"推理轨迹"。NVIDIA 的 22,000 道题和 414,890 条证明样本,本质上是把"好过程"沉淀成数据。你在日常开发里 agent 成功解决的疑难杂症——报错、修复过程、最终方案——都是你的领域轨迹。攒下来,未来就是你微调自己专属 coding 助手的数据。
这不是鸡汤。NeMo-Skills 仓库里有 IMO 推理管线的完整实现和 prompt,你可以直接去读它的 generate-verify-refine 是怎么编排的——这是大厂第一次把"金牌级 agent 循环"的源代码级实现摆到台面上。以前这类东西只存在于论文的伪代码里。
冷水:四盆,逐盆浇
第一盆:"训练和推理开销都很大"(substantial)是原文自己承认的。5500 亿参数的模型做 SFT,再配多轮 GenCorrect 推理——这不是你笔记本上能复现的量级。配方是公开的,算力账是自己的。读这篇博客的正确姿势是学"设计思想",不是照抄"参数规模"。
第二盆:IOI 成绩的"非官方"属性决定了它的上限。 unsupervised、无现场监督的跑分,在竞赛严肃性上天然低一档。NVIDIA 诚实地写了,媒体转述时却经常把这句脚注吞掉。你在引用"535.4 超人类最高分"时,请一定带上"非官方跑分、未计入官方排名"这个定语——这是专业性的分水岭。
第三盆:IMO 的 30 分是"系统"的成绩,不是"模型"的成绩。generate-verify-refine 系统 + 高算力筛选 + 三个 checkpoint 协同,才拿到 30/42。裸模型单次生成是什么水平?博客没说。不要把系统成绩误读成模型能力——这正是 co-design 思想的另一面:能力存在于系统里,不在单个 checkpoint 里。
第四盆:开源不等于开箱即用。checkpoint、数据集、benchmark、管线都在 Hugging Face 和 GitHub 上,但把它们跑起来、适配到你的领域,依然是工程活。NVIDIA 开源的是"配方和食材",不是"预制菜"。不过话说回来,在此之前,大厂连配方都不给看——从 0 到 1 的这一步,已经足够珍贵。
为什么这件事值得一个头条
过去两年,AI 竞赛新闻的叙事模板是固定的:某大厂模型在某竞赛拿了好成绩,论文挂 arXiv,代码"coming soon"。NVIDIA 这次把模板撕了:成绩、checkpoint、训练数据、benchmark、推理管线、prompt、提交的证明——全公开。这不是一次 PR,而是一次基础设施投放:Nemotron-IMO-Bench 那 200 道奥赛级题目,从今天起就是所有数学推理模型的公共考场;22,000 道编程题的合成轨迹方法,就是所有 coding specialist 的参考实现。
更深一层,这是 NVIDIA 在下的一盘棋:把 Nemotron 定位成"最好特化的基座"。"Easy to fine-tune should mean more than making a checkpoint trainable"——好微调不应该只意味着 checkpoint 可训练,而应该意味着有一套清晰可复用的配方。当每个团队都用 Nemotron 的配方炼自己的专家模型时,Nemotron 生态就成了事实标准。开源配方是最聪明的生态建设。
对 VibeFix 的读者,我的建议只有一句话:去把 NeMo-Skills 仓库里 IMO 的推理管线读一遍。不是让你去复现 IMO 金牌,而是让你看看,一套"生成-评估-改进"的生产级循环在代码层面长什么样——prompt 怎么写、批判和精修怎么分工、多 checkpoint 怎么协同。你 agent 工作流里缺的那块拼图,很可能就藏在那几百行代码里。
奖牌会褪色,配方不会。这次 NVIDIA 给的不是奖杯,而是一本打开的菜谱。
本文一手来源:Hugging Face 官方博客(NVIDIA 团队),One Model Family, Two Gold-Level Results: Fine-Tuning Nemotron for IOI and IMO。博客页面本身无显式日期戳,2026 年 10 月 7 日的发布日期来自 smartchunks、tpsreport 等多家媒体的交叉确认("NVIDIA published a report on Hugging Face on October 7, 2026")。相关论文与代码:IOI / IMO 的 arXiv 论文、NeMo-Skills GitHub 仓库(含 IMO 推理管线、prompt 与提交证明)、Hugging Face 上的 Nemotron Labs IMO 2026 collection(含 SFT/RL checkpoint、两份训练数据集与 Nemotron-IMO-Bench)。
原始来源
相关文章
Perplexity 发布开源决策模型 Decider:27B 参数、Apache 2.0,V1 定价 0.04 美元/M,六天后 V1.1 降到 0.02 美元/M。自报基准 85.71% 对 Jev 的 84.51%,“闭源 vs 开源”的剧本在新赛道重演。
智谱旗舰模型 GLM 5.3 在 Amazon Bedrock 上正式 GA:753B 参数 MoE、百万 token 上下文,CyberGym 安全基准拿下 84.5 的领先分数。AWS 甚至用它默认驱动的开源渗透测试 agent Strix 做了一场授权安全测试演示。背后是按调用量分成的 revenue share 模式——中美模型同在一个云货架上售卖,消息传出后智谱港股涨超 7%。
Prime Intellect 让 Prime Agent 编排出 2000+ 个 agent,花两周把自己从 TypeScript 完整重写为 Rust,动用 10000+ 沙箱、烧掉 2000 亿+ token。真正的看点不是 14 倍提速,而是诚实的方法论:不写代码的根 agent、验证与实现分离,以及公开承认“通过脚本化等价测试不等于生产就绪”。