Meta 首个 frontier 模型 Muse Wonder:编码基准反超 Opus 5.5,最强版只卖 Muse Code 订阅
Meta Superintelligence Labs 发布公司首个 frontier 模型系列 Muse Wonder 与 Wonder Full:自测 SWE-Marathon 57.5% 反超 Opus 5.5 的 46.3%,但第三方 Artificial Analysis 综合指数仍以 56 对 58 落后;标准版 API 定价 4/20 美元,最强版只给 Muse Code 订阅用户,且默认拿你的代码训练下一代模型。
Meta 终于交出了自己的 frontier 答卷。当地时间 2026 年 10 月 12 日,由 Alexandr Wang 掌舵的 Meta Superintelligence Labs(MSL)发布了公司首个 frontier 模型系列:Muse Wonder 和加强版 Muse Wonder Full。这是 Meta 自 2025 年 8 月重组 AI 团队、成立 MSL 以来的第一次"顶级模型"发布,也是它第一次在公开场合承认:最强的模型,不再免费,也不再开放。
这件事对 vibe coder 之所以重要,不只是"又多了一个能写代码的模型"。Wonder 系列的发布方式——最强版只走订阅、默认拿你的代码训练下一代模型、闭源不放权重——正在改写编码 AI 的商业规则。而它的成绩单,则是一次关于"厂商自测到底有几分可信"的现场教学。
发布了什么:两个版本,两种卖法
Wonder 系列一共两个成员。标准版 Muse Wonder 走 Meta Model API(模型标识 muse-wonder-1.0),约 100 万 token 上下文,支持文本、图像、音频、视频输入。加强版 Muse Wonder Full 以"最大推理力度"运行,是 Meta 口中"迄今最强"的模型,但它不上 API——只提供给 Muse Code 编程助手的付费订阅用户。
定价上,标准版 Wonder 是每百万 token 输入 4 美元、输出 20 美元,缓存输入 0.2 美元。这个价目表和 Claude Opus 5.5 完全同档,而 GPT-6 Astra 与 Claude Fable 5.1 的挂牌价是 10 美元 / 50 美元。换句话说,Meta 把 Wonder 直接摆进了"premium frontier"价格带,而不是延续 Muse Spark 1.3 时期 1.25 美元 / 4.25 美元的便宜路线。Zuckerberg 在 X 上说,Wonder 是比 Muse Spark"大得多、先进得多的新一代模型"——定价也确实翻了三倍多。
Wonder Full 的获取方式更有意思:Power Usage 档 50 美元/月(20 倍于 Everyday 档的用量),Maximum Usage 档 200 美元/月(80 倍用量)。想用上 Meta 最强的编码能力,先成为 Muse Code 的订阅用户。这是整场发布里最值得玩味的商业设计,我们后面细说。
技术上,两个模型都在 Meta 位于俄亥俄州的 Prometheus 数据中心训练——Meta 称之为吉瓦级(gigawatt-scale)算力集群,延续了 Muse Spark 1.3 的"大规模预训练 + 强化学习"路线。它们同时也是 Meta 个人 AI 助手 Muse 的新引擎。Meta 在 9 月推出的 Muse 助手下载增长已经放缓(《华尔街日报》数据),Wonder 被寄予了"让用户回来"的厚望。
成绩单:Meta 自测很漂亮,第三方评估更克制
先看 Meta 官方模型卡里的数据,这是整场发布最抓眼球的部分:
- SWE-Marathon(长周期软件工程):Wonder Full 57.5%,Claude Opus 5.5 46.3%,GPT-6 Astra 42.5%——领先超过 11 个百分点;
- DeepSWE v1.1(软件工程):Wonder Full 79.0%,Opus 5.5 74.2%,GPT-6 Astra 74.1%——反超;
- Harvey LAB-AA(法律任务):Wonder Full 13.1,Opus 5.5 只有 4.2;
- AutomationBench(业务自动化流程):Wonder Full 45.4,Opus 5.5 41.2,GPT-6 Astra 41.6。
但同一张表里也有 Meta 没大声宣传的行:Terminal-Bench 4.0 上 Opus 5.5 以 59.6 领先 Wonder Full 的 57.1;HealthBench Pro 上 Opus 5.5 以 65.6 领先;JobBench 专业任务上双方 75.3 对 75.4,基本打平。也就是说,Wonder Full 赢的是"长周期、跨应用"的 agent 型任务,输的是终端操作和知识问答这类短平快任务——这恰好和它的产品定位(长周期 agent)互相印证,倒也算表里如一。
真正的冷水来自第三方。独立评估机构 Artificial Analysis 的 Intelligence Index(综合推理、知识、编码、专业任务十项评估)给出:Opus 5.5 58 分第一,Wonder Full 56 分(与 Claude Sonnet 5.5 并列),GPT-6 Astra、Gemini 4 Argon、Claude Fable 5.1 都是 53 分,标准版 Wonder 52 分。综合实力上,Opus 5.5 依然领先,Wonder Full 是"接近前沿",不是"登顶前沿"。
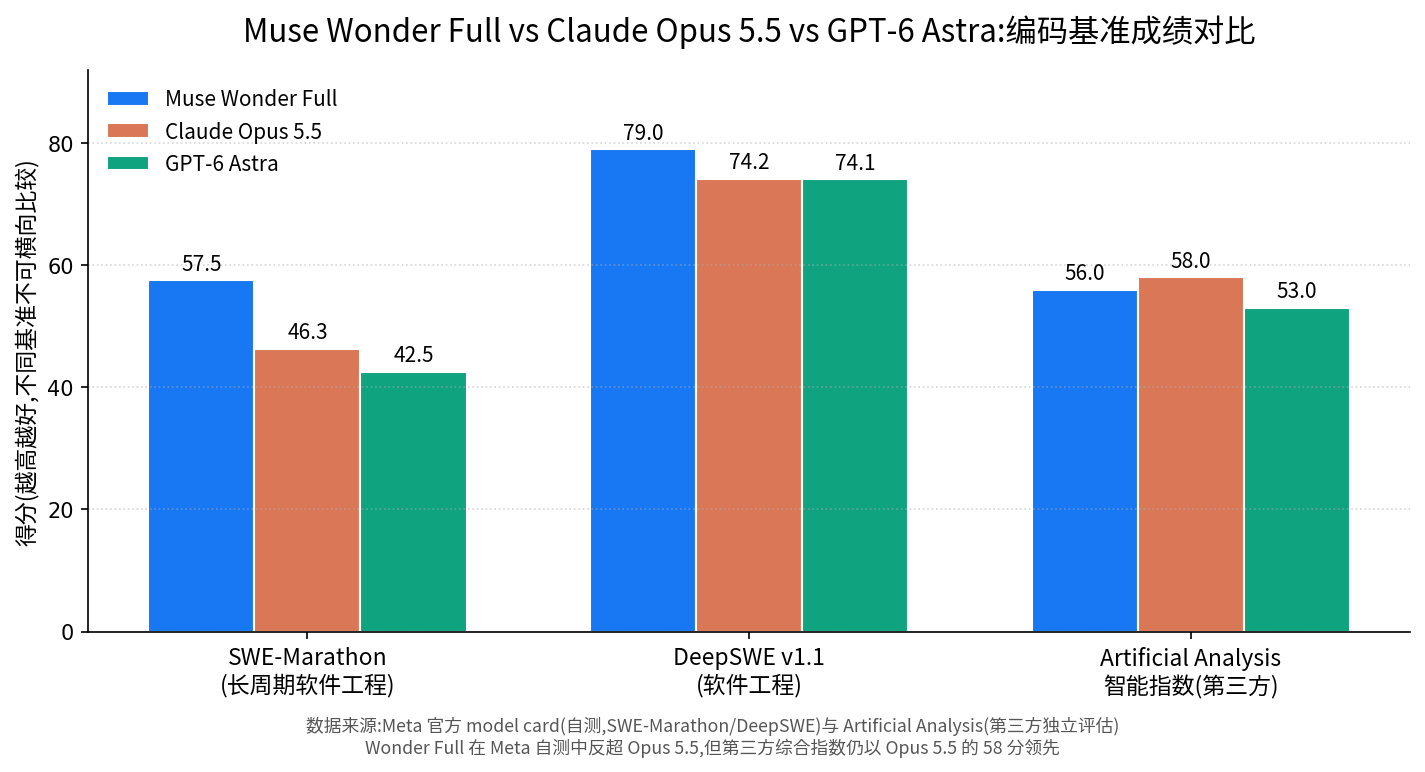 自测与第三方评估的落差:Wonder Full 在 Meta 自测的 SWE-Marathon、DeepSWE 上反超 Opus 5.5,但在 Artificial Analysis 第三方综合指数上仍以 56 对 58 落后。数据来源:Meta 官方 model card(自测)与 Artificial Analysis(独立评估)。
这里必须诚实地标注方法论争议。Meta 的模型卡自己承认,这张对比表混合了"内部测试、厂商提供的分数、第三方结果"三种来源;VentureBeat 的核查进一步指出,部分软件工程对比中各家用的 coding 工具并不相同,控制变量不如"同一条件下全测一遍"严格。Abacus.AI 的 Bindu Reddy 也在 X 上公开质疑过 Meta 自测成绩的可比性。看厂商发布会的数据,正确姿势永远是:自测成绩打七折,第三方指数才是定位,自己的工作流实测才是答案。
定价细账:token 单价只是故事的一半
4 美元 / 20 美元的 API 价目看起来和 Opus 5.5"同档",但 vibe coder 真正该看的是另一组数字。Artificial Analysis 估算了跑完 Intelligence Index 平均任务的实际成本:Wonder 约 4.52 美元,Opus 5.5 约 5.98 美元,GPT-6 Astra 反而最低,约 3.26 美元。token 单价低,不等于完成一个任务花的钱少——不同模型的 token 消耗效率差异很大。对长周期 agent 任务(反复读文档、调工具、生成大段输出)来说,任务成本才是真实账本。
而对个人开发者,真正的战场根本不在 API 价目表上。Wonder Full 不上 API,只走 50 美元 / 200 美元的 Muse Code 订阅——Meta 把"最强编码能力"做成了一项订阅特权。这和 Anthropic 把 Opus 5.5 同时开放 API 与订阅的做法形成鲜明对比。你的"最强模型"从此和一家 IDE 深度绑定,这是厂商锁定的新形态:以前锁定的是编辑器习惯,现在锁定的还是模型能力本身。
还有一个藏在条款里的雷点,VentureBeat 特别拎了出来:Muse Code 订阅默认开启 Contributor 模式——Meta 可以用你提交的提示词、代码、文件和输出来训练未来的模型。纯按量付费的 API 走的是 Standard 模式(不拿你的数据训练),但订阅用户想关掉 Contributor 模式得手动操作,且只对"之后"的提交生效。如果你把商业项目的代码喂给 Muse Code,等于默认签了一份数据授权协议。订阅前先去设置里关掉它,或者干脆别把敏感代码放进去。
Active Memory + Active Focus:方向是对的,证据还不够
抛开商业设计,Wonder 在产品思路上有两个真正值得关注的新能力。Active Memory 让 agent 跨会话保留关键的个人与工作上下文——按 Meta 研究员 Kavya Kopparapu 在发布视频里的说法,模型要能"记住对你重要的事,跨越日、周、月甚至更久"。Meta 还为此自研了 MemoryBench 记忆基准,自称 Wonder 在上面反超了 Fable、Opus 和 Astra。Active Focus 则解决另一个 agent 痼疾:遇到意外障碍、需求变更或失败尝试时不中途放弃,而是修订计划、尝试替代方案,关键动作前先请求许可。
我的判断是:这是从"聊天模型"到"长周期 agent"的分水岭设计,而且方向完全正确。vibe coder 最痛的体验是什么?不是模型写不出代码,而是"新开一个会话,它就忘了整个项目的上下文"。记忆能力正在成为 coding agent 的下一个主战场,Cursor、Claude Code 都在补这一课,Meta 直接把它做成了模型的原生能力。
但证据层面要打折扣:MemoryBench 是 Meta 自研的基准,第三方还没有独立复核;Active Memory 在真实项目里的表现(记什么、忘什么、记错了怎么办)要等开发者大规模实测。这两个能力是"值得单独测试的差异化",不是"已经验证的护城河"。
真正的信号:Llama 的开放路线,结束了
这次发布最容易被基准数字淹没、但长期影响最大的事实是:Wonder 系列闭源,不放权重。两个模型的参数都不可下载、不可自托管、不可魔改。对比一下:Meta 8 月发布的轻量模型 Muse Glimmer 还给了 Apache 2.0 协议,而 Wonder 直接关门。
从 Llama 到 Wonder,Meta 完成了从"开源布道者"到"闭源订阅商"的转向。这个信号对 vibe coder 有三层含义:第一,别再等开源版 Wonder 本地跑了,这条路 Meta 已经关上;第二,开源与闭源前沿模型的差距可能重新拉大到 6-12 个月(有券商研报已经在这么判断);第三,Meta 学会了 OpenAI 和 Anthropic 的全套玩法——最强能力只租不卖,订阅+数据飞轮才是新商业模式。
这也解释了为什么 Wonder Full 必须绑定 Muse Code 订阅:Meta 要的不是 API 调用量,而是把开发者锁进自己的工具链,再用 Contributor 模式把他们的代码变成下一代模型的养料。开源时代 Meta 靠 Llama 赚的是生态影响力;现在它要赚的,是订阅费和数据。
对 vibe coder 的意义:选芯清单上多了第三个名字
先说格局。2026 年 10 月的编码模型版图,现在是三足鼎立:Claude Code 背后的 Opus 5.5 / Sonnet 5.5、Codex 背后的 GPT-6 Astra,以及 Muse Code 背后的 Wonder Full。Meta 用一年时间(MSL 2025 年 8 月成立)从"掉队者"回到了牌桌上,这本身就很说明问题——前沿模型的竞争,现在是 OpenAI、Anthropic、Google、Meta 四家混战。
再说三个具体判断:
第一,别急着换工具。SWE-Marathon 57.5 对 46.3 听起来很美,但第三方综合指数 56 对 58 说明综合实力仍是 Opus 5.5 占优。Wonder Full 的优势集中在长周期、跨应用的 agent 任务上——如果你的日常是"在单个仓库里快速迭代",这个优势你可能感知不强。换"芯"之前,先拿自己的仓库跑一周对比:同一个需求,分别用 Claude Code 和 Muse Code 做一次,数一下一次通过率和返工次数。
第二,算清楚订阅账。50 美元/月的 Power Usage 和 200 美元/月的 Maximum Usage,对标的是 Claude Pro/Max 和 ChatGPT Plus 那套订阅体系。但注意 Meta 的用量档位是按"Everyday 档的倍数"来表述的,实际能跑多少任务、超出后怎么计费,发布初期并不透明。我的建议:先用标准版 Wonder 的 API(4 美元/20 美元)低成本试水,确认效果配得上之后再考虑订阅锁死 Wonder Full。最贵的那档,永远是"为不确定性付的税"。
第三,单独测试"跨会话续写"场景。如果 Active Memory 在真实项目中好用——比如一周后回来,模型还记得你的架构决策和代码规范——那 Muse Code 的长项目体验可能真的反超。这是 Wonder 系列唯一可能形成代际差的能力,也是最值得你花一下午验证的命题。反之,如果记忆经常记错、幻觉上下文,那它就是个营销词。
一句话总结
Meta 用 Wonder 证明了自己重回前沿实验室行列:一年时间,从重组 AI 团队到拿出对标 Opus 5.5 的 frontier 模型,执行力没得说。但对 vibe coder 来说,真正的问题从来不是"谁的基准高 2 分",而是 Meta 这次立下的新规则你接不接受:最强版只租不卖、默认拿你的代码训练下一代、开源路线就此关门。基准成绩会过时,商业规则不会——选工具之前,先看清规则。
一手来源:Meta 官方研究博客(research.meta.ai/blog/muse-wonder)、Meta Newsroom 公告;基准数据引自 Meta 官方 model card(2026-10-12)与 Artificial Analysis Intelligence Index;定价与订阅条款经 VentureBeat、TechCrunch 交叉核实。Meta 自测成绩存在方法论争议,文中已标注。
评论 (0)
原始来源
相关文章
2026 年 10 月 12 日,Cursor 官方宣布将 Cursor 并入 The X Subscription:Grok、Grok Bot、Cursor、X Premium 一价全包,Grok 编码用量至少翻倍;但第三方模型从首个请求起按 API 挂牌价另计,旧 Ultra 停售新用户。本文拆解订阅变化、重算四类 vibe coder 的成本账,并给出观望、切换与混合三种策略。
Google DeepMind 新团队 Polaris 正在招聘 Research Engineer,为 AI coding agent 构建评测框架——无学位要求、无最低年限要求。55 万至 110 万美元总包数字来自 Tamay Besiroglu 的 X 帖(职位页 base salary 约 16.4 万–25.2 万美元)。Polaris 的方法论是手工构建少量任务、每个约一周打磨,以贴近真实编码复杂度。
10 月 8 日,英国信息专员办公室(ICO)宣布十家 AI 巨头已做出或承诺做出数据保护改进。但更大的故事是监管者的下一个目标:agentic AI。为期六周的证据征集已启动(截止 11 月 20 日),法定 AI 决策行为准则也在路上,coding agent 正式进入合规射程。独立开发者也该知道的三个义务:lawful basis、transparency、safeguards。