微软把 137B 自研代码模型塞进你电脑:MAI-Code-1.1-Flash 本地版,零推理费但要 120GB+ 内存
微软自研代码模型 MAI-Code-1.1-Flash 推出本地版:3-bit 量化、256K 上下文全保留,本地调用零推理费,但官方推荐 120GB 以上内存。第三方实测显示量化版 SWE-Bench Verified 得分 70.80%,仅比全精度版低 1.8 个点。“零推理费”对独立开发者的真实含义是什么?Copilot 的路由器才是真正的护城河。
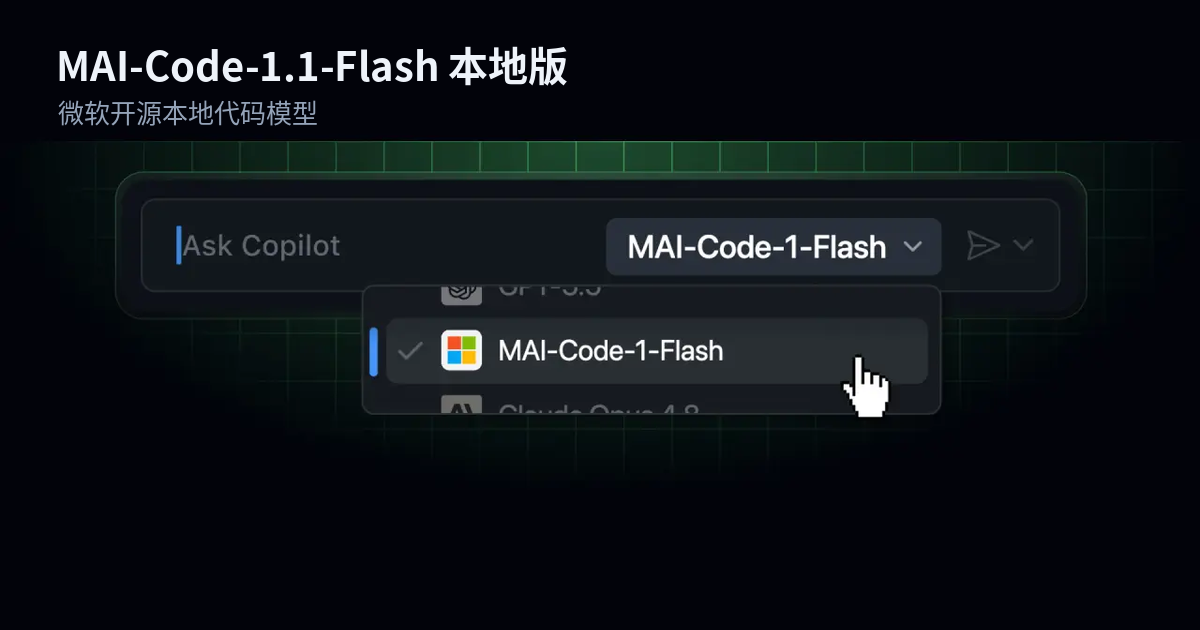
10 月 7 日,微软在旧金山开了一场发布会,纳德拉亲自站台,主题只有一个:把 AI 从云端搬进你的电脑。主角不是 Windows,不是 Surface,而是一个模型——MAI-Code-1.1-Flash,微软自研代码模型的本地版:3-bit 量化,256K 上下文全保留,官方宣称性能与全精度版"可比",本地调用零推理费。
先别急着欢呼。同一篇官方博客里还写着一行小字:推荐 120GB 以上内存的设备。零推理费是真的,门槛也是真的。这篇文章把官方说法、第三方实测和产品逻辑拆开,回答三个问题:量化版到底损失了多少性能?"零推理费"对独立开发者到底意味着什么?以及,微软的路由器里到底藏着什么算盘。
一、先看官方说了什么:137B 模型,两条战线
一手来源是 Microsoft AI 官方博客 10 月 7 日的文章《MAI-Code-1.1-Flash: Better, faster, at a quarter of the cost》。这次发布其实是两件事打包:云端版 1.1 的升级,和本地版的首次亮相。
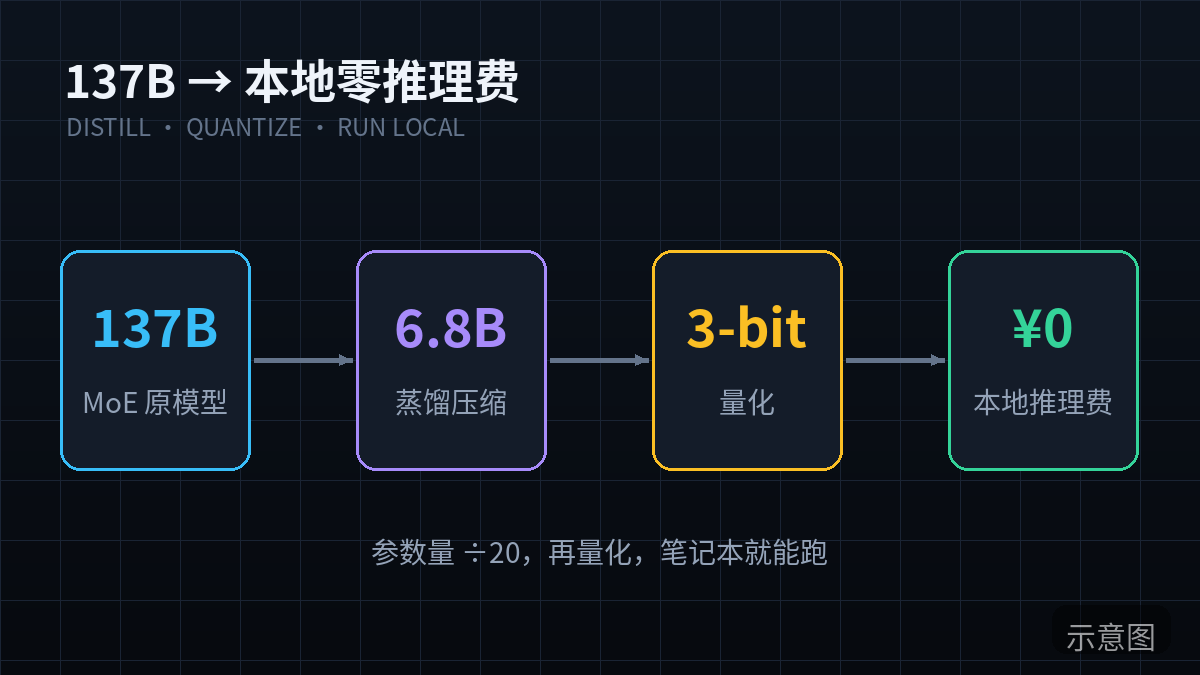
先看云端版的数字。MAI-Code-1.1-Flash 是一个 MoE 模型:137B 总参数,每次推理只激活 6.8B。相对今年 6 月 Build 大会上发布的 1.0 版,token 效率提升 25%,成本降到四分之一——标题里的 "quarter of the cost" 就是这么来的。GitHub Copilot CLI 上的 Terminal-Bench 2.1 提升 22%,.NET 相关任务提升 15%。微软还给了两个生产指标:代码留存率(code survival)+4%,用户回访 +9%,并且特意强调"benchmark 是参考,生产数据才是硬道理"。token 流速快 25%,完成一个任务消耗的 token 少 25%。
本地版是这次的重头戏,官方其实只说了三句话:
- 3-bit 量化优化,内存需求大降,但保留完整的 256K 上下文窗口,在 SWE-Bench Verified 和 Terminal-Bench 2.1 上与全精度版性能"可比"(comparable——注意这个词,官方没给具体数字)。
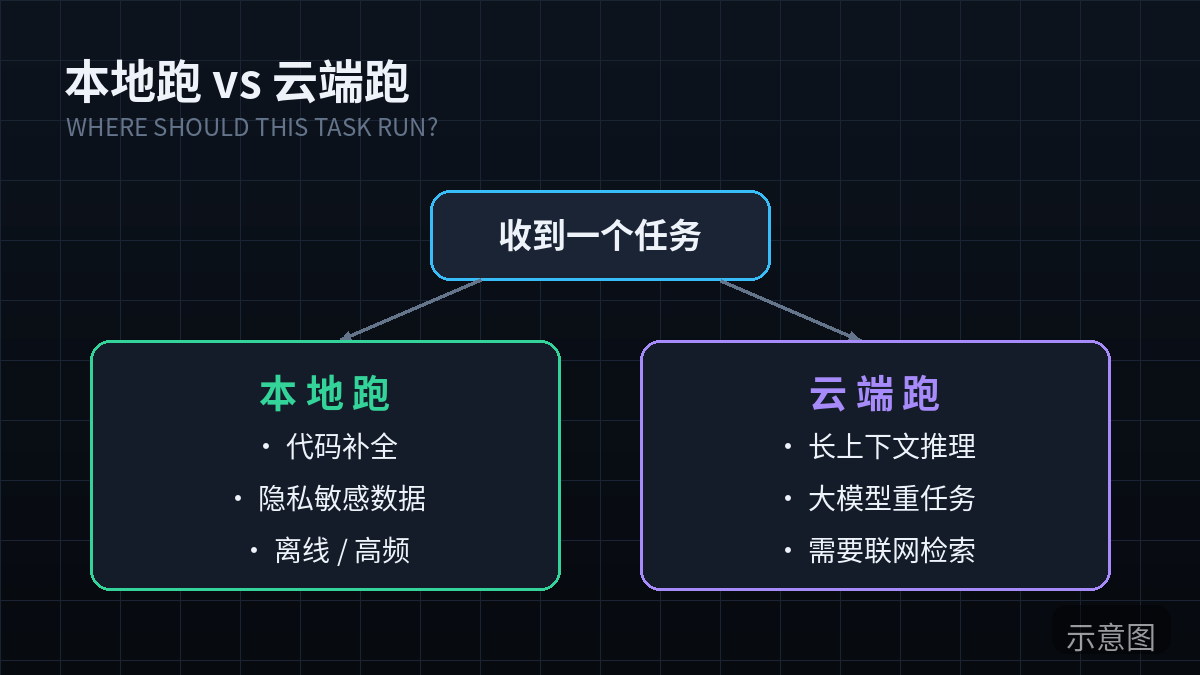
- "On-device coding, with zero inference charges for local model calls"——本地写代码,本地调用零推理费用。MAI-Code-1.1-Flash 给 Copilot 的路由器增加了一个 on-device 选项,合适的编码工作在你自己的硬件上跑,需要更强能力的任务再走云端模型补位。
- 模型可下载、本地运行,"为获得最佳性能,我们推荐 120GB 以上内存的设备"。
另外,GitHub Copilot app、Copilot CLI、VS Code 的实验性本地接入计划 10 月底上线。也就是说,模型现在能下载,但 Copilot 里丝滑的接入还得再等几周。把官方数字摆成一张表:
| 维度 | 1.0(6 月 Build 发布) | 1.1 云端版 | 1.1 本地版 |
|---|---|---|---|
| 参数规模 | — | 137B 总参数 / 6.8B 激活 | 同左,3-bit 量化 |
| 上下文窗口 | — | 256K | 256K 全保留 |
| token 效率 | 基准 | +25% | — |
| 推理成本 | 基准 | 降至四分之一 | 本地调用零推理费 |
| Terminal-Bench 2.1(CLI 场景) | 基准 | +22% | 与全精度版"可比" |
| .NET 任务 | 基准 | +15% | — |
| 生产指标 | 基准 | 代码留存 +4%、回访 +9% | — |
| 硬件要求 | 云端 | 云端 | 推荐 120GB 以上内存 |
二、"零推理费"三个字,到底省了谁的钱
先给结论:零推理费是真的,但它省的不是你以为的钱。
官方原话是 "zero inference charges for local model calls"——关键词是 inference charges(推理费用),不是"免费"。第三方媒体 NeoTeo 把这层窗户纸捅破了:零推理费指的是不收模型推理费,但电脑的钱、电费、你折腾环境的时间,一分没省。explainx 的报道补了一句更扎心的:微软至今没有公布本地版的完整定价条款——纳德拉说的是"没有云端 token 花费",但本地使用的商业细则,官方还没掀桌。
真正的账要这么算。官方推荐 120GB 以上内存,这是什么概念?今天市面上能跑这个模型的消费级设备,掰着指头数:苹果 Mac Studio 顶配(128GB 统一内存)、微软自家刚发布的 Surface Laptop Ultra 顶配(128GB 统一内存,NVIDIA RTX Spark 平台)。Neowin 的报道点破了那层"巧合":微软发布本地模型的同一天,发布了顶配 128GB 的 Surface Laptop Ultra——刚好压过官方推荐线。这哪是巧合,这是产品组合拳。
换句话说,"零推理费"的入场券,是一台大几千美元的工作站。letsdatascience 的标题更直接:《微软的代码模型能跑在笔记本上,但那台笔记本要 5900 美元》。我们来算一笔粗账:
| 成本项 | 云端 API 路线 | 本地路线 |
|---|---|---|
| 模型推理费 | 按 token 付费(1.1 已降至 1.0 的四分之一) | 零推理费 |
| 硬件一次性投入 | 0,现有电脑即可 | 约 5900 美元级工作站(128GB 统一内存) |
| 电费与折旧 | 忽略不计 | 长期运行的真实成本 |
| 适用人群 | 所有人 | 本来就有高配工作站的人 |
对独立开发者,这意味着什么?如果你本来就在用 128GB 统一内存的 Mac Studio 做开发,本地版是白捡的福利:高频的补全、重构、脚本任务,token 账单直接归零。但如果你现在用的是 16GB 的 MacBook Air,指望"零推理费"省钱,先得花一辆车的钱换电脑——这笔账怎么算都是亏的。微软的"零推理费"不是慈善,是精准筛选:它奖励的是已经站在硬件门槛里面的人。
还有一个被忽略的细节:统一内存是 CPU 和 GPU 共用的,操作系统、应用、推理运行时、KV 缓存都要从同一个池子里分。NeoTeo 提醒,设备标称的 128GB 不等于模型可用的 128GB。这就是为什么微软要的是"120GB 以上"而不是"刚好够"——53GB 的模型本体只是起步价,256K 上下文全开时峰值内存要到约 75.5GB(第三方数字,下一节细说),再加上系统开销,120GB 是留了余量的保守推荐。
三、量化版到底损失了多少:第三方实测摆出来
官方只说了"可比"(comparable),没给数字。数字是第三方媒体根据微软技术博客披露的测试细节交叉整理出来的,引用时必须注明来源层级:以下细颗粒数字来自 explainx、NeoTeo、letsdatascience 等第三方交叉报道,测试本身是微软在 10 月 5 日自测的(Windows ARM64 版 llama.cpp + CUDA 运行时),官方博客只给了定性表述。
先看 benchmark 对照表(微软自测,合成代码生成负载):
| 基准测试 | 本地量化版 | 全精度云端版 | 差值 |
|---|---|---|---|
| SWE-Bench Verified(500 题) | 70.80% | 72.6% | -1.8 个百分点 |
| Terminal-Bench 2.1(89 题) | 66.29% | 62.9% | +3.4 个百分点 |
两个数字都值得咀嚼。SWE-Bench 上只丢了 1.8 个点——3-bit 量化、模型体积压缩 80%(53GB 对 bfloat16 云端版),只付出不到 2 个点的代价,这个交换比在两年前是不可想象的。更意外的是 Terminal-Bench 2.1:量化版反超了全精度版 3.4 个点。作为参照,GPT OSS 120B 在这两项上分别是 32.0% 和 23.6%——MAI-Code-1.1-Flash 本地版的成绩是它的两倍还多。
但先别急着下"量化无损"的结论,三个诚实注脚必须打:第一,这是微软自己测的,测试集、prompt、解码参数都是自家选的;第二,letsdatascience 明确标注这是"合成代码生成负载"(synthetic code-generation workload),微软自己也提醒结果可能因设备而异;第三,SWE-Bench 和 Terminal-Bench 测的是"解题",不测"代码品味"——生产环境里的代码留存率(官方云端版 +4% 的那个指标),本地版还没有对应数据。
内存数字同样来自第三方交叉:模型本体约 53GB(相对 bfloat16 云端版压缩 80%),256K 上下文全开时峰值约 75.5GB,混合精度量化做到约 3.3 bits/weight。速度方面,64K 上下文时 prompt 处理 923.5 tok/s,128K 时 769.8 tok/s,解码用了推测解码(speculative decoding)提响应速度。这些数字描出一幅清晰的画像:这是一个为"大内存统一架构"(苹果 M 系列、NVIDIA RTX Spark 这类)量身定制的模型,传统独显 PC 的显存墙(24GB 级别)根本不在它的目标射程内。
四、路由器:微软真正的算盘
这次发布最容易被忽略、但可能最重要的一句话,藏在官方博客里:"MAI-Code-1.1-Flash gives Copilot's router an on-device option"——它给 Copilot 的路由器增加了一个本地选项。
注意主语:不是"给开发者一个本地模型",是"给路由器一个选项"。决定用本地还是云端的,不是你,是 Copilot 的 Auto 编排。techaeris 的发布会报道确认了两种用法:让 Copilot 的 Auto 在本地和云端推理之间自动路由,或者手动指定本地模型。自动路由的实验性预览计划 10 月底上线。
这才是微软真正的算盘。模型会越做越便宜、越做越小——1.1 相对 1.0 成本已经降到四分之一,本地版更是把推理费干到零。但"判断这个任务该用哪个模型"的权力,微软要牢牢攥在自己手里。路由器才是护城河,模型只是耗材。今天路由器里装的是 MAI,明天可以装任何模型,用户感知不到切换,离不开的也不是某个模型,而是那个永远帮你选对模型的 Copilot。
还有一组容易被误读的关系:本地推理不等于沙盒隔离。同一天 MXC(Microsoft Execution Containers)GA,很多人把"本地运行"和"安全隔离"混为一谈。RohitAI 的分析把这层关系捋得很清楚:沙盒控制需要单独配置,本地推理本身不附带文件和网络活动的边界控制;模型放在本地跑,不等于它能碰的东西变少了。微软的架构其实是三个旋钮:模型放哪(本地/云端)、路由谁定(Copilot Auto)、边界谁管(MXC)——三件事,别混成一个。
那么,什么任务值得本地跑?我的判断列成表:
| 任务类型 | 建议 | 理由 |
|---|---|---|
| 高频代码补全、重命名、简单重构 | 本地跑 | 量大、难度低,token 烧得最多,本地零推理费收益最大 |
| Shell 脚本、系统诊断(CLI 场景) | 本地跑 | Terminal-Bench 上量化版反超,CLI 是 1.1 重点优化方向 |
| 涉密代码、断网环境 | 本地跑 | 发布会现场开飞行模式演示,离线可用是硬价值 |
| 复杂多步推理、长链 agent 任务 | 走云端 | 官方原话:复杂任务由云端模型补位 |
| 需要最新知识、联网检索的任务 | 走云端 | 本地模型知识有截止,联网能力在云端侧 |
核心逻辑一句话:本地模型吃的是"高频、低难度、对延迟敏感"的任务——恰好是开发者每天烧掉 token 最多的部分。微软把这部分成本从自己(云端推理)和用户(API 账单)两边同时抹掉,换来的是用户对 Copilot 路由器的深度绑定。这笔买卖,微软不亏。
五、另一条线:官方下沉 vs 第三方接入
有意思的是,就在同一时期,Copilot CLI 还干了另一件事:开始发现并接入 Ollama 上的第三方本地模型。本站之前报道过这条线。这里形成了一组漂亮的对照:
- 一条线是官方模型下沉:微软自研的 MAI-Code-1.1-Flash 从云端走下来,进你的电脑,经 Windows ML provider 接入 Copilot。
- 另一条线是第三方接入:Ollama 社区里的 Llama、Qwen、DeepSeek 等开源模型从外面走进来,Copilot CLI 照单全收,还支持 OpenAI 兼容的本地端点。
一个下沉,一个接入,方向相反,入口相同:都是 Copilot。这就是微软的阳谋——模型层充分开放、充分竞争,越卷越好,反正不管你用的是微软自研还是社区开源,调用它们的都是 Copilot 的路由器。MAI 自研线是微软摆脱对 OpenAI 依赖的战略意图,但 Copilot 并不把鸡蛋放在一个篮子里:官方模型保证下限,第三方生态保证上限,路由器保证你离不开。
对独立开发者的实操含义是:10 月底实验性接入上线后,你的 Copilot CLI 里可能会同时出现三个选项——云端 MAI(强、按量付费)、本地 MAI(零推理费、要 120GB 内存)、本地 Ollama 开源模型(不要钱、吃你现有硬件)。怎么选,看上一节的任务分流表。硬件不够 120GB 的,大概率是"云端 MAI + Ollama 小模型"组合;硬件够的,加上本地 MAI 做主力。
六、我的判断:三层
短期(未来 3 个月):别为它换电脑
10 月底才开始实验性接入,Copilot app、CLI、VS Code 三端的 rollout 需要时间;120GB 内存的门槛把 95% 的开发者挡在门外;第三方实测数据是微软自测的合成负载,真实生产表现要等社区大规模实测。如果你已经有 128GB 统一内存的工作站,10 月底去开实验性选项,白捡的 token 减免不要白不要。如果没有,继续用云端——1.1 本身已经比 1.0 便宜四分之一,云端降价的红利是人人有份的。
中期(6 到 12 个月):真正的变量不是模型,是路由器
一旦 Auto 路由成熟,"简单任务本地化"会成为全行业的成本架构:云厂商的 API 定价会被迫继续下探,因为最烧 token 的那部分需求正在沉淀到本地。微软这一步,本质上是在重写 coding 助手的成本结构——把"按 token 付费"的池子切走一块,变成"一次性硬件投入"。对 API 创业公司这是坏消息,对开发者是好消息。
长期:本地模型的杀手锏不是便宜,是离线
发布会现场那个飞行模式演示,比所有 benchmark 数字都诚实——当模型在你电脑里,飞机上、客户内网、没网的机房,Copilot 照样工作。代码不出内网的合规价值,对金融、医疗、军工类客户是刚需。零推理费是营销话术,离线可用才是改变工作流的东西。哪天你在高铁上用 Copilot 重构完一个模块还没联网,你会回来感谢这篇判断。
最后回到开头那个问题:微软把 137B 模型塞进你电脑,到底意味着什么?意味着 AI 编程助手正式进入"混合动力"时代——云端负责思考,本地负责干活,路由器负责调度。模型本身会越来越不值钱,值钱的是调度它的那只手。而这只手,微软已经伸出来了,名字叫 Copilot。
本文事实依据:Microsoft AI 官方博客 2026-10-07《MAI-Code-1.1-Flash: Better, faster, at a quarter of the cost》;量化版 benchmark、内存、速度等细颗粒数字引自 explainx、NeoTeo、letsdatascience、Neowin 等第三方交叉报道(测试为微软 2026-10-05 自测的合成负载,官方博客仅作定性表述);"零推理费"为官方原文 "zero inference charges for local model calls" 的翻译。
评论 (0)
原始来源
相关文章
联想天禧 AI 自研代码智能体框架 TianxiCode 搭配 DeepSeek-v4.1-Flash,在 SWE-bench-Live Lite 分榜以 71% 解决率登顶全球第一,并通过官方 Verified 审核。本文解读这项“真实工程”评测为何更难、“框架>模型”论点的含金量,以及它给 vibe coding 实践者的三点启示。
Frank Michael Smith 用 Claude Code 花 12 小时做出体育问答游戏 GeoSports:首日 79 个玩家,一个月内百万人游玩,5 个月后 1500 万对局、约 4.7 万美元 ARR。本文拆解它为什么是体育问答这个品类跑出来,给出 5 条独立开发者可复制的判断,以及必须诚实说的三件事。
Rails 之父 DHH 在 Rails World 宣布 37signals 已“不再手写代码”。本文拆解 2025 年 11 月的拐点、转向原生应用与 Rust 的动作、同一信源里的反方证据,以及给 vibe coding 读者的三条判断。