微软开源 Scope:别再问 agent"行不行",给它出一套卷子
微软 DevRel 把内部打磨一年多的 agent 评测平台 Scope 开源(MIT)。它不给模型跑分,而是给你的产品出卷子:同一任务跑 Copilot、Claude Code 等多个 agent,DAG 评测标准 + LLM Judge 打分,全程保留日志与工作区快照。Cosmos DB 实测修了 20 个 Agent Kit 问题和 27 处文档。核心观点:当 agent 成为软件的"用户",DevEx 得升级成 DevAx——先有体检,才有药方。
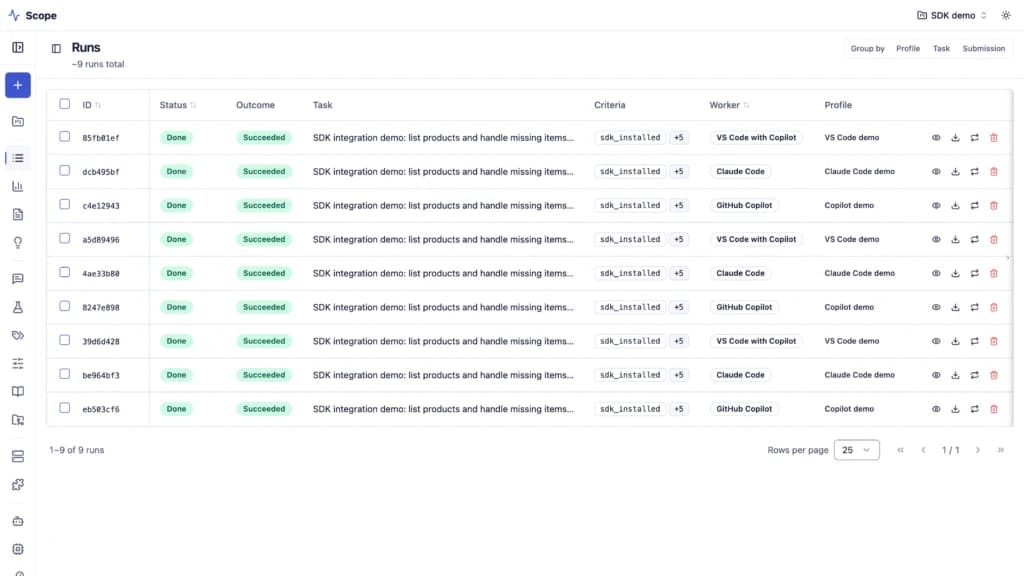
导语:别再问 agent"行不行",给它出一套卷子
2026 年 10 月 19 日(UTC 时间 16:00,即北京时间 10 月 20 日凌晨),微软 DevRel(开发者关系)团队把内部打磨了一年多的 agent 评测平台 Scope 开源了,MIT 许可证。它回答的是一个过去两年里所有 SDK、文档和 MCP 服务器团队都在暗自焦虑、却一直没有标准答案的问题:当 coding agent 开始替人读文档、选 SDK、调 API 的时候,你怎么知道自己的产品"对 agent 友好"?
Scope 的答案很直接:别再问 agent"行不行",给它出一套卷子。把同一套代表性任务同时发给 GitHub Copilot、Claude Code 等多个 agent 去做,用你自己定义的评测标准逐项打分,跑完看证据说话。而这套卷子最有价值的部分其实不是分数,是 agent 交卷后留下的完整"答题过程":它在哪一步走错了、在哪条文档上读歪了、在哪个报错信息前面卡住了。
微软自己拿它给产品"体检"的效果颇有说服力:Azure Cosmos DB 团队用 Scope 对比了裸模型和自家 Agent Kit,8 个端到端场景、5 种编程语言跑下来,修了 20 个 Agent Kit 问题和 27 处文档问题;一次针对性的 Agent Kit 更新之后,agent 对分层分区键的采用率从 47% 升到 100%,滥用 OFFSET/LIMIT 的情况从 47% 降到 0%。注意:这些数字是微软官方博客引用的 Cosmos DB 团队自报成绩,不是第三方独立评测——我们会在文末的"诚实提醒"小节里把它掰开揉碎。
Scope 到底是什么?先说它不是什么
先划清一个最容易误解的点:Scope 不是给大模型跑分的榜单。它不关心"哪个模型更聪明",它关心的是"你的产品被 agent 用得顺不顺"。问卷的出题人是你——SDK 维护者、CLI 作者、MCP 服务器开发者、文档团队;考生是市面上的 coding agent;考的是你的产品。
微软给这套逻辑起了个名字:DevAx(Developer Agent Experience,开发者智能体体验)。官方博客的定义很直白:理解 agent 如何与你的软件交互,并用证据去改善它们达成的结果。过去产品团队靠用户测试、访谈、用户反馈打磨 DevEx(开发者体验),这些依然重要;但现在多了一类新用户——agent。它会自己发现 API、挑选 SDK、照着文档一步步走、替开发者调用工具。一个对人类很友好的体验,完全可能让 agent 选错 API、漏掉关键说明、在任务中途卡住,而你对此一无所知。
Scope 是一个自托管的开源平台,构建在 Kubernetes 之上,本地也可以用 Docker Compose 一把拉起。关键细节:它是"你部署的软件",不是微软提供的托管服务。评测里跑的都是你产品的真实用法,代码和运行数据都留在你自己手里,不用交出去——这对要评测私有负载的团队是硬性条件。
它驱动的是现有的 coding agent,官方点名的有 GitHub Copilot、Claude Code 和 VS Code 里的 Copilot,而不是微软自家的新模型。换句话说,Scope 不卖考生,它卖的是"考场+判卷+错题本"这一整套基础设施。
它是怎么工作的:出卷、考试、判卷、复盘
一套完整的 Scope 评测,大致是下面这条管线:
- 出题:你定义代表性任务,比如"给示例应用接入我们的 SDK",需要的话附上起始代码库。还可以配置不同的 persona——模拟不同视角和沟通风格的用户,让评测覆盖更真实的使用方式。
- 考试:同一任务同时发给多个 agent 并行执行。所有配置都收进版本化、可复用的 profile:worker、模型、agent 版本、技能、MCP 服务器、扩展,一项不落。任务和标准保持不变,只换你想评估的那个变量——这才是"可重复实验"的真正含义。
- 判卷:评测标准被表达为有向无环图(DAG):检查项可以独立存在,也可以依赖前置项——比如"运行时检查"依赖"构建成功"。Judge 服务用大语言模型对着这些标准逐项打分,告诉你哪些要求达到了、哪些需要深挖。
- 复盘:这是 Scope 最狠的一环。agent 干活时全程流式输出,交互记录和工作区快照全部保留。你可以顺着工具调用链往回看:一个失败的检查项,前面到底发生了什么。失败从此变成具体的改进项——文档哪一句该改、SDK 哪个默认值该调、工具的报错信息该怎么重写。

官方博客举了个例子,很能说明这套东西的用法:SDK 团队让 agent 给示例应用加一个集成,评测"能不能构建、有没有用对 API、文档里写明的错误响应处理得对不对"。如果"缺失项处理"反复失败,团队拿到的就不是一句模糊的"agent 不太行",而是一个具体、可调查的行为。改完文档或工具之后再跑一遍——通过率变了没有?同一套场景就成了你产品的 "agent 回归测试",可以通过 Portal 界面看,也可以用 CLI 和 REST API 从脚本和流水线里提交评测、拉取结果。评测从此变成持续的产品反馈来源,而不是一次性的检查。
官方指出的三个发力方向:文档、SDK、工具
Scope 的官方博客把 agent 体验问题归纳为三个方向,每个方向都对应一类"体检报告":
- 文档:找 agent 反复读漏的说明和想当然的错误假设,更新指引后重跑,看这类失败是不是变少了。这是最划算的改进——很多时候 agent 不是"笨",是文档里关键的一句话藏得太深,或者示例代码本身就是错的。
- SDK 的发现与正确采用:检查 agent 有没有选对 SDK、初始化对不对、API 用法是否符合预期。把"基线"和"加了新示例/新技能"的版本对比一下,就能量化"多写一个示例"到底值多少钱。
- 工具链:看 agent 在命令行工具或 MCP 服务器上哪里挣扎,用证据去排优先级:是工具描述写得不清楚、报错信息不够 actionable,还是集成自己就有 bug。
这三个方向合起来,恰好覆盖了一个产品"被 agent 使用"的全链路:先看到(发现)、再看懂(文档)、最后用对(工具)。很多团队之前只在"用对"这一环救火——agent 报错了才去修;Scope 的思路是把三环都变成可度量的实验,问题出在哪一环,证据会自己说话。
Cosmos DB 的案例就是这套思路的完整演示:团队先用 Scope 对比了裸模型和自家 Agent Kit(带引导的技能包)在 8 个端到端场景、5 种语言下的表现,差距最大的地方就是改进清单——20 个 Agent Kit 问题、27 处文档问题。最漂亮的一个数据点:一次针对性的 Agent Kit 更新之后,agent 采用分层分区键的比例从 47% 干到 100%,而滥用 OFFSET/LIMIT(Cosmos DB 里又贵又慢的写法)从 47% 降到 0%。注意这个实验设计的巧妙之处:它测的不是"模型 A 好还是模型 B 好",而是"加了我们的引导之后,agent 的行为有没有变好"——这正是 DevAx 和传统模型跑分的根本区别。
为什么重要:DevEx 得升级成 DevAx
先说对 SDK、文档、MCP 团队的意义。agent 正在成为软件事实上的"新用户",而传统 DevEx 方法对它完全失明。用户访谈访不到 agent,问卷调查问不到 agent,埋点统计的是人的点击,不是 agent 的工具调用。当 agent 在你的文档里读漏一句话、选错一个 API、被一条含糊的报错信息卡住时,没有任何传统反馈渠道会告诉你。Scope 做的事,就是把这条缺失的反馈链补上:先有体检,才有药方。没有可重复的评测,所有"让文档对 agent 更友好"的努力都只能靠感觉。
再说对独立开发者的意义。Scope 的门槛没有你想象的高:它开源、MIT 协议、本地 Docker Compose 就能起。你如果维护一个 MCP 服务器、一套技能(skills)、一份 API 文档,完全可以给自己出 3~5 道"agent 必考题"——agent 用你的东西卡住的地方,就是你的文档和报错信息最值钱的改进清单。这比"凭感觉重写文档"靠谱得多。而且评测标准是你自己定的 DAG,不需要等某个权威机构发布"官方基准"。
第三层意义在开源本身。评测方法自己也需要被评测。微软在博客里把这句话说得很明白:当一个结果要指导文档更新或 SDK 改动时,团队应该能检查任务、证据和判分依据本身。Scope 把执行代码和评测代码一起开源,等于邀请所有人来质疑它的方法、调查意外结果、改进评测本身。这恰恰是很多黑盒"AI 评测"最缺的东西:分数出来了,但你不知道它怎么判的,也没法复现。
还有一层战略意义值得玩味:它把"agent 体验"从玄学变成了工程。过去"我们的 SDK 对 agent 友不友好"是个主观判断,现在它可以变成 CI 里的一条流水线、一个每周跑的数字、一次改版前后的对比实验。当"agent 通过率"成为和"单元测试通过率"并列的指标,产品团队对 agent 的态度就从"顺手支持"变成了"正式负责"。微软 DevRel 自己打磨了一年多才敢开源,某种程度上说明:连微软也是先被 agent 的"难伺候"教育了一遍,才总结出这套方法论——官方博客还顺手预告了 11 月 AI DevCon NYC 的相关分享,显然是想把 DevAx 做成一个持续的社区议题,而不只是一次性的开源发布。
和站内 ThinkingBox 篇划界:一个是方法论,一个是考场
细心的读者可能记得,本站 10 月 7 日发过一篇微软 × Hugging Face 的评测基准 ThinkingBox("别信 agent 说做完了,去查数据库")。有必要划清界限,避免混淆:ThinkingBox 是一个评测基准方法论——它教你怎么设计"防作弊"的评测题(比如不看 agent 的自我报告,直接去查它有没有真的改对数据库);而 Scope 是一个自托管的评测平台——它给你考场、考生调度、判卷服务和错题本,让你给自己的产品持续出卷子、跑实验、做回归。一个解决"怎么出好题",一个解决"怎么持续地考"。两者互补,不撞车;真要较真,ThinkingBox 的方法论完全可以作为 Scope 里的一套 DAG 评测标准来用。
它和传统模型跑分有什么不同:考产品,不考模型
为了避免混淆,有必要把 Scope 和你熟悉的那些 agent 评测放在一张表上比较——它们回答的是完全不同的问题:
- SWE-bench、HumanEval 这类基准:考的是模型本身——"这个模型写代码行不行"。考生是模型,出题人是基准维护者,分数用来给模型排名。
- ThinkingBox(本站 10-07 报道过):考的是评测方法本身——"你的评测题防不防作弊"。它教你不看 agent 的自我报告,直接去查它有没有真的改对数据库。
- Scope:考的是你的产品——"agent 用我的 SDK/文档/MCP 顺不顺"。考生是市面上的 agent,出题人是你,分数用来指导你改产品。
这个区别决定了 Scope 的设计取舍:它不在乎"哪个 agent 得分最高",甚至官方博客明确说,评测要"保持任务和标准一致,只换你想评估的那个变量"——比如同一套任务,对比"裸模型"和"加了你的 Agent Kit/技能包"的模型,差值就是你的引导材料的真实价值。Cosmos DB 的 47%→100% 正是这么测出来的。这种"差值思维"比绝对分数有用得多:它直接回答"我们上周改的那版文档,到底有没有让 agent 变聪明"。
诚实提醒:先泼四盆冷水
第一,Cosmos DB 的数字是厂商自报。8 场景 × 5 语言、20 个 Agent Kit 问题、27 处文档、47%→100%、47%→0%——全部来自微软官方博客引用的 Cosmos DB 团队原话,没有第三方独立复现。而且微软自己在博客里加了限定语:这些数字"描述的是被评测的 Cosmos DB 场景,而不是对 agent 的通用排名"。把它当作"这套方法能产生行动"的证据,而不是"Scope 能让所有产品提升 X%"的承诺。
第二,微软亲口承认了两个硬伤。一是"可重复的配置不保证行为一致"——agent 的输出天然带抖动,同样的卷子重考,分数会浮动,所以必须多次重复跑、区分偶发问题和系统性问题。二是"自动化的 Judge 也会犯错"——用 LLM 给 LLM 判卷,偏差和误判是内生的。微软的建议是:代表性任务 + 重复运行 + 人工复核证据,三者缺一不可。换句话说,Scope 给你的是"体检报告",不是"诊断书",最终下判断的还得是人。
第三,自托管是有代价的。Scope 不是开箱即用的 SaaS,你要自己管 K8s(或本地栈)、自己管凭证和实验数据的访问权限;跑 agent 要接各家 agent 的 provider,LLM Judge 要调大模型——都是按量花钱的。更重要的是,设计一套好的评测任务和 DAG 标准本身是专业活:任务太简单测不出问题,任务不"代表性"则结论失真。这笔"出题成本"是很多人低估的部分。
第四,别把它当成"一次接入、永远省心"。agent、模型、MCP 服务器、插件都在快速变化,今天的评测结论三个月后可能就过时了。Scope 的价值恰恰在于"持续"二字——把它接进工作流、定期重跑,而不是发布会上跑一次就束之高阁。
行动建议:从一道题开始
微软官方博客的结尾给的建议很实在,值得原文转述精神:从一道对你的产品最重要的题开始。定义什么是"成功",反复跑,调查 agent 在哪里挣扎,用学到的东西改进体验,然后再评测一次。具体落地可以分三步走:
- 如果你维护 SDK / MCP / 文档:先写 1 个最关键的 agent 任务(比如"照着文档完成一次完整接入"),在 Scope 里跑起来。把 agent 的失败日志和工作区快照当成"用户反馈录像"来看——它卡住的地方,就是你文档里最该改的三句话。
- 先本地试水,别直接上 K8s:用 Docker Compose 把本地栈拉起来,跑通第一个实验,确认这套方法对你的产品真的有信号,再考虑生产级部署。Scope 的 CLI 和 REST API 从一开始就是为脚本和流水线准备的。
- 把"agent 通过率"变成常规指标:文档或 SDK 每次更新后重跑同一套场景,看通过率是升了还是降了。对独立开发者来说,哪怕每月手动跑一次,也比"凭感觉"强一个数量级——你的 MCP 服务器被 agent 用得顺不顺,第一次有了可量化的答案。
一句话总结:当 agent 成为软件的用户,DevEx 必须升级成 DevAx。而 DevAx 的第一步不是"优化",是"体检"——先有一套可重复的卷子,你才知道药方该开在哪。Scope 把这套考场开源了,剩下的就是你的题了。等到哪一天你的文档更新、SDK 发版时能顺手看一眼"agent 通过率是升了还是降了",DevAx 才算真正落地——而那一天,可能比很多人预期的来得更快。
一手来源:微软官方开源博客《Introducing Scope: Open-source evaluation for AI coding agents》(2026-10-19,全文亲核);Scope 官方仓库与快速上手指南见博客文末链接。本文效果数字均为官方博客引用的厂商团队自报,已在正文中标注。
评论 (0)
原始来源
相关文章

10 月 17 日,开发者 Gathin T. 发帖称把爸妈的小米电视"vibe coding"了:Claude Code 经 Wi-Fi 找到电视、停用 25 个广告包、重写桌面启动器。他开源的 cleanyourtv 几天内拿下 10,700 个 GitHub star,覆盖 107 款机型实测。本文拆解让这一切成为可能的 ADB 链路、周末的集体狂欢,以及狂欢之下不应被淹没的三个警告。
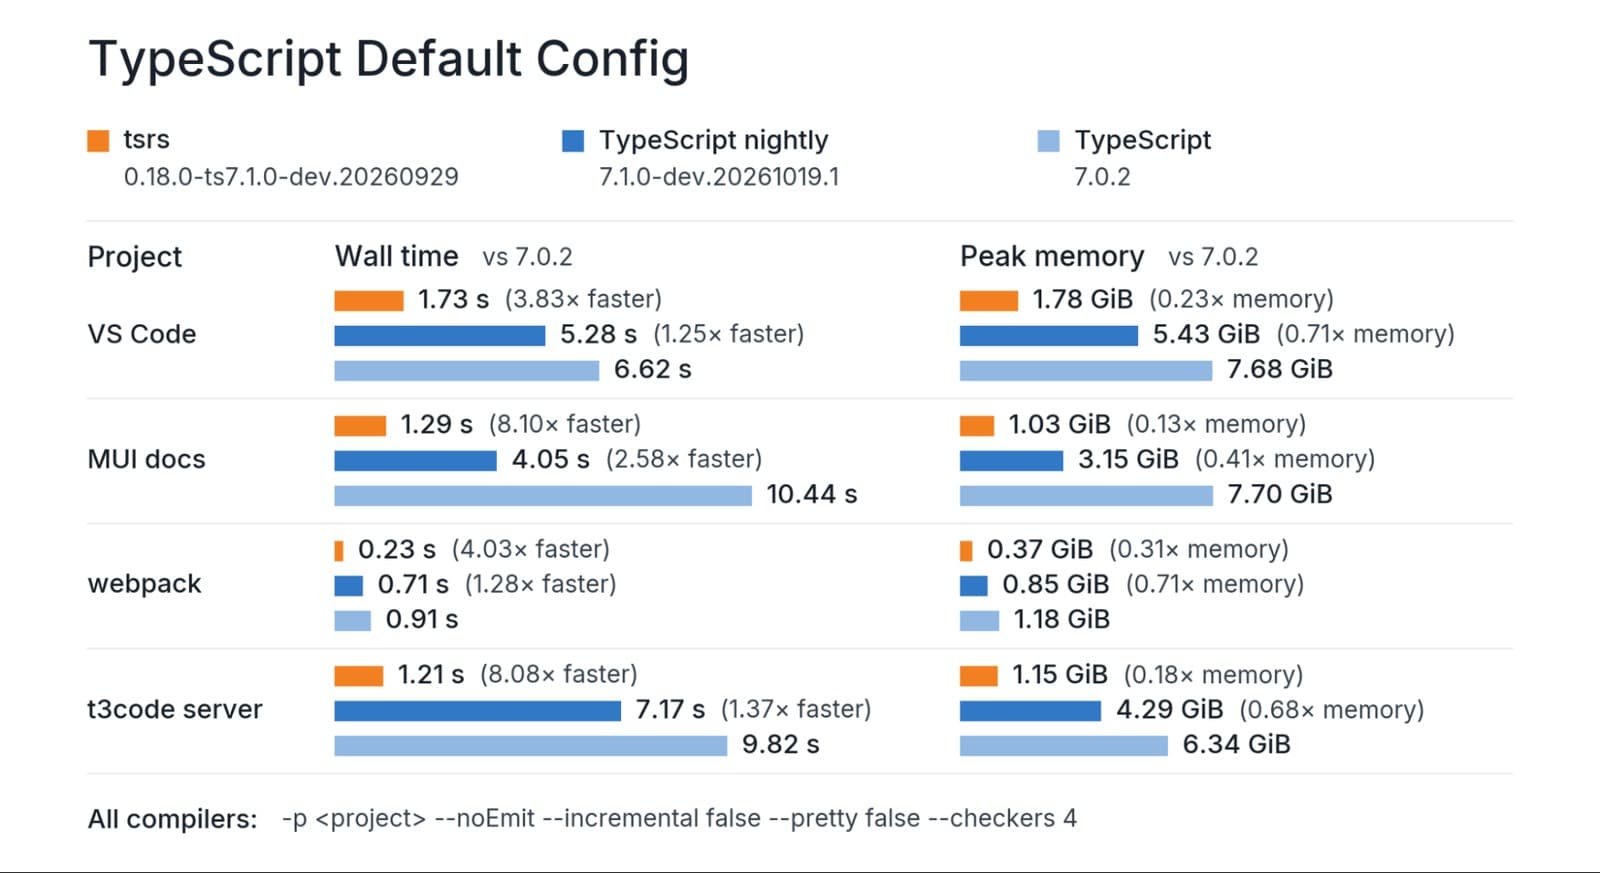
2026年10月20日,Cloudflare 联合 VoidZero 与 Owner.com 的 Max Schwenk 推出 tsrs——TypeScript 编译器的 Rust 移植,孵化于 Oxc 工具链,与 TS 官方团队协作且明确不是 fork。官方自测称比 TS 7.0 快最高 8 倍、内存少约 70%,部分优化已反哺进 TS 7.1。但真正的新闻是维护方式:Cloudflare 把维护 Vinext 的 agent 流程(晨间审查、tracking issue、夜间兼容矩阵、gap 自主修复)套用到编译器上。编译器大战的终局,或许是谁先让 agent 接管上游同步。

Simon Willison 10 月 20 日博文:Battle Drones,一款浏览器 RTS,321 个 commit 几乎全由 coding agent 写成。转折点是一句"让它好玩得多"加一通宵 Ultracode 运行——Claude 自己打了 1200 场 AI 对战来调平衡。如今它有 3D 画面、音频联机,还有 LLM 对战模式。