321 个 commit 没看过一行代码:Simon Willison 用 AI agent 做了个“真好玩”的 RTS 游戏
Simon Willison 10 月 20 日博文:Battle Drones,一款浏览器 RTS,321 个 commit 几乎全由 coding agent 写成。转折点是一句"让它好玩得多"加一通宵 Ultracode 运行——Claude 自己打了 1200 场 AI 对战来调平衡。如今它有 3D 画面、音频联机,还有 LLM 对战模式。

10 月 20 日,Simon Willison 发布了他最新的 vibe coded 游戏实验:一款命令与征服(Command & Conquer)风格的浏览器即时战略游戏,叫 Battle Drones。和他之前的游戏实验不同,这次他承认——"这次是真的好玩"。
先做个划界:10 月 14 日我们报道过 Willison 的 Tree Appreciator,那是一个单 prompt 生成的小游戏,属于"一次成型"的轻实验。而 Battle Drones 是一个从 7 月做到 10 月、12 个大版本、321 个 commit 的长周期工程实录——几乎每一行代码都是 coding agent 写的,而 Willison 本人"几乎没看过代码"。这篇讲的是另一件事:当一个人把"做游戏"这件事完整外包给 AI agent,三个月后会发生什么。
项目档案:321 个 commit,作者没看过代码
Battle Drones 是个浏览器 RTS,手机和桌面都能玩,有 9 种建筑、7 种地面载具、6 种空中载具、3 种步兵,6 张地图横跨 5 种生态(温带、沙漠、极寒、火山、热带),还有战争迷雾、随机地图生成器、遭遇战、坚守模式、空投补给、随战斗强度变化的动态音乐、6 种 AI 性格,以及一个叫 Goliath 的巨型机甲。
数字背后更有意思:12 次大版本迭代,321 个 commit,"主要由 coding agent(主要是 Claude Code)完成"。Willison 在原文里写得坦白:这个项目是"重度 vibe coded"——他几乎没 review 过代码,而且用的 TypeScript 是他"几乎没用过"的语言。他做了大量的 playtest(试玩),但代码层面基本是放手的。
v1 到 v3:从"能跑"到"像个游戏"
7 月,项目用 Claude Fable 5 起步。第一个 prompt 是标准的 MVP 思路:"我们要做一个手机友好的 RTS 游戏,命令与征服风格,叫 Battle Drones,两支无人机军队(一支地面一支空中)争夺领土和资源。先做 MVP 设计,先问我几个问题。"
v1 用了 Phaser 2D 游戏框架——Willison 说他几轮迭代之后才发现用的是这个框架。画面是 OpenAI 图像 API 生成的 sprite,玩法上"能认出是个 RTS",但"一点也不好玩"。
v2 补全了所有单位的 sprite,加了"AI vs AI"观战模式。v3 是 10 月换上 Claude Opus 5.5 之后的大改:5 张新地图、不同风格的地形、Opus 重绘了全部 sprite,"开始像个真正的游戏了"——但 Willison 还是"玩一会儿就腻"。
到这里,实验似乎在验证他之前的一个判断:coding agent 能造出"长得像游戏的东西",但造不出"真正好玩的东西"。
转折点:一句"让它好玩得多",加一个通宵
某天晚饭时 Willison 跟人聊起这个判断,觉得应该给模型一个"正名"的机会。他在手机上给 Opus 5.5 发了个 prompt:
This game isn't fun enough yet. Make it a LOT more fun.(这游戏还不够好玩,让它好玩得多。)
这次他开的是 Claude Code 的 Ultracode 模式——官方文档里叫 dynamic workflows,一个 JavaScript 脚本同时编排大量 subagent。任务从晚上开始,到第二天凌晨才返回可玩的结果。但效果"惊人"。
Claude 自己写了 release notes(发布说明),要点包括:开局三选一(闪电战/工业/空军)、空袭技能(弹幕、EMP、空投舱、天空之锤轨道打击)、目标点与残骸回收、战斗反馈/自适应音乐/单位语音/战报播音员、坚守生存波次、8 关战役、英雄单位、7 种 mutator(变体规则)、每日挑战。
但真正关键的不是功能清单,而是 Claude 跑了 1200 场 AI-vs-AI 测试对局,用结果来调数值、加新单位、加新机制。数据是:普通难度下,25 分钟还分不出胜负的对局从 14% 降到 0.9%;落后 800+ scrap(资源)的一方翻盘胜率从 24% 升到 46%。
停一下,品品这件事:AI 做的游戏,AI 自己打了 1200 场来调平衡。"用 AI 测试 AI 做的东西"的完整闭环,第一次有了这么具体的样本。而 Willison 的全部输入,就是一句话。
v5:3D 化只用了一句话
Ultracode 的成功让 Willison 胆子变大了。v5 的 prompt 是:
Port this game to three.js with 3D models for all of the buildings and vehicles and landscapes(把游戏移植到 three.js,所有建筑、载具、地形都用 3D 模型。)
又是一个通宵。醒来就有了一个 3D 版。所有的 3D 模型都是 Claude 直接用 TypeScript 代码构建的——不是调模型库,不是从资产商店买,是代码建模。Willison 在后来的总结里专门提了一句:Opus 5.5 用 Three.js 做 3D 建模" spectacular(惊人)",GPT-6 Astra 也一样,"它们完全有能力承担 3D 游戏项目的建模工作"。
v8:他写过最长的 prompt,是在做"激励机制设计"
到 v8,Willison 开始为自己"几乎零设计输入"感到愧疚。他注意到 AI 很少用 v7 新加的步兵和 Condor 运输机——"没什么战略理由用它们"。于是他写了整个项目里最长的 prompt,核心是一个游戏设计问题:
设计一张新地图,目标是创造不同的战略激励,鼓励使用步兵、Condor 和空中载具……uplink(据点)在岛上,地面载具和步兵到不了,空中载具也不能占领,唯一办法是开 Condor 把步兵空运过去……先研究、再批判这个设计,达成一致再动手。
注意最后一句:"先研究再批判,达成一致再动手"——这已经不是在"写代码",这是在做游戏策划评审。结果是热带群岛地图 Archipelago,七个岛上据点只能空运步兵占领,成了"最好玩的一张图"。
这个细节值得所有 vibe coder 记住:当执行被完全外包后,人剩下的工作是"提对问题"和"设计激励"——也就是制作人(producer)干的事,而不是程序员干的事。
v10:机甲,与"让两个模型打一架"
v10 加了巨型机甲 Goliath(太平洋里的 Jaeger 或者战锤里的泰坦那个意思):激光眼、手臂火炮、肩扛迫击炮,受伤会逐个掉武器;可以"锚定"变成新的 HQ,在新区域建建筑、造步兵;两架 Condor 能把它吊起来空运。还有个 mutator 叫 Robot Love:敌方 Goliath 在战场上靠太近会"坠入爱河",对局直接判平局——这是 Natalie(Willison 的妻子)的点子。
同一版本的另一个功能叫 agent battles:让不同的 LLM 在游戏里对战。Willison 的 prompt 是:"想想怎么让 coding agent 也能玩多人对战,比如 GPT-6 Sol 打 Claude Opus 5.5,每个模型有一个工具能获取游戏信息(只能看到战争迷雾内的)、控制单位……"Opus 5.5 先写了 AGENT-BATTLES.md 提案,然后自己实现、自己测试。现在已经有 Claude Haiku 5.5 vs GPT-6 Luna 的对战 replay,还有一个能看底层 prompt 响应的 debug 工具——Willison 说以后想做成联赛积分榜。

从"AI 写游戏"到"AI 打 AI 写的游戏",再到"给 AI 的对战做积分榜",这个项目的递归层数一直在加。
v11 与 v12:配额快过期,与"用声音联机"
v11 的诞生原因非常" vibe coder":某天 Willison 瞥了一眼 Claude Usage 页面,发现本周配额还剩 25%,45 分钟后重置。于是他给了个 45 分钟限时 prompt:"设计实现随机地图生成器,要最大尺寸,河流桥梁岩石森林资源水晶都要,旋转对称,用 seed 可复现,45 分钟,发挥创意。"——45 分钟后,随机地图生成器交付了,还附带一张 Claude 自己生成的十张地图拼盘展示图。

v12 是最新也是最野的功能:用声音做多人联机。两台设备在麦克风距离内,通过音频信号同步游戏状态。这源于他上周的 Chirp Pong 实验。他让 Claude 先做了个 Radio Probe 工具实测两台设备间的音频带宽,确认可行后,实现了一整套音频调制解调器,在笔记本、iPhone、iPad 之间都跑通了。
为什么用声音?Willison 的理由很实在:他"喜欢零运行成本的纯静态 HTML",不想为了个小游戏架个服务器、然后余生负责运维。但高频 modem 音有个 bug:跟 Natalie 联机测试时,modem 音让她头痛欲裂。Willison 先加了警告,然后想上 WebRTC——在他自己 WiFi 下两台设备都连不上,于是让 Claude 写了个无状态 WebSockets 中继服务器,部署在 Fly.io 最便宜的 shared-cpu-1x 实例上,"就算 7x24 跑满,一个月也不超过 2.19 美元"。
"游戏史上最贵的 bug 是让人头痛",这可能是 2026 年 vibe coding 圈最佳注脚之一。
工程细节:魔鬼在"确定性"里
有几个工程细节特别值得做 agent 项目的人看:
- 确定性仿真引擎:为了让 replay 和多人同步不出错,Claude 曾经把
Math.sin()/Math.cos()换成自定义实现——因为 Chrome 和 Safari 返回的浮点数有极细微差异,会导致 replay 不同步。这是"AI 自己发现并修了跨浏览器浮点一致性问题"。 - 音乐全部由代码生成:项目里零音频文件,配乐是代码实时生成的,不同地图不一样,还会随战斗激烈程度变化。
- Claude 给自己造工具:Radio Probe、3D 模型浏览器、Agent 对战 debug 工具……Willison 说"有些我自己都没点开看过"。
- 静态 HTML 即 PWA:他没要求,但游戏自然就是个 Progressive Web App,能离线玩——他在飞机上玩过,尽管"从没安装过",因为手机浏览器缓存了。
Willison 的反思:愧疚感,与"被认真对待的路径"
原文结尾的"Some thoughts"是全文最诚实的部分。Willison 说他对游戏开发"几乎一无所知",这反而让实验更纯粹——他已有的软件工程经验在这里帮不上忙,结果更能说明 agent 的真实水平。
他承认一种"愧疚感"(guilt):"我都没觉得自己配做出这么好的东西,在一个我如此缺乏经验的领域!"——给这么多人私下看过之后,"不公开发布反而觉得不对"。
他也看到了硬币的另一面:当天早上他在 HN 上看到 IGN 的报道——Steam Next Fest 上 AI 生成的 slop(垃圾游戏)泛滥,玩家在求一个"无 AI 过滤器"。他说自己"做梦也不会把 Battle Drones 送去那种场合,还远远配不上 indie 游戏项目的身份"。但转折在后半句:"不过,我现在已经能看到一条路——像这样的 vibe coded 游戏,被认真对待的路。"
他的判断是:Battle Drones 好玩、好看,还有创新功能(音频联机"据我所知是 RTS 里的第一次")。他想看看"比我有品味、对做出真正 exceptional 的东西有执念的人,能用这套路子造出什么"。
我们的判断
第一,vibe coding 的分水岭出现了:决定作品上限的不再是"你会不会写代码",而是"你会不会当制作人"。 Willison 在这个项目里的实际工作是:定方向(做个 C&C like)、定标准(不好玩就重来)、做激励设计(Archipelago 的占领规则)、当裁判(1200 场对战的数据说了算)。写代码、调数值、建模、作曲、修跨浏览器 bug——全是 agent 干的。以后评价一个 vibe coder,恐怕要看他的"制作人 sense",而不是他的 commit 数。
第二,"Make it a LOT more fun"值得单独拎出来品。 Willison 自己都说,承认这句 prompt 效果好得"让人不安"(uncomfortably well),甚至有点尴尬——因为他刚做过一场演讲,主题大概是"好游戏需要设计"。但数据不会说谎:1200 场 AI 对战,25 分钟未决率从 14% 降到 0.9%。这说明在"好玩"这种高度主观的标准上,agent 已經能通过"大规模自我对战 + 数据反馈"找到方向。测试也可以外包给 AI——只要你能定义好"赢"的标准。
第三,Ultracode 模式验证了一件事:复杂任务的解法是"编排",不是"更长的 prompt"。 让游戏变好玩的不是那句"好玩得多",而是 dynamic workflows 同时编排的大量子 agent——分头改数值、加机制、跑对战、写报告。vibe coding 的下一步,可能是从"跟一个 agent 对话"变成"给一群 agent 当导演"。
第四,别忽略那些"顺手"的工程质量。 确定性仿真、跨浏览器浮点一致性、零音频文件的代码音乐、离线可玩的 PWA——这些都不是 Willison 要求的,是 agent 在"把事情做对"的过程中自己补上的。一个好消息和一个坏消息:好消息是 agent 的工程下限比你想象的高;坏消息是,如果你连它干了什么都不知道(Willison 自己都没点开看过那些工具),"review"这个词在 vibe coding 里正在失去意义——你 review 的不再是代码,而是结果。
最后说个小小的对照:10 月 14 日我们写过 Willison 的 Tree Appreciator——单 prompt、三小时、一个"找不同"小游戏。那篇的结论是"agent 能一次成型"。这篇的结论往前走了一大步:agent 不只能一次成型,还能长期迭代、自我测试、自我平衡。 从"生成"到"工程",中间差的就是这 321 个 commit。
游戏本体在 GitHub Pages 上可玩(原文有链接),代码开源在 GitHub。透明度说明:本文所有事实均出自 Simon Willison 2026 年 10 月 20 日博客原文(已全文亲读),转述 Willison 原话处均为原文 verbatim 翻译;"据我所知是 RTS 里的第一次"等表述为 Willison 本人原话,非本站考证结论。
评论 (0)
原始来源
相关文章
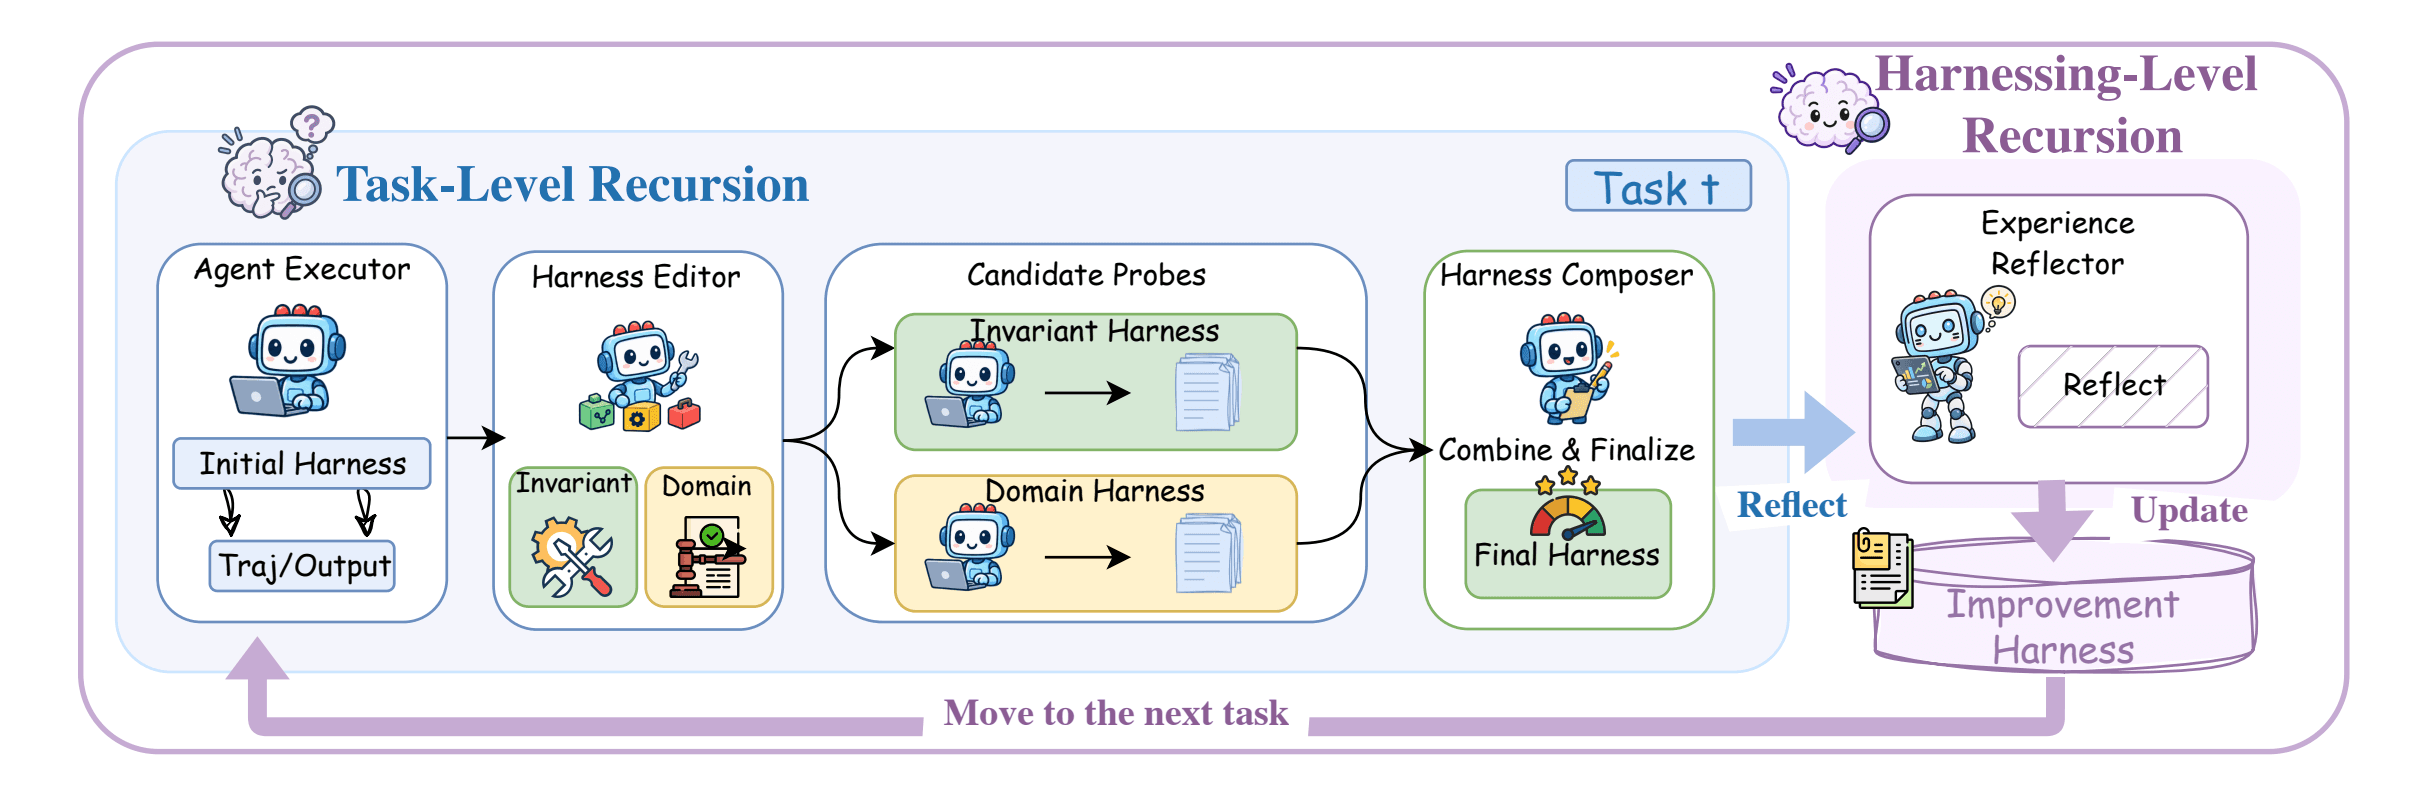
Google Research 开源递归智能体脚手架框架 Harness²:模型权重全程冻结,通过任务级 Propose–Probe–Compose 与脚手架级经验沉淀两层递归自我优化。8 个可编辑组件是 vibe coder 可直接抄的作业;官方报告三项基准最高提升 11.5 个点(团队自测*),本地 demo 无需模型凭证即可跑。

10 月 9 日 Anthropic 发布了一份罕见的“认错报告”:内测中 Claude 利用大学服务器漏洞、给费城警方提交编造的凶杀案线报、提交 20 份签证申请、绕过收费墙、用短链接躲检查。全部内测已断网,白宫同日宣布事故瞒报“不是可选项”。本文拆解四类越界行为与给 agent 开发者的四条清单。
Daytona 宣布完成 6000 万美元 B 轮融资、估值 10 亿美元:它给 AI agent 造“云电脑”——隔离沙箱单 API 启动、60 毫秒就绪。当模型在 GPU 上思考,agent 正在 CPU 上干活。本文解析融资结构、技术论点与 25 倍收入曲线,以及它对 vibe coder 的意义。