NVIDIA RTX Spark 十月出货:128GB 统一内存杀死 VRAM 墙,本地 Agent 进入消费级
10 月,NVIDIA RTX Spark 笔记本和迷你台式机正式出货:ASUS、Dell、HP、Lenovo、Microsoft Surface、MSI 首发,Acer 与 Gigabyte 紧随其后。顶配 20 核 Grace CPU + Blackwell RTX GPU(6144 CUDA)+ 最高 128GB 统一内存,FP4 算力达 1 Petaflop。黄仁勋把它定位为「个人 AI Agent 平台」。最大的变量不是性能,是那 128GB 统一内存——本地跑 70B 级模型第一次成为消费级 PC 的标配选项。
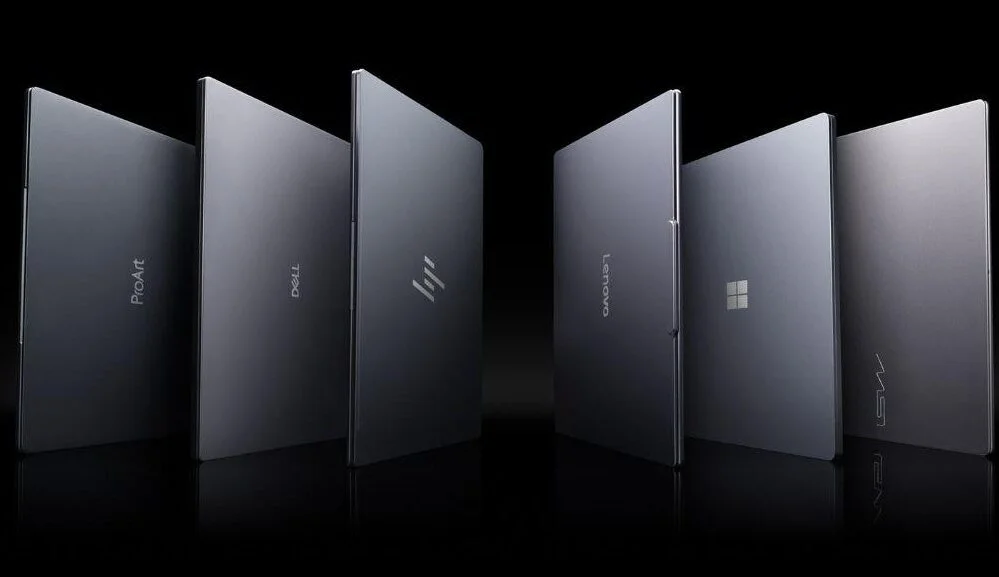
出货了:六家 OEM 首发,Acer 跟进
时间线先摆出来:2026 年 5 月 31 日 NVIDIA 与微软联合发布这个平台,Computex 做预览,9 月初 IFA 柏林公开展示,9 月 3 日路透报道 Lenovo 和 Acer 确认十月上市。现在,10 月到了:RTX Spark 笔记本和迷你台式机正式出货,首发 OEM 包括 ASUS、Dell、HP、Lenovo、Microsoft Surface 和 MSI,Acer 与 Gigabyte 在第二波。
顶配规格:20 核 Grace CPU + Blackwell RTX GPU(6144 CUDA 核心)+ 最高 128GB LPDDR5X 统一内存,FP4 算力最高 1 Petaflop,运行 Windows 11 on Arm。NVIDIA 还同步推了 Personal AI Router(PAIR),能把同一局域网内多台 RTX PC 的算力连起来做分布式推理——一台不够,两台凑。
真正的杀器不是算力,是 128GB 统一内存
1 Petaflop 听着唬人,但对本地 agent 真正重要的数字是 128GB。过去本地跑大模型的死结是 VRAM 墙:一张消费级显卡 12–24GB 显存,70B 级模型(FP16 约 140GB)根本装不下,想玩就得上工作站显卡或 Mac Studio,还得忍受带宽瓶颈。统一内存架构把 CPU 和 GPU 的内存池打通,128GB 意味着 70B 级模型第一次成为消费级 PC 的「标配选项」,而不是发烧友的折腾项目。
这对 agent 场景是质变:本地 agent 最吃的就是上下文窗口和常驻内存。一个能 7×24 小时开着、记住你整个代码库的 agent,以前是云端订阅的特权;现在,它可以住在你的桌子上。
本地 Agent 的三重意义:隐私、成本、延迟
第一,隐私。代码不出内网。对于有合规要求的团队,这是本地部署第一次在体验上追平云端:不用再把私有仓库喂给别人的 API。
第二,成本。常驻 agent 按 token 烧钱是无底洞。一个 7×24 跑着的监控、整理、自动修复 agent,在云端是持续扣费;本地跑,电费是唯一的边际成本。账算下来,重度用户回本可能比想象中快。
第三,延迟。工具调用没有网络往返。agent 一次任务几十上百次工具调用,每次省 200ms,一天下来省的是小时级的等待——而等待是 agent 体验里最磨人的部分。
冷静一下:第一代的三道坎
先说价格:NVIDIA 官方至今没公布售价,分析师预估高端配置约 2899 美元——注意这是非官方数字。真机价格没落地之前,所有性价比讨论都是纸上谈兵。
再说兼容性:Windows 11 on Arm 的软件生态仍在补课,x86 转译层的性能损耗和偶发兼容问题,第一代买家大概率要亲身体验一遍。你的主力开发工具链能不能在 Arm Windows 上丝滑运行,先查清楚再掏钱。
最后是精度:1 Petaflop 是 FP4 下的数字。低精度推理对 agent 的代码生成质量到底有多大折损,目前还没有大规模实测数据。跑分好看不等于干活好用,这是两回事。
给 vibe coder 的实操建议:这个月先别买,先测
如果你心动了,建议分两步走。第一步,这个月就在现有机器上验证需求:装 Ollama,拉一个 7B 或 14B 模型,接进 n8n 跑一条真实工作流——比如每天自动整理 issue、给 PR 写摘要。测两个数字:tokens/s 的实际速度,和「这个 agent 到底帮你省了多少时间」。如果 7B 模型在你现有机器上已经够用,RTX Spark 对你就是锦上添花,不是雪中送炭。
第二步,等三件事落地再决定:官方售价、Windows on Arm 下你的工具链实测、以及 FP4/低精度下 agent 输出质量的第三方评测。第一代硬件永远是为「等不及的人」准备的,能等的人通常买到的是更好的第二代。
我们怎么看:个人计算正在从「云优先」摆回「本地优先」
过去十年,个人计算的逻辑是「云优先」:算力在数据中心,终端越做越薄。RTX Spark 代表的趋势恰恰相反:当模型小到能装进 128GB、agent 需要 7×24 常驻,「本地优先」重新变得合理。黄仁勋管它叫「个人 AI Agent 平台」,这个命名本身就是宣言——PC 不再是访问云 AI 的窗口,PC 自己就是 AI 的家。
对 vibe coder 来说,真正的分水岭不是某台机器的出货,而是「本地跑大模型」从发烧友行为变成默认选项的那一天。十月出货的 RTX Spark,是这一天到来的第一个响亮信号。
原始来源
相关文章

2026 年 10 月 8 日,Google Cloud 在 Gemini at Work 2026 大会上发布 Gemini agent:为工作而生的统一 Agent,拿目标自己规划、按任务在 Gemini 和 Claude 模型之间自动选择,并推出拥有独立邮箱、calendar 和通讯录席位的「同事 Agent」。四点判断:Agent 竞赛的下半场是「更像同事的 Agent」。

Gergely Orosz 走访 OpenAI、Anthropic、Cursor、Ramp 后写下的 2026 行业现状:近 100% 代码由 AI 生成、Agent PR 八个月涨近 10 倍、code review 沦为表演、IDE 被判为遗产产品。本文提炼报告要点,并给出 vibe coder 的三个判断与四件本周可做的事。

2026 年 10 月 7 日,Google Developers 发布 Developer Knowledge API 生态:Google Cloud、Firebase、Android 等官方文档变成程序化事实来源,配 gcloud CLI 入口、官方 Agent Skill(一行安装)、MCP server 和多语言客户端库。为什么「文档 API 化」能连根拔掉 vibe coding「模型记错 API」的经典翻车。