OpenAI 开发者周报:一句话定制音色 + agent 预热沙箱
OpenAI 10 月 12–16 日面向开发者的三连更新:10-12 Agents API 支持沙箱预热(创建 environment、等 ready、创建 session 时传 environment_id;预热免费,但未挂载沙箱 5 分钟过期);10-15 GPT-Live 原生集成 Decisions API,可在通话人还没说完时触发结构化决策;10-16 上线 prompt-to-voice——一句话描述生成可复用的 GPT-Live 定制音色,创建免费、通话按正常费率计费,并新增德/法/印地/日/韩 9 个预置声音。边界:提示词生成的音色只能用于 GPT-Live,每组织上限 100 个,且须向用户披露是 AI 声音。
一句话:做语音 agent 的两大"慢活",OpenAI 这周一次全包了
2026 年 10 月 12 日到 16 日,OpenAI 在开发者侧连发三条更新,目标用户高度一致——做语音 agent 和 coding agent 的开发者:10 月 12 日,Agents API 支持预热沙箱(pre-warm sandboxes);10 月 15 日,GPT-Live 原生集成 Decisions API;10 月 16 日,GPT-Live 上线 prompt-to-voice(一句话定制音色),同时新增 9 个多语言预置声音。
先做必要的划界:本站此前报道过微软 MAI 语音技术栈(10 月 1 日)和 Sesame 的端侧语音助手——那两篇分别是微软的语音模型布局和 Sesame 的消费级语音助手产品。本篇只讲 OpenAI 开发者 API 这一条线:GPT-Live 的语音能力更新 + Agents API 的沙箱预热。厂商不同、产品形态不同,不混为一谈。
再做必要的透明度声明。撰稿人于 2026 年 10 月 22 日对一手来源做了二次验证:其中沙箱预热的 OpenAI Developer Community 官方帖(October 12, 2026, 5:22pm)已亲开确认,无变化;GPT-Live 的三条更新来自 OpenAI 官方 API changelog,但 changelog 本页在公开搜索中未拿到可直接打开的完整 URL,@OpenAIDevs 的原帖同样无法直接打开。所以正文里凡是"changelog 说",均为"经多家媒体引述 OpenAI 官方文档"——pondero.ai、Tech Times、digitalapplied.com、rohitai.com、voiceaispace.com、AI Dev Weekly 六家独立信源,对 10 月 15 日(Decisions 原生集成)、10 月 16 日(prompt-to-voice + 9 个新声音)两个日期的引述完全一致,事实口径也一致。读者如需核对原文,可在 OpenAI API changelog 按这两个日期查找对应条目。
prompt-to-voice:定制音色的第三条路,不用录音了
在 10 月 16 日之前,想让 GPT-Live 说出一个"属于你产品"的声音,只有两条路:第一条,用 OpenAI 的预置音色——拿来即用,但全世界用同一个声音的产品都在用它,品牌辨识度为零;第二条,走录音克隆流程——找真人录授权音频,但这条路只对符合条件的客户开放,又慢又重。对绝大多数做电话客服、语音助手的团队来说,现实是:要么忍受"和别人撞声",要么去走配音演员 + 录音棚 + 授权流程的老路。
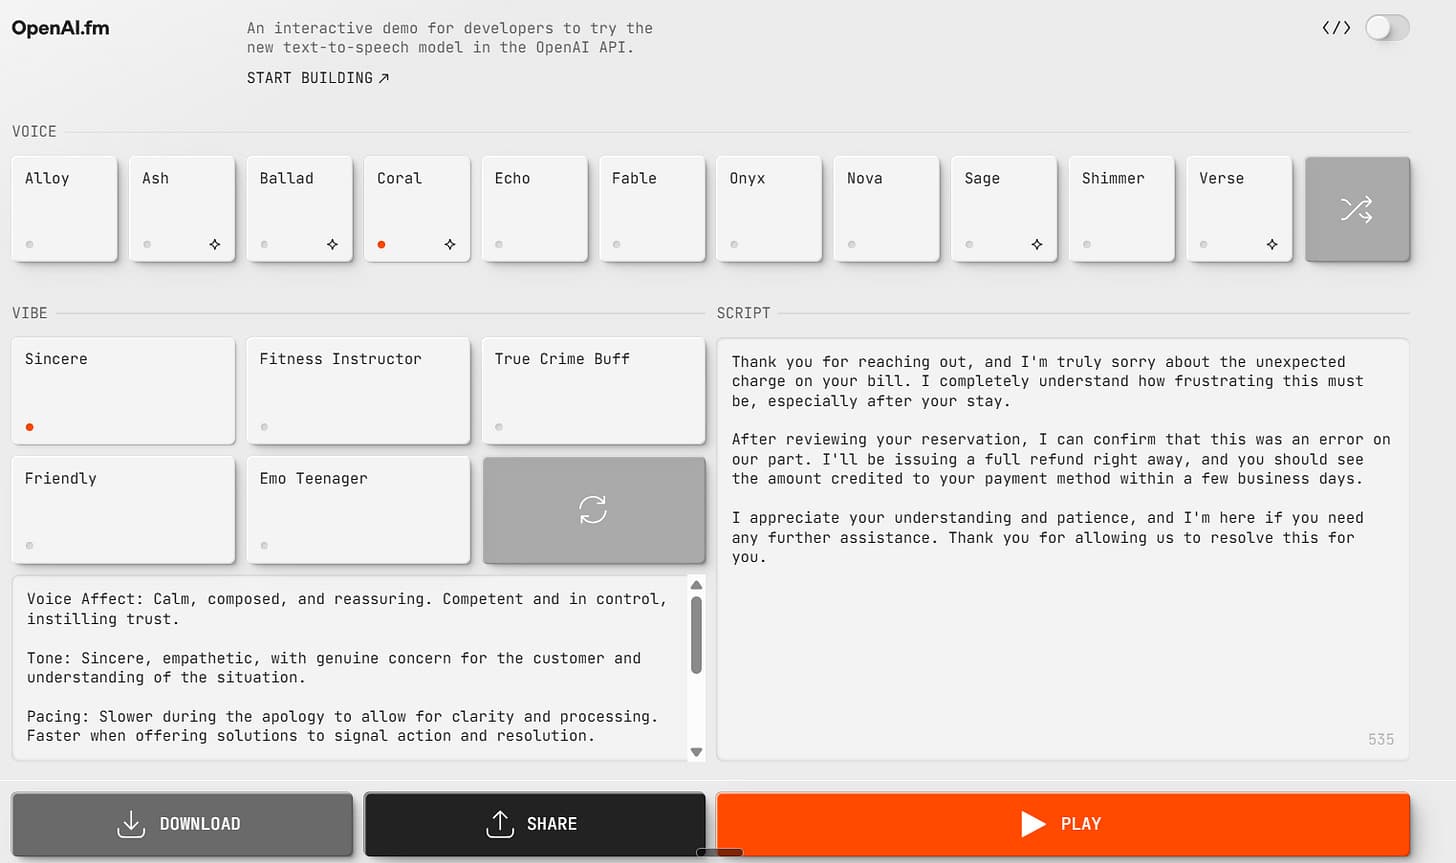
prompt-to-voice 是第三条路:向 /v1/audio/voices 发一段文字描述,比如"带轻微印度口音的沉稳客服声音",API 生成并保存一个可复用的 voice ID;不想写代码的团队,也可以在 voice Playground 里无代码操作。创建这个声音免费,之后用它说话,按正常 GPT-Live 会话费率计费(语音层约 0.05 美元/分钟)。
这个更新最妙的地方不是"又多了一个功能",而是它把"音色"从一种资产(要录制、要授权、要管理音频文件)变成了一段提示词。写过 vibe coding 的人对这个味道应该很熟:描述即实现。你不再需要为一个品牌声音立项、排期、走采购,现在是写一句话、调几次描述、听到满意为止。迭代音色的成本从"周"变成了"分钟",这才是它真正的杀伤力——它消灭的不是某个竞品功能,而是"定制音色"这件事本身的项目管理开销。
但边界必须写清楚,因为这里有个容易踩的坑。prompt 生成的音色只能用于 GPT-Live,不能用于 OpenAI 的 TTS 接口、Realtime 接口或 Chat Completions 的音频能力;每个组织最多保留 100 个;OpenAI 政策要求必须向终端用户披露这是 AI 声音。翻译成大白话:你用一句话捏出来的声音,是锁在 GPT-Live 生态里的,带不走、导不出。你的客服系统如果一半走 GPT-Live、一半走别的语音栈,这个声音过不去那道墙。选型之前先想清楚:你的语音 agent 未来三年是不是就押在 GPT-Live 上?如果是,这条路极香;如果不是,它就是一颗甜蜜的锁链。
三条音色路线,一张表看完
| 路线 | 成本 | 限制 | 适合谁 |
|---|---|---|---|
| 预置音色 | 零创建成本,按会话计费 | 和所有用它的产品"撞声",无品牌辨识度 | 快速验证 MVP、对声音没要求的内部工具 |
| prompt-to-voice(新) | 创建免费,通话按正常 GPT-Live 费率(语音层约 $0.05/分钟) | 仅 GPT-Live 可用;每组织最多 100 个;须向用户披露是 AI 声音 | 要品牌辨识度、但不想走录音流程的电话客服与语音助手 |
| 录音克隆 | 录音、授权、人力成本最高 | 仅限符合条件的客户,需真人授权录音 | 必须用特定真人声音的场景(如 IP 形象、代言人) |
这张表里藏着一个选型建议:先别急着捏定制音色,先去听 10 月 16 日新增的 9 个预置声音。多语言团队尤其如此——这 9 个声音覆盖德语(Nuri、Juni、Flitz)、法语(Brise、Sillage)、印地语(Nira)、日语(Harema、Shida)、韩语(Noeul)。如果你的客服要接德语电话,Nuri 可能已经够用了,省下一整套定制流程。预置声音是零创建步骤的,别为了"定制"而定制。
注意一个容易混淆的划界:10 月 15 日 OpenAI 还在 ChatGPT 端推了 GPT-Live-1.1,带 13 个新声音(法语、德语、印地语、日语、韩语、墨西哥西班牙语各 2 个,外加英语的 Bubbie)。那是 ChatGPT 消费端的更新,和开发者 API 是两条线——API 侧的模型还是 gpt-live-1,API 侧新增的是上面这 9 个。看新闻时别把两边的声音名单混在一起数。
10 月 15 日:GPT-Live 原生集成 Decisions API,通话人没说完就能决策
prompt-to-voice 解决的是"声音像谁",Decisions 集成解决的是"反应有多快"。此前 GPT-Live 要在通话中做结构化决策,流程是:GPT-Live 先通知开发者的自家后端,等后端去调 Decisions API 拿到结果,再把结果喂回通话——一次完整的往返,发生在用户正在说话、等着回应的几百毫秒里。现在 GPT-Live 可以直接调用 Decisions,省掉了中间这一跳。
技术细节上,开发者把触发器挂在转录事件上:session.input_transcript.delta(通话人还没说完时)或 session.output_transcript.delta(GPT-Live 自己回应时),每个触发器返回一小组选项——比如一种表情、一个强度等级、一个手势。用大白话说:客服 agent 可以在用户话音未落时,就决定"这句话该用什么语气接",而不是等整句话说完、后端跑一圈再回来。
为什么这事值得单独拿出来说?因为做语音 agent 的人最痛的第二个点,就是"实时决策要自己搭后端"。语音交互的延迟预算是以百毫秒计的,每多一次后端往返,都是用户能感知到的"嗯……那个"。OpenAI 把决策能力下沉到通话链路里,等于把一部分原本属于"你的后端"的活收编了。对小团队这是利好——你不用再为"实时反应"单独搭一套低延迟服务;对已有复杂后端的团队则是提醒:检查一下你的决策链路里,有多少跳是可以被这条原生集成吃掉的。
10 月 12 日:Agents API 预热沙箱,免费但要掐着点
第三条更新不在语音线,但在 agent 基础设施这条线上同样实在:Agents API 现在支持预热(pre-warm)OpenAI 托管的沙箱。流程三步:创建 environment → 等它 ready → 创建 session 时传入 environment_id。效果是用户请求到达时,沙箱已经是热的,session 可以直接挂载,省掉冷启动那几秒。
定价策略很有意思:预热免费——在你把环境挂到 session 之前,不收费。但有两个过期时钟要掐着点:没挂载过的沙箱环境 5 分钟后过期,用过一次的 session 空闲 20 分钟后过期。翻译一下:预热不是"提前一小时准备好等着",而是"掐着用户可能来的时间点提前几十秒创建"。这是一个典型的成本账设计——OpenAI 把算力空转的成本转成了开发者的时序设计成本。你的调度逻辑里要多一件事:在预期流量前创建环境,流量低谷别白占着。
官方同时给了另一条路线:自托管沙箱(self-hosted sandboxes),文档覆盖配置、依赖包、文件、算力、网络全套说明。对数据不能出内网、或已有成熟容器编排的团队,自托管是更长期的答案;对想快速验证的团队,托管预热是零运维的捷径。两条路官方都铺好了,选哪条看你的合规和运维家底。

竞争视角:OpenAI 在从第三方手里拿回"声音层"
还有一个值得玩味的行业信号。过去两年,"给 AI 配一个好听的专属声音"这件事,实际是被 ElevenLabs 这类第三方语音公司吃掉的——它们的卖点就是音色克隆、音色市场、多语言。OpenAI 的 GPT-Live 模型能力不差,但声音侧一直只有"预置音色"和"重型录音克隆"两个极端,中间巨大的"想要有点特色但不想折腾"的市场,等于拱手让人。
prompt-to-voice 就是 OpenAI 杀回中间地带的武器。它不跟 ElevenLabs 拼录音棚级的克隆精度,而是用"一句话生成"的低摩擦,把那批"想要品牌感但没预算立项"的长尾团队截留在自家生态里。配合 9 个多语言预置声音(德语 3 个、法语 2 个、日语 2 个、印地语和韩语各 1 个),OpenAI 的策略很清晰:先用预置声音覆盖"够用"场景,再用 prompt-to-voice 覆盖"想要特色"场景,只把"必须真人声音"的硬骨头留给录音克隆。三层漏斗,每一层都尽量不让用户流到第三方去。
对开发者的实际影响是:如果你现在的语音栈是"OpenAI 管对话 + 第三方管声音"的拼接架构,这次更新值得重新算一笔账。拼接架构的隐性成本不低——两套计费、两处延迟、两份合规(声音那份尤其麻烦)。prompt-to-voice 让"全栈 OpenAI"的选项第一次在声音层也成立了。当然,反过来也成立:如果你已经深度绑定了第三方的声音资产(比如训练好的专属音色库),迁移到 GPT-Live 意味着重建——这笔账要按你的声音资产规模来算,没有标准答案。
一个 vibe coder 这周就能跑通的工作流
把三条更新串成一条完整的工作流,看看一个独立开发者这周能做出什么。假设你要给自家小店做一个电话客服 agent,接德语和英语电话:
第一步,定声音(10 分钟)。先去听 10 月 16 日新增的 9 个预置声音,德语的 Nuri、Juni、Flitz 大概率有一个合你胃口。合用就直接拿走,零创建步骤;不合用,再用 prompt-to-voice 写一句描述捏一个——"语速稍慢、道歉时更柔和的德语客服声音",创建免费,多试几次不心疼。记住每组织 100 个的上限,给声音起好名字,别捏一堆"test1、test2"占坑。
第二步,接实时决策(半天)。把原来"GPT-Live 通知后端 → 后端调 Decisions → 结果回填"的那段胶水代码删掉,换成原生集成:触发器挂在 session.input_transcript.delta 上,让 agent 在用户话还没说完时就决定用什么语气接。省掉的不只是一次网络往返,更是整整一个需要你维护的低延迟后端服务——对独立开发者来说,少维护一个服务就是多一周的命。
第三步,预热沙箱(1 小时)。如果你的 agent 需要在沙箱里跑代码(查订单、改预约),在店铺营业高峰前创建 environment,等 ready,session 挂载时直接传 environment_id。用户打进电话,agent 秒回,而不是"请稍等,系统正在启动"。记得 5 分钟过期这条:别提前一小时创建,掐着高峰前几分钟来。
三步走完,你得到的是一个"声音是自家品牌、反应跟得上人说话、启动不用干等"的电话客服,而你写的胶水代码比上个月少了一大截。这就是这批更新对 vibe coder 的真实意义:它们不教你新概念,只帮你删代码。删掉的那部分,恰好都是以前"不得不自己搭"的脏活累活——配音流程、低延迟决策后端、冷启动等待。OpenAI 把脏活收编了,你只管写业务逻辑。
观点:OpenAI 在替你付两笔"体验税"
把三条更新放在一起看,OpenAI 这周干的其实是一件事:替开发者付掉语音 agent 链路里最难向老板解释的两笔"体验税"。
第一笔是品牌税。以前"我们客服的声音和别家产品一模一样"是个无解题——定制要录音,录音要立项。现在它变成了一句提示词,成本结构变了,决策链条就变了:以前定制音色是"要不要花两周立项"的问题,现在是"写三句话试试"的问题。当一件事的成本从"项目级"降到"尝试级",它的采用曲线会完全不同。这也是 prompt-to-voice 和 vibe coding 共享的那个味道:描述即实现,把原来需要跨职能协作的事,压缩成一个人的几分钟。
第二笔是延迟税。Decisions 原生集成和沙箱预热,一个吃掉通话中的后端往返,一个吃掉 session 建立时的冷启动,都是在"用户感知到的等待"上动刀。语音交互里,300 毫秒的迟疑用户听得出来,3 秒的冷启动用户直接挂电话。这些优化都不性感,没有一处是"模型更聪明了",但它们决定了一个语音 agent 是"能用"还是"好用"。基础设施的胜利从来都是这种样子的:不改变能力上限,只改变体验下限。
但硬币的另一面也要看清。prompt-to-voice 的 GPT-Live 锁定是一道真实存在的墙——你的声音资产和 OpenAI 的语音栈深度绑定,迁移成本在你按下"生成"的第一天就开始累积。100 个/组织的上限对大多数团队够用,但对做多品牌矩阵的团队(一个品牌一个声音、一个市场一个声音)要提前规划命名和复用。以及那条披露义务:必须告诉用户这是 AI 声音——这不是建议,是政策,客服话术和合规文档里要留位置。
沙箱预热这边,真正的成本不在钱(免费),在时序设计。5 分钟过期意味着你的预热逻辑必须和流量预测绑在一起:预测准,省下冷启动;预测偏,环境过期了等于没预热。对流量有明显波峰波谷的业务(比如客服的早晚高峰),这套机制很划算;对流量完全随机的业务,预热的命中率要先算一笔账再动手。
给读者的行动清单
1. 先听 9 个新预置声音,再决定要不要捏定制音色。德语 Nuri/Juni/Flitz、法语 Brise/Sillage、印地语 Nira、日语 Harema/Shida、韩语 Noeul——多语言客服团队大概率能直接找到合用的,零创建步骤。定制是好东西,但别为定制而定制。
2. 捏第一个 prompt-to-voice 时,把描述当 prompt engineering 做。"沉稳的客服声音"和"带轻微印度口音、语速稍慢、道歉时更柔和的客服声音"是两个不同的声音。写具体、可迭代,听到不满意就改描述重生成——反正创建免费。
3. 盘点你的声音资产锁定。如果你一半的语音流量走 GPT-Live、一半走别的栈,prompt 生成的声音过不去。选型前先回答:未来三年押不押 GPT-Live?
4. 检查通话链路里的后端往返。Decisions 原生集成吃掉的是一次"通知后端→调 Decisions→回填"的往返。把你现在的实时决策链画出来,数一数有几跳能被这条集成省掉。
5. 给预热沙箱算一笔命中率账。5 分钟未挂载过期、空闲 20 分钟过期——你的流量可预测吗?可预测就上预热,随机流量先小规模试再看。
6. 合规先行。AI 声音披露义务写进客服话术;自托管 vs 托管沙箱的选型,把数据合规要求摆在第一位。
最后回到开头那句大白话:OpenAI 这周没有发布更聪明的模型,但它让"做一个声音像自家品牌、反应跟得上人说话、启动不用干等的语音 agent"这件事,变便宜了一大截。对每天和 agent 打交道的开发者来说,这种更新比参数量新闻实在得多——因为它动的是你下周就能用的东西。
评论 (0)
原始来源
相关文章
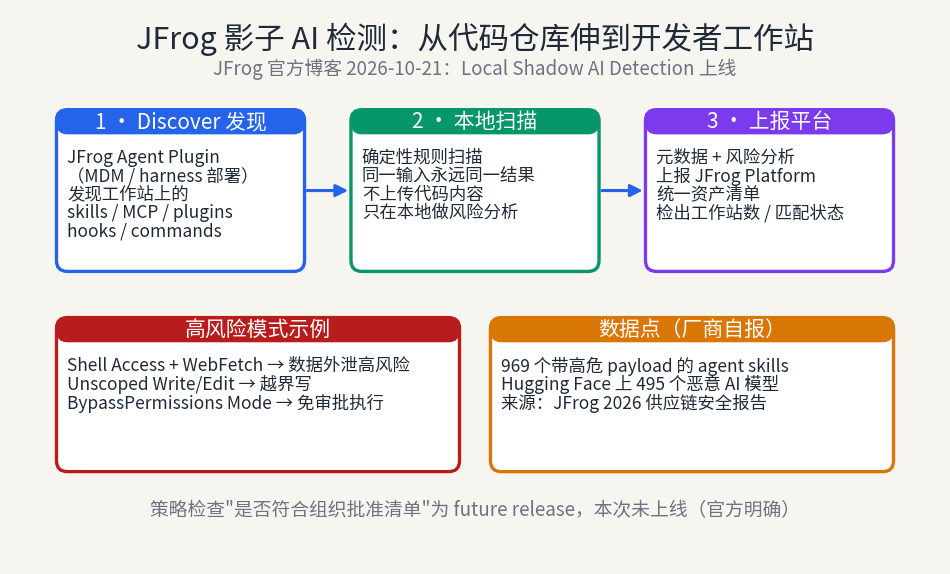
JFrog 把影子 AI 检测从仓库延伸到开发者工作站:Agent Plugin 发现笔记本上的 skills、MCP servers、hooks 等未注册 AI 资产,本地确定性扫描后上报统一清单。但“是否符合批准清单”的策略检查还在 future release——现在看得见,拦不住。个人开发者也该给自己做一份 skill 资产清单。
2026 年 10 月 21 日 Anthropic 官宣 Claude Duet 进入研究预览:每天晨间简报、白天每隔几小时检查已连接应用,发送付款签名删除前必须展示原稿等你确认,但证券交易和账户转账即使批准也不做。底层 Claude Opus 5.5,独立云端虚拟机加浏览器,你关机它照样跑。最值得细读的一句:Anthropic 选“几小时查一次”而非实时监控,理由是持续检查会更快烧光 Pro/Max 额度——这是独立开发者做常驻 agent 最真实的成本参照。
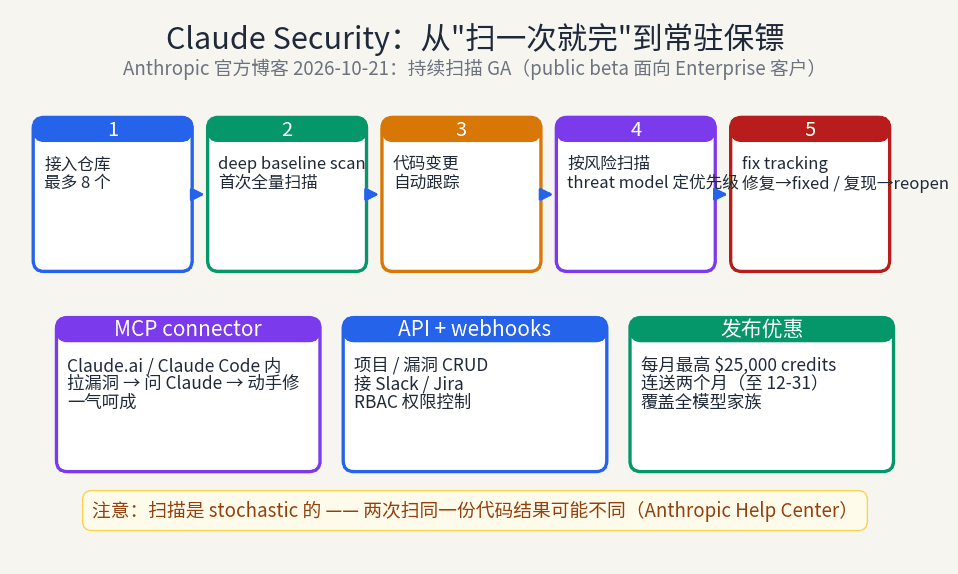
Anthropic 把 Claude Security 从手动触发的单次扫描升级为持续监控:先做深度基线扫描,之后自动跟踪每次代码变更;新增自动 fix tracking、按项目生成的 threat model,以及把漏洞处理搬进 Claude Code 会话的 API 与 MCP connector。对写代码飞快、却没人做安全 review 的 vibe coder 来说,这是缺失已久的"常驻"安全层——但它的非确定性扫描,也给"把扫描结果当门禁"的 CI 流程出了道新难题。