别急着写代码,先把 README 写了
一句话 prompt 丢给 AI,开工两小时,收获 40 个文件和一个你从没要过的登录页?问题不在 AI,在你没把“做完长什么样”定义死。这篇指南教你 README 驱动开发:开工前先写一份 Agent 友好的 README——一句话定位、5 分钟上手、架构地图、命令与环境变量表、Non-goals 五件套,再让 AI 动手。附四步实战流程、三个反模式和一份开工前检查清单。
一句话 prompt 开工,翻车是迟早的事
想象这个场景:周六上午,你心血来潮想做个小工具——把喜欢的播客转成文字,再自动生成一份 shownotes。你打开 AI 编程工具,敲下一句:“帮我做一个播客转文字并生成 shownotes 的工具。”然后去泡了杯咖啡。
回来时,Agent 已经吭哧吭哧建了 40 多个文件:前端框架、用户登录、付费订阅页、深色模式切换……你盯着屏幕,心想:我什么时候说过要登录了?更要命的是,转文字的核心流程反而藏在三层目录深处,跑都跑不起来。你让它“修一下”,它又加了 20 个文件。这就是“一句话开工”的标准结局:需求越模糊,Agent 的自由发挥空间越大。
问题不在 AI,在你给的输入。一句话 prompt 是愿望,不是规格。Agent 是个极其勤奋、但从不质疑你的实习生——你说“做个工具”,它理解的“工具”可能自带用户系统、后台管理和部署流水线。它不会问你“要不要登录”,它直接替你做了决定。
而 README 恰好站在反面:它是同一份文档,同时写给“未来的你”和“现在的 AI”看。为什么我说它是 vibe coding 时代最好的需求文档?三个理由:
- 人读得懂。Markdown 没有学习成本。你三个月后回来,照着“5 分钟上手”跑一遍命令,就知道这个项目还能不能跑、怎么跑。
- AI 读得懂。大模型的训练语料里,Markdown 文档的数量是天文数字。标题、列表、代码块这种结构,恰好是模型最擅长解析的格式——比你口头描述精准一个数量级,也比散落在聊天记录里的需求好找得多。
- git 里自带版本。需求变了?改 README,提交,diff 里清清楚楚写着“v0.2 把登录砍掉了”。需求文档和代码住在同一个仓库,再也不会出现“需求在飞书文档里、代码在 GitHub 上、两边对不上”的惨剧。
一句话总结:先把 README 写清楚,等于先把“做完长什么样”定义死。图纸定死了,施工队(Agent)才没法自由发挥。
一份 Agent 友好的 README 长什么样
别被“需求文档”四个字吓到。Agent 友好的 README 不需要长篇大论,它是一份填空式的骨架,五个部分,20 分钟就能写完。下面我用一个虚构项目做例子——PodMemo,一个“播客转文字并自动生成 shownotes”的小工具(纯属虚构,方便演示)。
第一部分:一句话定位 + 给谁用
开头三行,必须回答:这是什么、给谁用、解决什么痛点。Agent 读完这三行,就知道整个项目的“北极星”是什么,后面所有决策都有了参照系。
PodMemo:把任意播客 RSS 链接转成文字稿,并自动生成带时间戳的 shownotes。
给谁用:每周听 5 小时以上播客、想快速回顾要点的人。
不解决:实时会议转写——那是另一个产品。
第二部分:5 分钟上手
这是整份 README 里最关键的部分。每一行命令都必须复制粘贴就能跑,不能出现“自行配置”“详见文档”这种含糊话。记住:Agent 会照着这里的命令验证自己的产出。你亲手跑不通的命令,Agent 也一定跑不通。
git clone https://github.com/you/podmemo.git
cd podmemo
cp .env.example .env  # 填入你的 OPENAI_API_KEY
pip install -r requirements.txt
python -m podmemo --feed https://example.com/feed.xml --out ./notes/
看上面那段示例里带 --out 的那行:给一个真实能跑的例子,别写 --feed <你的播客链接> 就完事。Agent 会拿你给的例子做冒烟测试,占位符测不出任何东西。
第三部分:架构地图
画一棵目录树,每个目录配一句话职责。这是给 Agent 的“城市地图”——它以后改代码、加功能时,知道该去哪个文件,而不是把所有逻辑堆进一个 main.py。
podmemo/
├── fetcher/     # 拉取 RSS、下载音频
├── transcriber/  # 调用转写 API,输出带时间戳的文本
├── notes/        # 生成 shownotes:摘要、章节、金句
└── cli.py        # 命令行入口,唯一的对外接口
别小看这棵树。它提前回答了 Agent 最爱瞎猜的三个问题:代码分几层?新功能放哪里?对外接口是什么?
第四部分:命令与环境变量表
把所有命令和环境变量列出来。Agent 最怕“隐式知识”——那些只存在你脑子里、从来没写下来的东西。写下来,一条都别漏:
python -m podmemo --feed URL—— 转写单个播客源,输出到./notes/python -m podmemo --feed URL --lang zh—— 指定转写语言,默认自动检测OPENAI_API_KEY—— 必需,转写和摘要都用它,缺了直接报错退出NOTE_STYLE—— 可选,brief(默认,要点式)或detailed(详细版)
第五部分:非目标(Non-goals)
这是整份 README 里防 AI 加戏最关键的一节。明确写出“这个项目不做什么”,Agent 就失去了自由发挥的借口。写的时候问自己:如果 Agent 自作主张加功能,它最可能加什么?把那些全写进“不做”:
- 不做用户账号体系——单机工具,不联网同步
- 不做 Web 界面——命令行就是全部交互
- 不做实时转写——只处理已发布的播客音频
- 不支持视频平台——只认 RSS 和音频直链
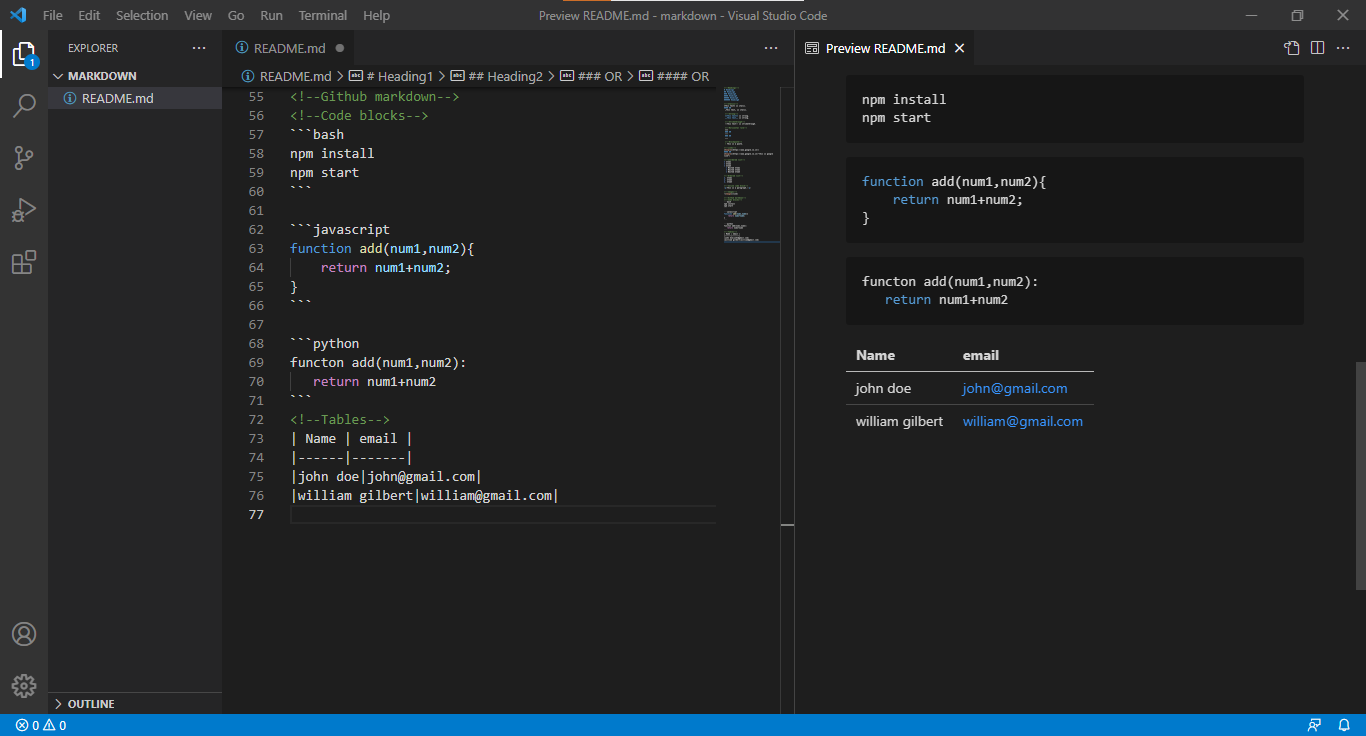
看到区别了吗?传统 README 是“写完代码后的装饰”,而这份 README 是“开工前的施工图纸”。Agent 拿到它,不需要猜你的意图,只需要执行。猜,是翻车的开始;执行,是交付的开始。
四步实战流程:从骨架到双向同步
骨架有了,流程是这样的。这是我自己真实用过的顺序,每一步都有坑,提前告诉你:
第 1 步:写骨架,20 分钟,别多。新建一个空的 README.md,把上面五个部分当填空题做。写不出来的部分先空着——空着本身就是一种信息,说明你还没想清楚。想不清楚的,先别让 Agent 动手。20 分钟写不完?说明这个想法还没成熟,先去散个步。
第 2 步:自己跑一遍命令。README 里“5 分钟上手”的每一条命令,你亲手跑通。这是你对 Agent 的承诺:图纸上的每一条线,在现实里都存在。你跑不通,Agent 一定跑不通;你跑通了,Agent 就有了一个可验证的验收标准。这一步最枯燥,也最值钱。
第 3 步:把 README 喂给 Agent 开工。prompt 可以极简,因为需求已经在文档里了。我常用的开工语只有一句:“按 README.md 从零实现这个项目;实现过程中如果发现 README 与现实冲突,先按合理的方式实现,并在 README 里标注出来。”其中给 Agent 更新文档授权的那句很关键——没有授权,Agent 默认不敢碰你的文档。
第 4 步:每个里程碑,让 Agent 同步更新 README。比如转写链路跑通了,你就说:“更新 README:把验证过的命令和实际目录结构写进去。”文档即契约,代码与文档双向同步。三个月后你回来,README 依然是真的,而不是一份“开工时的美好愿望”。
记住这个循环:人定方向(写 README)→ AI 施工(写代码)→ AI 回写文档(更新 README)→ 人验收(跑一遍命令)。你永远站在“定义做什么”的位置,AI 负责“做到”和“记下来”。分工一旦清晰,协作就顺了。
三个反模式,个个都见过
反模式一:README 写成营销稿。“PodMemo 是一款革命性的、AI 驱动的、重新定义播客体验的下一代智能工具……”形容词堆了三行,一条能跑的命令都没有。Agent 读完只知道你很激动,不知道要做什么。检验标准很简单:删掉所有形容词,剩下的内容能不能指导施工?不能,就重写。
反模式二:写完就扔。开工前写得很认真,v0.1 上线后 README 再也没动过。半年后 README 写着“只支持英文转写”,代码早就支持中英双语了。这时候 README 从“施工图纸”变成了“误导图纸”,还不如没有。对策就是第 4 步:里程碑同步更新必须变成习惯,不是可选项。
反模式三:一次性文档。跟上一个很像,但更隐蔽:有人把 README 当“上线发布稿”,只在发布那天更新一次。README 驱动开发里,README 是活的契约——每次需求变更,先改 README 再改代码。顺序反了,这套方法就失效了。下次你想加功能,先问自己:README 改了吗?
什么时候别用这招
诚实一点:README 驱动开发不是银弹。有两种情况,别用:
探索性原型:你还不知道要做什么。比如你想“随便玩玩 RAG 看看效果”,连问题都没定义清楚。这时候写 README 是削足适履——先让 Agent 快速搭个原型玩两天,等你想清楚“这东西到底解决什么问题”了,再回头补 README,把原型转正。顺序是:先探索,再立项。
一次性脚本:写完就删的东西。批量重命名 200 张照片的脚本,跑一次就进垃圾桶。为这种东西写五部分 README 纯属浪费生命。一句话 prompt 开工,跑完删掉,挺好,不丢人。
判断标准很简单:这段代码三个月后还会存在吗?会,就写 README;不会,就别写。文档是写给未来的,别为一次性用品立碑。
开工前检查清单
每次开工前,对着这份清单打勾。缺一项,就回去补,别心存侥幸:
- 一句话定位写出来了,陌生人读完知道这是干嘛的
- “给谁用”写清楚了,不是含糊的“所有人”
- 5 分钟上手里的每条命令,我亲手跑通过
- 命令里有一个真实可跑的例子,不是占位符
- 架构地图画了,每个目录都有一句话职责
- 环境变量列全了,必需和可选标注清楚了
- Non-goals 写了至少 3 条“不做什么”
- README 里没有“自行配置”“详见文档”这类含糊话
- 开工 prompt 里给了 Agent 更新 README 的授权
- 想好了第一个里程碑是什么,以及到时让 Agent 更新文档
下次你想 vibe coding 一个新点子,别急着打开 AI 编程工具。先新建一个 README.md,花 20 分钟把“做完长什么样”写死。你会发现,想清楚本身,就是最难的那部分工作——而这部分,AI 替不了你。图纸画好了,再让 Agent 动手,翻车的概率会小一个数量级。试一次,你就回不去了。
相关文章

10 月 3 日,工程师 Kevin Liao 发表檄文冲上 HN 前页:记忆插件是一场 RAG 片段抽奖,Agent 需要的是文档工作区。本文拆解他的诊断、开源的 Operator Memory 插件、两个最强的反方质疑,以及今晚就能开始的最小实践。

2026 年 10 月 7 日,Google Developers 发布 Developer Knowledge API 生态:Google Cloud、Firebase、Android 等官方文档变成程序化事实来源,配 gcloud CLI 入口、官方 Agent Skill(一行安装)、MCP server 和多语言客户端库。为什么「文档 API 化」能连根拔掉 vibe coding「模型记错 API」的经典翻车。
每个 vibe 项目迟早会遇到同一个时刻:列表页一打开就要查十几次库,并发稍高数据库就被打满。这篇实战从缓存的三问心智模型讲起,逐层拆解 HTTP 缓存头、Next.js 数据缓存、Redis 应用缓存与 AI 结果缓存(语义缓存/prompt 缓存),给出缓存键设计、穿透击穿雪崩的三件套解法和失效策略,最后附一份上线检查清单。