Replit 把默认位交给了 OpenAI:新战场是默认位,不是菜单
Replit CEO 在 TC Disrupt 宣布 OpenAI 取代 Anthropic 成为 Replit Agent 默认模型:成本、合作、性能三重理由,Claude 仍在菜单上。为什么真正的故事不是「分手」而是「默认位」。
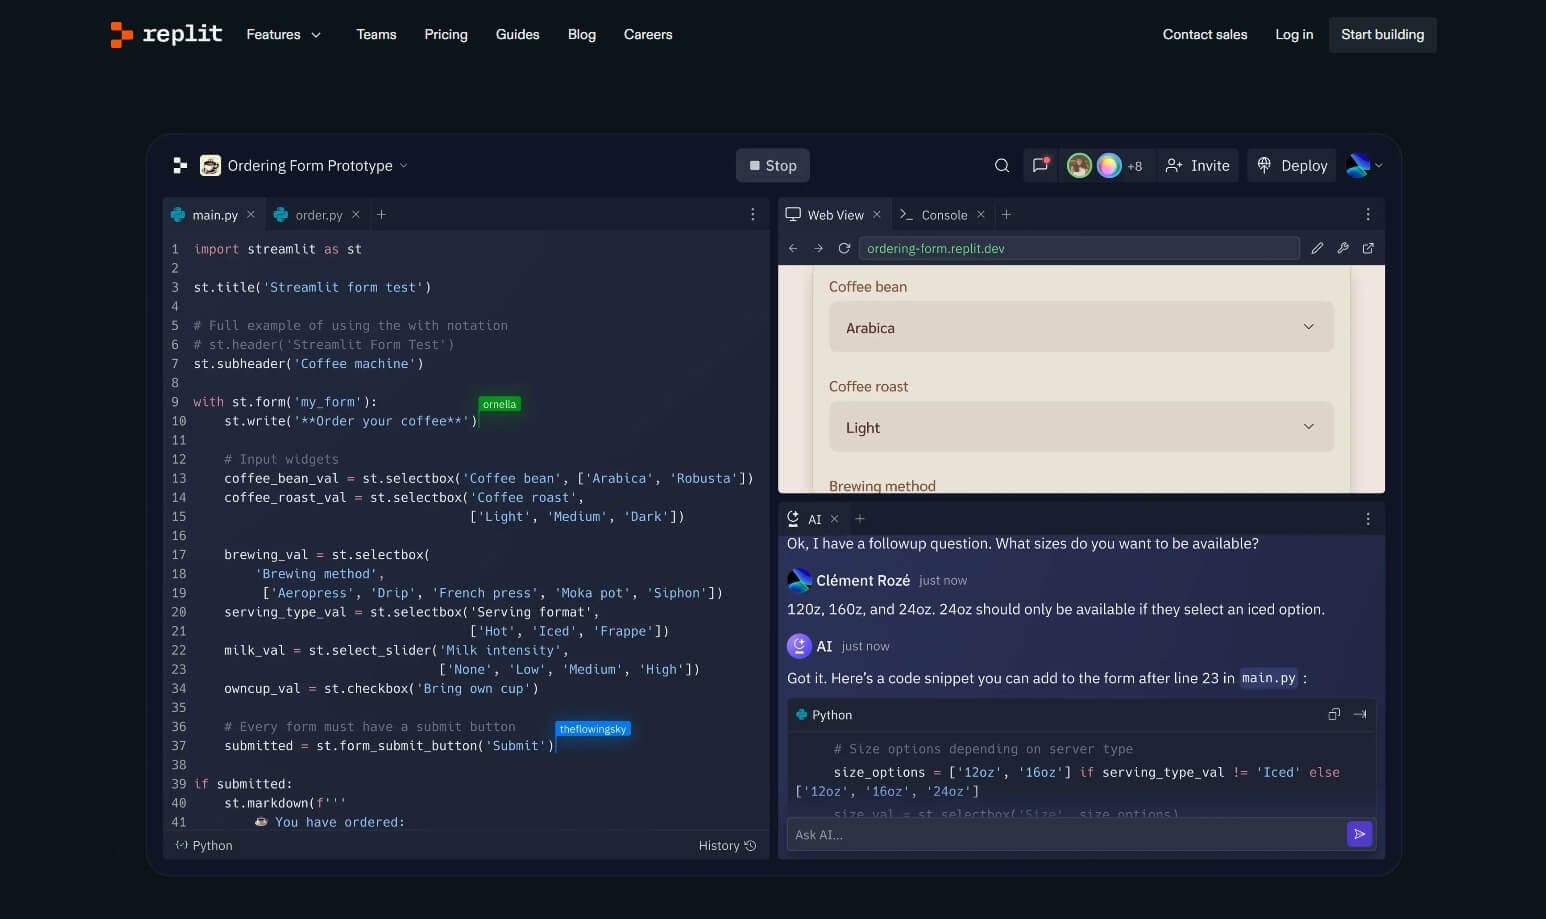
上周四,TechCrunch Disrupt 的舞台上,Replit 联合创始人兼 CEO Amjad Masad 扔出了一颗不大不小的炸弹:Replit 不再把 Anthropic 当作合作伙伴,OpenAI 的 ChatGPT 成了 Replit Agent 的默认模型。
原话是这么说的:「I think ChatGPT is better now(我觉得现在的 ChatGPT 更好)。」理由有三:成本、合作关系、性能。他还搬出了证据:Replit 内部有一套基准测试,同时也发布公开基准,「Sol 和 Astra 在从零构建 vibe-coded 应用上,表现一直更好」。
但这件事真正值得玩味的,不是「谁赢了」,而是 Masad 在台上和台下说的两套话——以及它们之间那条细细的裂缝。
台上很决绝,台下很圆滑
在台上,Masad 的表述是「不再与 Anthropic 合作」。消息一出,很多人解读为 Replit 和 Anthropic 彻底分手。但 TechCrunch 的后续报道很快补上了另一半:在 Disrupt 之后,Masad 澄清用户仍然可以在平台上选用 Anthropic 的 Claude 或其他模型,只是 ChatGPT 现在是默认选项。他的完整表述是:「Replit remains model agnostic(Replit 保持模型中立)……OpenAI is now our preferred partner for powering Replit Agent, based on performance, economics, and the strength of our partnership.」
Anthropic 那边的人也不认「分手」这个说法。一位要求匿名的知情人士告诉 TechCrunch,合作关系仍然存在。证据链也站在这一边:9 月底 Replit 的博客还在讲 Claude Fable 5 和 Fable 5.1 跑在生产环境;10 月 2 日的 changelog 同时加了 GPT-6.1 Sol(Max Mode)和 Claude Sonnet 5.5(Power Mode);甚至就在 Disrupt 讲话的第二天,10 月 16 日的 changelog 还给 Core 和 Pro 用户加上了 Power Mode 可选的 Claude Haiku 5.5。
所以准确的总结是:OpenAI 赢下了默认位和「首选伙伴」的名头,Claude 留在了菜单上。没有分手,但座次变了。
为什么「默认」比「分手」更重要
这里有一个所有做平台的人都懂、但很少说破的道理:大多数用户永远不会去碰模型选择器。TechCrunch 在报道里直接点明了这一点——正因为用户都用默认,默认位的变化会「显著减少 Replit 在 Anthropic 那边的支出」。Masad 自己也在台上承认:直到最近,Replit 还是 Anthropic 的前五大客户之一。
这就是 2026 年模型战争的新打法:争夺的不再是「谁被集成」,而是「谁是默认」。菜单上可以摆十个模型,但流量的九成归默认的那个。Replit 这种量级的平台(浏览器里写代码、部署一条龙,创业者和独立开发者的心头好),它的默认位就是模型厂商的印钞机。OpenAI 拿下这个位置,靠的不只是模型性能,还有 8 月就宣布的合作铺垫,以及——Masad 在 X 上 10 月 17 日亲口补的——「OpenAI 的模型总体更便宜」。

复盘:OpenAI 是怎么赢下这一局的
把时间线摊开看,OpenAI 这一局赢得并不偶然,而是一步步铺过来的:
8 月,Replit 宣布与 OpenAI 达成合作。当时没人觉得 Anthropic 的地位动摇了——毕竟 Replit 是靠 Claude 起家的,前五大客户不是白当的。10 月 2 日,Replit 的 changelog 同时上架 GPT-6.1 Sol(Max Mode)和 Claude Sonnet 5.5(Power Mode),表面看是「双线并行」,实际上是在让用户用脚投票、收集真实场景数据。10 月 15 日,Masad 在 Disrupt 舞台上把结论抛出来:内部基准+公开基准,Sol 和 Astra 在「从零构建应用」上更好,加上成本和合作关系,默认位易主。10 月 16-17 日,话术收敛为「首选伙伴+保持中立」,安抚 Anthropic 和存量用户。
这是一套标准的渠道争夺打法:先以合作名义进场,再用数据证明价值,最后拿下默认位。Anthropic 输的不是模型性能——Claude 至今仍在菜单上,也没人说它不好用——输的是商务组合拳:OpenAI 给了更好的价格、更紧密的合作姿态,而 Masad 需要的企业故事(成本可预测、供应商关系稳定),OpenAI 恰好都能讲。
对 Anthropic 来说,真正的损失也不是 Replit 一家的账单,而是示范效应。Replit 是 vibe coding 平台里最有代表性的一家,它用脚投票等于告诉全行业:在「从零做应用」这个场景下,OpenAI 的 GPT-6 家族已经可以正面接住 Claude 了。接下来 Cursor、Lovable、Windsurf 这些平台的默认位,会不会也成为 OpenAI 的下一个目标?Anthropic 需要回答的问题,从「我的模型够不够强」变成了「我的渠道关系够不够硬」。
vibe coding 平台正在变成模型的「应用商店」
把视线再拉远一点。这件事标志着 vibe coding 平台的角色正在发生变化:它们不再只是「用了某个模型的工具」,而是变成了模型分发的渠道——有点像当年的手机应用商店。模型厂商(OpenAI、Anthropic、Google)是开发者,Replit、Cursor、Lovable 这些平台是商店,而「默认模型位」就是首页推荐位。
在这个新格局里,有几个判断值得记下来:
第一,「模型中立」正在变成一种修辞。几乎所有平台都宣称 agnostic,但默认位只有一个,中立只是菜单的装饰。用户嘴上说要选择权,身体却很诚实地留在默认上。平台的真实立场,看默认位就够了。
第二,「从零构建应用」正在成为独立的评测维度。Masad 反复强调的 benchmark 不是 SWE-bench 那种代码补全分数,而是「从零把一个应用做出来」。这正是 vibe coding 的核心场景——也说明模型评测正在从「写代码能力」分化出「做产品能力」。以后选模型,可能要看两张不同的成绩单。
第三,成本正在成为默认位争夺的决定性变量。性能差距在缩小(各家前沿模型在 vibe coding 场景下其实都能用),这时候「更便宜」就成了压垮骆驼的最后一根稻草。Replit 的算盘很实在:同样的默认体验,更低的推理成本,直接变成毛利。
对独立开发者意味着什么
短期看,Replit 用户几乎无感——Agent 照样用,只是底下的默认模型换了。但长期有两件事值得注意。
一是平台锁定的形态变了。以前你担心的是「我的代码被锁在某个平台」,现在要担心的是「我的 Agent 工作流被锁在某个默认模型的行为上」。当平台可以一夜之间换掉默认模型,你的 prompt 技巧、调试习惯都可能要重新校准。把关键工作流写成「模型无关」的形式(明确的指令、外部化的上下文),比押注某一个默认模型更安全。
二是企业化正在重塑这些平台。Masad 在台上还透露:企业收入占比从去年的 2%涨到了今年的 15%,B2B 收入超过一半,预计 2027 年企业+政府客户贡献过半。vibe coding 平台正在从「个人玩具」变成「企业工具」,而企业客户最看重的就是成本可预测和供应商关系——这恰恰是 OpenAI 这次赢下的两个维度。独立开发者享受的免费/低价额度,越来越是由平台的企业生意在补贴。
最后回到 Masad 在台上说的另一句话,关于 agent 需要的「栖息地」:好的编排、好的错误恢复、好的安全与沙盒、好的网络、好的身份与授权。「一旦把这些搞定,你就能安全地部署 AI。」这话没错,但 10 月 15 日这出戏提醒我们:栖息地的房东,也是会换租客的——而房东换租客,从来不需要征得你的同意。
评论 (0)
原始来源
相关文章
Claude Code 2.1.299 起,200K+ token 会话空闲约 54 分钟会自动压缩——卡在 1 小时 prompt cache 过期之前。这是成本工程的一步,但压缩是有损的:它到底丢了什么、什么时候该关掉。
GitHub 企业级许可证合规检查 GA:ruleset 合并门禁 + 专供 coding agent 预查包许可证的新 API。合规从「事后审查」转向「事前策略」。
Anthropic 悄悄向国会递交 AI 安全法案草案:政府仅在损失超 10 亿美元或 50 人死亡时才能叫停模型。以安全立身的实验室写下了最窄的联邦框架——拆解其背后的策略。