65B 打赢 501B:Ricursive 开源 Ripple-65B,3200 万美元练出美国开源编码新标杆
11 月 4 日,芯片设计实验室 Ricursive 发布首个公开模型 Ripple-65B Preview:65B 稠密模型,Terminal-Bench 2.1 拿下 80.52 分,超过 501B 的 Reflection Beam;全部研发成本据称只有 3200 万美元。
一个只有 65B 参数的模型,在终端智能体编程测试上打赢了 501B 的对手。11 月 4 日,成立不到一年的芯片设计实验室 Ricursive Intelligence 发布了它的第一个公开模型 Ripple-65B Preview:65B 稠密 Transformer,从零预训练,Apache 2.0 开源,Terminal-Bench 2.1 拿下 80.52 分。发布博客的标题很直接——“美国开源权重在智能体编程上的新标杆”。

这个数字之所以值得单独写一篇,是因为它同时戳中了过去一年开源模型叙事里的两个默认假设:第一,好模型必须越做越大;第二,好模型必须越烧越贵。Ripple 两条都反着来——参数只有对手的八分之一,研发总账只要 3200 万美元。数字当然要打折扣(后面会细说哪些地方要打折),但即便打完折,这仍然是 11 月开源模型圈最值得认真对待的一次发布。
先看数字:65B 赢了 501B
Ricursive 在官方模型卡上公布的 Terminal-Bench 2.1 成绩是 80.52 分。Terminal-Bench 测的不是选择题,而是让模型在真实终端环境里独立完成编程任务——装依赖、改代码、跑测试、修报错,全程没人搭手。对写代码的智能体来说,这是目前最贴近实战的公开标尺之一。
横向对比是这篇发布最扎眼的部分。同一张表里,Reflection 的 Beam 501B 是 80.1 分,Meta 的 Muse Spark Open 816B 是 76.4 分,Thinking Machines 的 Inkling 975B 是 63.8 分,英伟达的 Nemotron 3 Ultra 550B 是 56.4 分。Ripple 以 65B 的体量排在第一,比第二名少 436B 参数,比最后一名少 485B。发布博客特意强调了这一点:这是一个稠密模型,不是混合专家(MoE)——65B 参数就是 65B 全激活,没有“总参数大、激活参数小”的花招。
还有一个细节值得留意:模型卡里 Terminal-Bench 2.1 有两行数字。自报行(self-reported)是 80.5,官方 Terminus 2 评测框架跑出来的行也是 80.5。Ricursive 在模型卡里坦承,换官方框架后几乎所有模型的分数都变低了(Muse Spark Open 除外),并说明自己的对比是“尽力做到公平”。这种把方法论的丑话说在前面的做法,比只贴一个最高分要可信得多。
Ripple 到底是什么
Ripple-65B Preview 是一个 65B 参数的稠密 Transformer 模型,从零开始预训练,训练语料 12 万亿 token,以英文和代码为主,上下文长度支持到 1M token(1,048,576)。它不是一个专用芯片模型——Ricursive 的说法是,它是为自家芯片设计平台服务的私有模型的通用版本,这次把它放出来。
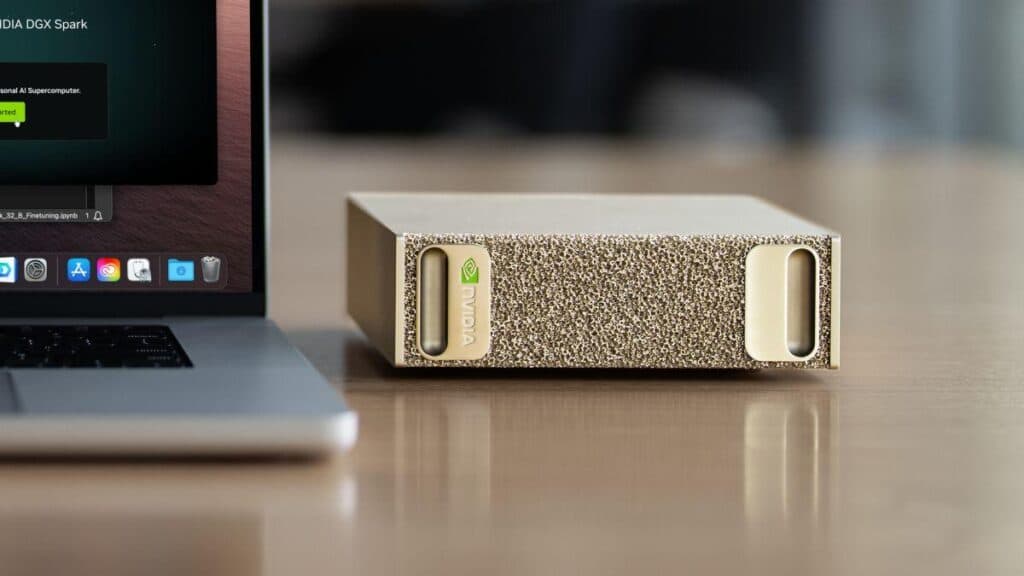
发布包含三个版本:BF16 指令微调版、NVFP4 量化版(面向本地低显存部署)和 BF16 基础版。许可证是 Apache 2.0,可以免费下载、商用、二次开发。模型已经上架 Hugging Face,托管 API 则在 Together AI、GMI Cloud、OpenRouter 和 Fireworks 上线。博客还提到一个很具体的本地化卖点:65B 的体量可以装进英伟达的 DGX Spark 桌面设备——也就是说,它瞄准的不是只有数据中心能跑的巨无霸,而是开发者桌子上的机器。
速度数字也给了:数据中心 GPU 上,在 2 块 B200、批量为 8 的条件下,未量化、无定制算子时能达到每秒 250 个 token。这个数字来自官方模型卡,没有第三方复核,先记下来,待验证。
3200 万美元是怎么做到的
发布里最容易上头条的数字其实不是 80.52,而是 3200 万美元。Ricursive 说这是从零开始的全部研发成本——包括预训练阶梯实验、数据配比、评测、调试、合成数据生成、后训练配方开发,以及最后的大规模预训练和后训练。博客的原话是,这个数字大约是“此前智能体编程开源标杆成本的十分之一”。脚注里给出了估算依据:Reflection 被报道每月在 SpaceX 的 Colossus 上投入 1.5 亿美元算力,而 Beam 的预训练加后训练各花了 4 周。
这个“一成成本”的说法要谨慎对待:它是 Ricursive 自己做的估算,分母来自媒体报道而非对方财报。但成本结构本身的几个要点是实打实的,也正是这篇发布对从业者最有价值的部分。
第一是“爬梯子”的方法论。团队从 AI2 的 Olmo 3 阶梯出发,在小规模上逐项测试改动对编程能力的影响,经历了 v1.0 到 v1.6 六个版本:v1.0 用了 StepFun 的批量与学习率缩放律,v1.1 换了自研的平滑缩放阶梯,v1.2 从后归一化切到前后归一化,v1.3 加入 sigmoid 门控注意力,v1.4 的双流 mHC 架构在小规模有效、到 4B 规模失效于是被否掉,v1.5 换全局 NoPE 并加学习率冷却到零,v1.6 再加 value residuals。最终版本把自定义预训练数据集里的代码比例大幅上调。官方的说法是,这套阶梯在 4B 规模上把代码计算效率提升了 16 倍,完整的大模型训练中优势扩大到 55 倍。换句话说,同样的代码能力,他们用的算力只有 Olmo 3 路线的十六分之一。
第二是后训练的克制。团队没有购买任何后训练数据,全部用自研的合成数据管线、质量过滤和覆盖度指标。强化学习阶段只用了 140 万次 rollout——博客称大约是 Reflection Beam 的七十分之一——就从一个不错的 SFT 检查点陡峭地爬到了 80.5 分。少花钱的另一面是“轻后训练”:模型卡写明,这次发布只做了相对轻度的后训练,重点放在智能体编程上,通用能力并非主攻方向。
第三是架构上为效率做的取舍。薄而深的设计:d_model 只有 5120,但堆到 80 层;注意力头数量超配,同时提高滑动窗口注意力与全局层的比例、缩小窗口尺寸来对冲成本;再加上 FFN 激活裁剪、门控注意力、全局 NoPE 和 value residuals。整个预训练和后训练期间保持了 40% 的 MFU(模型算力利用率),且用的是简单分片、无定制算子、无量化的 BF16 训练。团队规模也小得惊人:开发期间从 1 个人扩展到 5 个人。
榜单要横着读:它赢在哪、输在哪
只看 Terminal-Bench 2.1 会得出“Ripple 全面登顶”的印象,横着读完整张模型卡,画面要复杂得多,也诚实得多。
在编程与智能体这一栏,Ripple 确实强。SWE-bench Pro v2.0 Hard 79.1 分,是全表最高,比 Beam 的 76.5 分和 Muse Spark Open 的 72.4 分都高;SWE-bench Verified 76.5 分,则低于 Beam 的 81.6 分和 Muse Spark Open 的 78.7 分,排第三。也就是说,在最难的那档真实软件工程任务上它拔得头筹,在标准验证集上它只是中上。
通用能力和推理上,短板很明显。MMLU 89.6 分、MMLU-Pro 84.2 分、GPQA Diamond 85.2 分,都低于同表对手;DeepSWE 1.1 只有 44.3 分,远低于 Muse Spark Open 的 60.0 分;SciCode 39.4 分也是全表偏低。数学反而是亮点:AIME 2025 98.3 分、AIME 2026 95.0 分、HMMT 2026 年 2 月卷 90.5 分,都处在第一梯队。指令遵循 IFBench 79.2 分居中,安全类的 FORTRESS 对抗集 83.8 分、StrongREJECT 97.5 分也都不是最差。
读这张表还要记住一行小字:只有部分分数是各家官方模型卡的公开成绩,缺失的评估由 Ricursive 用自己的内部流程补跑(表中以斜体标注)。这意味着横向对比的基准并不完全统一,竞争对手的某些分数是 Ricursive 自己测的。模型卡把这一点写出来了,但读者很容易忽略。结论应该是:Ripple 在智能体编程这个单项上确实拿出了有竞争力的成绩,尤其是在最难的 SWE-bench Pro v2.0 Hard 上;但它不是一个全能冠军,通用知识、科学代码和部分智能体任务上仍有明显短板。
这家公司是干什么的
Ricursive Intelligence 是一家做 AI 芯片设计的实验室,2025 年底才成立。两位创始人 Anna Goldie 和 Azalia Mirhoseini 是 AlphaChip 背后的研究者——AlphaChip 是谷歌用强化学习做芯片版图布局的工具。这次发布的模型,本质上是他们芯片设计平台的副产品:先为自家平台训了一个模型,发现它在通用编程上也很能打,于是放出一个通用版本。
这层背景解释了 Ripple 的两个特点:第一,为什么架构优化围绕英伟达硬件的训练与推理效率展开;第二,为什么团队会把“模型与硬件协同进化”当作长期叙事——博客结尾说,目标是“缩小模型与驱动它的硬件之间的闭环”。据 TechCrunch 的报道,公司今年四个月内融资 3.35 亿美元,估值 40 亿美元——人少、钱多、目标聚焦,这是它能用 5 个人做这件事的底气。这条融资消息来自第三方报道,尚未见官方确认,读的时候要打个折。
还有一个时间线上的巧合值得注意:Ripple 发布的前一天,Thinking Machines 刚发布 Inkling 2 Small;同一周,Cognition 发布了 SWE-2 Flash。11 月的第一周成了开源与半开源编程模型的集中发布窗口。Ripple 在这个窗口里抢到的位置是“最小、最便宜、单项最强”——一个很聪明的差异化站位。
开发者现在能怎么用
最直接的路径是 Hugging Face:权重免费下载,Apache 2.0 意味着可以商用。不想自己部署的话,Together AI、GMI Cloud、OpenRouter 和 Fireworks 都有托管 API。据第三方实测报道,Together AI 的标价是每百万输入 token 0.20 美元、每百万输出 token 0.60 美元——这个价格如果属实,比同级别的闭源模型便宜一个数量级,但价格以官方页面为准,本文发稿时未做独立核对。
本地部署是另一条值得试的路。NVFP4 量化版把显存需求压到约 57GB,BF16 完整版约 130GB——前者已经可以进高端消费级多卡或 DGX Spark 这类桌面设备。对想在本地跑一个能干活的编程智能体、又不想把代码发到云端的人来说,这是目前少数几个“单项成绩够硬、体量又塞得进本地”的选择。需要注意的是,1M 上下文是模型卡标称的上限,不同托管方实际开放的窗口可能小得多,有第三方报道称 OpenRouter 上目前只开放到约 16K——用之前先查自己走的那个渠道。
也要提醒一句:名字里的 Preview 不是装饰。模型卡明确说后训练做得比较轻、重心在智能体编程上,通用对话、长文本写作这类任务不在这次优化的靶心内。拿它当主力聊天模型,体验大概率不如同级别的通用模型;拿它当编程智能体的底座,才是它被设计出来的用法。
该信几分:三点保留意见
第一,所有的基准分数都来自 Ricursive 自己。没有独立实验室复现过 80.52 这个数字,对手的若干分数还是 Ricursive 自己跑的。在 Terminal-Bench 这类对评测框架、提示词、采样参数极其敏感的测试上,分数的波动空间不小。等第三方用同一框架复跑、等社区在真实仓库里大规模试用之后,这个排名才算站稳。
第二,3200 万美元和“十分之一成本”是估算,不是审计过的财务数字。成本口径里是否包含人力、是否按市价折算算力、是否计入失败实验的沉没成本,博客没有逐项拆开。把它理解为“这家实验室认为自己很省钱”,比理解为“行业成本从此打一折”更准确。
第三,Ripple 的强项很集中,弱项也很集中。它证明了小团队用聪明的配方可以在单项上掀翻巨无霸,但它没有证明 65B 能通吃一切。通用知识、科学计算、部分智能体任务上的落后,说明这条路线的天花板还在验证中。Preview 这个后缀,厂商自己也留了余地。
即便如此,这次发布的意义不在于它终结了什么,而在于它示范了什么:当所有人都在比谁的模型更大、谁的算力更多的时候,一支 5 人团队用 3200 万美元、140 万次强化学习 rollout,做出一个在最难的编程基准上排第一的开源模型。这个示范本身,比任何一个分数都更值得行业认真对待。接下来要看的是两件事:社区复现能不能守住 80.52,以及 Ricursive 能不能把“便宜又强”从一次发布变成一条持续的产品线。
为什么是现在:开源编程模型的十一月窗口
Ripple 不是孤立出现的。就在它发布的前一天,Thinking Machines 发布了 Inkling 2 Small;同一周,Cognition 发布了 SWE-2 Flash。再往前数,百度、智谱等中国实验室的开源模型也在同一时期密集亮相。11 月的第一周,几乎成了全球编程模型的一次集体点名。
这个窗口的出现不是偶然。智能体编程已经从“能不能写代码”的演示阶段,进入了“能不能在真实仓库里连续干活”的比拼阶段。评测的标尺也跟着变了:Terminal-Bench、SWE-bench Pro 这类要求模型在终端里独立完成多步任务的基准,取代了只看单函数补全的旧测试。谁能在这些新标尺上拿出成绩,谁就能在下一轮工具链选型里占到位置。Ripple 选在这个时候发布,瞄准的正是选型窗口——模型还没完全定型、生态位还没被占满,先用一个单项第一把名字钉在榜单上。
另一个背景是成本焦虑。过去两年,训练一个前沿模型的账单动辄以亿美元计,只有少数巨头玩得起。Ripple 的 3200 万美元如果站得住脚,哪怕只是部分站得住脚,也会改变很多小团队的算盘:与其等着用别人的大模型,不如自己按配方训一个够用的小模型。开源社区的热情已经说明了这一点——Hugging Face 上的下载和讨论在发布后迅速升温,本地部署的教程和量化版本也在社区里接连出现。对 VibeFix 的读者来说,这个信号的实际含义是:未来一年,能本地跑的强编程模型会越来越多,选模型的标准会从“谁最大”变成“谁最适合我的任务和预算”。
对 vibe coding 意味着什么
对每天用 AI 写代码的人来说,Ripple 最直接的价值不在分数,而在选择权。一个 65B、Apache 2.0、能塞进本地设备的强编程模型,意味着三件事正在变便宜:第一,隐私成本——代码不用离开发自己的机器就能交给一个像样的模型处理;第二,试错成本——按量付费的托管价格如果维持在每百万 token 几毛钱的水平,跑一整天的智能体任务也不再是心疼的开支;第三,定制成本——权重开源意味着可以针对自己的代码库、自己的规范做微调,而不是永远迁就通用模型。
但也要泼一盆冷水:模型强不等于智能体强。Terminal-Bench 测的是模型在受控环境里的单任务表现,真实开发里还有工具调用、长上下文记忆、多文件协作、测试反馈循环等一整条链路。把 Ripple 接进 Cursor、Claude Code 这类工具链之后的表现,目前还没有大规模的实测数据。模型卡的数字回答的是“这个底座行不行”,没有回答“装上轮子之后跑得怎么样”。在社区拿出真实仓库的复现报告之前,最稳妥的态度是:把它当作一个值得优先试用的新底座,而不是立刻替换主力工具的信号。
还有一个更长期的看点。Ricursive 的主业是芯片设计,模型是它“软硬协同”路线的一环。如果这条路线走得通,未来可能出现更多“为特定硬件优化、为特定任务裁剪”的小而强的开源模型——模型不再追求面面俱到,而是像芯片一样按场景分工。对独立开发者来说,这或许是比“又一个通用大模型”更好的消息:工具会变得更便宜、更专、更贴近具体任务。
来源:Ricursive Intelligence 官方发布博客;Ripple-65B Preview Hugging Face 模型卡。基准分数与成本数字均为厂商自报,尚未经独立复现。
评论 (0)
原始来源
相关文章
2026 年 11 月 5 日,OpenAI 发布 GPT-6 Cyber:ExploitGym 48.5%,一次扫描写出 948 个 Linux 提权利用、挖出 81 个 Firefox 高危漏洞。但它不对公众开放,只给通过 Daybreak Red 审核的安全团队。
METR 在 Anthropic 内部待了 11 周,评估称其模型能力进步速度约为此前两倍,加速大部分来自 AI 自身。但最关键的证据大多被涂黑了。
11 月 5 日 Thinking Machines 发布第二代模型 Inkling 2 Small:594B 总参数、17B 激活,智能指数 31 分,能 4.5 小时无人值守训出一个预测模型。但权重现在还是闭源的,Apache 2.0 开源要等下周安全测试做完。