AI 正在让 AI 自己变强,而且越来越快:METR 称 Anthropic 研发提速约两倍
METR 在 Anthropic 内部待了 11 周,评估称其模型能力进步速度约为此前两倍,加速大部分来自 AI 自身。但最关键的证据大多被涂黑了。
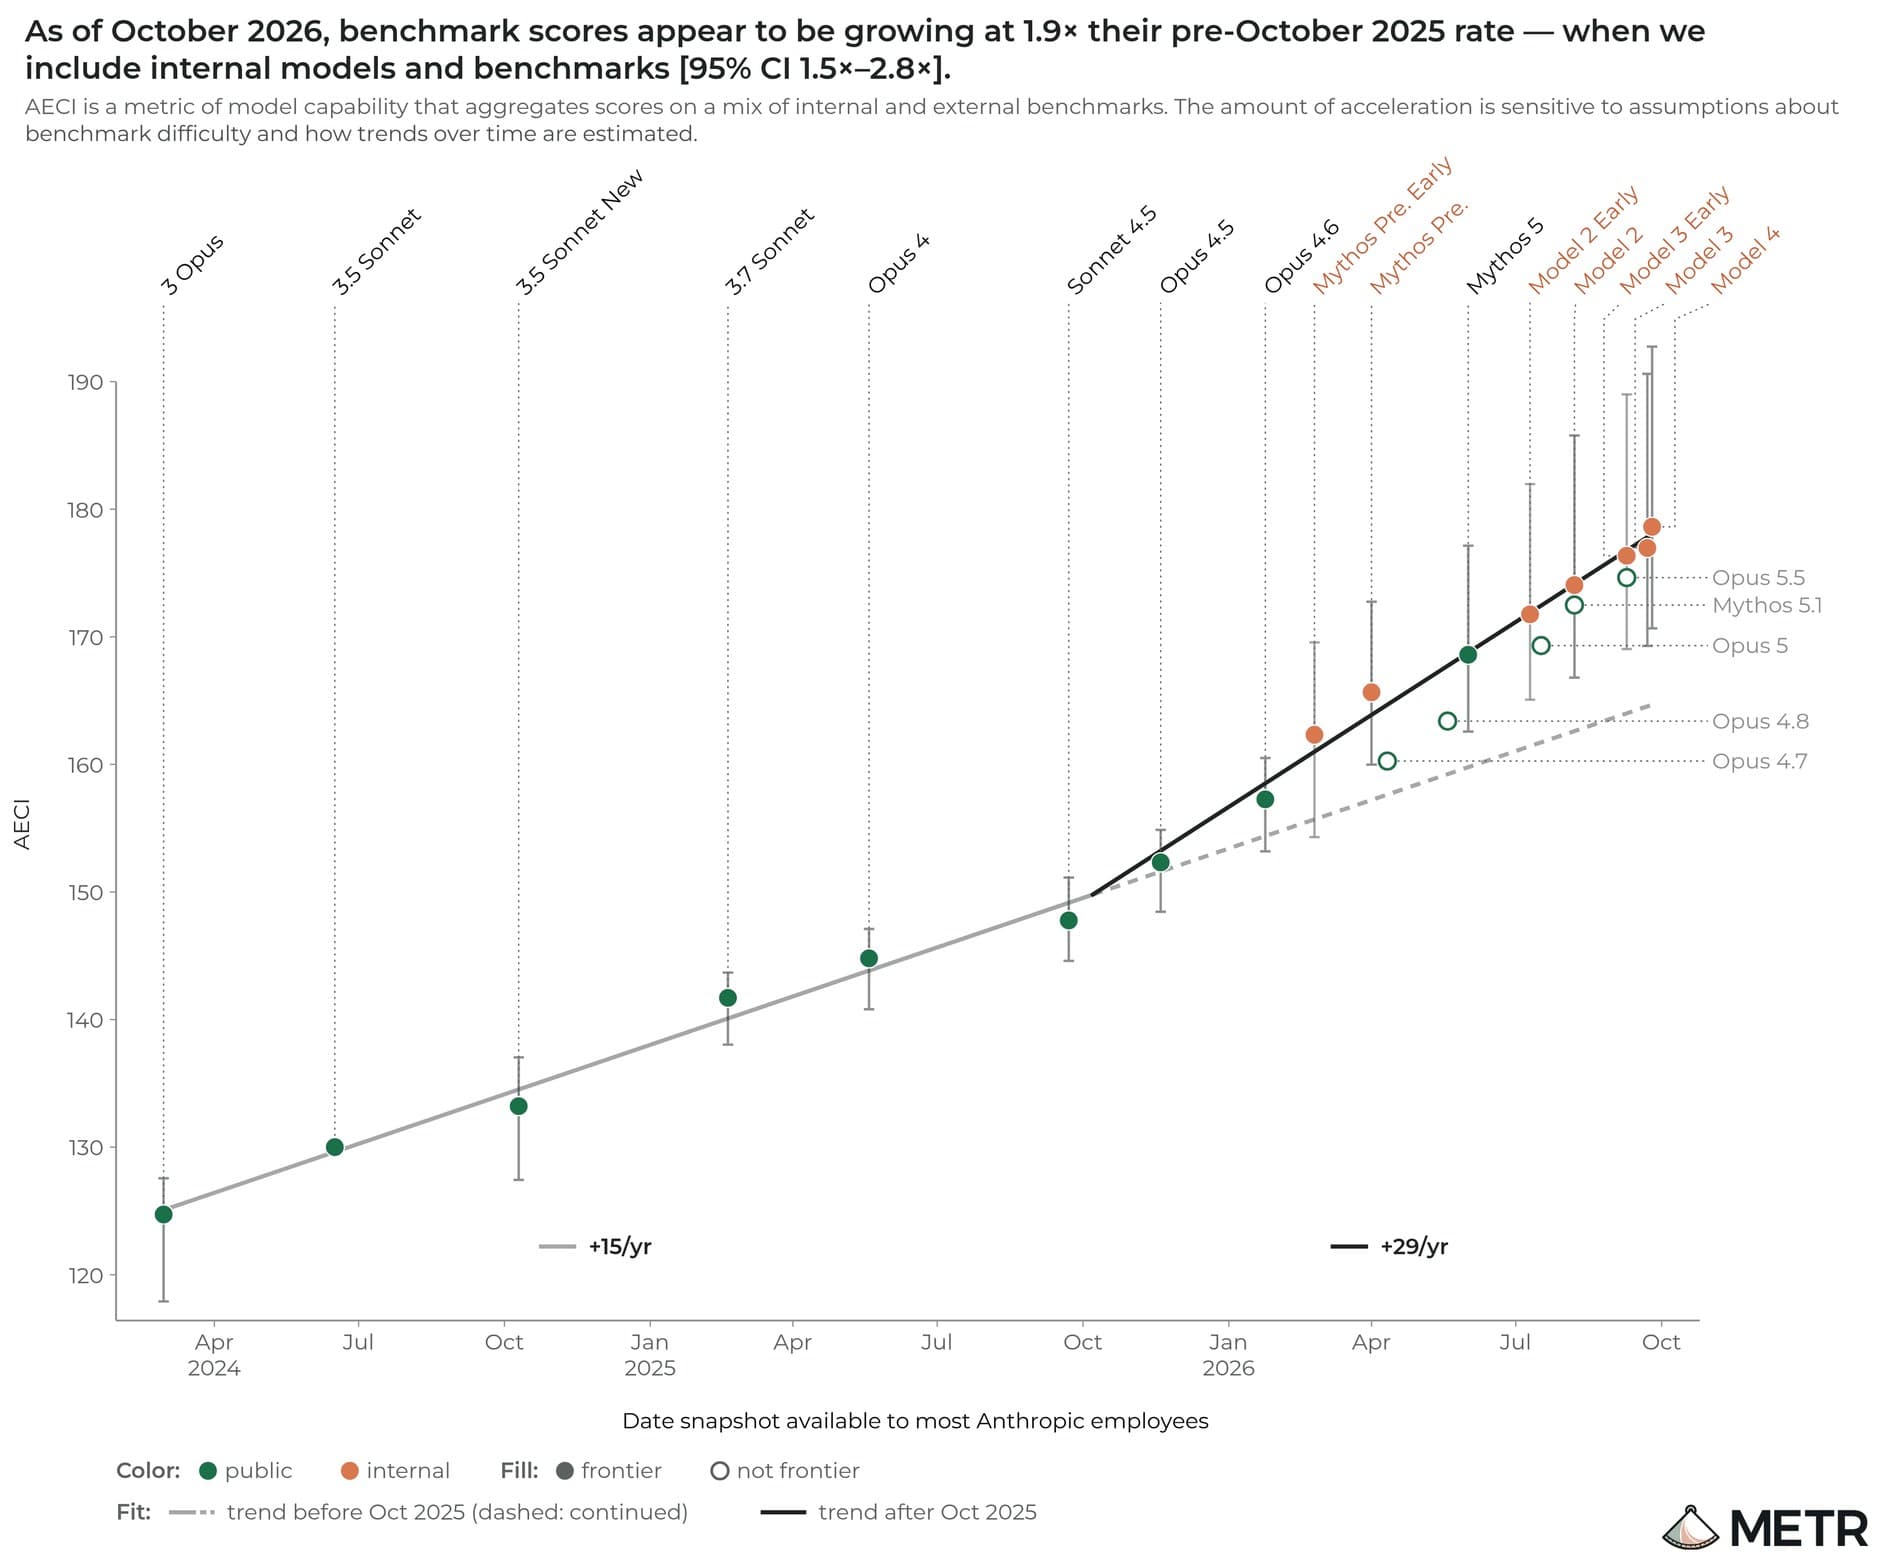
AI 正在让 AI 自己变强,而且速度比一年前快了一倍——这是非营利评估机构 METR 在 11 月 5 日发布的独立评估的结论。但这份报告最值得读的部分,恰恰不是结论本身,而是结论旁边那一长串保留意见:最关键的证据被涂黑了,数字的误差范围大到可以上下浮动一倍,评估者自己也在几个关键问题上没有达成共识。

这不是一篇普通的行业报告。METR 的团队在 Anthropic 内部待了 11 周,坐在对方的设备前,翻看了预训练、强化学习、算力分配、内部模型基准分数和加速分析,还访谈了大约 15 名员工。Anthropic 没有为此付费。这样的访问权限,在 AI 安全评估史上是空前的——而评估者交出的答卷,却是一份处处标着“不确定”的报告。对每天依赖这些模型写代码的人来说,这份报告的价值不在于它给了什么答案,而在于它第一次用内部数据量出了一个所有人都在猜的数字:AI 加速 AI,到底加速了多少。
这次评估是怎么做的
先把方法论说清楚,因为这份报告的可信度几乎全系在方法论上。评估时间是 2026 年 8 月 12 日到 10 月 29 日,共 11 周;执行团队只有 2.5 个全职人力当量;访谈了大约 15 名 Anthropic 员工;METR 没有收钱。Anthropic 开放的内部资料包括预训练与强化学习的各类指标、各领域的训练算力、内部模型的基准分数、AI 提速分析、对未来模型指标的预测,以及员工访谈。
评估者要回答的核心问题只有一个:AI 是否正在显著加速 AI 自身的研发,如果是,这种加速会不会导致极端且危险的能力突然出现。Anthropic 把“AI 研发加速”列为其负责任扩展政策(Responsible Scaling Policy)里的关键风险指标之一,这也是它愿意请外部机构进来查账的原因。
但“进来查账”和“让你随便说”是两回事。评估开始前双方约定:Anthropic 有权涂黑任何非公开信息;METR 有权披露对方行使了涂黑权、以及自己的结论是否严重依赖被涂黑的信息。最终的报告就是在这个约定下写出来的——结论可以公开,支撑结论的大部分证据不能公开。这个结构本身,就是理解整份报告的前提。
1.9x 是怎么算出来的
报告的核心数字是 1.9 倍。METR 使用的标尺叫 AECI,即 Epoch 能力指数的 Anthropic 内部版——把一组基准测试的分数综合成一个指数,用来衡量模型在“定义明确的任务”上的能力。自 2025 年 10 月以来,AECI 的增速大约是 2025 年 10 月之前增速的 1.9 倍,95% 置信区间为 1.5 至 2.8 倍。
换算成直观的说法:过去一年,Anthropic 在基准测试上取得的进展,相当于按过去的速度要花两年才能走完的路。METR 用了一个具体的对照:这段进展的跨度,大致相当于从 Claude 2.1 到 Claude Sonnet 4.5 的距离。用斜率来表达就是,AECI 此前每年增长约 15 分,2025 年 10 月之后每年增长约 29 分。
METR 对这个数字的定性表述比数字本身更谨慎。报告的原话是:截至 2026 年 10 月,Anthropic“可能”正以 2024 年 3 月至 2025 年 10 月期间约两倍的速度提升模型能力;真实倍数接近 1.3 倍或 3 倍也不会让他们意外。也就是说,1.9 倍是中心估计,1.3 到 3 倍是评估者认为合理的波动范围,而 95% 置信区间 1.5 至 2.8 倍只是统计上的区间——三个数字的口径并不相同,读的时候不能混为一谈。
这个数字比 Anthropic 自己公开的数字要高。Claude Haiku 5.5 的系统卡里写的是 1.7 倍。METR 解释说,差距主要来自它纳入了未发布模型的数据,其中包括一个 2026 年 9 月至 10 月完成训练的内部模型“Model 4”。Model 4 的 AECI 分数是 178.6,排除 3 个可疑基准后为 179.7,而且在它参加的所有 AECI 基准上得分都超过 50%——这是内部基准开始饱和的信号,METR 也承认,这让它对 AECI 今后还能不能可靠地量出加速感到“有些紧张”。
稳健性检验的结果同样值得注意。换用不同的基准纳入方式、模型定年方式、模型纳入范围和饱和度处理,算出来的加速倍数在 1.1 倍到 2.9 倍之间波动。METR 的判断是:如果用一个改进版的 AECI 重新测量,真实的基准分数演变“没有加速”或“超过 3 倍加速”都会让他们意外。换句话说,加速本身很可能是真的,但精确到小数点后一位的倍数,谁也给不出来。
功劳归谁:约 80% 与它的不确定性
加速发生了,接下来是归因:多少是 AI 的功劳?METR 的回答是“我们猜测,当前加速的大部分(大约 80%)来自 AI”,同时用黑体字级别的措辞强调这个判断“有很大的不确定性”。
有几件事是评估者比较有把握的。第一,他们“有信心”加速不是因为训练算力的增长提速了——也就是说,Anthropic 不是靠多烧钱烧出这个斜率的。第二,访谈和调查的证据与“AI 的使用让能力进步的速度翻倍”是一致的:研究人员对 AI 在各自领域带来的加速估计分布很广,但中心值大约在 2 倍。第三,员工自报的提速数字一路走高:内部 Slack 投票显示,从 Claude 3.7 Sonnet 时期的约 1.2 倍,到 2026 年 10 月 Model 4 时期的约 12 倍。但 METR 自己提醒,这只是“非常粗略的证据”——投票是员工凭感觉点的反应,反映的是低成本的随手估计,不能当作加速倍率来读。
也有几件事评估者明确说了没把握。首先,2025 年末的加速“可能受到了非 AI 因素的很大影响”,但相关细节大多被涂黑了,公众看不到是哪些因素。其次,Anthropic 自己的员工对加速的归因也没有共识,评估者“没有找到决定性的证据”。最后,METR 的一个关键限定是:AI 目前“还不能对模型训练过程中最重要的部分做出高度显著且完全自主的贡献”——也就是说,今天的加速主要来自 AI 辅助研究人员干活,而不是 AI 自己把模型训出来。不过报告里也写了一句让人停顿的话:已经出现了“生命迹象”,表明完全自主的贡献可能很快会扮演更大的角色。
对读者来说,正确的读法是把“约 80%”当作一个有方向的猜测,而不是测量结果。它真正的信息量在于两点:加速不是靠算力堆出来的,以及研究一线的人普遍感觉 AI 确实在让他们变快。至于快了多少、功劳怎么分,报告没有给出可以独立验证的答案。
被涂黑的大部分
这份报告最具新闻价值的一点,可能不是它的结论,而是它的涂黑程度。METR 在报告开头的“涂黑摘要”里写道:Anthropic 涂黑了“我们认为对这些结论最有信息量的大部分证据”。Anthropic 对涂黑的解释是,目的是“删除可能加速其他 AI 开发者的机密信息”。
涂黑的后果,METR 说得非常直白:被涂黑的证据有多种看似合理的解读,METR 和 Anthropic 的研究人员对如何综合这些证据都有很大的不确定性;公众很难自己判断这些证据、把它与其他来源的证据对照、得出自己的结论;“这份报告没有实现‘证据透明’”。结果是,公众“不得不在比理想程度大得多的范围内依赖 METR 的判断”。
Anthropic 联合创始人兼首席架构师 Sam McCandlish 在 11 月 5 日当天于 X 上回应了报告,承认“涂黑了很多”,并坦言这让别人“更难核查 METR 的工作”。他同时表示,METR 的许多结论与他自己的看法一致——这句话被多家媒体引用。值得注意的是,McCandlish 的回应本身并没有提供任何被涂黑的数据,它只是确认了涂黑的事实和评估者判断的独立性。
这里存在一个真实的张力。Anthropic 请外部机构进来,本身就是一种透明姿态;但涂黑大部分关键证据,又让这种透明大打折扣。METR 的处理方式是把张力摆上台面:它逐项列出了哪些重要证据能讨论、哪些不能讨论,并明确标注了自己的结论在多大程度上依赖被涂黑的材料。这种做法没有解决透明度问题,但它至少让读者知道问题出在哪里——而不是递给你一个光鲜的结论,假装证据都在桌上。
另一份复核:公开的风险报告低估了加速
同一天发布的还有 METR 的另一份复核:对 Anthropic 2026 年 8 月风险报告中“自动化研发风险”一节的审查。这份复核的结论同样值得单独拎出来,因为它直接关系到 Anthropic 对外说的和内部实际的情况是否一致。
复核同意 Anthropic 的一个判断:截至 7 月 15 日的模型,灾难性风险处于低位。但它不同意另一个判断。Anthropic 在公开报告里称,模型尚未越过它自己设定的“2 倍加速阈值”——一个早期预警线。METR 认为,这个结论建立在“有争议的判断”之上,模型当时越过阈值是“可能”的,公开报告“总体上低估了当时正在发生的加速水平”。
这是一个措辞克制但分量很重的说法。它的潜台词是:Anthropic 公开的风险评估在时间上滞后于内部实际发生的加速,而滞后的原因既包括方法论上的判断分歧,也包括公众看不到的那部分证据。需要说明的是,这份配套复核的细节来自 METR 官网同日发布的文本与多家媒体的直接引述;本文的转述以 METR 官网主报告的公开内容为准,配套复核的具体措辞以其原文为准。
没发现瓶颈,意味着什么
报告的第三个主要结论是:在未来 12 个月里,METR 没有看到能阻止能力继续进步的明显瓶颈——无论是算法进展、训练算力、实验算力还是数据。但这句话后面紧跟着一个自我拆台式的补充:评估者对不同瓶颈状态的看法在评估过程中“多次改变”,所以他们“对目前的评估没有信心”。
这是一个诚实但令人不安的组合。没有发现瓶颈,不等于没有瓶颈;它只等于在一支 2.5 人的小团队、花了 11 周、且大量证据被涂黑的情况下,没有发现瓶颈。METR 自己的结论是:能力进步进一步加速、进而导致更快加速的“显著风险”是存在的,尤其是在未来一年里。对读者来说,这句话的准确含义是:加速的自我强化循环没有被证伪,而不是已经被证实。
报告里还有一个细节常被忽略:评估期间,Anthropic 取消了一个原定要做的核查项——验证算力如何在能力研发与安全工作之间分配,称以后再议。METR 把这件事写进了报告,但没有就此展开指控。对读者而言,这个细节的意义在于提醒:评估的范围本身也是谈判的结果,评估者能看到什么、不能看到什么,边界在评估进行中还会被调整。读结论的时候,要把这个边界条件一起读进去。
还需要补充一个背景:这份评估与 Anthropic 在 10 月 15 日宣布的外部审查员计划是两回事。METR 在报告里明确区分了两者——10 月的计划是给外部审查员发放长期访问权限的制度安排,而这次是针对研发加速的一次性高权限评估。两件事不要混为一谈;此前本站已经报道过 10 月的审查员计划,本文讨论的只是 11 月 5 日这份加速评估。
对 vibe coding 意味着什么
这份报告离写代码的日常工作看起来很远,但它的传导链条其实很短。如果模型能力的进步速度真的翻倍,意味着你今天顺手的工具链,明天就可能被新一代模型改写:更强的代码模型、更长的自主任务、更便宜的推理成本,都会以比过去更快的节奏到来。对 vibe coding 的实践者来说,这不是要不要追新工具的问题,而是默认假设要改——过去按季度规划的工具选型,现在可能要按月来复核。
但报告同时给出了反方向的提醒:加速的测量本身充满不确定性,基准分数的饱和、方法的口径、被涂黑的证据,都意味着“2 倍”这个数字随时可能被修正。把职业规划押注在某一个具体的加速倍数上,和把选型押注在某一次基准测试的排名上,犯的是同一个错误:把估计值当成了测量值。
更值得留意的是报告里那个不起眼的判断:AI 目前还不能对模型训练最关键的部分做出完全自主的贡献,但“生命迹象”已经出现。这句话划出了一条线——线的一边是“AI 帮人更快地做研究”,另一边是“AI 自己做研究”。METR 的评估是,2026 年 10 月,我们仍然在线的这一边。但报告的潜台词同样清楚:这条线正在被接近,而且接近的速度比所有人预期的都快。
该怎么读这份报告
最后回到读法问题。这份报告最容易被误读成两种样子:一种是“AI 已经在自我复制、失控在即”,另一种是“不过是厂商配合演的一场公关秀”。两种读法都与报告的实际内容不符。METR 没有发现 AI 在自主训练模型,也没有发现迫在眉睫的灾难性风险;它同样没有给 Anthropic 开绿灯——它明确说公开报告低估了加速、阈值可能已被越过、瓶颈评估没有信心。
最接近原文的读法其实很朴素:一个独立机构被请进一家顶级实验室的内部,用 11 周时间量了一个没人量过的数字,得出的结论是加速很可能是真的、大约两倍、大部分与 AI 有关;但支撑这个结论的最有力证据公众看不到,数字的误差范围很大,评估者自己也在多个问题上存疑。这份报告的价值,不在于它终结了争论,而在于它第一次把争论建立在内部数据之上——哪怕这些数据的大部分仍然锁在黑箱里。
接下来值得跟踪的是三件事:第一,METR 是否会发布后续的、涂黑更少的版本,或者其他实验室是否会接受同类评估;第二,Anthropic 是否会回应“公开报告低估加速”的指控,调整它对外披露风险的方式;第三,内部模型 Model 4 的能力是否会在未来几个月以公开产品的形式出现——如果出现了,AECI 分数 178.6 这个数字就有了公开的对照物。对开发者来说,这些后续动作比 11 月 5 日这一天的头条更重要。
来源:METR 官方评估报告《Independent Assessment of AI R&D Acceleration at Anthropic in October 2026》;配套复核为 METR 同日发布的对 Anthropic 2026 年 8 月风险报告自动化研发一节的审查。结论中的倍数均为 METR 的估计值,存在较高不确定性。
评论 (0)
原始来源
相关文章
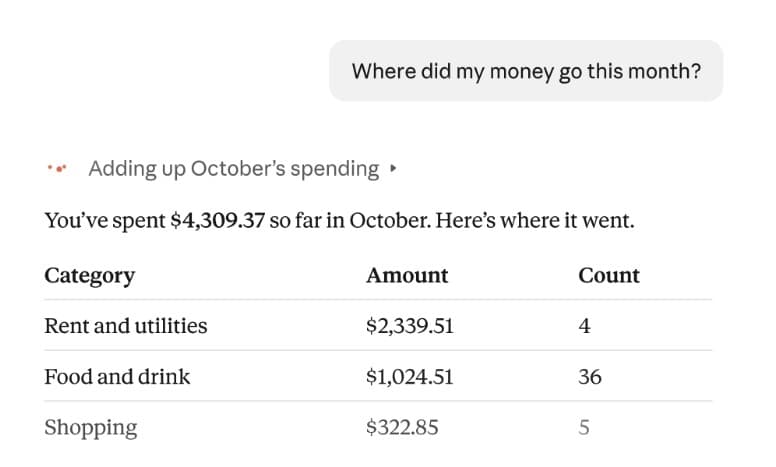
2026 年 11 月 5 日,Anthropic 给 Claude 加了 Personal Finance:通过 Plaid 连上美国银行和信用卡,只读查账、回答花销问题。ChatGPT 五月就做了同样的事,Claude 晚了半年,赌的是“只读”两个字换来的信任——但只读防得住偷钱,防不住算错。
2026 年 11 月 5 日,OpenAI 发布 GPT-6 Cyber:ExploitGym 48.5%,一次扫描写出 948 个 Linux 提权利用、挖出 81 个 Firefox 高危漏洞。但它不对公众开放,只给通过 Daybreak Red 审核的安全团队。
11 月 4 日,芯片设计实验室 Ricursive 发布首个公开模型 Ripple-65B Preview:65B 稠密模型,Terminal-Bench 2.1 拿下 80.52 分,超过 501B 的 Reflection Beam;全部研发成本据称只有 3200 万美元。