陶哲轩带头"宣战"OpenAI:700 多篇 AI 生成的数学证明,撕裂了数学界
菲尔兹奖得主陶哲轩牵头"人类数学协会"发表联合声明,敦促全球数学家停止与 OpenAI 合作,抗议其一次性公开 700 多份 AI 生成的数学证明。图灵奖得主杨立昆则称这是数学进入新时代。一场关于"可读性 vs 解题能力"的论战撕裂了数学界——而这正是 vibe coding 时代每个人的切身问题。
数学史上最不体面的一场公开决裂,发生在一家 AI 公司的 GitHub 仓库里。10 月 9 日,量子位报道:菲尔兹奖得主陶哲轩牵头"人类数学协会"(Association for Human Mathematicians,简称 AHM)发布联合声明,敦促全球数学家停止与 OpenAI 的一切合作。声明的火药味直指 9 月底的一件事——OpenAI 一次性公开了 700 多份由其内部模型生成的数学证明文件。陶哲轩一方的定性毫不留情,据报道转述:"一次性发布 700 多个文件根本不算科研,纯粹是炫耀算力霸权"。
先说清楚这件事的份量。数学界历史上不缺争吵——优先权之争、学派之争、证明之争,样样都有,但以"联合声明"形式号召全行业抵制一家公司,这是第一次。抵制的对象还不是伪科学机构,而是当下最强的 AI 公司。AI for Science 喊了好几年"机器将重塑科研",这是第一次有人类顶尖学术共同体站出来说:不,你们的方式我们不认。这件事值得被认真对待,不是因为陶哲轩的名头,而是因为争论的核心——AI 生成的东西,到底还算不算"人类可理解的成果"——正是 vibe coding 时代每个人的切身问题。先把事实链捋清楚。
一、导火索:约 8000 道题、约 5% 命中率、约 3 小时算力
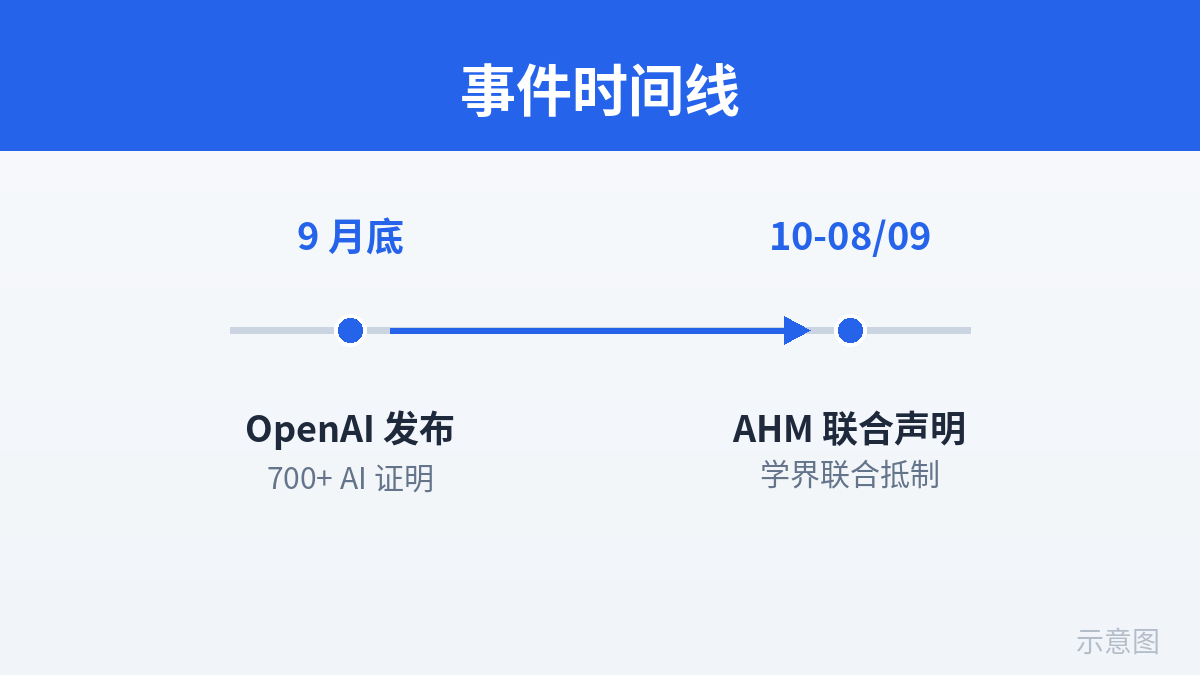
按量子位 10 月 9 日刊登的报道(侦察员在量子位官网首页亲核,标注"前天 08:35")把时间线串起来:
- 9 月底,倾销式发布。OpenAI 把一批由内部模型生成的数学证明文件直接公开——总量 700 多份,后来其 GitHub 仓库又撤回 3 篇,现存约 719 篇。这个数量级本身就是一种宣言:它不是一次投稿,不是一篇论文,而是一次倾销。数学论文的传统节奏是"一篇论文打磨数年",OpenAI 的节奏是"一次发布 700 篇",两种科研伦理在第一天就撞了车。
- 程序不正义:无视自己参与立下的红线。OpenAI 此前与普林斯顿高等研究院共建过一个"数学与 AI 咨询小组"(AGMAI),该小组划出过一条明确红线:前沿 AI 公司不应擅自在内部模型上测试高深数学难题。报道称,OpenAI 无视了这条警告,直接用内部模型刷了约 8000 道开放性数学题,按约 5% 的命中率产出 700 多份证明文件并公开。用一句国内读者秒懂的话说:自己参与立的规矩,自己转头就撕了。这也是 AHM 声明里"不信任"情绪的最大来源——问题不只是 AI 解出了题,而是解题的过程绕开了共同体约定的程序。先斩后奏,斩的还是自己签过字的规矩。
- 10 月 8 日至 9 日,AHM 联合声明发布。陶哲轩牵头,声明敦促全球数学家停止与 OpenAI 合作。鉅亨网与 DEV 社区的交叉报道(均为 2 天前发布)确认了这一事件的传播链条,说明这不是某一家中文媒体的独家渲染,而是一场正在发酵的国际论战。
而最让数学家们坐不住的,是那笔成本账。把报道里的数字摆成一张表,冲击力会更直观:
| 维度 | 人类学者(传统路径) | OpenAI 内部模型(报道口径) |
|---|---|---|
| 解一道高难度难题的耗时 | 数年,甚至一生的研究积累 | 约 3 小时 GPT-Pro 级别算力 |
| 单次产出规模 | 一篇论文,打磨数年 | 约 8000 道题刷出 700 多份证明,一次公开 |
| 产出形式 | 人类可读、可评审、可教学的证明 | 机器生成、未经同行评审的文件 |
一个学者可能花数年甚至一生去啃的问题,机器用一个下午就"解决"了,还一次交出 700 多份。这已经不是竞争,这是降维打击之后,还在你头顶开庆功会。陶哲轩那句"炫耀算力霸权"的愤怒,至少有一半来自这里:当解题成本趋近于零,几代人建立起来的学术尊严体系,一夜之间失去了定价权。你穷极一生证明的东西,别人用几小时电费就"证明"了——换谁都得问一句:那我这辈子到底在干什么?
二、观点对摆:陶哲轩 vs 杨立昆
这场论战最有价值的部分,是双方说的根本不在同一个维度。先听陶哲轩阵营的。
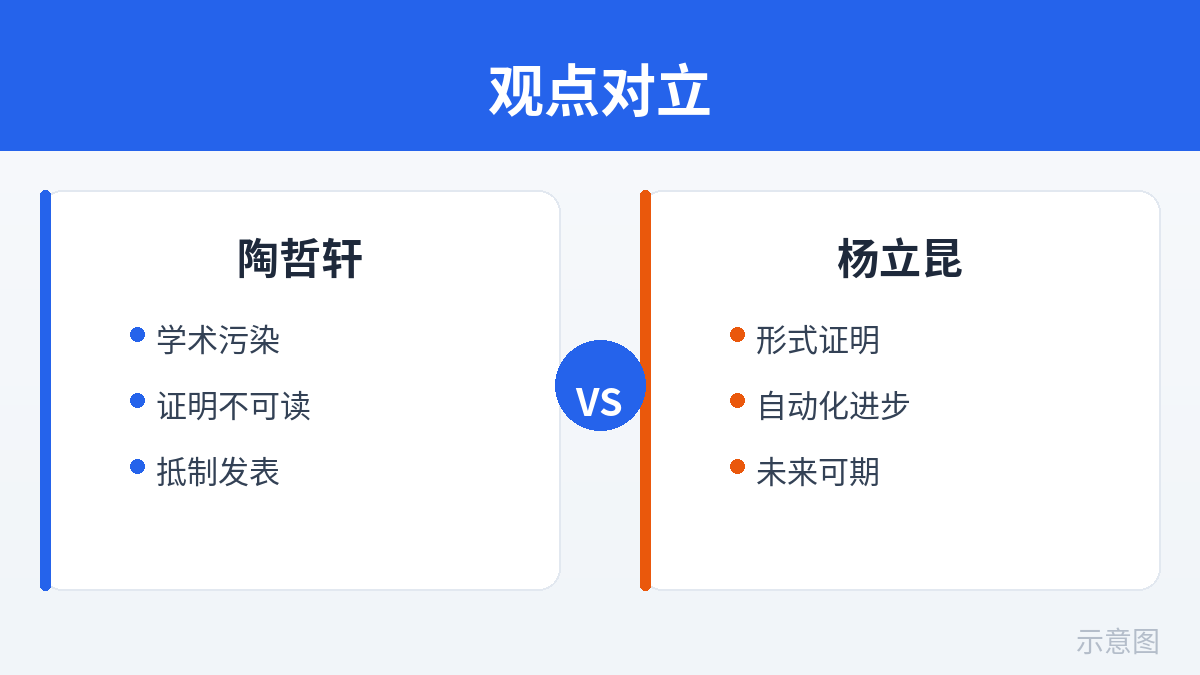
陶哲轩阵营:没人看得懂的"证明",算什么证明?
质量争议是 AHM 声明的第二支柱。理论计算机科学家 Scott Aaronson 把这一幕称为 "Mathocalypse"(数学末日)——据报道转述,这个词指的不是"AI 太强了人类完蛋了",而是"人类数学"作为一种可理解、可传承的知识体系正在遭遇末日。他的妻子、唯一博弈猜想研究者 Dana Moshkovitz 的评价更毒辣,据报道转述,她说相关证明"像吃了致幻剂的人写的":逻辑跳跃、堆砌先验结论、夹杂人类从未见过的诡异构造。这些文件没有经过同行评审,也谈不上可读性——它们或许在形式上是对的,但没有一个人类能真正"读"它们。
陶哲轩本人的警告走得更远:"证明消化不良"与不可逆的学术污染。他的逻辑值得逐字咀嚼——数学研究从来不只是"得到答案",探索路径本身就是知识。一旦某个开放问题被机器宣称"解决",人类再沿着原来的路径去研究就变得毫无意义:你还没出发,终点已经插上了别人的旗。更糟的是,这种污染不可逆:问题被"解决"了,但没有人真正理解它,知识没有增长,只有答案增加了。一个被机器"解决"却无人理解的定理,对人类知识库的贡献是零,对人类好奇心的伤害却是实实在在的。
AHM 声明里转述的核心指控只有一句话:一次性发布 700 多个文件根本不算科研,纯粹是炫耀算力霸权。
杨立昆阵营:形式证明自动化,是数学的新时代
另一边,图灵奖得主杨立昆(Yann LeCun)给出了完全相反的判断:在他看来,这是形式证明自动化的实质性进步,数学正在进入一个新时代。他的逻辑也很硬:证明的终极价值在于正确性,而正确性是可以被机器形式化验证的;"人类可读性"只是历史局限下的副产品,不是数学的本质。AI 一次解出 700 多道难题,恰恰证明了"机器理解数学结构"这条路走得通——剩下的只是工程问题。要求机器证明必须让人类看懂,就像要求汽车必须长得像马车,是对新事物的叶公好龙。
把两边的立场压成一句话:陶哲轩捍卫的是"人类可理解的证明"作为知识载体的地位;杨立昆押注的是"机器可验证的结果"终将取代人类证明。一方要的是可读性,一方要的是解题能力。这不是谁对谁错的口水战,这是两种数学观的正面碰撞——而碰撞的回声,会一路传到每个写代码的人耳朵里。
这里有个值得玩味的细节,很多人会忽略:陶哲轩本人恰恰是数学形式化工具 Lean 的热情支持者,他早年间就牵头把重要猜想的证明完整形式化进了 Lean。所以他的反对从来不是"机器不该碰数学",而是"不能跳过翻译这一步"。一份配上人类可读解释的形式化证明,是知识;没有解释、直接倾销的 700 份文件,是噪音。陶与杨的真正分歧不在"要不要机器",而在"机器产出在算数之前,要不要先过'人类能理解'这一关"。记住这个区分,后面的判断全系于此。
三、我的判断:他们吵的不是同一件事,但每个 vibe coder 都得选边
先给结论:这场争论短期内不会有赢家,但陶哲轩担心的"污染"和杨立昆说的"新时代",会同时发生。抵制声明改变不了技术曲线——OpenAI 不会因为数学家不合作就停下模型训练,8000 道题能刷出来,8 万道也能;但陶哲轩指出的那个问题是真实且无解的:一旦机器能批量产出"正确但不可读"的结果,人类知识体系里"理解"这一环就会被绕过去。数学只是第一个战场,代码、论文、设计方案,迟早都要过这一关。
而这正是 vibe coding 时代每个人的切身问题,只是换了个名字:AI 生成的东西,人还看得懂、还敢用吗?
想想你自己的日常。你让 AI 一晚上生成了 3000 行代码,测试全绿,能跑。但你敢把它合进生产分支吗?你让 AI 写了一份 40 页的技术方案,逻辑自洽、术语准确,但你敢拿着它去跟客户签字吗?不敢的原因,和数学家们不敢用那 700 多份证明的原因,是同一个:可验证不等于可理解,可运行不等于可维护。AI 产出的"正确性"和人类的"理解力"之间,出现了一道裂缝,而且这道裂缝正在随着模型能力的变大而变宽。测试能告诉你代码"work",但只有你读懂了它,你才知道它"为什么 work"——而"为什么"才是你下次能复用、敢修改、出了事能调试的全部底气。
再往深想一层,陶哲轩说的"学术污染",在工程世界里有个一模一样的孪生兄弟,叫技术债的 AI 加速版。机器"解决"了一个问题,人类没理解它,于是没人能维护它、没人能改进它、出了问题没人能调试——答案增加了,知识没有。这不就是每个接手过 AI 生成祖传代码的人都闻过的味道吗?数学家们现在闻到的,和你打开一个 5000 行 AI 生成文件时的窒息感,是同一种味道。只不过数学家们把它写成了联合声明,而你只是在心里骂了一句。
所以我的判断很明确,分三层说:
- 短期(1 到 2 年):抵制更多是姿态,技术不会停。AHM 的声明改变不了 OpenAI 的路线图,数学家个体也很难真正做到"不合作"——审稿、引用、合作网络是嵌在一起的,真要切割等于学术自杀。但这个姿态本身有价值:它逼整个 AI for Science 社区正面回答"可读性"问题,而不是假装它不存在。有时候,提对问题比给对答案更重要。
- 中期:真正的分水岭是"可读性标准",不是"解题能力"。杨立昆是对的,形式化验证会越来越强;陶哲轩也是对的,不可读的证明无法进入人类知识体系。未来的赢家不是"解题最快"的模型,而是"能把证明讲成人话"的模型——把机器证明翻译成人类可理解、可教学的形式,这本身会成为一个巨大的新赛道。vibe coding 同理:能生成代码的 AI 遍地都是,能生成"人类敢合入的代码"的 AI 才是稀缺品。下次你评估一个 coding agent,别只看它 benchmark 分数多高,看它生成的代码你愿不愿意署名。
- 长期:数学可能会分裂成两种。一种是机器的数学——形式化、可验证、不可读,跑在证明检查器里;一种是人类的数学——可理解、可教学、可传承,跑在论文和课堂里。两者用"翻译层"连接,就像今天编译器连接高级语言和机器码。这不是末日,这是分工。Scott Aaronson 的"Mathocalypse"预言的其实是旧分工的死亡,不是数学的死亡。旧分工死了,新分工里"翻译者"的身价会涨上天。
最后说一句给 VibeFix 读者的话。这场论战里,陶哲轩和杨立昆都是对的,但他们回答的是不同考卷上的题。轮到你交卷的时候,考题只有一个:下一次 AI 甩给你一份"正确但看不懂"的产出——代码、方案、证明,随便什么——你是直接合入,还是先让它讲到你能听懂为止?你的答案,决定了你是算力的消费者,还是知识的主人。数学家们已经用一场决裂投了票,你的票,投在每一次合入之前。
(本文事实依据为量子位 2026-10-09 报道及鉅亨网、DEV 社区交叉报道;涉及数字均为报道口径,已标注"约";引号内人物评价为报道转述,非逐字原文。)
评论 (0)
原始来源
相关文章
联想天禧 AI 自研代码智能体框架 TianxiCode 搭配 DeepSeek-v4.1-Flash,在 SWE-bench-Live Lite 分榜以 71% 解决率登顶全球第一,并通过官方 Verified 审核。本文解读这项“真实工程”评测为何更难、“框架>模型”论点的含金量,以及它给 vibe coding 实践者的三点启示。
Rails 之父 DHH 在 Rails World 宣布 37signals 已“不再手写代码”。本文拆解 2025 年 11 月的拐点、转向原生应用与 Rust 的动作、同一信源里的反方证据,以及给 vibe coding 读者的三条判断。
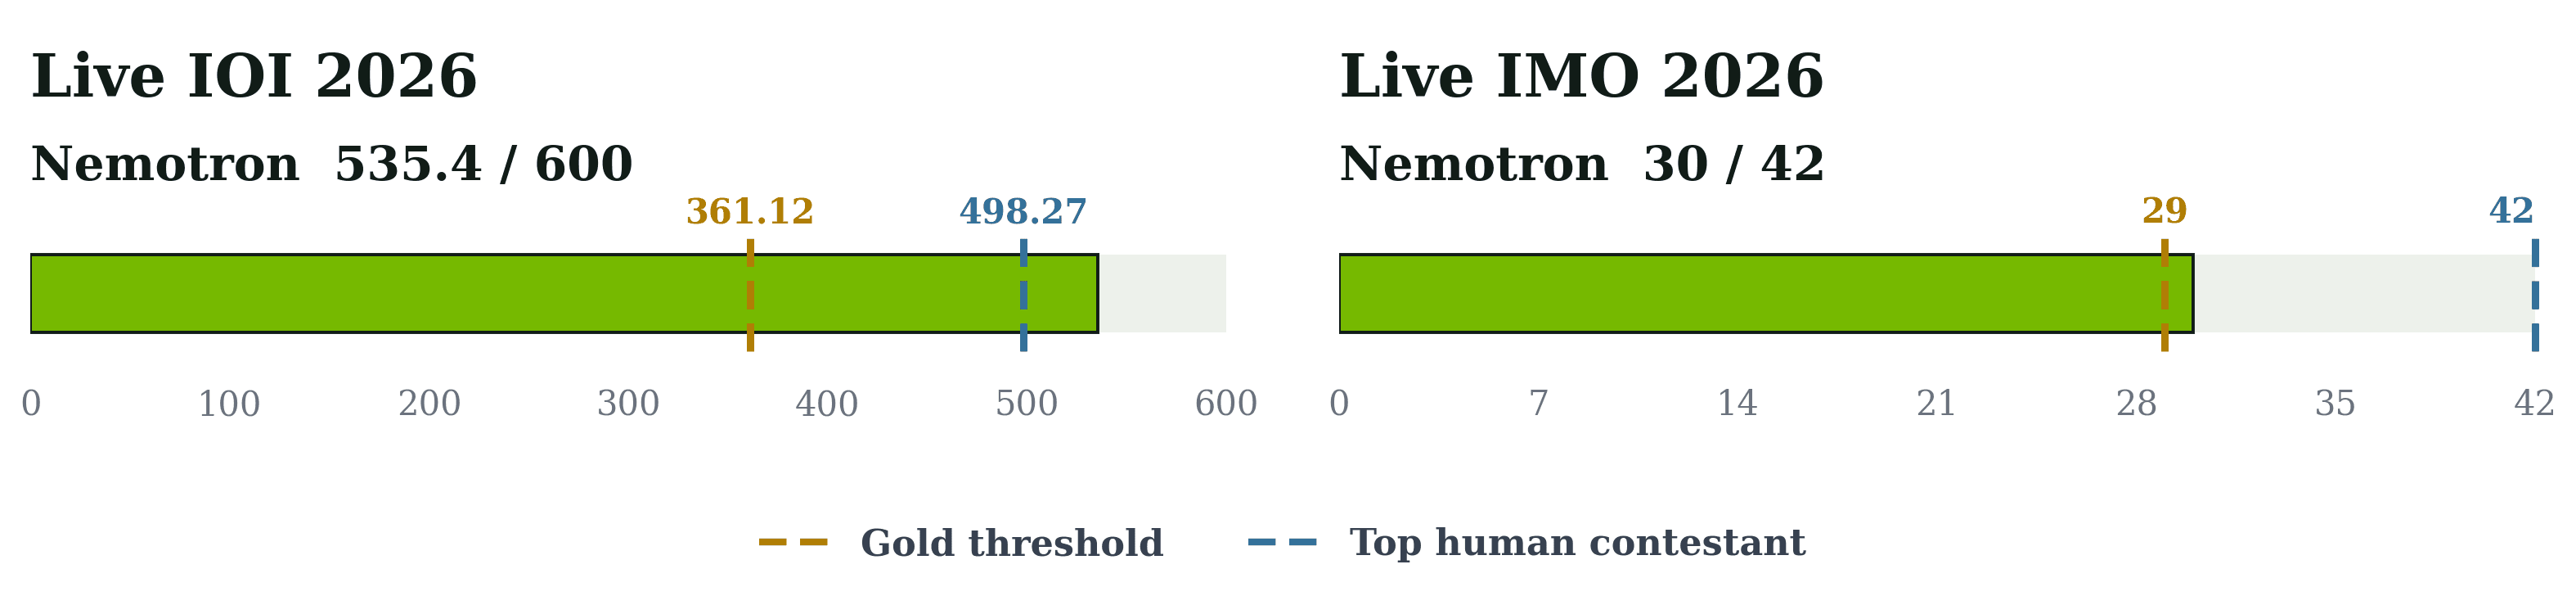
NVIDIA 的 Nemotron 系统在 IOI 2026 拿下 535.4/600(非官方跑分,超过人类最高分 498.27)、在 IMO 2026 拿下 30/42(官方阅卷,越过 29 分金牌线),并把整套配方全部开源:SFT 与 RL 的 checkpoint、两份训练数据集、全新的 200 道奥赛级数学 benchmark、推理管线与 prompt。核心方法是模型、数据、推理循环的协同设计:GenCorrect 的生成-评估-改进循环把 291 分的模型推过 438.3 的金牌线。对一人公司而言,这是一份生产级的测试驱动 agent 循环模板。