腾讯 Hy4 完整版来了:第一次能看图、能操作电脑,但权重还没开源
腾讯 11 月 4 日正式发布 Hy4 完整版,补上视觉理解和电脑操作两块短板,价格与预览版持平。但完整版权重尚未公开下载,今天的 Hy4 首先是一个托管服务,而非可本地部署的开源模型。
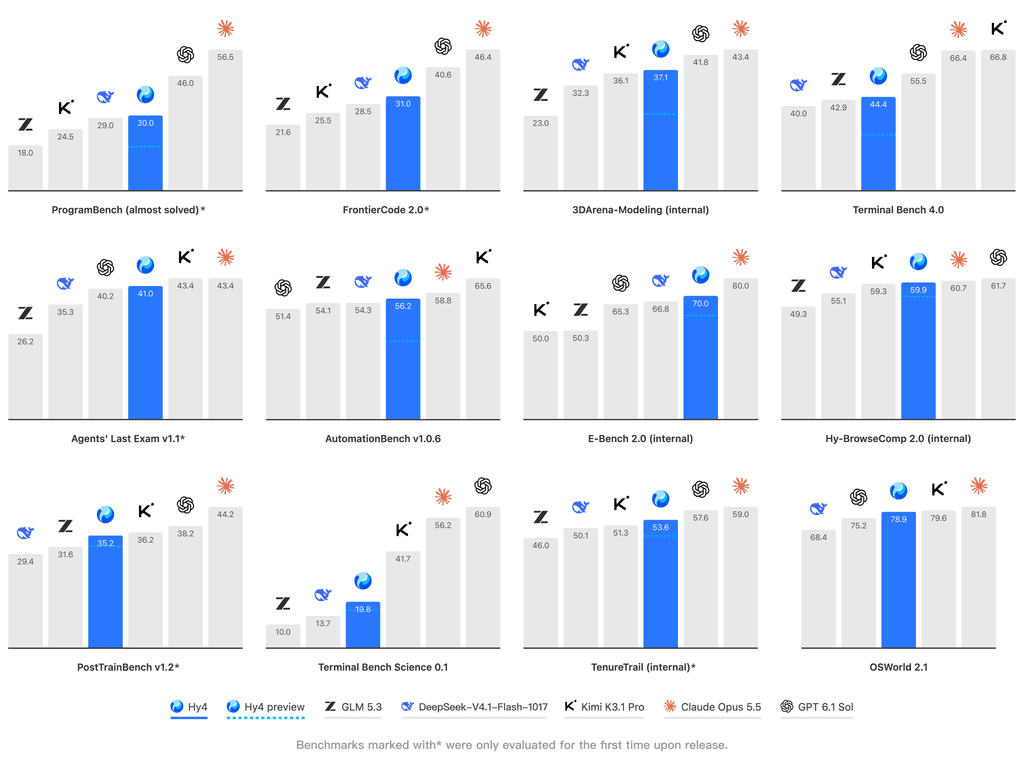
腾讯混元在 2026 年 11 月 4 日正式推出了 Hy4 的完整版。这个时间点本身就值得注意:它不是一次悄悄上线的模型替换,而是腾讯在官网上以一篇正式公告宣布的新一代旗舰模型。距离 8 月 28 日的 Hy4 预览版不到三个月,完整版补上了预览版最明显的两块短板——看图的能力和操作电脑的能力。腾讯的说法很直接:Hy4 第一次跻身世界最强的开源模型之列。但这句话需要立刻加一个限定:截至公告当天,完整版的模型权重还没有公开下载,真正能下载的仍然是 8 月的预览版。所以更准确的表述是,Hy4 完整版已经可以通过腾讯的服务用起来了,但还不能算一个已经可以自由下载、本地部署的开源模型。把“已经发布”和“已经开源”区分开,是读懂这次发布的第一步。

先说这次发布到底新在哪里。预览版是一个纯文本模型,能写代码、能处理办公任务,但看不见图片,也摸不到电脑。完整版第一次加入了视觉理解,并且把视觉、推理和工具调用结合在了一起。腾讯列出的具体能力包括细粒度图像处理、复杂图表分析和带图的数学推理。换句话说,模型不只是“能看图”,而是能把图里的信息变成下一步行动的依据。这个区别很重要:很多模型能描述一张图,却很难根据图里的数字或结构去完成一个多步骤任务。Hy4 完整版的卖点正是后者,它要解决的是真实工作里的那种“看图、算数、再动手”的链条。
第二个新增能力是电脑操作。Hy4 第一次可以同时操作命令行界面和图形界面,去完成工作和日常任务。腾讯还特别提到,模型针对 Blender 和 CAD 这类专业软件做过专门训练,目的是提升它规划和执行长周期、复杂任务的能力。这意味着它的目标场景不只是回答问题,而是像一个能动手的操作员那样,在软件里一步步把事情做完。对普通用户来说,这个能力听起来很酷;对开发者来说,真正的问题在于可靠性——它在第几步会出错,出错后能不能自己发现并纠正,以及它有没有权限边界。腾讯的公告没有给出这些操作层面的失败率,只强调了能力的方向。读者在尝鲜时,应该把它当作一个需要人盯着的助手,而不是一个可以放手不管的自动化员工。
从预览版到完整版,腾讯强调的另一个变化是规模的扩大:预训练和后训练都做了扩量,同时改进了指令遵循、长上下文理解和长周期智能体任务。这个说法比较笼统,但公告里给出的几个具体数字可以用来交叉验证。办公场景方面,腾讯称 Hy4 在 WorkBuddy 上的评测平均分为 83.18, pass 率为 96.15%,并在中国内地市场的 12 个场景中有 9 个排名第一。这些数字来自腾讯自己的评测体系,不是第三方独立复现的结果,读的时候要打个折扣。不过它们至少说明了腾讯这次的发力方向:不是单纯拼聊天能力,而是拼在自家办公产品里的实际表现。
金融场景是腾讯这次讲得最细的一块,也是最值得仔细看的一块。腾讯称,Hy4 团队联合腾讯金融科技做了一次盲测,共有 213 名金融专业人士参与,其中 153 人来自外部领先机构,约七成拥有五年以上从业经验,覆盖 579 个真实金融任务。结果是 Hy4 以 3.04 分居首,DeepSeek-V4.1-Flash-1017 为 2.97 分,Kimi K3.1 Pro 和 GLM-5.3 均为 2.68 分。单看分数差距,Hy4 对第二名的领先并不大,只有 0.07 分。但这组数据的价值不在于分差,而在于方法:它用的是真实任务和有经验的评审,而不是只跑公开基准。另一组内部数据也指向同一个方向:Hy4 在投资研究智能体基准上的表现比预览版提升了 12.03 个百分点。把这两组数据放在一起看,腾讯想传递的信息很清楚:Hy4 不是一个实验室模型,而是一个为金融、办公这类高 stakes 场景调校过的模型。
幻觉率的改善同样来自腾讯的内部评测,需要同样谨慎地读。公告称,通过针对性的搜索优化,Hy4 的幻觉率从预览版的 12.95% 降到了 7.2%,而由无依据假设导致的错误从 23.1% 降到了 5.6%。这个降幅如果属实,对需要查最新信息、整合多源信息的任务确实有实际意义。但幻觉率的定义和测试集在不同厂商之间并不统一,跨厂商直接比较数字没有意义。更值得关注的是方法本身:腾讯说它优化了检索最新信息、整合多个信息源和核对事实一致性这三个环节。这说明 Hy4 的改进不只是模型变大,还包括它如何使用外部信息。对于经常要查财报、研报和市场数据的用户来说,这个方向比单纯的参数规模更重要。
前端和游戏开发是另一条值得注意的产品线。腾讯称,Hy4 针对高复杂度的业务逻辑、状态管理和前后端协同做了优化,生成的界面不仅要好看,还要真正能跑。同时,通过与腾讯互动娱乐事业群专业开发者的合作,Hy4 深度整合了 Unreal Engine、Unity 和 Godot 等主流引擎,支持复杂的游戏逻辑和多人玩法。与预览版相比,Hy4 在 GameDev 基准上提升了 19.1%,在 GameLogic 基准上提升了 9.8%。这些数字同样是厂商自报,但它们揭示了一个判断:腾讯没有把 Hy4 只定位成一个聊天或办公模型,而是希望它能进入游戏开发这种对状态、逻辑和长时间一致性要求很高的场景。这类任务最容易暴露模型的短板,因为一个逻辑错误可能在几十步之后才显现出来。
科研方向的叙述则更偏向长期布局。腾讯称,Hy4 结合了高级推理、科学编程和长周期任务执行能力,可以支持端到端的科研工作流,并在 TenureTrail 的评测中覆盖了 7 个学科的 123 个可执行任务,在数学构造、物理建模、环境与地球科学、系统工程和社会经济决策等方面表现突出。同时,腾讯提到 Hy4 正在进入递归自我改进的下一阶段,并利用 Hyra 2.0 框架优化了同架构小模型的预训练基础设施,还开源了两个基于 Hy4 和 Hyra 2.0 的基础模型,分别面向单细胞表示和物理场建模。这部分内容对普通用户的直接意义不大,但它说明腾讯把 Hy4 当作一个平台来经营,而不只是一个单点产品。科研模型的价值往往不在发布当天的基准分数,而在于它能不能被研究社区真正用起来并持续改进。
安全是这次公告中写得最克制、也最值得肯定的一节。腾讯明确表示,Hy4 的网络安全训练数据只限于防御性内容,重点是概念验证开发和漏洞修复,同时为了分析目的纳入了逆向工程和渗透测试,但与漏洞利用相关的进攻性材料被明确排除在训练数据之外。腾讯玄武实验室和 Keen 安全实验室的安全评估覆盖了密码学逆向工程、二进制反混淆、漏洞利用等方向,结论是在已评估的范围内没有发现与 Hy4 进攻性网络安全能力相关的重大问题。生物安全方面,腾讯的内部专家评估认为 Hy4 具备较强的基础生物学知识,但在开放式实验设计方面的能力相比前沿模型更为有限。这个表述没有夸大,也没有回避短板。在当前各家厂商都在争夺“最安全模型”话语权的背景下,这种分项说明比一句笼统的“安全可靠”更有信息量。
价格和使用方式是这次发布最务实的部分。Hy4 完整版的价格与预览版保持一致:每百万输入 token 约 0.90 美元,每百万输出 token 约 2.70 美元,每百万缓存输入 token 约 0.045 美元。腾讯同时宣布,11 月 4 日至 15 日期间 WorkBuddy 和 CodeBuddy 免费提供一定额度,而腾讯云 TokenHub 上的 Hy4 在 2026 年 12 月 31 日之前享受五折优惠。模型目前已经接入腾讯云 TokenHub、WorkBuddy、CodeBuddy、元宝、企业微信智能助手、ima 等产品,API 也通过 OpenRouter、Hermes 和 OpenCode 等第三方平台提供。腾讯还提到,QQ、王者荣耀、和平精英、微信读书、腾讯新闻等产品的接入正在推进中。价格不变而能力增加,对现有用户是实实在在的利好;但对新用户来说,真正要算的账不是单价,而是完成一个任务的总成本,包括重试、纠错和人工复核的时间。
最后回到那个最关键的限定:权重还没有发布。腾讯的原话是,计划在未来几天内发布模型权重和系统卡,并强调其对负责任开源的承诺。第三方平台的信息也印证了这一点:截至 11 月 4 日,腾讯的公开仓库里仍然只有 8 月的预览版权重。也就是说,今天的 Hy4 完整版是一个托管服务,而不是一个可以下载的模型。腾讯还预告了一个更便宜、更快的 Hy4 Flash 版本即将发布,面向注重性价比的应用。把这两点放在一起看,Hy4 的完整版发布更像是一个分阶段的路线图:先让服务可用、收集真实反馈,再放出权重和系统卡,最后用 Flash 版本覆盖成本敏感的场景。读者在做决策时,不妨按这个节奏来评估:现在就可以通过腾讯的产品和 API 去试它的视觉和电脑操作能力;但如果你的需求是本地部署、离线运行或深度定制,那就等权重和系统卡真正落地之后再下结论。
综合来看,Hy4 完整版的意义不在于它宣称自己“跻身最强开源模型之列”,而在于它把腾讯混元的产品路线讲清楚了:从纯文本到视觉加电脑操作,从通用聊天到办公、金融、游戏和科研这些具体场景,从单一模型到一个包含 Flash 版本和科研基础模型的家族。它的短板同样清楚:核心数字全部来自厂商自己的评测,权重尚未公开,电脑操作的可靠性还没有经过独立验证。对于开发者和企业用户来说,最理性的态度是先用免费额度和折扣期去跑自己真实的任务,用自己的数据去验证它在视觉理解、长任务执行和幻觉控制上的表现,而不是只看公告里的排名。模型发布日的口号会过去,真正留下来的是它在你自己的工作流里能不能稳定地把事情做完。
再往前看一步,Hy4 完整版与预览版的对比,其实讲的是一条产品演进路线,而不是一次单纯的能力叠加。预览版解决的是“模型能不能在办公和代码场景里稳定输出”的问题,完整版则要回答“模型能不能看懂真实世界的信息、并在软件里把任务做完”。视觉理解让它可以处理带图、带表的输入,电脑操作让它可以把推理结果落到具体操作上,前后端协同和游戏引擎整合则让它可以处理更长的状态链条。这条路线的好处是场景越来越具体,坏处是验证成本也越来越高:聊天回答的好坏一眼就能看出来,而一个长任务在第十步才出错,往往需要完整复跑才能定位问题。腾讯这次没有公布长任务的成功率、平均步数和纠错能力,这正是后续评测最应该补上的部分。
对开发者来说,Hy4 完整版的上手路径目前是比较清晰的。已经在用腾讯云 TokenHub 的团队可以直接调用新版本,价格不变,等于用同样的成本换来视觉和电脑操作能力;已经在用 WorkBuddy 和 CodeBuddy 的用户可以在免费额度期内先跑真实任务,再决定是否长期使用;通过 OpenRouter 等第三方平台接入的用户则可以把它放进现有的多模型对比流程里,和其他模型在同一个任务上直接比较效果。这种“先在已有入口里试用”的安排,比要求用户迁移到一个全新平台要友好得多。但开发者也要注意一个细节:不同入口的版本、限速和功能支持可能并不完全一致,正式上线前应该以自己实际要用的入口为准做测试,而不是以公告里的通用描述为准。
从竞争格局来看,Hy4 完整版的发布时间点也很有意味。它处在各家厂商密集发布新模型、新能力的窗口期,单纯拼参数和基准已经很难形成差异化。腾讯选择的差异化路径是“场景纵深”:办公协同、金融分析、游戏开发、科研工作流,每一个场景都有自己的评测和产品落点。这种策略的优点是离付费用户更近,缺点是每个场景都需要持续投入才能保持领先,一旦某个场景的评测被独立机构复现后表现不如预期,口碑的反噬也会更快。相比之下,Sarvam Prism 那种“只做判断层”的极窄定位,反而更容易被验证:速度、校准和顺序稳定性都是可以直接复测的指标。Hy4 的长任务能力则更难被一句话验证,这也是读者在试用时应该多留心的地方。
最后列一份试用清单,供真正想动手的人参考。第一,先用自己的任务做对照实验:同一份带图的文档、同一张复杂图表、同一个需要多步操作的软件任务,分别跑 Hy4 完整版和你现在用的模型,记录成功率、出错位置和人工干预次数。第二,重点测试幻觉控制:给模型提供有冲突或过时的信息,看它会不会把假设当成事实写进结论。第三,测试电脑操作的边界:明确告诉它哪些操作不允许做,看它是否会越界;同时观察它在出错后是会停下来求助,还是会继续沿着错误路径走下去。第四,等权重和系统卡发布后再评估本地部署的可能性,在此之前不要把“开源”写进自己的采购或合规文档里。第五,关注 Hy4 Flash 的后续发布:如果你的场景对成本和延迟更敏感,Flash 版本可能比完整版更合适。这份清单的核心只有一句话:不要只看发布日的排名,要看它在你的任务、你的数据、你的权限边界里表现如何。
还有一个值得单独提醒的点:不要把“腾讯说”直接当成“行业共识”。Hy4 在金融盲测、办公评测和游戏基准上的领先,都是在腾讯自己搭建的评测框架里得到的,不同厂商的评测框架本来就很难横向比较。真正有说服力的验证,往往来自第三方机构的复测、开源社区的实际使用反馈,以及企业在生产环境里跑出来的故障率和成本数据。在这些数据出现之前,最稳妥的阅读方式是把腾讯的公告当作一份“厂商主张清单”,逐项去验证,而不是当作一份已经盖棺定论的成绩单。这种态度不是对腾讯的不信任,而是对所有模型发布都应该保持的基本审慎。
评论 (0)
原始来源
相关文章
印度 Sarvam AI 于 11 月 3 日发布决策模型 Prism:不生成长文本,只在给定选项中打分,平均 71.8 分、44 毫秒响应,权重以 Apache 2.0 开源。它的真正卖点不是最聪明,而是校准可靠、顺序稳定,适合塞进自动化链路里做判断层。
Google 11 月 3 日宣布 Guided Learning 进入搜索试点与 Classroom 全球上线,同时 Gemini、Gemini Notebook、Gemini in Classroom 与搜索在 K-12 学生账号上默认全部关闭、等待管理员明确打开。但搜索与 AI 深度绑定,拒绝 AI 的学校也将失去学生搜索入口。
Anthropic 发布开源原型 FlashProve,用 zkSNARK 证明一段回答确实来自事先承诺的模型权重,而不必公开权重。单张 H100 上约每秒 110 个 token、证明约 19MB,但证明开销仍是普通推理的 70 到 95 倍,上下文仅限 1024 个 token,且暂无部署计划。