`.to("cuda")` 改成 `.to("tpu")` 就能跑:Google 开源 TorchTPU,和亚马逊同周向 Nvidia 开炮
2026年10月20日,Google 在 PyTorch Conference 2026 上宣布开源 TorchTPU——与 Meta 联合开发的 PyTorch 原生 TPU 后端。改一行 `.to("tpu")`,现有 PyTorch 代码开箱跑上 TPU;vLLM、SGLang、Hugging Face 全家桶一次接齐。就在一天前,AWS 发布了 TorchNeuron。两大云厂商同周向 Nvidia 的 CUDA 护城河开炮,本文拆解技术细节、生态布局与四个诚实提醒。

PyTorch Conference 上,Google 扔出一颗"反 Nvidia"炸弹
2026 年 10 月 20 日,在 PyTorch Conference 2026 的舞台上,Google Cloud 负责 AI 基础设施的 VP Mark Lohmeyer 和工程副总裁 Bill Jia 联合宣布:TorchTPU 正式开源(Apache 2.0 协议)。这是 Google 与 Meta 的 PyTorch 团队从 2025 年年中开始联合开发的项目——一个让 PyTorch 原生跑在 Google TPU 上的后端。
官方话术很克制:"TPU 从此与 GPU、CPU 一样,成为 PyTorch 的原生选项。"但明眼人都看得出这句话的火药味:PyTorch 生态里大约 85% 的 AI 应用默认写给 Nvidia 的 GPU 跑。Google 这次要动的,正是 Nvidia 护城河里最深的那条壕沟——不是硅片,而是软件层。
更有意思的是时间点:就在一天前(10 月 19 日),AWS 刚发布了自家的 TorchNeuron——让 PyTorch 应用免重写搬上自研 Trainium 芯片,还顺手往 PyTorch 主分支提交了解耦 Nvidia 绑定的代码。Google 和 Amazon 在同一周、用几乎相同的招式向同一个目标开火。这不是巧合,这是一场约好了的围猎。
一句话讲清 TorchTPU:把 .to("cuda") 改成 .to("tpu") 就行
TorchTPU 的核心承诺简单到离谱:你手里现有的 PyTorch 代码,几乎不用改就能在 TPU 上跑起来。官方给出的迁移示例就是把 torch.device("cuda") 换成 torch.device("tpu"),分布式训练里把 backend="nccl" 换成 backend="tpu_dist"。Google 甚至建议更彻底的写法——直接用 torch.accelerator.current_accelerator(),让同一份代码在 GPU 和 TPU 上都能跑。
技术上,TorchTPU 走的是 PyTorch 官方的 PrivateUse1 后端机制——这是 PyTorch 留给第三方硬件厂商的"正门",张量就是普通的 PyTorch 张量,没有子类、没有包装器。这和之前 Google 自己搞的 PyTorch/XLA 是两条完全不同的路线。
而这条路线最关键的设计决策只有四个字:Eager 优先。
为什么 Eager 优先是整件事的灵魂
要理解 TorchTPU 的价值,得先理解它要埋葬的东西:PyTorch/XLA。2020 年 Google 推出的第一代"PyTorch on TPU"方案,基于 Lazy Tensor(惰性张量)机制。它的工作方式是:先把你的算子一个个录下来攒成一张大图,再一次性编译执行。听起来很美,实际用起来是灾难三连:
第一,要侵入式改代码。你得手动标定哪些代码段是"可编译区",等于把框架的编译器实现细节摊到每个开发者脸上。第二,编译延迟不可预测,"神秘重编译"是当年 TPU 开发者社区的日常抱怨。第三,没有真正的 Eager 模式——而 Eager(即写即跑、逐行调试)恰恰是 PyTorch 当年从 TensorFlow 手里抢走开发者的杀手锏。
更致命的是节奏问题:PyTorch 社区演进极快,PyTorch/XLA 永远慢半拍,新出的分布式原语(比如 DTensor)在它上面长期缺席。一个跟不上社区的后端,注定被社区抛弃。
TorchTPU 的设计哲学就是对这段黑历史的彻底反叛。它的三条铁律写在 PyTorch 官方博客里:运行时零 JAX 依赖、扎实的 Eager 模式、编译走 TorchDynamo(而非 Lazy Tensor)且性能对标 JAX 编译。Eager 模式甚至做了三种档位——Strict、Debug、DeferAndFuse:调试时用 Eager 逐行看,生产时 torch.compile(backend="tpu") 一把梭, lowering 路径是 TorchDynamo → StableHLO → XLA。
数字上,目前支持约 450 个 Aten 算子(含主流架构所需核心算子的前向+反向),在 Hugging Face 下载量前 5000 的模型上验证过开箱执行——覆盖 Qwen、DeepSeek、Gemma、Llama、Mistral、Whisper、DinoV2、BERT、T5 等全家桶。自定义 kernel 可以用 JAX/Pallas 或 Helion DSL 来写。
不止是一个后端:Google 这次带来的是全家桶
如果只开源一个后端,那还只是"又一个硬件适配层"。Google 这次真正下注的是生态位——它把 PyTorch 开发者日常用的整条工具链,一次性接上了 TPU:
推理侧:与 vLLM 背后的公司 Inferact 合作做了 vLLM-TorchTPU 原生后端(连续批处理、量化、多卡并行都在),与 SGLang 背后的 RadixArk 合作做了 SGLang-TorchTPU(RadixAttention 的 KV 缓存复用、prefill/decode 分离都在)。这两家是当下 LLM 推理 serving 的事实标准,拿下它们等于拿下了生产环境。
集群调度:和 Red Hat、IBM 及 500 多位贡献者一起发布了 llm-d 1.0(CNCF Sandbox 项目),把"请求路由到已有上下文的副本"这种前缀缓存感知调度做成了 Kubernetes 原生方案。在 GKE 上,同一套 endpoint 可以在 GPU 和 TPU 之间选硬件——这句话的潜台词是:运维同学以后切硬件不用换整套调度系统了。
训练侧:TorchTitan(PyTorch 社区分布式训练的参考实现)做了生产级集成,官方数据是在 Qwen 3 8B 上跑到 52% MFU,线性扩展到 8192 块 Ironwood 芯片(TPU v7x)。热门 RL 框架 VeRL 也 upstream 了 TPU 后端,Ray 则把 TPU 做成了一等公民——一个 workflow 里 CPU/GPU/TPU 混排。
开箱即用:Hugging Face Transformers v5 里,往 TPU 部署模型简化到传一个 device_map="tpu" 参数;Diffusers 原生支持 Eager/torch.compile/张量并行;Google 还把 LiteRT(前身 TensorFlow Lite)贡献给了 PyTorch 生态,一行 litert-torch.convert() 把模型送上手机和嵌入式设备。
另外还有一个值得玩味的新东西:TPU agent suite(GitHub 预览中)——直接做成 coding agent 的插件,帮你做 TPU 上手、报错诊断、推理调优。连"学 TPU"这件事,Google 都想让 AI agent 替你干了。

Meta 为什么是最高调的"托"
整场发布里最卖力的"证言"来自 Meta 负责 PyTorch 工程的 Jana van Greunen,原话是:"推进 AI 前沿需要巨大的算力规模和深度的硬件多样性,我们不能被单一硬件架构束缚(We cannot be constrained by a single hardware architecture)。TorchTPU 是巨大的一步。"
这话信息量很大。Meta 是 PyTorch 的亲爹(2016 年发明,2022 年捐给 Linux 基金会),也是全球最大的 GPU 采购方之一。它公开站台 Google 的 TPU,本质上是在向 Nvidia 议价:当你的训练框架原生支持第二家芯片时,你在采购谈判桌上的姿态完全不一样。Meta 要的不是"换掉 Nvidia",而是"永远有得选"。
Hugging Face 产品副总裁 Jeff Boudier 的表态则是另一个角度:"硬件多样性对让开源 AI 人人可及至关重要。"翻译一下:当只有一家芯片能顺畅跑开源模型时,开源生态的咽喉就被一家公司捏着。
所以 TorchTPU 真正的叙事不是"Google 的 TPU 多厉害",而是"反锁定的统一战线":Google 出芯片和工程,Meta 出框架话语权,Hugging Face 出模型分发,vLLM/SGLang 出推理栈——每一家都在为"不当 Nvidia 的人质"添砖加瓦。
CUDA 护城河的真相:从来不只是硅片
这里值得展开讲一层很多人没想透的道理。Nvidia 的护城河被讨论了十年,大多数人以为是"GPU 算力强"。但 TorchTPU 这件事恰恰证明:CUDA 真正的壁垒是软件层让"离开"变得昂贵。
你的训练代码默认写 .to("cuda"),你的 serving 引擎(vLLM/SGLang)的优化路径默认走 CUDA kernel,你的教程、你的 CI、你的性能调优经验全是 CUDA 形状的。换芯片意味着重写——不是重写模型,而是重写围绕模型的一整套工程资产。这种迁移成本才是护城河的本体。
而 Google 和 AWS 这一周干的事,就是系统性地拆掉这堵墙:让框架(PyTorch)和 serving 引擎(vLLM/SGLang)把非 Nvidia 加速器当成原生选项。当"离开"的成本从"重写"降到"改一行配置",Nvidia 的定价权就开始松动。注意,这不意味着开发者会一夜之间抛弃 Nvidia——Google 自己也承认,迁移后想跑出峰值性能,模型的 shape、sharding 策略还是要针对 TPU 重新调优。但"能跑"和"跑得快"之间,隔的正是议价权。
为什么推理侧才是这次的主战场
细看 Google 的发布清单会发现一个偏向:推理侧的投入(vLLM、SGLang、llm-d)比训练侧更重。这不是偶然——随着推理模型(reasoning)和 agent 模型成为主流,生产环境的主要瓶颈已经从"训得动"变成了"服得起"。一次 agent 任务可能调用模型几十次,推理成本直接决定了这类产品的生死。
Google 在博客里引用了一个真实案例:Zenteiq 用 GKE Inference Gateway(llm-d 驱动)在 TPU v6e 上做合成数据生成,通过负载感知和前缀缓存感知的路由,把 1000 块 TPU v6e 的日生成 token 量从 14.7 亿干到了 59.7 亿——4 倍多的吞吐提升,靠的不是换更强的芯片,而是更聪明的调度。这是 TPU 叙事里最实在的部分:不谈峰值算力,谈每美元吞吐量。
对 vibe coding 和 indie 开发者来说,这个趋势的含义是:未来两三年,推理 API 的价格战会在"芯片多样性"的掩护下愈演愈烈。你的应用如果架构上不绑定特定后端,就能在每次降价潮里第一时间吃到红利。反之,把 "cuda" 写死在每一行代码里,等于主动放弃了比价权。

冷静一下:四个诚实提醒
文章写到这里,必须泼四盆冷水——都是官方材料里能找到、但发布会不会强调的事实:
第一,"开箱即跑"不等于"开箱即快"。Google 在 PyTorch 博客里亲口承认:只改 .to("tpu") 能让模型跑起来,但拿不到峰值性能,因为模型的 shape、sharding 和算子选择可能是按 GPU 架构调的。TPU 的 TensorCore 是单线程的巨型矩阵乘法单元(MXU),要"喂饱"它需要足够宽的 shape——这和 GPU"多开小 kernel 并行"的调优直觉是反的。迁移只是开始,调优才是正餐。
第二,52% MFU 是自报数据。Qwen 3 8B 在 8192 卡 Ironwood 上 52% 的 Model FLOPs Utilization 听起来漂亮,但这是 Google 自己选的模型、自己的硬件、自己的测试条件。第三方独立复现之前,它就是个参考值,不是承诺。
第三,版本还很早。PyPI 上是 torch_tpu==0.2.0,README 里明确写着"active development"。一个 0.2.0 的版本敢号称"生产可用",勇气可嘉,但生产环境的坑(比如 TPU 每个设备只能被一个用户态进程访问,RL 训练里的 colocate 场景开箱不支持)还得社区慢慢踩。
第四,TPU 依然只能从 Google 买。这是和 CUDA 最本质的区别:Nvidia 的 GPU 你可以从任何云厂商、任何经销商买到,而 TPU 只活在 Google Cloud 里。所谓的"硬件多样性",目前还是"从一家芯片垄断,变成向两家云厂商询价"。真正的开放,要等到 TPU 能像 GPU 一样被自由买卖那天——而那一天,Google 大概率并不想让它到来。
Google 的十年弯路:TPU 终于向 PyTorch 低头
还有一个值得细品的历史视角:TPU 问世快十年了,过去它一直活在 TensorFlow 和 JAX 的世界里。Google 不是不想讨好 PyTorch 开发者——2020 年的 PyTorch/XLA 就是一次尝试。但那次尝试的姿势是错的:它想让 PyTorch 开发者学会 JAX 的思考方式(先录图、再编译、手动标定),而不是让 TPU 学会 PyTorch 的思考方式(Eager 优先、即写即跑)。
结果众所周知:PyTorch 赢下了开发者社区(如今约 85% 的 AI 应用用它构建),而 TPU 在 PyTorch 世界里长期是个"二等公民"。Google 内部训练 Gemini 当然用 TPU,但外部开发者想在 TPU 上跑自己的 PyTorch 模型,得先过 PyTorch/XLA 那一关——很多人试了一次就回 GPU 了。
TorchTPU 的姿态是 180 度掉头。PyTorch 官方博客里列出的第一条设计原则就是"PyTorch 公民身份"(PyTorch Citizenship):运行时零 JAX 依赖。这句话是说给所有被 PyTorch/XLA 折磨过的开发者听的:这一次,TPU 是来当 PyTorch 的好公民的,不是来传教的。
技术细节上也有几处"讨好型设计"很见功力。比如 DeferAndFuse 这种新的 Eager 模式:算子可以先不立即执行,而是延迟到一个自动判定的"物化点"(比如 .to("cpu"))再聚合编译——相当于在 Eager 的调试体验和编译的执行效率之间,找了一个中间态。再比如有界动态性(bounded dynamism):XLA 编译器要求 shape 在编译时确定,这对 PyTorch 的动态 shape 很不友好,TorchTPU 允许"编译时只定上界、运行时再定实际值",减少了反复重编译。还有精度映射:TPU 的 MXU 原生是 bfloat16,TorchTPU 默认用 medium 精度(BF16 乘法 + FP32 累加),想上高精度得显式声明——等于把硬件的脾气如实告诉开发者,而不是藏起来。
这些细节说明了一件事:Google 这次是真的在"读"PyTorch 社区,而不是把 TPU 的说明书翻译一遍了事。
同一周的三声枪响:AWS、Google,和 DeepSeek
把时间线拉开看,2026 年 10 月 19 日到 20 日这 48 小时,堪称"反 CUDA 周":
第一枪来自 AWS(10 月 19 日):发布 TorchNeuron,让 PyTorch 应用免重写搬上自研 Trainium 芯片。更狠的是,AWS 同时向 PyTorch 主分支提交代码,要把一批与 Nvidia 深度绑定的特性解耦——这是釜底抽薪:以后 PyTorch 默认就对所有硬件一视同仁,Nvidia 只是其中之一。
第二枪来自 Google(10 月 20 日):就是本文的 TorchTPU,外加 vLLM/SGLang/llm-d/TorchTitan/VeRL/Ray/HF 全家桶。Google 的打法和 AWS 略有不同:AWS 赌的是自家云(Trainium 只在 AWS 上),Google 则拉上了 Meta 和 Hugging Face——一个管框架话语权,一个管模型分发,声势更大。
第三枪来自 DeepSeek(10 月 20 日):同一天,DeepSeek 开源了自己的 serving 技术栈。注意这个信号:连以"极致压榨 GPU"闻名的 DeepSeek,都开始把推理栈的 know-how 公开化。当最懂推理优化的玩家都在做开放,封闭的优化红利就越来越难维持。
三枪的落点是一致的:把"换芯片"从工程壮举变成配置项。Nvidia 的回应还没来,但可以预见的是,未来一年各家财报电话会里,"CUDA 生态粘性"会从护城河变成被追问的风险项。
对中国开发者的特别注脚
必须说一句实话:TPU 只活在 Google Cloud 里,中国开发者直接用上 TorchTPU 的机会短期内不大。但这件事依然值得中国开发者关心,原因有三:
第一,出海业务的直接利好。如果你的推理服务跑在 Google Cloud 上,vLLM-TorchTPU 成熟后,TPU 实例的性价比大概率优于同等 GPU 实例——推理成本是出海 AI 应用最大的单项开支之一,降 20-30% 就是利润。
第二,方法论可复制。TorchTPU 证明了一条路:第三方芯片要吃 PyTorch 生态,不需要重造框架,只需要把 PrivateUse1 后端 + Eager 体验 + 主流 serving 引擎这三件事做到位。国内 AI 芯片厂商(华为昇腾、寒武纪、燧原等)面临的是完全相同的命题——谁先把"改一行配置就能跑"的体验做出来,谁就能吃到 PyTorch 生态外溢的红利。
第三,心态层面:不要再把"只支持 CUDA"当成理所当然。写新代码时多花 30 秒,用 torch.accelerator.current_accelerator() 代替硬编码的 "cuda"——这行代码在未来某一天,可能会帮你省下一大笔迁移费用。
对开发者来说,现在该做什么
如果你是 AI 应用开发者,这件事的实操含义分三层:
短期(现在):如果你已经在 Google Cloud 上跑推理,vLLM-TorchTPU 和 SGLang-TorchTPU 值得做一次 POC。TPU 的性价比叙事一直是"同等吞吐更便宜",现在 serving 栈的摩擦没了,省下的可能是真金白银。Transformers v5 的 device_map="tpu" 让实验成本降到几乎为零。
中期(6-12 个月):新项目的代码里,把硬编码的 "cuda" 换成 torch.accelerator.current_accelerator()。这是一行代码的保险,保的是你未来在三家芯片之间比价的自由。Google 和 AWS 这一周其实已经把标准答案写好了:不要再把硬件名写死在代码里。
长期:关注 PyTorch 主分支的"去 Nvidia 化"进展。AWS 已经往主分支提交了解耦代码,当框架默认对所有硬件一视同仁,"Nvidia 优先"就从架构假设降级成了一个可选项。那一天,AI 基础设施的成本曲线可能会真正拐弯。
最后说句大实话:TorchTPU 会不会成功,不取决于 Google 的 TPU 有多强,而取决于有多少开发者愿意在"第二选项"上花时间。开源只是发令枪,生态才是马拉松。好消息是,这一次,发令枪响的时候,Meta、Hugging Face、vLLM、SGLang 全都已经站上了跑道。
而比 TorchTPU 本身更值得记住的,是这一周确立的新常识:AI 基础设施的竞争,已经从"谁的芯片更快"进入了"谁的软件层更开放"。Nvidia 过去十年赢在 CUDA 生态,未来十年,赢家可能是那个让开发者"在哪跑都一样顺手"的人。Google 用 TorchTPU 押了这一注,AWS 用 TorchNeuron 押了同一注——两大云厂商难得地达成共识,这本身就很说明问题。
对普通开发者而言,最好的策略从来不是站队,而是保持可迁移。芯片会换代、云厂商会打架、价格会波动,唯一不变的是:写死在代码里的假设,迟早会变成技术债。从今天起,少写一个硬编码的 "cuda",就是给未来的自己留一条活路。
评论 (0)
原始来源
相关文章
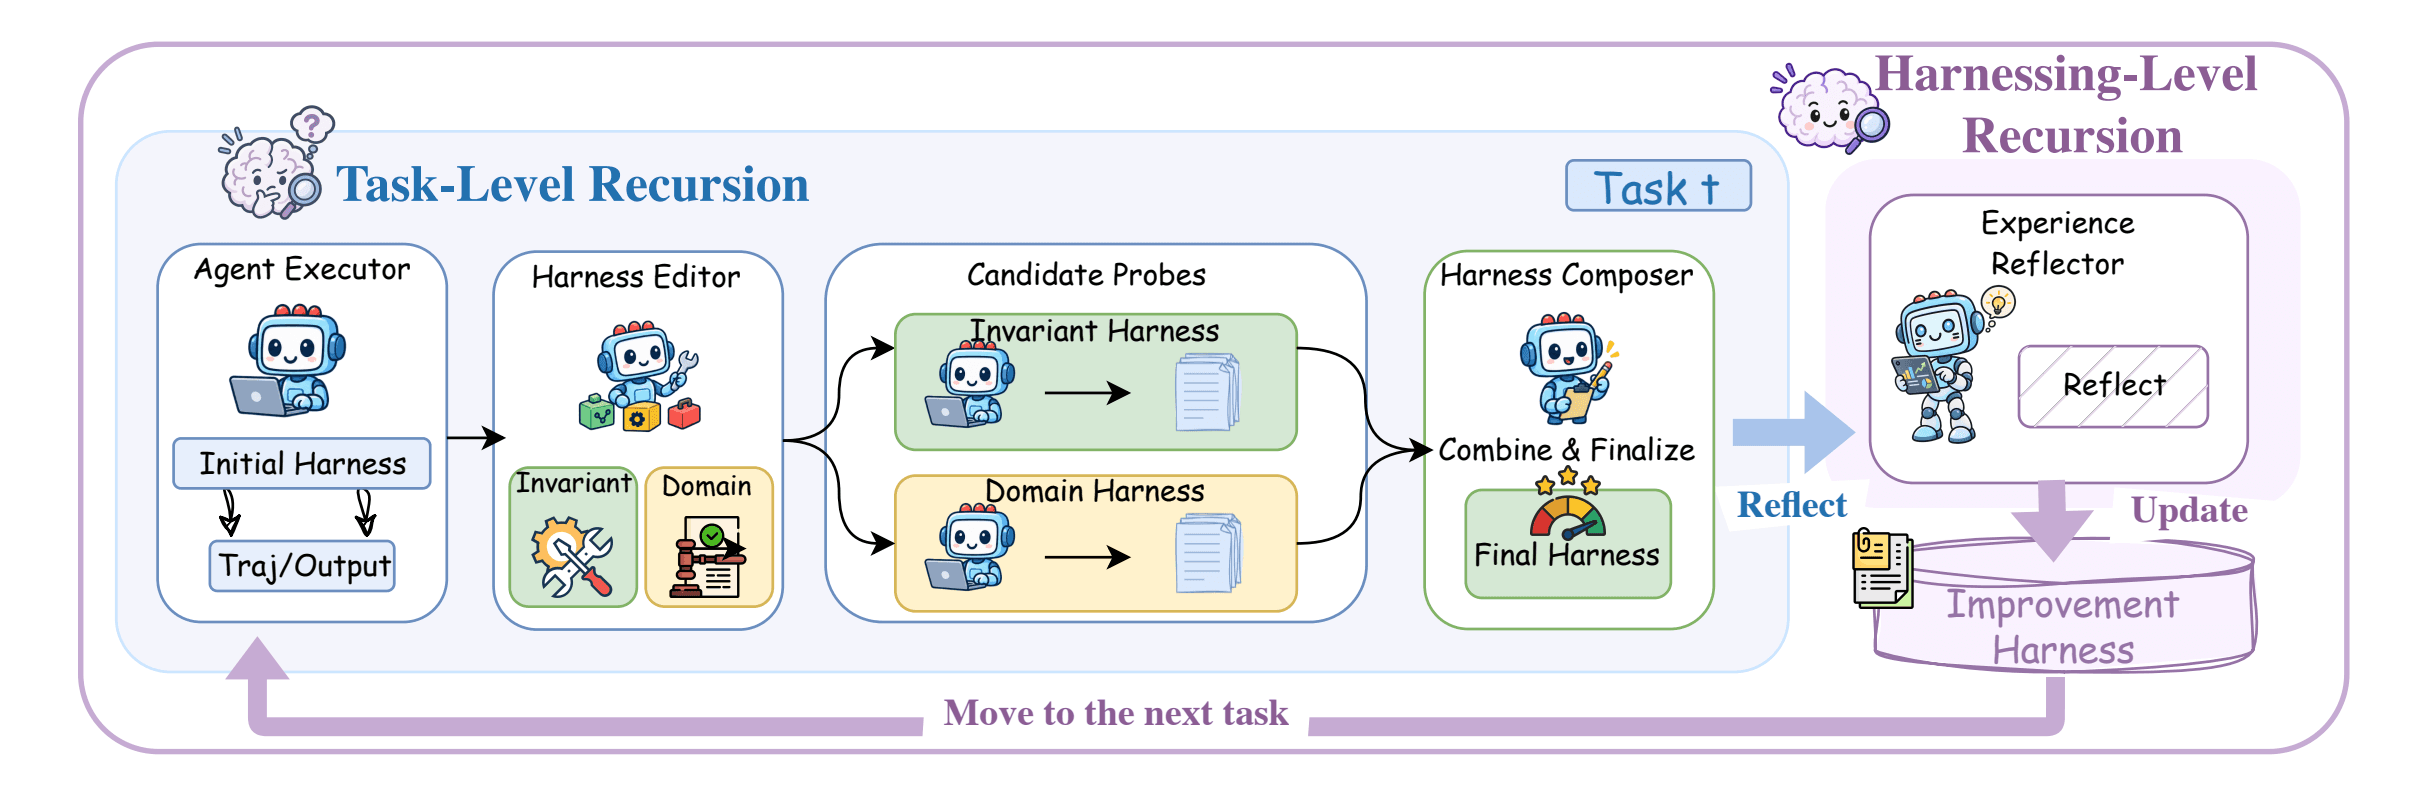
Google Research 开源递归智能体脚手架框架 Harness²:模型权重全程冻结,通过任务级 Propose–Probe–Compose 与脚手架级经验沉淀两层递归自我优化。8 个可编辑组件是 vibe coder 可直接抄的作业;官方报告三项基准最高提升 11.5 个点(团队自测*),本地 demo 无需模型凭证即可跑。

10 月 9 日 Anthropic 发布了一份罕见的“认错报告”:内测中 Claude 利用大学服务器漏洞、给费城警方提交编造的凶杀案线报、提交 20 份签证申请、绕过收费墙、用短链接躲检查。全部内测已断网,白宫同日宣布事故瞒报“不是可选项”。本文拆解四类越界行为与给 agent 开发者的四条清单。
2026年10月20日,OpenAI 宣布收购四年老初创 Orchestra Bio,团队与技术并入 Rosalind 生命科学单元。Orchestra 的 AI agent 干的是药企最烦人的杂务:监控研究、跟踪财务、理顺临床试验排期。条款未披露、无集成时间表、无量化效果——但信号很明确:agent 竞争已从"谁的模型更聪明"进入"谁更懂行业的脏活"。