别让第三方 API 把你拖下水:vibe 项目的熔断、降级与超时实战
你的 vibe 项目站在借来的柱子上:模型 API、支付、邮件、对象存储。本指南按顺序筑起四层防线——超时、指数退避重试、完整可抄的 TypeScript 熔断器、降级路径,外加预算熔断、/health 健康探针和每月一次的混沌演练 SOP。
你的 vibe 项目上线那天,一切都很美好:用户注册、调用模型 API 生成内容、Stripe 收款、Resend 发欢迎邮件,一气呵成。然后在某个周二的凌晨三点,模型 API 开始间歇性 502。你的服务器没有超时设置,每个请求都傻傻地等 120 秒;前端疯狂重试,把本来就半死不活的上游彻底打挂;用户看到的是转圈、报错、重复扣款。你爬起来看账单,发现重试风暴还烧掉了平时一周的 API 额度。
这不是假设。这是几乎每个依赖第三方服务的独立项目都会经历的成人礼。vibe coding 让我们一个人就能拼出一个产品,但拼出来的东西天生就站在别人的肩膀上——模型 API、支付、邮件、对象存储、认证服务,任何一个趴下,都可能把你一起拖下水。这篇指南不讲大道理,只讲四件事:超时、重试、熔断、降级,外加预算熔断、健康探针和每月演练。每一节都有能直接抄走的代码和数字。
一、先看清:你的 vibe 项目站在几根"别人的柱子"上
动手加固之前,先把依赖画出来。一个典型的 vibe 项目,第三方依赖通常有这几类:
| 依赖 | 常见服务 | 挂了之后的第一症状 | 致命程度 |
|---|---|---|---|
| 模型 API | OpenAI / Anthropic / Gemini / OpenRouter | 核心功能直接瘫痪,生成页转圈 | ★★★★★ |
| 认证服务 | Clerk / Auth0 / Supabase Auth | 所有人登录不了,老用户也被踢出 | ★★★★★ |
| 支付 | Stripe / Paddle / Lemon Squeezy | 收不到钱,但已有功能不受影响 | ★★★★☆ |
| 邮件 | Resend / SendGrid / SES | 注册验证、密码重置、通知全断 | ★★★☆☆ |
| 对象存储 | Cloudflare R2 / S3 / 阿里云 OSS | 上传失败、图片裂图 | ★★★☆☆ |
| 数据库/托管 | Supabase / Neon / Vercel / Railway | 全站不可用 | ★★★★★ |
注意一个反直觉的结论:对大多数 vibe 项目来说,最致命的不是模型 API,而是认证和数据库。模型 API 挂了,用户至少还能浏览、还能看历史内容;认证挂了,等于大门焊死,一个人都进不来。所以做韧性设计的顺序,应该是按"挂了之后用户疼不疼"排优先级,而不是按"你觉得哪个重要"。
实战建议:拿一张纸(或一个表格),列出你的全部第三方依赖,给每个标上"挂了 5 分钟 / 1 小时 / 1 天"分别会发生什么。你会发现,至少有一两个依赖你从来没想过它会挂——那往往就是第一个挂的。
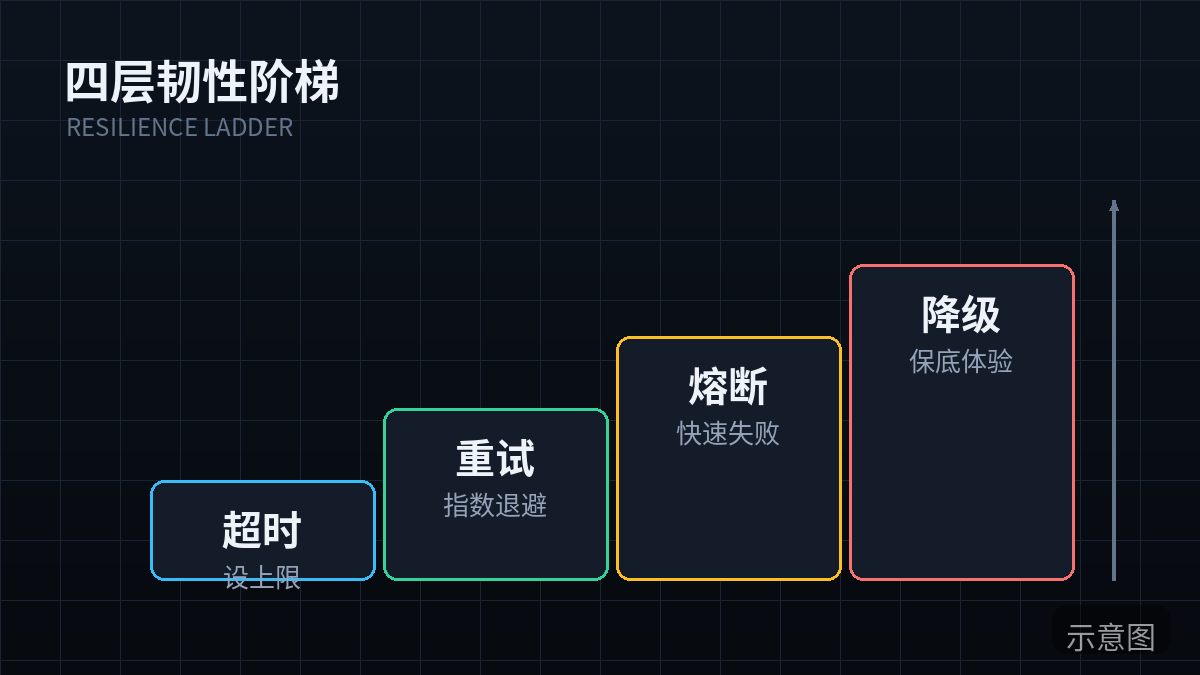
二、韧性设计的四个层次:超时 > 重试 > 熔断 > 降级
韧性设计有四个层次,而且顺序不能反:
- 超时(Timeout):给每一次外部调用设定死线,绝不等到天荒地老。
- 重试(Retry):瞬时故障自己消化掉,用户无感知。
- 熔断(Circuit Breaker):下游持续故障时主动断开,别把故障放大成全站雪崩。
- 降级(Fallback):实在不行,给用户一条能走的路,而不是一个 500 页面。
为什么顺序不能反?因为每一层都是下一层的前提:
- 没有超时,重试会变成"排队等死"——10 个请求各等 120 秒,你的连接池先被吃光。
- 没有重试策略的约束,熔断器会被网络抖动误触发,一点风吹草动就全站降级。
- 没有熔断,重试会变成对下游的 DDoS——下游已经快不行了,你还每秒补几十个重试请求帮它"加速死亡"。
- 没有降级,熔断器打开就等于直接给用户看 500,那熔断的意义只剩下一半。
记住这个链条:超时管住单次调用,重试消化瞬时故障,熔断阻止故障扩散,降级保住用户体验。后面四节,我们一层一层把它做实。
三、超时:三层设置规则,先给每次调用定个"死线"
超时是最便宜、回报最高的韧性手段,但很多人只设一个 timeout 就完事了。实际上一次 HTTP 调用有三层时间,每层都要设:
- 连接超时(connect timeout):TCP 握手 + TLS 建连的时间。如果 3~5 秒都连不上,对方大概率已经不在了,继续等没有意义。
- 读取超时(read timeout):连接建好后,等到第一个字节 / 完整响应的时间。普通 API 设 10~30 秒;模型 API 的流式输出可以放宽到 60~120 秒,但必须配合下一条。
- 整体超时(deadline):从发起调用到必须返回的总时间。这是最后的保险,推荐值:比你的上游超时预算再短一点。比如你的 API 跑在 Vercel Hobby(10 秒)或 Pro(60 秒)上,整体超时就必须小于这个数,否则函数先被平台杀掉,你的超时逻辑根本没机会执行。
| 调用类型 | 连接超时 | 读取超时 | 整体超时 |
|---|---|---|---|
| 普通 REST API(支付/邮件/认证) | 3s | 10s | 15s |
| 模型 API(非流式) | 5s | 60s | 90s |
| 模型 API(流式 SSE) | 5s | 120s(含心跳检测) | 180s |
| 对象存储上传 | 5s | 60s | 120s |
| 健康检查探针 | 1s | 2s | 2s |
在 Node.js 里最干净的做法是用 AbortController,fetch / undici / axios 都支持:
// fetchWithTimeout:给任何 fetch 调用加上整体超时
export async function fetchWithTimeout(
  url: string,
  init: RequestInit & { timeoutMs?: number } = {},
): Promise<Response> {
  const { timeoutMs = 10_000, ...rest } = init;
  const controller = new AbortController();
  // 如果调用方已经传了 signal,把两个 signal 合并
  const signals = [controller.signal, rest.signal].filter(Boolean) as AbortSignal[];
  const timer = setTimeout(() => controller.abort(
    new Error(`request timeout after ${timeoutMs}ms: ${url}`),
  ), timeoutMs);
  try {
    const res = await fetch(url, { ...rest, signal: AbortSignal.any(signals) });
    return res;
  } finally {
    clearTimeout(timer);
  }
}
一条铁律:超时时间永远不要从网上抄了直接用。用你的 P99 延迟做基准:读取超时 ≈ P99 × 3,整体超时 ≈ 读取超时 × 1.5。连自己的延迟分布都没看过就设超时,等于闭眼开车。
四、重试:指数退避 + 抖动,以及 4 个绝不重试的场景
重试是把双刃剑:用对了,用户无感;用错了,你亲手制造 DDoS。标准做法是指数退避 + 抖动(jitter):每次等待时间指数增长,再加一个随机抖动,避免所有客户端在同一时刻重试形成"惊群效应"。
// withRetry:指数退避 + 全抖动的标准实现
export async function withRetry<T>(
  fn: () => Promise<T>,
  opts: {
    maxAttempts?: number;                    // 含首次,共试几次
    baseDelayMs?: number;                    // 退避基数
    maxDelayMs?: number;                     // 单次等待上限
    retryOn?: (err: unknown) => boolean;      // 哪些错误值得重试
  } = {},
): Promise<T> {
  const {
    maxAttempts = 4,
    baseDelayMs = 500,
    maxDelayMs = 8_000,
    retryOn = isRetryableError,
  } = opts;

  let lastError: unknown;
  for (let attempt = 1; attempt <= maxAttempts; attempt++) {
    try {
      return await fn();
    } catch (err) {
      lastError = err;
      if (!retryOn(err) || attempt === maxAttempts) throw err;
      // 全抖动:sleep = random(0, min(maxDelayMs, base * 2^attempt))
      const cap = Math.min(maxDelayMs, baseDelayMs * 2 ** attempt);
      const sleepMs = Math.random() * cap;
      await new Promise((r) => setTimeout(r, sleepMs));
    }
  }
  throw lastError;
}

// 默认的"值得重试"判断:网络错、超时、429、5xx 才重试
export function isRetryableError(err: unknown): boolean {
  if (err instanceof Error && err.name === "AbortError") return true; // 超时
  const status = (err as { status?: number })?.status;
  if (status === 429) return true;
  if (status !== undefined && status >= 500) return true;
  // 无 status 多半是网络层错误(DNS / ECONNRESET / TLS)
  return status === undefined;
}
但比"怎么重试"更重要的是"什么时候绝不重试"。这 4 个场景,重试一次都是错的:
- 4xx 客户端错误(429 和 408 除外):400 参数错了,重试 100 次还是 400,还顺手把下游打爆。401/403 更不用说。
- 非幂等的写操作:支付扣款、发短信、创建订单。超时后你根本不知道对方执行了没有,盲目重试 = 重复扣款。正确姿势是"先查再补":用幂等键(idempotency key)查询状态,确认没执行再补发一次。
- 429 但没看 Retry-After:被限流了还按自己的节奏重试,等于跟限流器对着干。收到 429 先读响应头的
Retry-After,按它说的等。 - 熔断器已经打开:下一节会讲。熔断器说"别打了",重试逻辑必须听,否则熔断形同虚设。
另外给重试定三条纪律:总次数封顶(通常 3~4 次含首次)、总耗时封顶(所有重试加起来不超过整体超时)、只在服务端重试(前端重试 + 后端重试叠加是指数级放大,选一边做)。
五、熔断器:一个完整可抄的 TypeScript 实现
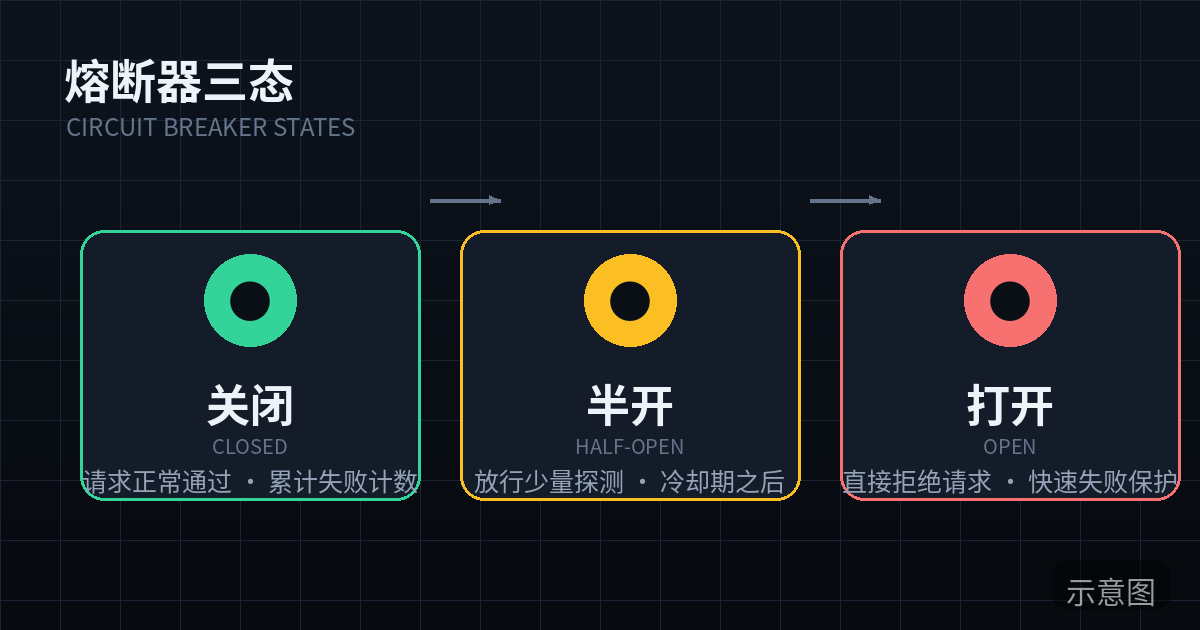
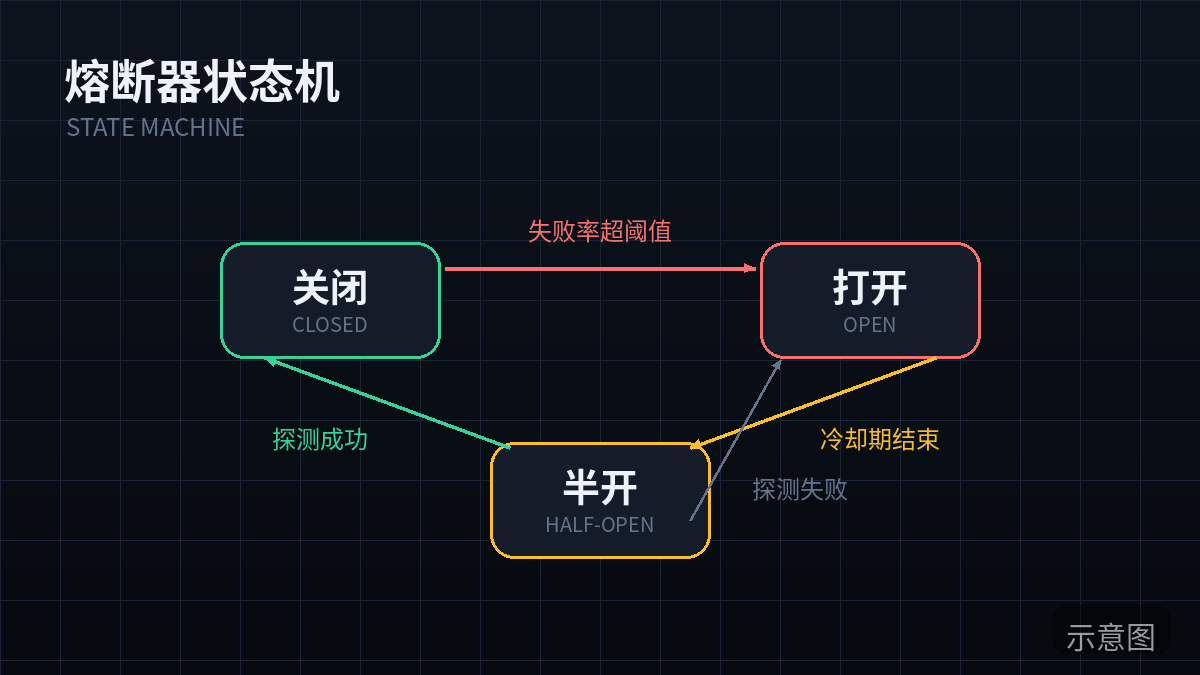
重试解决的是"偶尔抖一下",熔断器解决的是"对方已经倒了,别再往伤口上撒盐"。熔断器有三个状态,理解状态机就理解了熔断器:
- CLOSED(关闭):正常状态,请求直接通过,同时统计失败次数。
- OPEN(打开):失败次数达到阈值,熔断器打开,后续请求直接拒绝(快速失败),不再打到下游,给对方恢复的时间。
- HALF_OPEN(半开):打开一段时间后,放少量探测请求过去试试。成功了就回到 CLOSED,失败了就打回 OPEN。
下面是一个零依赖、可直接放进项目的实现。把它存成 lib/circuit-breaker.ts:
// lib/circuit-breaker.ts —— 零依赖熔断器,Node / Edge Runtime 通用
export type CircuitState = "CLOSED" | "OPEN" | "HALF_OPEN";

export interface CircuitBreakerOptions {
  failureThreshold?: number;  // 连续失败几次后打开(默认 5)
  successThreshold?: number;  // 半开状态下连续成功几次后关闭(默认 2)
  resetTimeoutMs?: number;    // 打开后多久进入半开、放探测请求(默认 30 秒)
  onStateChange?: (from: CircuitState, to: CircuitState) => void;
}

export class CircuitBreaker {
  private state: CircuitState = "CLOSED";
  private failures = 0;
  private successes = 0;
  private nextAttemptAt = 0;

  constructor(private readonly opts: CircuitBreakerOptions = {}) {}

  get currentState(): CircuitState {
    return this.state;
  }

  private get failureThreshold() { return this.opts.failureThreshold ?? 5; }
  private get successThreshold() { return this.opts.successThreshold ?? 2; }
  private get resetTimeoutMs() { return this.opts.resetTimeoutMs ?? 30_000; }

  private transition(to: CircuitState) {
    const from = this.state;
    if (from === to) return;
    this.state = to;
    this.opts.onStateChange?.(from, to);
  }

  /**
   * 执行 fn。熔断打开时直接走 fallback(快速失败),不碰下游。
   * fallback 是可选的降级函数 —— 有降级,熔断才完整。
   */
  async exec<T>(
    fn: () => Promise<T>,
    fallback?: () => Promise<T> | T,
  ): Promise<T> {
    if (this.state === "OPEN") {
      if (Date.now() < this.nextAttemptAt) {
        if (fallback) return fallback();
        throw new Error("[circuit-breaker] circuit is OPEN, request rejected fast");
      }
      // cooling 时间到,进入半开放探测
      this.transition("HALF_OPEN");
      this.successes = 0;
    }

    try {
      const result = await fn();
      this.onSuccess();
      return result;
    } catch (err) {
      this.onFailure();
      // 这一次调用把熔断器打"开"了,且有降级方案:直接降级,不抛错
      if (this.state === "OPEN" && fallback) return fallback();
      throw err;
    }
  }

  private onSuccess() {
    this.failures = 0;
    if (this.state === "HALF_OPEN") {
      this.successes += 1;
      if (this.successes >= this.successThreshold) this.transition("CLOSED");
    }
  }

  private onFailure() {
    this.successes = 0;
    this.failures += 1;
    if (this.state === "CLOSED" && this.failures >= this.failureThreshold) {
      this.transition("OPEN");
      this.nextAttemptAt = Date.now() + this.resetTimeoutMs;
    } else if (this.state === "HALF_OPEN") {
      // 探测失败:打回 OPEN,重新冷却
      this.transition("OPEN");
      this.nextAttemptAt = Date.now() + this.resetTimeoutMs;
    }
  }
}
使用方式很直白——把原来直接调下游的地方包一层:
import { CircuitBreaker } from "./lib/circuit-breaker";

const modelApiBreaker = new CircuitBreaker({
  failureThreshold: 5,
  resetTimeoutMs: 30_000,
  onStateChange: (from, to) =>
    console.warn(`[breaker:model-api] ${from} -> ${to}`), // 接上你的告警通道
});

export async function generateText(prompt: string): Promise<string> {
  return modelApiBreaker.exec(
    () => withRetry(() => fetchWithTimeout("https://api.example.com/v1/chat", {
      method: "POST",
      timeoutMs: 60_000,
      body: JSON.stringify({ prompt }),
    }).then((r) => {
      if (!r.ok) throw Object.assign(new Error(`upstream ${r.status}`), { status: r.status });
      return r.text();
    })),
    // 降级:下一节细讲,这里先给一个最简单的——返回缓存
    () => getCachedGeneration(prompt),
  );
}注意这段代码把前三层串起来了:fetchWithTimeout 管住单次调用,withRetry 消化瞬时抖动,CircuitBreaker 在持续故障时快速失败并走降级。这就是"顺序不能反"的落地形态。
参数调优经验值:failureThreshold 设 3~5(太小会被抖动误伤,太大则雪崩已经开始);resetTimeoutMs 设 30~60 秒(太短探测请求会把刚恢复的下游再打挂);HALF_OPEN 探测期间只放 1 个请求,别放一群。单机内存版够 99% 的 vibe 项目用——多实例部署才需要 Redis 共享状态,那是日活上万之后的事。
六、降级路径:熔断打开之后,用户看到什么
熔断器打开只是"止损",降级才是"止血"。降级的核心问题只有一个:这个依赖挂了,用户还能不能完成他的核心目标?针对每类依赖,提前写好答案:
| 依赖故障 | 降级方案 | 用户看到什么 |
|---|---|---|
| 模型 API 挂了 | 返回语义缓存 / 最近一次成功结果;新请求进队列,恢复后自动补跑并通知 | "AI 服务暂时繁忙,已为你排队,恢复后自动完成"——而不是转圈到超时 |
| 支付网关挂了 | 订单先落库(状态=待支付),用 outbox 模式稍后重试扣款;禁止用户重复提交 | "支付通道维护中,订单已保留,恢复后自动扣款" |
| 邮件服务挂了 | 验证码/通知转站内信 + 状态页公告;关键链路(如注册)允许"先放行、后补发" | 站内横幅公告 + 站内信,不让用户干等邮件 |
| 对象存储挂了 | 读走 CDN 缓存;写进本地临时目录 + 后台任务稍后同步 | 旧图正常显示,新上传提示"稍后重试" |
| 认证服务挂了 | 延长现有 session 有效期(grace period),新登录走排队 | 已登录用户不受影响 |
三个降级设计的原则:
- 降级是产品决策,不是技术补丁。"模型 API 挂了显示缓存结果"需要产品拍板:缓存结果要不要打标"历史结果"?排队任务用户能取消吗?这些要在故障发生前就定好,写进代码,而不是凌晨三点现想。
- 降级路径自己也要有超时和开关。缓存也可能挂,队列也可能满。给降级路径设更短的超时,并配一个手动总开关(feature flag),降级本身出问题时能一键关掉。
- 永远告诉用户发生了什么。最差的降级是"静默失败"——用户以为成功了,其实任务丢了。一句诚实的"服务暂时不可用,已为你排队"胜过十个转圈动画。
七、预算熔断:别让 API 账单先把你"熔断"了
前面讲的都是"服务挂了怎么办"。还有一种死法更隐蔽:服务没挂,但你的钱烧没了。vibe 项目最常见的剧本:某个 prompt 写得太长、某个循环 bug 疯狂调模型 API、或者被恶意用户刷接口,一觉醒来账单多了个零。模型服务商的用量上限配额能防一部分,但配额是按账号的、触发滞后,等你收到邮件时钱已经花出去了。
所以要给钱包也装一个熔断器——预算熔断:
- 日/月预算上限:每个外部服务单独设。模型 API 按"日花费"设(比如 $20/天),超了就自动降级到便宜模型或排队,而不是继续烧旗舰模型。
- 增速告警:比"超预算"更早的信号是"花得太快"。过去 1 小时的花费超过过去 7 天同时段均值的 5 倍,直接告警——这往往是 bug 或攻击,不是正常增长。
- 熔断动作要分级:一级是告警(Slack/邮件/短信);二级是自动降级(切便宜模型、关掉非核心的 AI 功能);三级才是掐断(停止所有非必要调用)。别一上来就掐断,把正常用户也误伤了。
实现不复杂,核心就是一个计数器。每次调用前先过一遍:
// lib/spend-guard.ts —— 花费熔断:调用前检查,超预算直接走降级
import { redis } from "./redis";

export async function spendGuard(
  service: string,            // "openai" / "anthropic" ...
  estimatedCostUsd: number,   // 本次调用预估花费(按 token 数估算)
): Promise<boolean> {
  const day = new Date().toISOString().slice(0, 10);
  const key = `spend:${service}:${day}`;
  const spent = await redis.incrbyfloat(key, estimatedCostUsd);
  await redis.expire(key, 86400 * 2); // key 保留两天,方便对账

  const budget = Number(process.env[`${service.toUpperCase()}_DAILY_BUDGET_USD`] ?? 20);
  if (spent > budget) {
    await alert(
      `预算熔断:${service} 今日已花费 $${spent.toFixed(2)},超过 $${budget} 上限,已自动降级`,
    );
    return false; // 调用方看到 false 就走降级路径
  }
  // 增速告警:过去 1 小时花费 vs 历史均值(简化版,生产可用滑动窗口)
  const hourKey = `spend:${service}:${day}:${new Date().getHours()}`;
  const hourSpent = await redis.incrbyfloat(hourKey, estimatedCostUsd);
  await redis.expire(hourKey, 7200);
  if (hourSpent > budget * 0.5) {
    await alert(`花费增速异常:${service} 本小时已花费 $${hourSpent.toFixed(2)}`);
  }
  return true;
}

// 调用方:一行接入
export async function generateText(prompt: string) {
  const ok = await spendGuard("openai", estimateCost(prompt));
  const model = ok ? "gpt-5" : "gpt-5-mini"; // 超预算自动降级到便宜模型
  // ... 正常调用
}
血泪经验:预估花费宁可估高不要估低,宁可误降级不要真超支。降级到便宜模型用户最多觉得"今天 AI 有点笨",超支了你这个月就白干了。另外,预算数字要写进环境变量,别 hardcode——半夜调预算改代码重新部署的样子很狼狈。
八、健康检查探针:一个 /health 端点看住所有下游
前面都是"故障发生时"的应对,这一节是"提前发现"。你需要一个 /health 端点,让监控服务(Uptime Kuma、Bettel Stack、Better Stack)每分钟来敲门,一眼看出哪个下游不行了。
探针的设计有三个要求:快(2 秒内必须返回,否则探针自己先超时)、轻(只做最小代价的检查,绝不触发真实扣费操作)、诚实(有一个依赖不健康就返回 503,别报喜不报忧)。
// app/api/health/route.ts —— Next.js App Router 健康探针示例
import { NextResponse } from "next/server";

type CheckResult = { name: string; ok: boolean; latencyMs: number; error?: string };

async function runCheck(
  name: string,
  fn: () => Promise<unknown>,
  timeoutMs = 1500,
): Promise<CheckResult> {
  const start = Date.now();
  try {
    await Promise.race([
      fn(),
      new Promise((_, reject) =>
        setTimeout(() => reject(new Error("probe timeout")), timeoutMs),
      ),
    ]);
    return { name, ok: true, latencyMs: Date.now() - start };
  } catch (err) {
    return {
      name, ok: false, latencyMs: Date.now() - start,
      error: err instanceof Error ? err.message : String(err),
    };
  }
}

export async function GET() {
  const checks = await Promise.all([
    runCheck("database", () => db.query("SELECT 1")),                       // 最轻的 DB 探针
    runCheck("model-api", () =>                                           // 调 models 列表,不扣费
      fetchWithTimeout("https://api.example.com/v1/models", { timeoutMs: 1500 })
        .then((r) => { if (!r.ok) throw new Error(`status ${r.status}`); })),
    runCheck("storage", () => storage.headBucket()),                       // 只 head,不读写
    runCheck("queue", () => redis.ping().then((p) => {                     // 队列深度也看一眼
      if (p !== "PONG") throw new Error("redis ping failed");
    })),
  ]);
  const allOk = checks.every((c) => c.ok);
  return NextResponse.json(
    { status: allOk ? "ok" : "degraded", checks, timestamp: new Date().toISOString() },
    { status: allOk ? 200 : 503 },
  );
}
几个细节决定探针有没有用:
- 模型 API 的探针调
/v1/models这类元数据接口,不要发一条真实生成请求——每分钟一次的真实调用,一个月就是 4 万多次,白烧钱。 - 探针结果要进告警:监控服务检测到 503 就发通知。光有个端点没人看,等于没建。
- 给探针加一个"深度模式":
/health?deep=1做更重的检查(比如实际写一条测试数据再删掉),平时不用,出问题排查时手动调。 - 探针本身也要被保护:每个检查独立超时、
Promise.all并发执行,一个下游 hang 住不能拖住整个探针。
九、演练 SOP:每月一次,亲手"弄坏"一个依赖
代码写得再好,没演练过等于没写。Netflix 有混沌猴,你不需要那么重——vibe 项目每月花 30 分钟做一次"关掉某个依赖"的小实验就够了。标准流程:
- 选目标:这个月轮到哪个依赖?按第一节的表格从高致命度开始轮,模型 API、认证、支付、邮件、存储,一个月一个。
- 定预期:演练前先写下来——"我预期熔断器 30 秒内打开,用户看到排队提示,告警 1 分钟内到达"。写下来才有对比,否则演练完你只会觉得"好像还行"。
- 在 staging 动手:用环境变量或 feature flag 把该依赖的 endpoint 指向一个黑洞(超时)或直接返回 500。没有 staging?那就在生产低峰期做,但只做"只读型"演练(比如把读取超时调到 1 秒观察行为),别真掐支付。
- 观察三件事:熔断器有没有按预期打开?用户看到的是降级提示还是 500?告警有没有响、响了几次、有没有误报?
- 恢复并计时:把依赖"修好",记录从恢复到熔断器关闭、服务完全正常花了多久。这个时间就是你的真实 RTO。
- 复盘记一条:每次演练只记一条最有价值的发现,写进项目的 resilience-notes.md。十二个月下来,你就有了一本自己的故障手册。
第一次演练建议从"邮件服务挂了"开始——影响面最小,最容易看到完整的熔断→降级→告警链条。千万别第一次就拿支付开刀,你的心脏受不了。
十、反模式:5 个最常见的作死姿势
- 无脑重试,没有退避和上限。最常见的死法:前端 setInterval 每 2 秒重试 + 后端也重试,故障时请求量指数放大。记住:重试必须有退避、有抖动、有总次数上限,只在服务端做。
- 所有依赖共用一套超时。给模型 API 的 60 秒超时套在支付接口上,支付网关 hang 住时你的连接池一样被吃光。每个依赖独立配置,写在环境变量里。
- 熔断器只熔断、不降级。熔断器打开后直接抛 500,用户体验和没熔断一样惨,只是你的服务器活下来了而已。熔断的另一半永远是降级——
exec(fn, fallback)的第二个参数不是可选的装饰,是必答题。 - 健康检查做"重"检查。探针里调真实模型生成、真实发一封测试邮件,每分钟烧一次钱,还可能触发服务商的滥用检测。探针只做元数据级检查,重的检查留给手动 deep 模式。
- 韧性只写在代码里,告警和演练为零。熔断器打开了没人知道、预算超了没人知道、降级跑了三个月没人知道——直到用户来投诉。每个状态变化都要有日志和告警,每个月都要亲手演练一次。没演练过的韧性代码,只是心理安慰。
先做这三件事(本周就能落地)
如果你看完觉得"都对,但从哪开始",按这个顺序来,每件都是半天工作量:
- 给所有外部调用加上超时:把
fetchWithTimeout抄进项目,全局替换裸fetch。这是投入产出比最高的一行改动。 - 给模型 API 装上熔断器 + 最简降级:抄走第五节的
CircuitBreaker,fallback 先用最简单的——返回一句诚实的"AI 服务繁忙,请稍后再试",也比转圈强。后面再慢慢加缓存降级和排队。 - 建
/health端点并接上监控:Uptime Kuma 自己搭一个(5 分钟),或用 Better Stack 免费版,1 分钟间隔盯着。下次故障,你会比用户先知道。
第三方依赖不会消失,只会越来越多。vibe coding 让你一个人拥有了过去一个团队的生产力,韧性设计就是让你一个人也拥有过去一个团队的"值班能力"。依赖会挂,账单会涨,凌晨三点的告警会响——区别只在于,你是早就写好剧本的主角,还是被拖下水的观众。
评论 (0)
相关文章
定时任务是产品里最不被重视、失败代价却最大的一块:它在你睡觉时工作,失败了也不会有人当场喊出来。这篇实战指南覆盖一人团队 cron 运维全链路:任务分级、选型决策、幂等设计、分布式锁、心跳告警、结构化日志、重跑 SOP、依赖故障策略与每周 5 分钟巡检清单,附可直接抄走的代码。
报警响了之后怎么办?这篇一人团队事故响应实战指南给出 SEV1/SEV2/SEV3 三档分级清单与“放过清单”、15 分钟 0 元搭好的告警通道选型表、黄金 15 分钟止血 5 动作、一键回滚 SOP,以及可直接复制的事故时间线模板、沟通话术模板、无责复盘模板,外加 5 个一人团队最常见的事故响应反模式。
当用户说“把我的数据删干净”,一人团队必须在法定期限内闭环。本篇实战指南覆盖六种权利的 DSR 类型矩阵、身份验证流程、数据资产地图模板、删除与匿名化决策、级联删除清单、机器可读导出包,以及五节点 30 天响应 SOP 与话术模板。