cron 任务在凌晨 3 点挂了,没人知道——一人团队的定时任务运维实战
定时任务是产品里最不被重视、失败代价却最大的一块:它在你睡觉时工作,失败了也不会有人当场喊出来。这篇实战指南覆盖一人团队 cron 运维全链路:任务分级、选型决策、幂等设计、分布式锁、心跳告警、结构化日志、重跑 SOP、依赖故障策略与每周 5 分钟巡检清单,附可直接抄走的代码。
凌晨 3 点 17 分,你的手机安安静静。昨晚 11 点你明明确认过:日报邮件的 cron 任务今天会准时发出。但它没有。不是报错——报错至少会吵醒你——而是任务静默地没跑。原因?上周你升级了服务器镜像,crontab 没迁移过来。就这么简单,也就这么致命:第二天早上 9 点,三十多个付费用户在群里问"今天的日报呢",你才知道出事了。
这是每个一人团队都会撞上的墙。定时任务是整个产品里"最不被重视、失败代价却最大"的一块:它在你睡觉的时候工作,失败了也不会有人当场喊出来。等你发现时,伤害已经扩散——邮件没发、数据没同步、账单没对上、过期的试用账号还在白嫖。
这篇指南不谈理论,只谈一人团队能落地的 cron 运维实战:从选型、幂等、锁、告警、日志,到重跑 SOP 和每周 5 分钟巡检。每一节都对应一个真实踩过的坑,代码可以直接抄走。
一、一人团队的 cron 任务画像:先给每个任务定"失败代价"
运维的第一步不是搭监控,而是给任务分级。一人团队的任务数量不多(通常 5~20 个),但失败代价天差地别。先把你的任务列出来,按"失败后多久会被发现、损失是什么"打上标签。
下面是四个最常见的任务画像,覆盖了 90% 的一人产品:
| 任务类型 | 典型例子 | 失败多久会被发现 | 失败代价 | 建议告警级别 |
|---|---|---|---|---|
| 日报/通知类 | 每日数据日报邮件、续费提醒 | 几小时(用户会来问) | 信任损失,用户觉得"产品没人管" | P1:失败 10 分钟内必须知道 |
| 数据同步类 | 从第三方 API 拉订单、同步库存 | 半天到一天(数据对不上才发现) | 下游决策全错,且错误会累积 | P1,附带数据断层检测 |
| 清理类 | 删过期文件、清试用账号、归档日志 | 几天甚至几周 | 磁盘爆掉、僵尸账号越积越多 | P2:每天汇总一次即可 |
| 账单对账类 | 对支付流水、生成发票 | 月底(对账时才发现) | 直接的钱的问题,漏一单都是实损 | P0:失败立刻电话/强提醒 |
注意一个反直觉的结论:清理类任务失败代价最低,但它是最容易被忽视的。磁盘满了导致整个服务宕机,一人团队里这种"小任务引发大事故"的案例比比皆是。所以分级的目的不是"只管重要的",而是"给每个任务匹配相应强度的保障"——P0 任务配电话告警 + 人工确认,P2 任务配每日汇总邮件就够了。
实战建议:建一张任务清单表(用 Notion、飞书多维表格都行),列是任务名、运行频率、负责人(就是你)、失败代价等级、上次成功时间。每次新增任务先填表再写代码。这张表未来就是你的巡检清单。
二、选型:四种跑定时任务的方式,一人团队怎么选
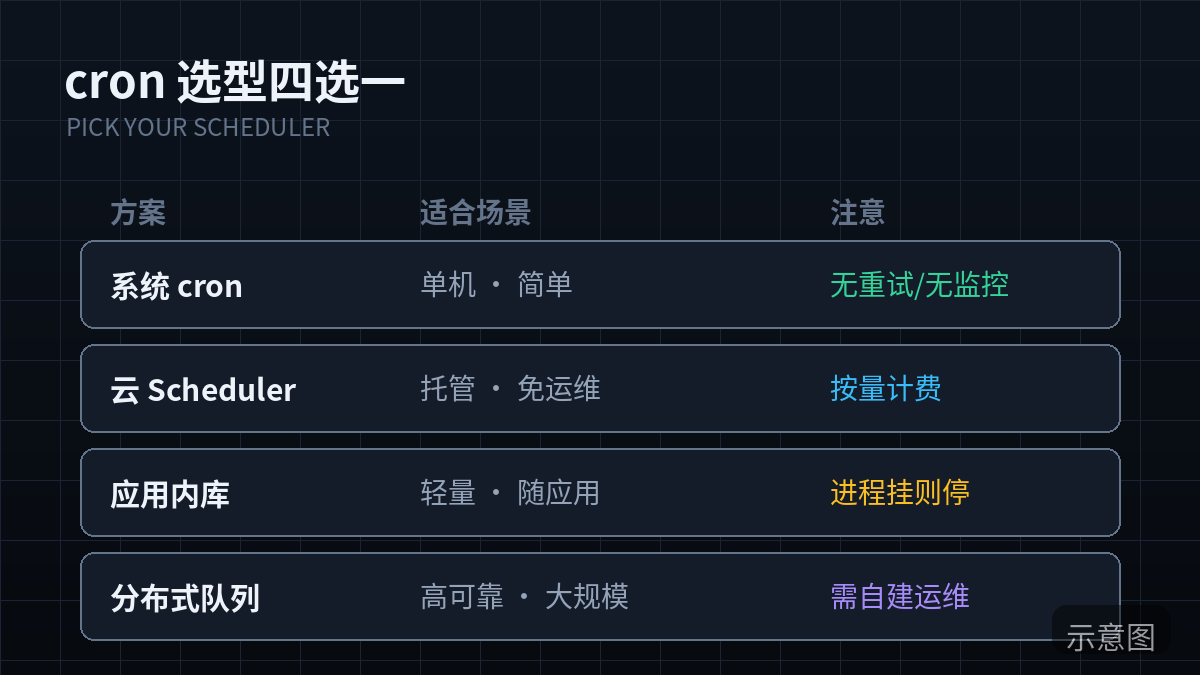
很多教程上来就教你配 Linux crontab,但 2026 年的一人团队有更多选择。选错跑法,后续的运维成本会翻倍。下面这张决策表是按"一人团队"这个约束条件做的——默认你没时间折腾运维:
| 操作系统 cron | Vercel Cron / 平台定时 | GitHub Actions 定时 | 队列延迟任务(如 BullMQ) | |
|---|---|---|---|---|
| 成本 | 免费(已有服务器) | 免费档够用,超量按次收费 | 公开仓库免费,私有仓库按分钟计费 | 需要 Redis,约 $5~10/月 |
| 最大单次运行时长 | 无限制 | 通常 60s~300s(看套餐) | 6 小时(但不建议跑这么久) | 无限制 |
| 失败可见性 | 几乎为零(要自己搭) | 平台自带运行日志 | Actions 页面自带日志和邮件通知 | 要自己搭 Dashboard |
| 适合场景 | 长任务、重型批处理、已有 VPS | 轻量触发器("到点叫我") | 爬虫、数据同步、备份脚本 | 需要重试/延迟/优先级的业务任务 |
| 最大的坑 | 服务器迁移就丢任务;单点 | 超时杀进程,且冷启动延迟 | 免费额度用完悄悄停跑;cron 表达式是 UTC | Redis 挂了任务全丢(要用持久化) |
给一人团队的选型建议只有三条:
- 能用平台定时就别自己搭。Vercel Cron、Cloudflare Workers Cron Triggers 这类,把"机器挂了任务还跑不跑"的问题交给了平台。你省下的运维时间比那点费用贵得多。
- 超过 5 分钟的任务不要放进平台定时里。正确姿势是"平台定时只做触发器":cron 到点后往队列里扔一个 job,真正的重活由 worker 慢慢做。这样既利用了平台的可靠性,又不受超时限制。
- GitHub Actions 是被低估的 cron。数据同步、备份、发日报这种"每天跑一次、跑完就结束"的脚本,放在 Actions 里有免费日志、有失败邮件通知、版本和代码在一起,几乎零运维。注意两点:私有仓库注意分钟数额度;schedule 写的是 UTC 时间,北京时间减 8 小时。
血泪教训:不要把 cron 表达式写死在各处。用一个集中的配置文件(或环境变量)管理所有任务的调度时间,并注释"北京时间"。时区问题在第十节还会细说——它是 cron 世界的第一杀手。
三、幂等设计:让任务可以安全重跑
这是整篇指南最重要的技术节。cron 任务一定会失败,也一定会被重跑(手动或自动)。如果重跑一次就多发一封邮件、多扣一次款,那你的重跑 SOP 就是一句空话。幂等的意思是:同一个任务跑 N 次,效果和跑 1 次一样。
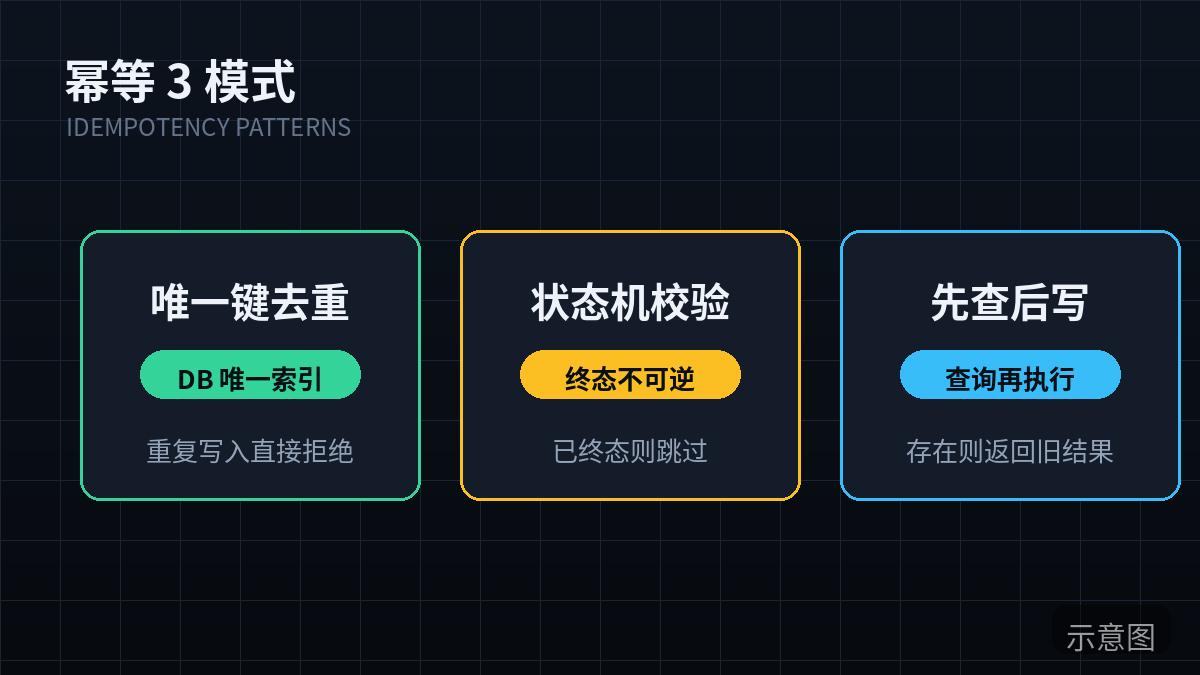
三种实现模式,按推荐顺序排列:
模式一:唯一键去重(最常用)
给每次"业务动作"生成一个天然唯一的键,写库时用唯一约束挡住重复。比如日报邮件,用 user_id + date 做唯一键:
-- PostgreSQL:先建唯一约束,一劳永逸
CREATE TABLE daily_reports (
  id SERIAL PRIMARY KEY,
  user_id UUID NOT NULL,
  report_date DATE NOT NULL,
  sent_at TIMESTAMPTZ,
  UNIQUE (user_id, report_date)  -- 重跑时第二次 INSERT 直接冲突
);

-- 发送逻辑:INSERT ... ON CONFLICT DO NOTHING
-- 返回 0 行 = 今天已经发过,直接跳过;返回 1 行 = 本次真正发送
# Python:发送前先"占位",占位成功才真正发
def send_daily_report(user_id, report_date):
row = db.execute("""
INSERT INTO daily_reports (user_id, report_date)
VALUES (%s, %s)
ON CONFLICT (user_id, report_date) DO NOTHING
RETURNING id
""", (user_id, report_date)).fetchone()
if row is None:
log.info("skip duplicate", extra={"user_id": user_id, "date": report_date})
return # 已经发过,重跑安全
try:
mailer.send(build_report(user_id, report_date))
db.execute("UPDATE daily_reports SET sent_at = now() WHERE id = %s", (row.id,))
except Exception:
# 发送失败:删掉占位,允许下次重跑
db.execute("DELETE FROM daily_reports WHERE id = %s", (row.id,))
raise注意 except 里的删除操作:占位和发送之间如果进程被杀,会留下一条"占了位但没发"的记录。下次重跑时 ON CONFLICT DO NOTHING 会误判为"已发送"而跳过。更严谨的做法是加一个状态机——这就是模式二。
模式二:状态机(适合多步骤任务)
当任务有多个步骤(拉数据 → 计算 → 发邮件 → 记账),用状态字段记录进度,重跑时从断点继续:
# 状态:pending -> pulling -> computing -> sending -> done
#         \-> failed(任何一步异常都落到 failed,保留现场)
STEPS = ["pulling", "computing", "sending"]

def run_pipeline(run_id):
    run = get_run(run_id)
    start_idx = STEPS.index(run.state) if run.state in STEPS else 0
    for step in STEPS[start_idx:]:
        set_state(run_id, step)          # 每步开始前先落库
        try:
            globals()[f"do_{step}"](run)  # do_pulling / do_computing / do_sending
        except Exception as e:
            set_state(run_id, "failed", error=str(e))
            raise
set_state(run_id, "done")状态机的额外好处是可观测:巡检时一眼就能看出"昨晚的任务卡在 computing 那一步",而不是对着"失败了"三个字干瞪眼。
模式三:时间窗口去重(适合数据同步)
同步类任务最怕"同一批数据被拉取两次"。做法:每次同步记录本次处理到的最大时间戳(watermark),下次只拉大于 watermark 的数据:
def sync_orders():
    wm = get_watermark("orders_sync")  # 上次同步到的最大 updated_at
    batch = upstream.fetch_orders(since=wm, limit=500)
    if not batch:
        return  # 没有新数据,直接返回,重跑也无害
    upsert_orders(batch)  # 用订单号做唯一键,upsert 本身幂等
set_watermark("orders_sync", max(o.updated_at for o in batch))三个模式可以组合:同步任务用水位线保证"不重拉",写入时用唯一键保证"不重写",多步骤用状态机保证"可断点续跑"。记住一句话:幂等不是优化项,是 cron 任务的上线门槛。没有幂等设计的任务,不配设置自动重试。
四、超时与锁:防止任务自己跟自己打架
cron 任务的第二个经典死法:上一次还没跑完,下一次又启动了。两个实例同时跑,轻则重复处理,重则互相覆盖数据。尤其数据同步任务——上游 API 偶尔变慢,30 分钟的任务拖成 50 分钟,而你的调度间隔是 30 分钟。
解法是分布式锁:任务开始前先抢锁,抢不到就退出。但锁有三个细节做错会出大事:
- 锁必须有过期时间。进程被杀时不会主动释放锁,没有过期时间 = 锁永远卡死 = 任务永远不再跑。用 Redis 的
SET key value NX PX 300000(NX=不存在才设置,PX=5 分钟过期),原子操作一步到位。 - 锁的过期时间要大于任务的最大合理时长,但又不能太大。一个实用的经验值:锁超时 = 预估时长 × 3。如果任务平时跑 2 分钟,锁设 6~10 分钟。锁过期了但任务还在跑?那是另一个问题——说明任务时长失控了,应该告警而不是加长锁。
- 锁的值要是唯一的 run_id,释放时校验"这把锁是不是我加的"。否则会出现:实例 A 的锁过期了,实例 B 加上了锁,然后 A 跑完了把 B 的锁删了——经典的误删锁事故。
import uuid, time
import redis

r = redis.Redis(decode_responses=True)

def run_with_lock(job_name, max_seconds, fn):
    run_id = str(uuid.uuid4())[:8]
    lock_key = f"cron:lock:{job_name}"
    # NX:抢不到锁说明上一次还没跑完,直接退出(不堆积)
    acquired = r.set(lock_key, run_id, nx=True, px=max_seconds * 1000)
    if not acquired:
        log.warning("skip overlapped run", extra={"job": job_name})
        return "skipped"
    try:
        # 看门狗:任务执行期间定期续锁,防止长任务被误判死亡
        stop = threading.Event()
        def watchdog():
            while not stop.wait(max_seconds * 1000 / 3 / 1000):
                # 只有锁还是我的才续期
                if r.get(lock_key) == run_id:
                    r.pexpire(lock_key, max_seconds * 1000)
        threading.Thread(target=watchdog, daemon=True).start()
        return fn(run_id)
    finally:
        stop.set()
        # Lua 脚本保证"检查+删除"原子性,防止误删别人的锁
        r.eval("""
            if redis.call('get', KEYS[1]) == ARGV[1] then
                return redis.call('del', KEYS[1])
            end
            return 0
        """, 1, lock_key, run_id)
没有 Redis?PostgreSQL 用户可以用 pg_try_advisory_lock(),它是会话级锁,连接断开自动释放,连过期时间都不用操心,一人团队够用了:
-- 返回 true 才拿到锁;拿不到直接退出
SELECT pg_try_advisory_lock(hashtext('daily_report'));
-- 任务结束(或连接断开)后自动释放,也可手动:
SELECT pg_advisory_unlock(hashtext('daily_report'));最后是超时:每个任务都要设一个"超过多久算异常"的阈值。不是为了杀进程(杀进程可能导致数据写一半),而是为了告警。实现很简单:任务开始时记录时间, wrapper 里检查 duration > threshold 就发一条 P2 告警"任务超时运行中"。很多"任务 hang 住"的事故,都是靠这条规则先发现的。
五、失败告警:任务失败必须推到你手机上
cron 任务失败有两种:一种是抛异常退出的,另一种是"根本没启动"的(服务器重启、crontab 丢了、部署时把调度器停了)。只监控异常是不够的,你必须同时监控"该跑但没跑"。
方案一:心跳监控(防"没跑")—— Healthchecks.io / 自建 Uptime Kuma
原理反过来想:不是等任务报错,而是要求任务每次跑完都来"打卡"。到点没打卡,就说明出事了:
# 任务成功后 ping 一下,失败则 ping /fail
# Healthchecks.io 免费档:20 个 check,够一人团队用
curl -m 10 --retry 3 https://hc-ping.com/<your-uuid>       # 成功
curl -m 10 --retry 3 https://hc-ping.com/<your-uuid>/fail   # 失败
在 Healthchecks 里设置"期望每 24 小时打卡一次,宽限 1 小时",超时没收到就发告警。它还能区分"跑了但失败"和"根本没跑"——后者是 crontab 丢失、服务器宕机这类最危险的情况,靠异常监控永远发现不了。
方案二:异常推送(防"跑了但炸了")—— 飞书/Telegram Bot,零成本
给所有任务套一个统一的 wrapper,任何未捕获异常直接推到你手机上。飞书群机器人、Telegram Bot 都是免费的,5 分钟就能接好:
import traceback, requests, os

def alert_to_phone(title, body, level="P1"):
    # 飞书群机器人 webhook(换成你的地址)
    requests.post(os.environ["FEISHU_WEBHOOK"], json={
        "msg_type": "text",
        "content": {"text": f"[{level}] {title}\n{body}"}
    }, timeout=10)

def cron_wrapper(job_name, fn):
    run_id = str(uuid.uuid4())[:8]
    started = time.time()
    log.info("job started", extra={"job": job_name, "run_id": run_id})
    try:
        result = run_with_lock(job_name, MAX_SECONDS[job_name], lambda rid: fn(rid))
        log.info("job done", extra={"job": job_name, "run_id": run_id,
                                    "duration_ms": int((time.time()-started)*1000)})
        requests.get(f"https://hc-ping.com/{CHECK_UUID[job_name]}", timeout=10)  # 心跳打卡
        return result
    except Exception as e:
        log.error("job failed", extra={"job": job_name, "run_id": run_id,
                                       "error": traceback.format_exc()})
        requests.get(f"https://hc-ping.com/{CHECK_UUID[job_name]}/fail", timeout=10)
        alert_to_phone(f"{job_name} 失败", traceback.format_exc()[-1500:], level="P1")
        raise
告警分级:不是所有失败都值得半夜叫醒你
| 级别 | 定义 | 通道 | 例子 |
|---|---|---|---|
| P0 | 涉及钱,或核心功能停摆 | 电话/短信强提醒,15 分钟未确认升级 | 账单对账失败、支付回调处理中断 |
| P1 | 用户可感知的功能异常 | 手机推送(飞书/TG),1 小时内处理 | 日报邮件没发、数据同步中断 |
| P2 | 可延后,不影响用户 | 每天早 9 点汇总一封邮件 | 日志归档失败、清理任务超时 |
分级最大的价值是保护你的注意力。一人团队没有值班表,on-call 的人就是你 24 小时。如果清理任务失败也半夜震你手机,三个月后你就会把告警全关了——然后 P0 来的时候你也收不到。P2 坚决不打扰,这是铁律。
进阶:Healthchecks.io 的告警可以接到 PagerDuty 免费档或电话网关(如 Pushover $5 买断)做 P0 的电话提醒。一人团队花小钱把 P0 通道做扎实,是回报率最高的投入。
六、日志规范:出事时能 5 分钟定位,全靠平时怎么写
凌晨被 P1 告警吵醒,你只有手机。能不能在 5 分钟内判断"要不要起床",取决于日志里有没有关键字段。一人团队不需要 ELK 全家桶,但每个 cron 任务的日志必须包含下面这些字段——用结构化(JSON)格式输出,方便 grep 和过滤:
| 字段 | 说明 | 例子 |
|---|---|---|
| job_name | 任务名,全局唯一 | daily_report |
| run_id | 本次运行的唯一 ID,贯穿所有日志行 | a3f9c1d2 |
| started_at / finished_at | 开始/结束时间,UTC + ISO8601 | 2026-10-11T19:00:00Z |
| duration_ms | 耗时,用于发现"越跑越慢" | 84213 |
| status | started / done / failed / skipped | failed |
| rows_affected | 处理的数据量,断层检测靠它 | 1284 |
| error_code | 业务错误码,不是堆栈 | UPSTREAM_503 |
| error | 堆栈或错误信息(截断,防爆日志) | Traceback...(前 1500 字符) |
| host | 跑在哪台机器/哪个环境 | worker-1 / prod |
| trigger | 触发方式:schedule / manual / retry | manual(重跑时一眼区分) |
三个实战要点:
- run_id 是灵魂。没有它,一次运行的几十行日志就是散沙,手机上根本没法看。有了它,一句
grep a3f9c1d2 app.log就能还原完整现场。上面第五节的 wrapper 已经自动生成了 run_id,记得所有子函数都透传它。 - rows_affected 是数据任务的"心电图"。同步任务某天 rows_affected 从 1200 掉到 0,任务本身可能"成功"了(没抛异常),但数据断了。给关键任务加一条规则:rows_affected 连续 2 次为 0(或偏离 7 日均值 50% 以上)就发 P2 告警。
- 日志保留策略。云日志按量收费很贵:一人团队的做法是,原始日志保留 7 天(够排查),但把每次运行的"摘要行"(job_name/run_id/status/duration_ms/rows_affected)永久存进数据库小表。一年后你想查"这个任务历史成功率",查表就行,不用翻日志。
# 每次运行结束写一条摘要,表很小,随便查
CREATE TABLE cron_run_history (
  job_name TEXT NOT NULL,
  run_id TEXT PRIMARY KEY,
  trigger TEXT NOT NULL DEFAULT 'schedule',
  status TEXT NOT NULL,
  started_at TIMESTAMPTZ NOT NULL,
  duration_ms INT,
  rows_affected INT,
  error_code TEXT
);
CREATE INDEX ON cron_run_history (job_name, started_at DESC);
-- 查最近 30 天成功率:
-- SELECT status, COUNT(*) FROM cron_run_history
-- WHERE job_name='daily_report' AND started_at > now() - interval '30 days'
-- GROUP BY status;
七、重跑 SOP:手动重跑的安全步骤
任务失败后,最危险的动作就是"赶紧手动跑一遍"。慌乱中的重跑是二次事故的温床:没确认幂等就重跑导致重复扣款、重跑了错误的时间窗口导致数据错乱、重跑完没通知用户导致客诉。把下面这份 SOP 打印出来(或存成团队文档——团队就是你),每次重跑前照着走:
- 确认幂等(30 秒):这个任务重跑安全吗?查代码里的去重机制(唯一键/状态机/水位线)。如果答案是"不确定",先别跑——先去第三节补幂等,或者把重跑范围缩到最小。不确定的任务宁可不重跑,等天亮了再处理。
- 看日志定原因(2 分钟):用 run_id 找到失败那次运行的日志。区分三种情况:偶发异常(网络抖动)→ 可直接重跑;上游挂了 → 先看第八节;数据/逻辑 bug → 修代码再重跑,重跑旧代码只会再失败一次。
- 指定时间窗口(关键):重跑命令必须显式带上时间窗口参数,比如
--date 2026-10-11或--since/--until,绝不允许"默认跑今天"。默认值是重跑事故的最大来源:你以为是补昨天,结果它又跑了一遍今天。 - 用 trigger=manual 标记:手动重跑的日志 trigger 字段写
manual,并在摘要表里能区分。未来排查"我记得那天手动补过一次"时,这是唯一的证据链。 - 先干跑(dry-run),再真跑:对 P0/P1 任务,重跑先加
--dry-run看它"打算做什么"(会影响多少行、发多少封邮件),确认数字合理再去掉 dry-run。实现 dry-run 并不难:把写库/发邮件的调用包一层if dry_run: log only。 - 观察日志确认成功:重跑后盯着日志看完
status=done,核对 rows_affected 是否符合预期(比如补昨天的日报,rows 应该 ≈ 历史均值)。不要"跑完就关电脑"。 - 通知受影响的用户(如果需要):P1 级别以上的失败,重跑成功后发一条简短通知:"今日日报延迟 3 小时送达,给您带来不便非常抱歉。"用户不怕延迟,怕的是石沉大海。这条消息花你 2 分钟,能换回大量信任。
# 重跑命令的参考形态:显式窗口 + dry-run + 原因备注
python jobs/daily_report.py \
  --date 2026-10-11 \
  --trigger manual \
  --dry-run \
  --reason "cron missed, rerun per SOP"
# 确认输出合理后,去掉 --dry-run 再跑一遍
反面教材:某独立开发者的数据同步任务失败后,他直接在服务器上
python sync.py跑了一遍——脚本默认同步"最近 7 天",把已经同步过的 6 天数据又写了一遍。因为写入没有唯一键,订单表多了 4000 多条重复记录,清理花了一整个周末。记住:重跑的杀伤力永远大于第一次失败。
八、依赖失败处理:上游 API 挂了,任务该重试、跳过还是熔断
cron 任务很少是孤岛:它调支付接口、调第三方数据 API、读写数据库。上游一挂,你的任务跟着挂。这时候有三种策略,选错比不选更糟:
| 策略 | 做法 | 适用场景 | 反例(别这么用) |
|---|---|---|---|
| 重试(带退避) | 失败后等 2s、8s、32s 再试,最多 3~5 次 | 偶发的网络抖动、对方限流 429 | 对方 500 持续 1 小时,你重试 100 次等于 DDoS 人家 |
| 跳过(优雅降级) | 本次不跑,记一条 P2 日志,下次调度再说 | 非关键任务、可容忍数据晚一天 | 账单任务"跳过",月底对不上账 |
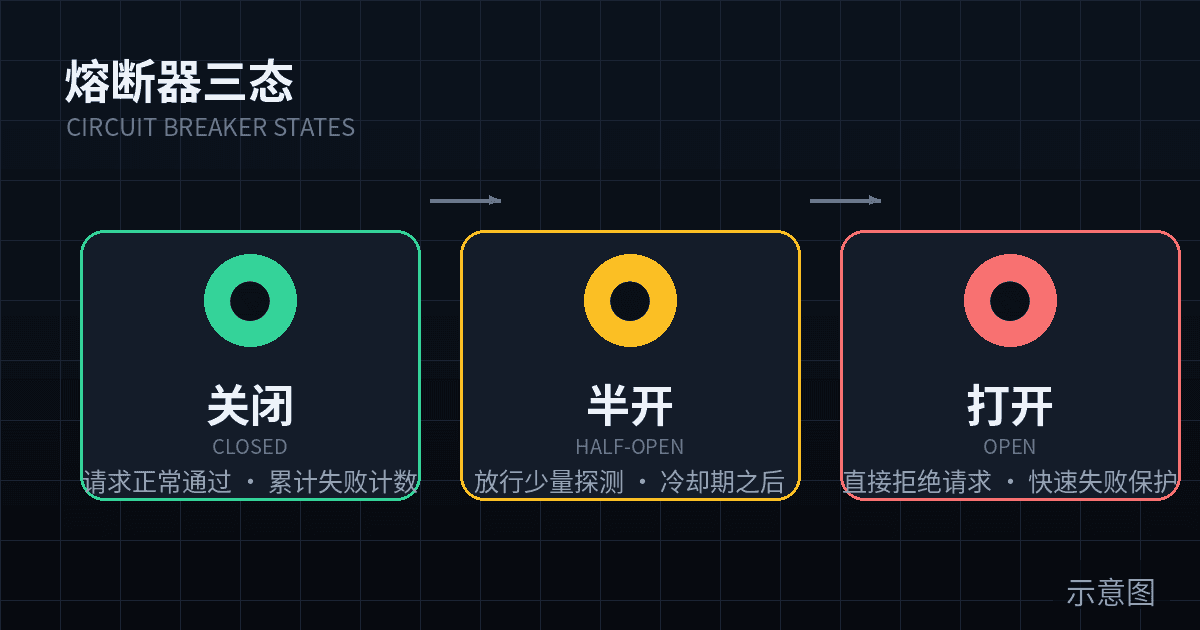
| 熔断(fail fast) | 连续失败 N 次后,直接不再尝试并报 P1 | 上游明确挂了、重试无意义时 | 阈值设太低,一次抖动就熔断,恢复还得手动 |
一人团队的推荐组合拳:任务内做"有限重试"(指数退避 + 抖动),任务外做"熔断计数"。代码如下:
import random, time

def with_retry(fn, max_attempts=4, base_delay=2):
    for attempt in range(1, max_attempts + 1):
        try:
            return fn()
        except TransientError as e:  # 只重试"瞬时错误":超时、429、503
            if attempt == max_attempts:
                raise
            # 指数退避 + 抖动:2s, 4s, 8s... 避免惊群效应
            delay = base_delay * (2 ** (attempt - 1)) + random.uniform(0, 1)
            log.warning("retrying", extra={"attempt": attempt, "delay": round(delay, 1)})
            time.sleep(delay)
        except PermanentError:
            raise  # 401/404/参数错误:重试 100 次也没用,直接抛

# 熔断计数存在 Redis,连续失败 5 次就熔断 30 分钟
def circuit_allows(job_name):
    fails = int(r.get(f"cron:fails:{job_name}") or 0)
    if fails >= 5:
        return False
    return True

# 在 cron_wrapper 的 except 里:r.incr(f"cron:fails:{job_name}"),成功后 r.delete(...)关键细节:区分"瞬时错误"和"永久错误"。超时、连接重置、429、503 可以重试;401(密钥错了)、404(接口下线了)、400(参数错了)重试就是浪费时间,还会把日志刷爆。在代码里定义两个异常类,接到上游错误时先分类,这是专业和业余的分水岭。
真实案例:某 SaaS 的同步任务依赖的第三方 API 做了版本下线,返回 410 Gone。任务的重试逻辑不分青红皂白重试了 6 小时,打了 2000 多个请求——对方按调用量计费,那个月账单多了 300 美元。410 应该直接熔断 + P1 告警"上游接口下线,需要人工介入"。
九、每周一次的 cron 健康检查:5 分钟巡检清单
再好的自动化也代替不了一双定期看一眼的眼睛。每周一早上(或周日晚上),花 5 分钟走一遍这份清单。一人团队的巡检不需要花哨,贵在固定时间、固定动作:
- 看心跳面板(1 分钟):打开 Healthchecks.io(或你的监控面板),确认所有 check 都是绿色。重点看有没有"灰色"(从没打卡过——新任务忘了放心跳)或"红色 overdue"。
- 查 7 天成功率(1 分钟):跑第六节那个 SQL,看每个任务最近 7 天的
done / failed / skipped分布。failed > 0 的逐个点开看原因;skipped 增多的要警惕——可能是锁竞争或任务变慢导致的重叠跳过。 - 看耗时趋势(1 分钟):
SELECT job_name, AVG(duration_ms) ... GROUP BY job_name对比上周。耗时每周涨 10% 的任务,两个月后就会撞上调度间隔——提前优化,别等它爆。 - 看 rows_affected 断层(1 分钟):数据同步类任务,确认每天的 rows_affected 在正常区间。掉到 0 或者突然翻倍,都值得点开日志看一眼。
- 清一下技术债(1 分钟):有没有新增任务还没进心跳监控?有没有临时加的
--dry-run测试任务忘了删?crontab 里有没有注释掉的"僵尸行"?顺手清理,保持清单干净。
把这 5 步写成检查单贴在显示器旁边(或存成每周循环的待办)。你会发现:90% 的 cron 事故在变成事故之前,都在这份清单里露过马脚——某任务连续三天 skipped、某任务耗时翻倍、某心跳变灰。巡检的意义就是把这些"马脚"在周一早上抓住,而不是在用户投诉时才发现。
十、反模式:5 个一人团队最常犯的错误
1. 无告警的静默失败
任务失败了,日志里躺着一条 error,但没人知道。这是最常见的死法,也是最容易修的:任何没有接入心跳 + 异常推送的 cron 任务,都视为"不存在"。新任务上线的 checklist 第一项永远是:心跳建好了吗?告警通道通吗?先发一条测试告警确认手机能收到,再谈业务逻辑。
2. 重跑导致重复副作用
日报重发两遍、用户收到两条扣款通知——重跑的副作用比失败本身更伤信任。根因永远是"上线时没做幂等"。修复顺序:先给写入加唯一键(30 分钟的事),再补状态机。如果历史已经脏了,写个一次性清理脚本去重,然后把"幂等检查"写进新任务的上线 checklist。
3. 两个实例同时跑
本地开发时手动跑了一遍,服务器上 cron 又跑了一遍;或者扩了两个 worker 容器,两个都装了 cron。症状是"偶尔出现重复数据,复现不了"。解法:第四节的分布式锁是标配;另外永远只让一个地方拥有调度权——要么全走平台 cron,要么全走服务器 crontab,不要混用。本地调试用 --dry-run,别直连生产库真跑。
4. 时区硬编码
"每天凌晨 3 点跑"——哪个 3 点?服务器是 UTC,你写的是北京时间,夏令时一到又差一小时。血泪规则:所有时间存 UTC,所有展示转本地;cron 表达式旁边必须注释时区。GitHub Actions 的 schedule 是 UTC,Vercel Cron 可以选时区,Linux crontab 跟系统时区走——三者混用时,建一张对照表,别靠脑子记。
# 反面例子:谁知道这是什么时区?
0 3 * * * /opt/app/daily_report.py
# 正面例子:注释时区 + 用 UTC 表达 + 任务内部再转本地
# 每天北京时间 03:00 = UTC 前一日 19:00(冬令时;夏令时需调整)
0 19 * * * TZ=UTC /opt/app/daily_report.py --tz Asia/Shanghai
5. 把 cron 当队列用
"每分钟跑一次,扫表里待处理的记录"——这是把 cron 当成了穷人的消息队列。数据量小的时候没问题,量一大就崩:单次扫描越来越慢、锁竞争、错过调度。判断标准:如果任务的触发条件是"有数据待处理"而不是"到点了",那它应该是个队列消费者,而不是 cron。迁移到 BullMQ / Cloudflare Queues 的成本,远低于一次"每分钟任务堆积到几百个实例"的事故。
结语:cron 运维的本质是"为睡觉时的自己负责"
回顾全文,其实只有三句心法:
- 失败一定会发生——所以要有心跳(发现没跑)、告警分级(叫醒你)、结构化日志(快速定位)。
- 重跑一定会发生——所以幂等是上线门槛,锁防止自己打自己,重跑 SOP 防止慌乱中酿成二次事故。
- 疏忽一定会发生——所以每周 5 分钟巡检,把"马脚"掐灭在变成事故之前。
一人团队没有 SRE,没有值班表,on-call 的人 24 小时都是你。这套东西搭起来大概需要一个周末:周六上午接心跳和告警(第五节),下午给现有任务套 wrapper 加锁和幂等(三、四节),周日早上写巡检清单(第九节)。从此以后,凌晨 3 点的任务再挂掉,第一个知道的人是你——而不是你的用户。这就是一人团队 cron 运维的全部意义。
评论 (0)
相关文章
你的 vibe 项目站在借来的柱子上:模型 API、支付、邮件、对象存储。本指南按顺序筑起四层防线——超时、指数退避重试、完整可抄的 TypeScript 熔断器、降级路径,外加预算熔断、/health 健康探针和每月一次的混沌演练 SOP。
报警响了之后怎么办?这篇一人团队事故响应实战指南给出 SEV1/SEV2/SEV3 三档分级清单与“放过清单”、15 分钟 0 元搭好的告警通道选型表、黄金 15 分钟止血 5 动作、一键回滚 SOP,以及可直接复制的事故时间线模板、沟通话术模板、无责复盘模板,外加 5 个一人团队最常见的事故响应反模式。
vibe coding 的迭代速度是 API 契约的十倍快,这正是一个人做项目最容易翻车的地方。本文补上 API 治理缺失的那块拼图:vibe 项目 API 的 3 种真实死法、版本策略 5 维度决策表(URL 路径版 vs 请求头版本 vs 无版本)、12 条破坏性变更判定清单(可直接贴墙上)、废弃 SOP 四步(Deprecation/Sunset 响应头、双语废弃公告模板、双跑观察看板、下线执行检查表)、可直接复制的一页纸迁移指南模板,以及一人版本治理的最小配置:CHANGELOG 驱动 + CI 用 openapi-diff 自动卡住 breaking change。