API 别翻车:vibe 项目的版本管理与废弃 SOP
vibe coding 的迭代速度是 API 契约的十倍快,这正是一个人做项目最容易翻车的地方。本文补上 API 治理缺失的那块拼图:vibe 项目 API 的 3 种真实死法、版本策略 5 维度决策表(URL 路径版 vs 请求头版本 vs 无版本)、12 条破坏性变更判定清单(可直接贴墙上)、废弃 SOP 四步(Deprecation/Sunset 响应头、双语废弃公告模板、双跑观察看板、下线执行检查表)、可直接复制的一页纸迁移指南模板,以及一人版本治理的最小配置:CHANGELOG 驱动 + CI 用 openapi-diff 自动卡住 breaking change。
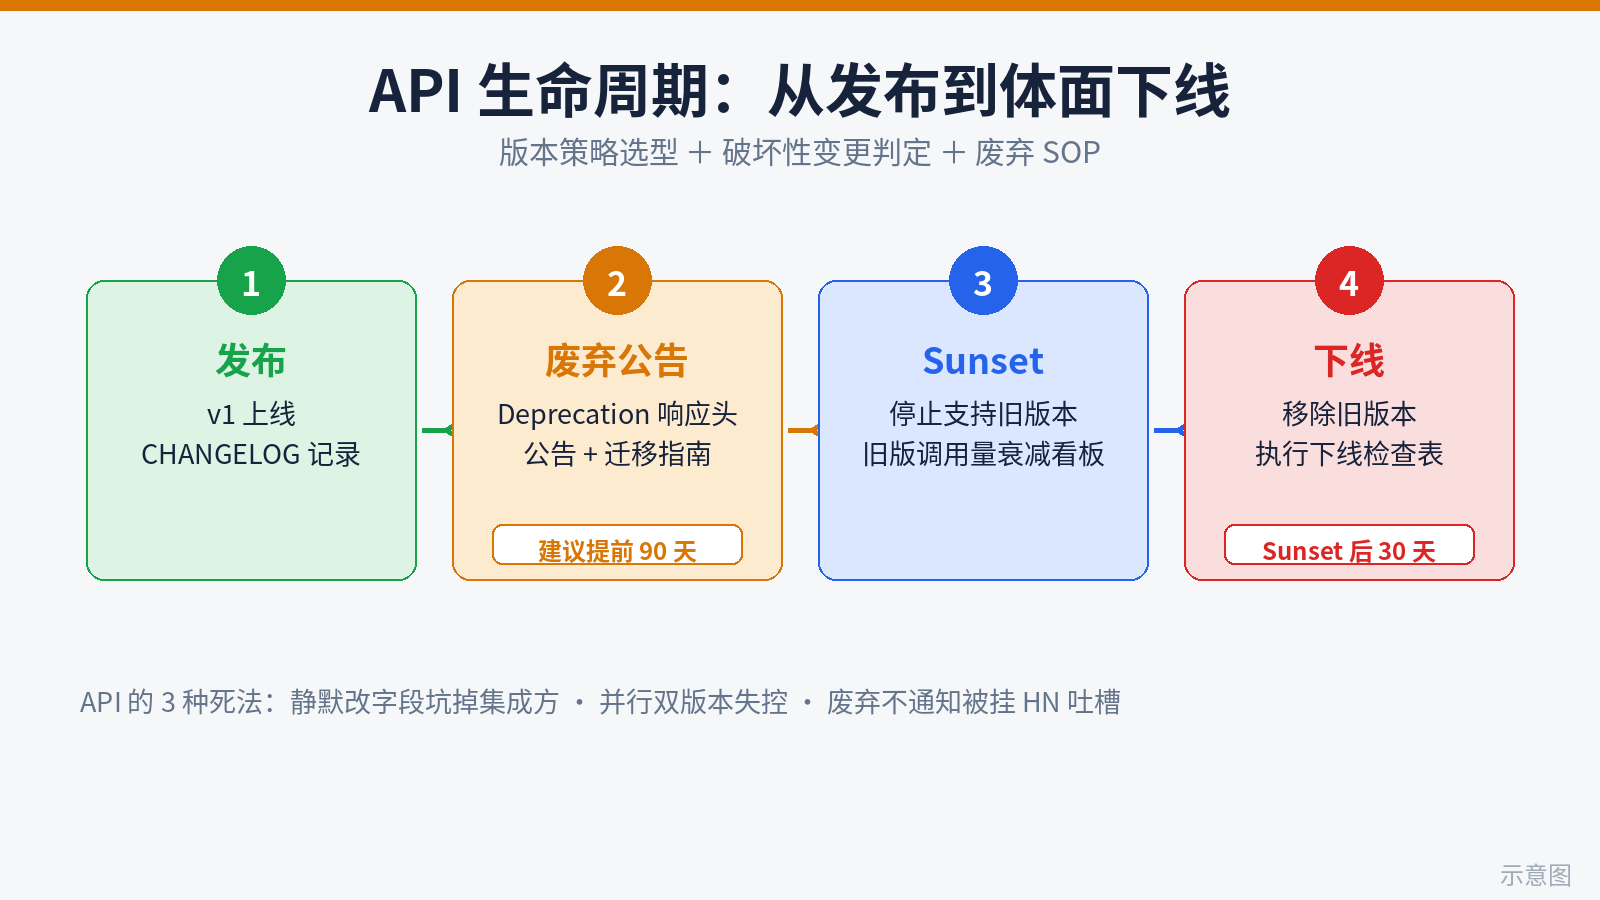
我见过 vibe 项目 API 最常见的死亡过程是这样的:凌晨三点你让 AI 助手"把返回体里的 user_name 改成驼峰命名吧,顺手的事",助手秒改、秒部署、秒跑通——然后第二天早上,一个接入你 API 的小伙伴在群里说:"我这边全挂了,什么都没动。"你才想起来,你改的那个字段,三个月前写进过文档发给过别人。vibe coding 的迭代速度是 API 契约的十倍快,这正是它最容易翻车的地方:prompt 随便改没事,但 API 一旦有人调用,它就变成了承诺。
这篇专门讲版本管理与废弃,跟已有的三篇各管一段,互不重叠:prompt 版本控制那篇管的是 prompt 文本的版本,跟 API 契约无关;灰度发布那篇讲的是部署 rollout 怎么不炸生产,不讲契约生命周期;changelog 那篇讲的是发版沟通,不讲废弃执行。这里补上缺的那块拼图:契约怎么变、旧版本怎么死。
一、vibe 项目 API 的 3 种死法
先说清楚代价,这样后面的 SOP 你才有动力执行。这三种死法我都见过真人真事:
死法一:静默改字段,坑掉集成方
最经典。某独立开发者给自己的记账 SaaS 加了个 AI 分类接口,v1 返回 {"category": "food"}。半年后他让 Cursor "优化一下返回结构",变成了 {"category": {"id": "food", "confidence": 0.97}}。改完他自己前端适配了,一切正常。但他忘了:三个月前有个做效率工具的朋友调用了这个接口做自动记账,对方直接 data.category 拿字符串。第二天对方的用户发现记账全乱了——[object Object] 被写进了几百条账单。修复成本:对方花了两天做数据清洗,友谊的小船差点翻了。
教训就一句话:凡是被别人调用过的字段,就不再是"你的字段",是"公共契约"。vibe 迭代里最危险的就是 AI 助手看不到契约边界——它只看到你的仓库,看不到别人的仓库。
死法二:并行双版本失控
第二个坑是矫枉过正。有人被坑过一次之后,决定"以后所有变更都开新版本",于是有了 /v1、/v2、/v2.1、/v3……每个版本都是复制一份 handler 改两行。一年后他自己都分不清哪个版本修了哪个 bug:v2 的用户报了个安全漏洞,他修在 v3 上,v2 的用户继续裸奔。更惨的是文档:四个版本的文档页面互相抄,示例代码里的版本号和实际对不上,新用户照着文档调,调的是个已经半残的版本。
版本不是越多越安全。版本数量是负债,不是资产。一人维护的项目,活着的版本最好永远不超过 2 个。
死法三:废弃不通知,被挂 HN 吐槽
第三种死法最伤口碑。某小而美的 API 服务(做图片去背景的)某天直接下线了 v1,没有任何通知——创始人觉得"反正 v1 只有几十个人用"。结果其中一个用户是某 Show HN 项目的作者,对方的 demo 在 HN 首页展示当天全挂,直接在评论区开喷:"API 作者一声不吭下线接口,大家避雷。"这条评论的点赞数比原帖还高。这个服务的口碑,基本就定格在那条评论里了。
记住:下线旧版本的公关成本,永远大于维护它的技术成本。一个 30 天的废弃通知 + 一封迁移邮件,能换来的信任,值回你多维护三个月旧版本的人力。
二、版本策略决策表:三种路线怎么选
业界主流就三种做法,我按一人维护的真实体感做了个 5 维度对比表:
| 维度 | URL 路径版本(/v1/users) | 请求头版本(Accept: application/vnd.x.v1+json) | 无版本(永远向后兼容) |
|---|---|---|---|
| 一人维护成本 | 中:路由多一份,但逻辑清晰 | 高:网关/中间件要解析头,调试时肉眼看不见版本 | 低:不用维护多版本 |
| 客户端升级摩擦 | 低:URL 变了,调用方一眼就知道要改 | 高:header 忘带就默默走到默认版本,出 bug 难查 | 无:客户端不用动 |
| 网关/代理复杂度 | 低:Nginx 按路径分流,一行配置 | 中:要按 header 路由,CDN 缓存 key 也要带上版本 | 无 |
| 长期技术债务 | 中:版本多了会膨胀,但可控(配合废弃 SOP) | 中高:版本逻辑藏在中间件里,新人接手先懵三天 | 高:字段只增不减,三年后返回体变成考古现场 |
| 调试友好度 | 高:日志、报错、curl 里版本一目了然 | 低:抓包才看得到 header | 高:没有版本问题可调 |
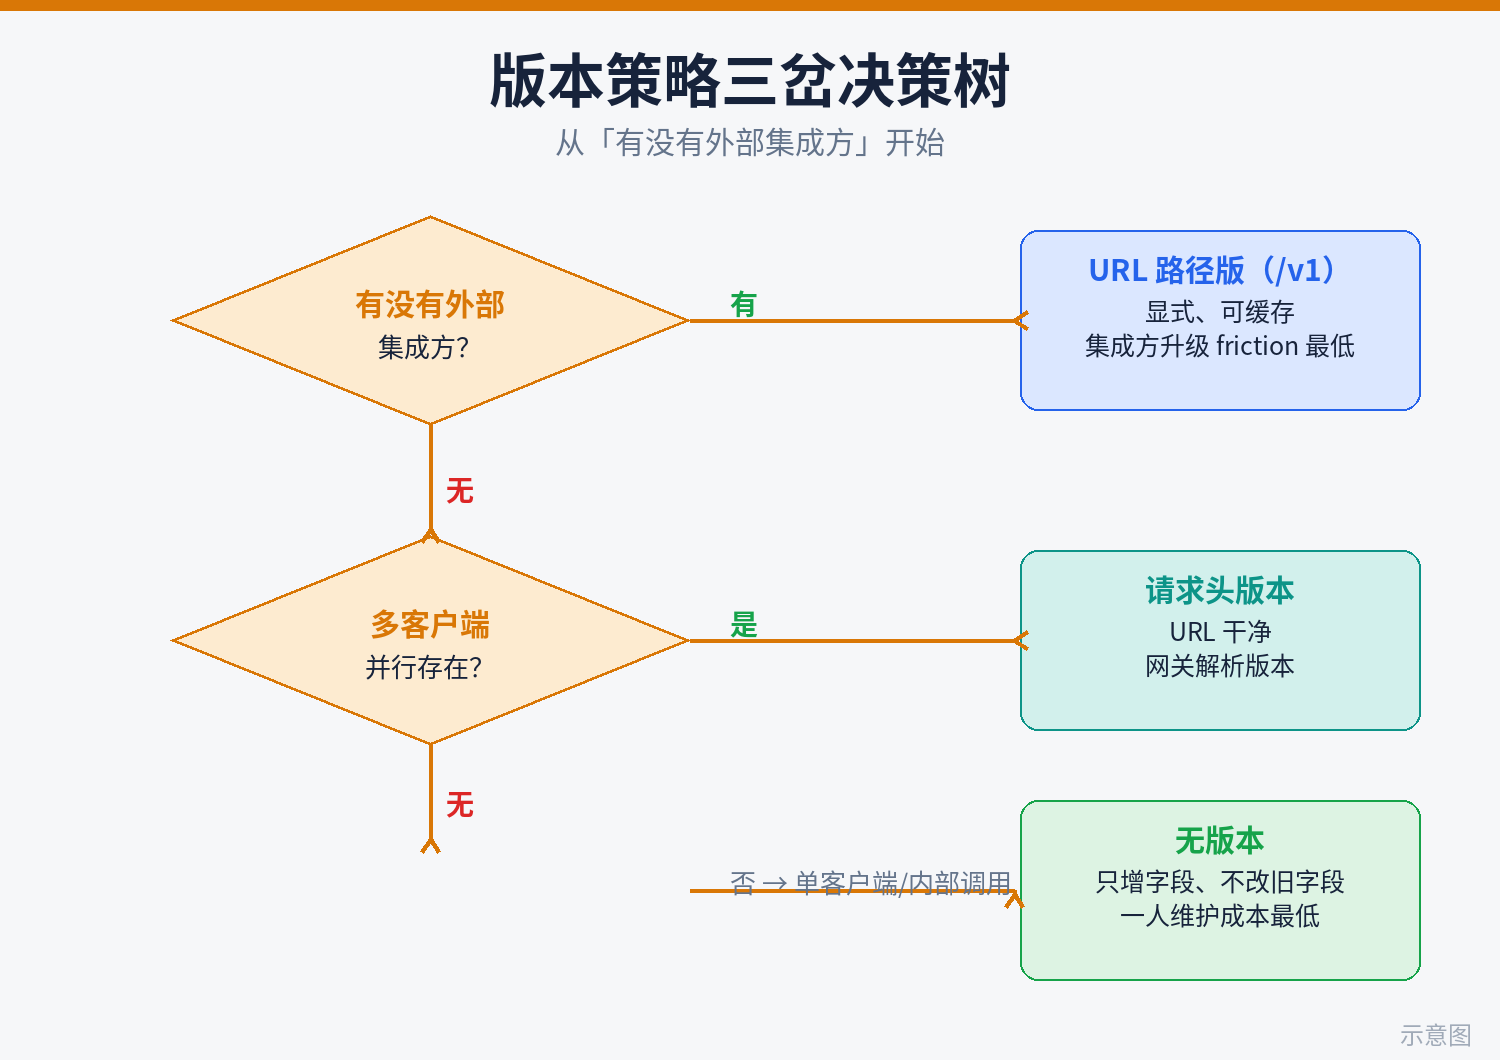
我的默认选型建议,按项目阶段给:
- 0 到 1 的个人项目、公开 API 用户 < 100:选无版本 + 只增不减。这个阶段你的 API 契约还在成型,版本机制是过度设计。守住一条铁律就行:只加字段、不改旧字段(判定清单见第三节)。
- 有外部集成方、开始收钱了:切到 URL 路径版本(/v1)。这是调试成本最低、对集成方最友好的方案,也是 Stripe、GitHub、Twilio 这些 API 公司的主流选择。请求头版本是给有专职 API 团队的大厂准备的,一个人别碰。
- 永远不要:把版本号放在查询参数里(
?version=2)。缓存、日志、网关都会把它当成"同一个 URL 的不同参数"处理,迟早出灵异 bug。
一句话总结:小项目无版本靠自律,中项目 /v1 靠流程,大厂 header 版本靠团队——你是一个人,选前两种。
三、破坏性变更判定清单:12 条对照表,贴墙上
版本策略定完,日常开发里 90% 的纠结都是这一个问题:"我这个改动,算 breaking 吗?"AI 助手更不会替你判断——它只管代码跑通。下面这 12 条是 REST API 的实战判定标准,左边算 breaking(必须发新版本或走废弃流程),右边不算(可以直接上):
| ✅ 算 breaking(动契约) | ❌ 不算 breaking(可直接上) |
|---|---|
改字段名(user_name → userName) | 新增可选字段(老客户端直接忽略) |
| 删除字段(哪怕文档里标了"已废弃") | 新增可选请求参数(带默认值) |
| 改字段类型(字符串改数字、对象改数组) | 新增枚举值(客户端应做未知值兜底) |
| 字段从可选变必填 | 字段从必填变可选(放宽约束) |
分页默认值变更(page_size 默认 20 改 50) | 新增一个独立的端点(endpoint) |
错误码/错误结构变更(code: 1001 含义变了) | 新增错误码(老错误码含义不变) |
几条容易误判的,单独拎出来说:
- "枚举加值"为什么不算 breaking?因为契约规定的是"你可能收到这些值",加一个新值没有破坏任何已有承诺。但前提是你的文档里写过"客户端应对未知枚举值做兜底处理"——没写这句话,加值就是事实上的 breaking。文档里加这一句,成本为零,收益巨大。
- "分页默认值变更"为什么算 breaking?因为调用方的代码里到处都是"没传 page_size 就按 20 条处理"的隐含假设。你改成 50,他的列表页直接错位、他的"加载更多"逻辑直接乱套。默认值是契约的一部分,不是实现细节。
- 最阴险的一种 breaking:错误信息文本变更。有人用正则匹配你的
"message": "user not found"做分支判断,你改成"User Not Found"他就挂了。所以错误码(code)才是契约,message 文本永远别让别人依赖——文档里明确写"message 仅供人类阅读,可能随时变更"。 - 时间格式、时区变更也算 breaking。
2026-10-11T14:00:00+08:00改成 Unix 时间戳,对方解析直接炸。凡是改序列化格式的,一律按 breaking 处理。
给 AI 助手的配套动作:把这张表存成项目里的 API_CONTRACT_RULES.md,每次让 AI 改接口前先让它读一遍。vibe coding 里 AI 是最高频的"契约破坏者",不是因为它坏,是因为它看不见契约——你把规则喂给它,它比人守规矩。
四、废弃 SOP 四步:让旧版本体面地死去
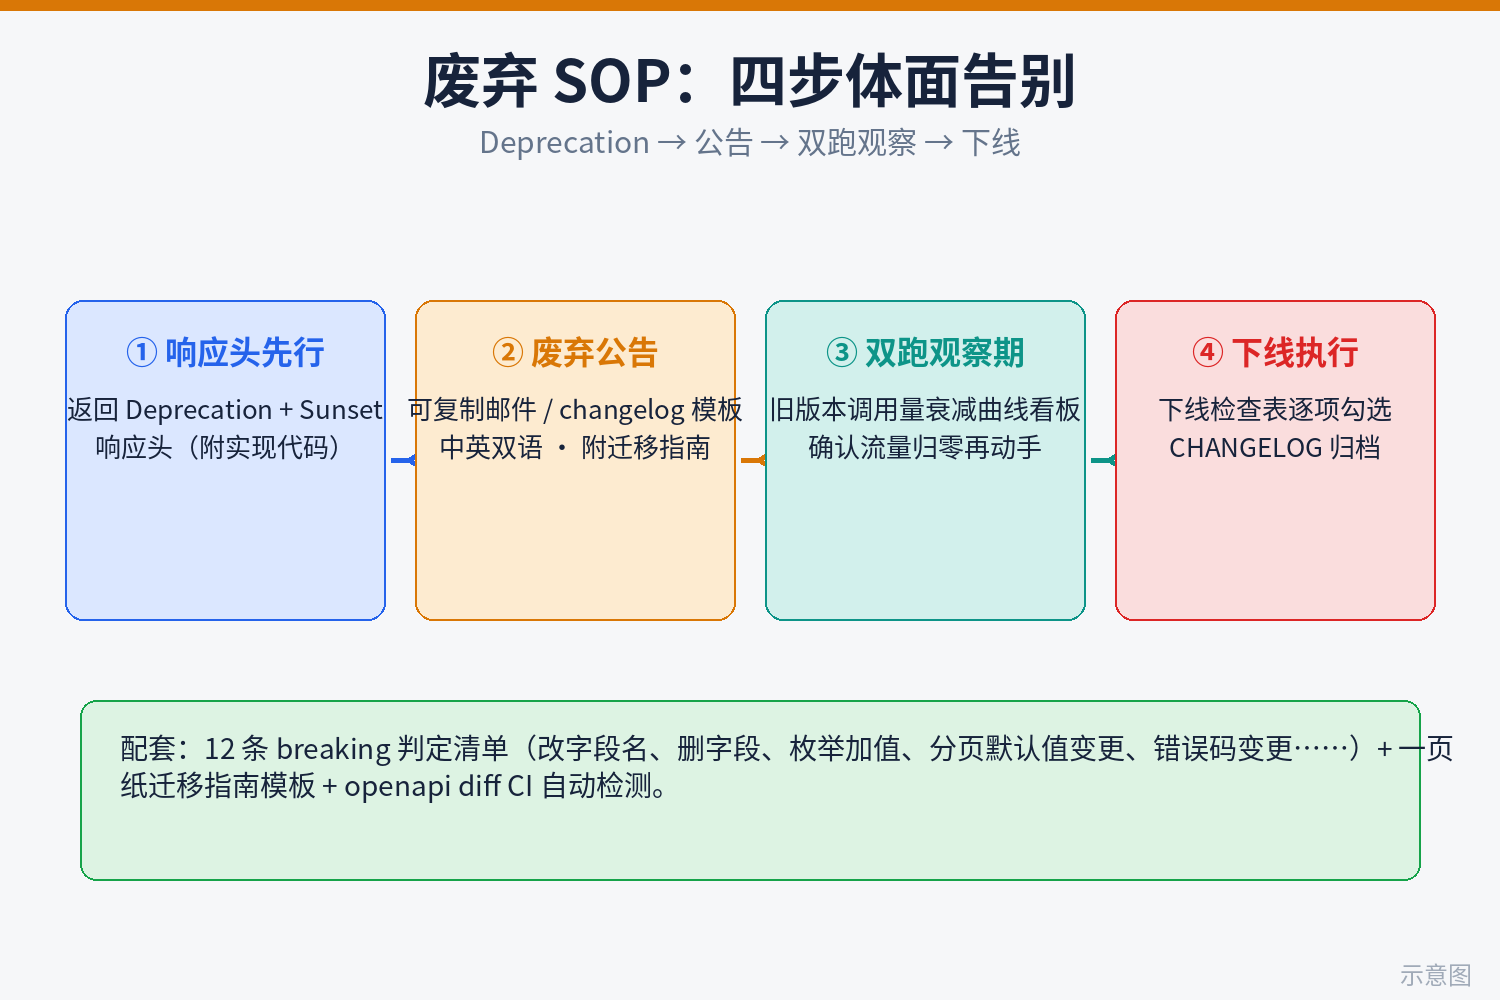
判定为 breaking 的变更,不能直接上,必须走废弃流程。标准 SOP 四步,每一步都有明确的产出物:
第 1 步:打标——Deprecation + Sunset 响应头
废弃的第一动作不是发公告,是让旧版本的每一次响应都自己喊"我快死了"。用标准的 Deprecation 和 Sunset 响应头(RFC 8594 / RFC 9745),这是机器可读的废弃通知,调用方的监控能直接抓到:
// Express 中间件:给 v1 的所有响应打上废弃标记(可直接复制)
const SUNSET_DATE = '2026-12-31T23:59:59Z'; // 下线日期,ISO 8601
function deprecationHeaders(req, res, next) {
res.setHeader('Deprecation', 'true');
res.setHeader('Sunset', SUNSET_DATE);
// 附带迁移文档链接,调用方看到头就知道去哪看
res.setHeader('Link', '<https://vibefix.work/zh/explore/api-v2-migration>; rel="deprecation"');
next();
}
app.use('/v1', deprecationHeaders); // 只挂在旧版本路由上,v2 不受影响

// 进阶:下线前 30 天开始在响应体里追加警告(给没看响应头的调用方最后一次机会)
function sunsetWarning(req, res, next) {
const daysLeft = Math.ceil((new Date(SUNSET_DATE) - Date.now()) / 86400000);
if (daysLeft <= 30 && daysLeft > 0) {
res.setHeader('Warning', `299 - "v1 API sunsets in ${daysLeft} days, migrate to v2"`);
}
next();
}
为什么响应头比公告重要?因为公告靠人看,响应头靠机器看。认真做集成的团队都会监控上游 API 的响应头变化——你的 Sunset 头一出现,对方的告警先响了。这比你发 10 封邮件都管用。
第 2 步:公告——废弃通知模板(中英可直接复制)
响应头是给机器的,公告是给人的。两个渠道都要发:邮件(给已知的集成方)+ changelog(给未来的集成方)。模板如下,括号替换即可:
主题:[重要] {产品名} API v1 将于 {下线日期} 下线,请迁移至 v2

你好,
{产品名} API v1 将于 {下线日期} 正式下线(Sunset)。v1 目前返回的所有响应
已携带 Deprecation 响应头。

你需要做的事(预计 {X} 分钟):
1. 阅读迁移指南:{迁移文档链接}
2. 主要变更:{一句话讲清最大的 1-3 个 breaking 变更}
3. 在 {建议完成日期} 前将调用切换到 /v2

下线后 v1 将返回 410 Gone,不再恢复。如有问题回复本邮件,
或在 {截止日期} 前申请延期(我们会个案评估)。


Subject: [Action Required] {Product} API v1 sunsets on {sunset date} — migrate to v2

Hi,
{Product} API v1 will be sunset on {sunset date}. All v1 responses now
carry a Deprecation header.

What you need to do (about {X} minutes):
1. Read the migration guide: {migration doc link}
2. Key changes: {1-3 breaking changes in one line each}
3. Switch your calls to /v2 before {recommended date}

After sunset, v1 returns 410 Gone permanently. Reply to this email with
questions, or request an extension before {deadline} (evaluated case by case).三个细节决定公告的专业度:一是给"预计耗时",写"预计 15 分钟"比"请尽快迁移"的行动率高得多;二是给"申请延期"的口子,真有大客户卡住,你多个案评估的选项,比"一刀切"少 90% 的撕扯;三是下线后返回 410 Gone 而不是 404——410 的语义是"这个资源曾经存在,现在永久没了",调用方的监控能区分"下线了"和"出故障了",排查方向完全不同。
第 3 步:双跑观察——旧版本调用量衰减看板
公告发出后,v1 和 v2 进入双跑期。你要盯的不是"有没有人骂",而是三个数字:
- v1 调用量衰减曲线:按天画 v1 请求数,正常情况应该是每周衰减 20-30%。如果连续两周零衰减,说明公告没触达到人——去查查邮件打开率,或者直接去对方的技术群里 at 人。
- v1 的独立调用方数量:比总调用量更重要。从 50 个调用方降到 3 个,剩下的 3 个就是你要一对一跟进的"钉子户"。提前两周给这 3 家单独发邮件 + 提供结对迁移(pair migration),比下线当天救火便宜十倍。
- v2 的错误率:迁移过去的人如果在 v2 上大量报错,说明你的迁移指南写得不清楚,或者 v2 有 bug。v2 错误率 spikes 和 v1 衰减停滞同时出现,就是迁移指南要重写的信号。
看板不用 fancy,Grafana / Cloudflare Analytics / 甚至每天跑一条 SQL 把数字贴到 Notion 都行。关键是每天看一眼,连续看 30 天。一个人的版本治理,拼的不是工具,是"有没有每天看一眼"的纪律。
第 4 步:下线执行检查表
到了 Sunset 日期,按这个清单执行,一项一项打勾:
□ 1. 确认 v1 调用量已降到阈值以下(建议:峰值 5% 或绝对值 <100/天)
□ 2. 给剩余调用方发最后一封"48 小时后下线"邮件(附迁移指南链接)
□ 3. 把 v1 路由切换为返回 410 Gone + JSON 说明(带迁移链接,不要直接删路由)
□ 4. 保留 v1 的 410 桩至少 90 天(别急着删代码,调用方排查需要这个信号)
□ 5. 更新公开文档:v1 文档页顶部挂"已下线"横幅,链接指向迁移指南
□ 6. 发一条 changelog:"v1 已于 {日期} 下线,感谢迁移的每一位"
□ 7. 90 天后删除 v1 代码,删的同时在 git 打 tag(v1-final)留档
第 3 条值得展开:下线 ≠ 删代码。正确姿势是把 v1 handler 换成一个 10 行的 410 桩,返回 {"error": "v1_sunset", "migration_guide": "{链接}"}。调用方收到 410 + 迁移链接,5 分钟就知道发生了什么;你直接删路由返回 404 或 500,对方要排查半天才定位到"你下线了"。这 10 行代码,是你能给集成方留下的最后体面。
五、给集成方的"一页纸迁移指南"模板
废弃公告里提到的迁移指南,不要写成长篇大论。集成方要的是一页纸:改哪几个地方、每处怎么改、改完怎么验证。下面模板直接复制,填括号就行:
# {产品名} API v1 → v2 迁移指南(预计 {X} 分钟)

> v1 将于 {下线日期} 下线(返回 410 Gone)。v2 已于 {上线日期} 上线,
> 双跑期 {N} 天。先在测试环境验证,再切生产。

## 变更总览(共 {N} 处 breaking)

| # | v1 | v2 | 影响 |
|---|----|----|------|
| 1 | `GET /v1/users` | `GET /v2/users` | 路径变更,全局替换即可 |
| 2 | 返回 `user_name`(下划线) | 返回 `userName`(驼峰) | 字段读取处需同步改 |
| 3 | 分页默认 `page_size=20` | 分页默认 `page_size=50`,最大 100 | 依赖默认值的列表页需显式传参 |

## 分步操作

1. **全局替换 base URL**:`https://api.example.com/v1` → `https://api.example.com/v2`
2. **字段名批量改**:按下表映射修改读取处(附 sed/IDE 替换正则)
`user_name` → `userName`;`created_at` → `createdAt`
3. **分页显式传参**:所有没传 `page_size` 的调用,显式加上 `page_size=20`
(保持与 v1 一致的行为,避免默认值变更带来的错位)

## 验证清单

- [] 测试环境跑通冒烟用例({列出 3-5 个核心接口})
- [] 对比 v1/v2 同一请求的返回 diff(字段齐了、类型对了)
- [] 检查错误处理:v2 错误码表见 {链接},确认分支判断用的是 code 不是 message
- [] 灰度 10% 流量到 v2,观察 24 小时无异常后全切

## 回滚

v1 在 {下线日期} 前一直可用。如 v2 出现阻塞性问题,
切回 v1 并联系我们:{联系方式}。下线后 v1 不再恢复,
请务必在截止日期前完成迁移。

## 常见问题

**Q: v2 能兼容 v1 的字段名吗?**
A: 不能,v2 统一驼峰命名。建议用上面的批量替换一次改完。

**Q: 迁移期间 v1 会限流或降质吗?**
A: 不会。双跑期内 v1 保持原有 SLA,下线前 7 天我们会再提醒一次。写迁移指南的黄金标准:集成方照着做,不用动脑子。每一处变更都给"改前 → 改后"的对照,每一步都给验证方法。最忌讳的是只列"v2 新特性"不讲"v1 代码怎么改"——人家要的是手术步骤,不是产品发布会。
六、一个人的版本治理:CHANGELOG 驱动 + CI 自动卡 breaking
前面都是"出事了怎么办",这一节讲"怎么让出事变难"。一个人维护 API,治理体系必须轻到"不写就难受"的程度,核心就两件套:
1. CHANGELOG 驱动:改契约先写 changelog
规矩很简单:任何改动 API 契约的 PR,changelog 条目先行。不是发版时补写,是改代码前先写。格式固定三段:
## [Unreleased]
### ⚠️ Breaking
- `GET /v1/users` 返回体 `user_name` 改名为 `userName`(v2 生效,v1 保持不变)
迁移:调用方将读取处批量替换即可,详见 {迁移指南链接}

### Added
- `GET /v2/users` 新增可选字段 `avatar_url`,老客户端可忽略

### Deprecated
- `GET /v1/users` 标记废弃,Sunset 日期 {下线日期},响应头已携带 Deprecation
为什么先写 changelog 有效?因为写 changelog 的时候,你被迫用"调用方的视角"描述改动——"改名为 userName"写出来那一刻,你自己就会意识到"哦这是 breaking"。很多静默 breaking 都是在"我就改一行代码"的心态里溜过去的,changelog 是强制你抬头看一眼契约的机制。跟 changelog 发版沟通那篇的区别是:那篇讲的是发版时怎么跟用户沟通,这里讲的是用 changelog 当开发时的契约刹车片——一个对外,一个对内。
2. CI 自动检测:openapi-diff 卡住 breaking 变更
光靠自觉不够,AI 助手改代码可不会先写 changelog。上 CI 自动卡:每次 PR 里 OpenAPI spec 有变化,就 diff 一下,breaking 变更直接标红,逼你显式确认。最小配置如下(GitHub Actions + oasdiff,单文件、零后端):
#.github/workflows/api-contract.yml
name: API Contract Check
on:
pull_request:
paths:
- 'openapi.yaml' # 只有 spec 变了才跑,不浪费 CI 分钟数

jobs:
diff:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4
with:
fetch-depth: 0 # 需要完整历史来取 base 分支的 spec
- name: Get base spec
run: git show origin/${{ github.base_ref}}:openapi.yaml > /tmp/base.yaml
- name: Install oasdiff
run: go install github.com/oasdiff/oasdiff@latest
- name: Diff specs
id: diff
run: |
oasdiff diff /tmp/base.yaml openapi.yaml \
--format json > /tmp/diff.json
# 只关心 breaking 级别:fail-on 会让 CI 变红
oasdiff diff /tmp/base.yaml openapi.yaml \
--fail-on ERR > /tmp/breaking.txt || echo "BREAKING_FOUND=true" >> $GITHUB_ENV
- name: Comment on PR
if: env.BREAKING_FOUND == 'true'
uses: actions/github-script@v7
with:
script: |
github.rest.issues.createComment({
issue_number: context.issue.number,
owner: context.repo.owner,
repo: context.repo.repo,
body: '⚠️ 检测到 **breaking change**:\n\n```\n' +
require('fs').readFileSync('/tmp/breaking.txt', 'utf8') +
'\n```\n请确认:1) 已更新 CHANGELOG 的 ⚠️ Breaking 区;' +
'2) 如需发新版本,已按本文第四节走废弃 SOP。'
});这套配置的精髓在三处:一是 paths 过滤,spec 没变就不跑,一个月省下几百 CI 分钟;二是 --fail-on ERR 只卡 breaking,加字段这种非 breaking 变更直接放行,不制造噪音;三是 PR 自动评论,把 diff 结果和"去更新 CHANGELOG、去走废弃 SOP"的要求贴到作者脸上——很多时候作者不是不想守规矩,是 PR 合并时根本想不起来。
前提是你得有一份 openapi.yaml。vibe 项目很多人没有——补一份不难,让 AI 助手根据你的路由代码反向生成,半小时搞定。这份 spec 是整个版本治理的地基:diff 的输入是它,文档站点的输入是它,客户端 SDK 生成的输入也是它。没有 spec 的 API 版本管理,都是空中楼阁。
最后把整篇收成一句话:API 版本管理不是技术问题,是承诺管理问题。vibe coding 让你一天能发十个版本,但你的集成方一天只能承受一次"契约变了"。版本策略选 /v1 还是无版本、breaking 判定 12 条、废弃 SOP 四步、CI 自动卡——这四层做完,一个人维护的 API 也能有大厂的体面:旧版本死得明白,新版本生得清楚,集成方半夜不会被你的"顺手一改"炸醒。这才是 vibe 项目从"玩具"变成"基础设施"的分水岭。
相关文章
第二个客户是 vibe 项目的成人礼:单租户代码里藏着全局单用户、硬编码配置、无租户边界三个隐性假设,一碰就塌。本文给出三种隔离模型的六维决策表(共享表/Schema-per-tenant/DB-per-tenant),手把手落地 Postgres RLS(三件套:Next.js 中间件解析租户、CREATE POLICY 行级策略、Prisma 扩展自动过滤),对比子域名/路径前缀/自定义域名三种路由,附 10 项跨租户泄露负向测试清单、5 步不停机迁移 SOP(含每步回滚点),以及按租户计量用量的最小实现。
这是供给侧的 MCP 指南:把你自己的项目做成 MCP server,让 Agent 来调用你。从 3 个动笔信号、Tools/Resources/Prompts 决策表,到 150 行可运行的 TypeScript 完整代码、Tool schema 设计 7 原则、stdio 与 Streamable HTTP 选型、安全红线检查表,再到注册表提交清单与 README 安装模板——一个下午,让你的项目进入 Agent 的工具箱。
vibe coding 让做出产品变容易、让人知道更难,社区和开源是少数以时间换流量的公平赛道。这篇获客战术执行手册覆盖:社区为什么是获客杠杆、Discord/微信群/GitHub Discussions 阵地选择、冷启动 0→20 的 5 个种子用户来源、0→100 的每日 15 分钟运营 SOP、低成本参与感设计、README 即落地页的写作公式、GitHub trending 机制与发布时间窗口、issue 驱动营销、build in public 节奏模板、社区危机处理、5 个健康度指标,以及从社区到收入的转化路径设计。