从单人工具到团队生意:vibe 项目的多租户隔离架构实战
第二个客户是 vibe 项目的成人礼:单租户代码里藏着全局单用户、硬编码配置、无租户边界三个隐性假设,一碰就塌。本文给出三种隔离模型的六维决策表(共享表/Schema-per-tenant/DB-per-tenant),手把手落地 Postgres RLS(三件套:Next.js 中间件解析租户、CREATE POLICY 行级策略、Prisma 扩展自动过滤),对比子域名/路径前缀/自定义域名三种路由,附 10 项跨租户泄露负向测试清单、5 步不停机迁移 SOP(含每步回滚点),以及按租户计量用量的最小实现。
我第一个付费客户签下来的时候,整个人是飘的:一个人、几个周末搭出来的小工具,居然有人愿意按月付 29 美元。第二个客户是朋友介绍的,我花了 10 分钟给他开了个账号——同一套数据库,只是多建了一个 user_id。第三个客户签约那天,我做了一个这辈子最后悔的决定:为了"快",直接把新客户的数据也塞进了同一张表,反正"先跑起来再说"。
爆雷发生在一个周二的凌晨。客户 A 在后台点了"导出全部数据",下载下来的 CSV 里躺着客户 B 的 40 多条订单记录。原因蠢到离谱:导出接口是我最早写的,where 条件里压根没加 user_id。更惨的是,这不是一个 bug,是架构——我的代码里到处都是"当前只有一个客户"的隐性假设,第二个客户一进来,这些假设一个接一个地塌。修导出接口花了 20 分钟,但接下来两周,我 grep 出了 47 处同样裸奔的查询、3 套硬编码的第三方密钥、1 个全局单例的"当前用户"。
多租户隔离不是大公司的专利,它是 vibe 项目从"单人玩具"变成"团队生意"的成人礼。这篇把我重构时踩过的坑一次性讲透:三种隔离模型怎么选、Postgres RLS 怎么落地、单租户老代码怎么迁、计费怎么按租户计量。先划清一句边界:如果你看过本站那篇 RBAC 权限指南——那篇讲的是同一个租户里"谁能做什么",这篇讲的是租户之间"数据如何互相看不见",两者是上下游,不重叠。
一、为什么 vibe 项目死在"第二个客户":单租户代码的 3 个隐性假设
第一个客户永远不会暴露架构问题,因为 n=1 时任何隔离 bug 都是不可见的。第二个客户带来的不是 2 倍复杂度,是 N² 的交叉污染面。下面三个假设,vibe 阶段几乎人人中招:
假设 1:全局单用户——"当前用户"是一个单例
典型写法:一个全局的 getCurrentUser(),所有查询默认"查我的"。单人用时天衣无缝;第二个客户进来后,"我的项目"页面直接变成"所有人的项目"。更隐蔽的变体是把 user_id 当 tenant_id 用:客户公司的员工离职了、账号转交了,数据归属瞬间错乱——人会流动,租户才是稳定的计费与归属主体。
判断句:user_id 回答"谁在操作",tenant_id 回答"账算在谁头上",这是两列,不是一列。重构时第一件事,就是把所有"按用户隔离"的查询改成"按租户隔离",用户只解决登录态,不解决数据归属。
假设 2:硬编码配置——全站共用一份密钥
Stripe Key、OpenAI Key、邮件发件域名、Webhook Secret,全塞在 .env 里一份。单客户时没问题;第二个客户说"我要用自己的 Stripe 收款",你会发现配置层根本没有"按租户覆盖"的概念。更惨的是通知模板:A 客户想叫"工作台",B 客户想叫"控制台",硬编码的文案让你改一行惊动全站。
我的建议是:凡是"将来可能每个客户都不一样"的东西,第一天就放进 tenants 表或 tenant_settings 表。密钥、域名、品牌色、功能开关,全部按租户存。环境变量只放"整个应用都一样"的东西(比如数据库连接串)。这个习惯的成本是建表时多想 5 分钟,收益是第二个客户进来时零重构。
假设 3:无租户边界——查询默认查全表,靠前端过滤
这是爆雷重灾区。列表页、搜索、导出 CSV、后台定时任务、管理员看板——所有"顺手写"的查询默认都是全表。前端只渲染当前用户的数据,看起来一切正常,直到有人调了 API、导出了文件、或者搜索引擎爬到了未鉴权的分享链接。记住一句话:前端过滤是 UI 便利,不是安全边界;真正的边界必须在数据库层。
自查方法:全局搜 findMany( / SELECT * FROM,逐个看 where 里有没有租户条件。我当时的 47 处里,有 31 处是"以为加了其实没加"——比如加了 userId 但没加 tenantId,跨团队协作的场景直接穿透。
二、三种隔离模型决策表:6 维度打分,一人团队闭眼选第一个
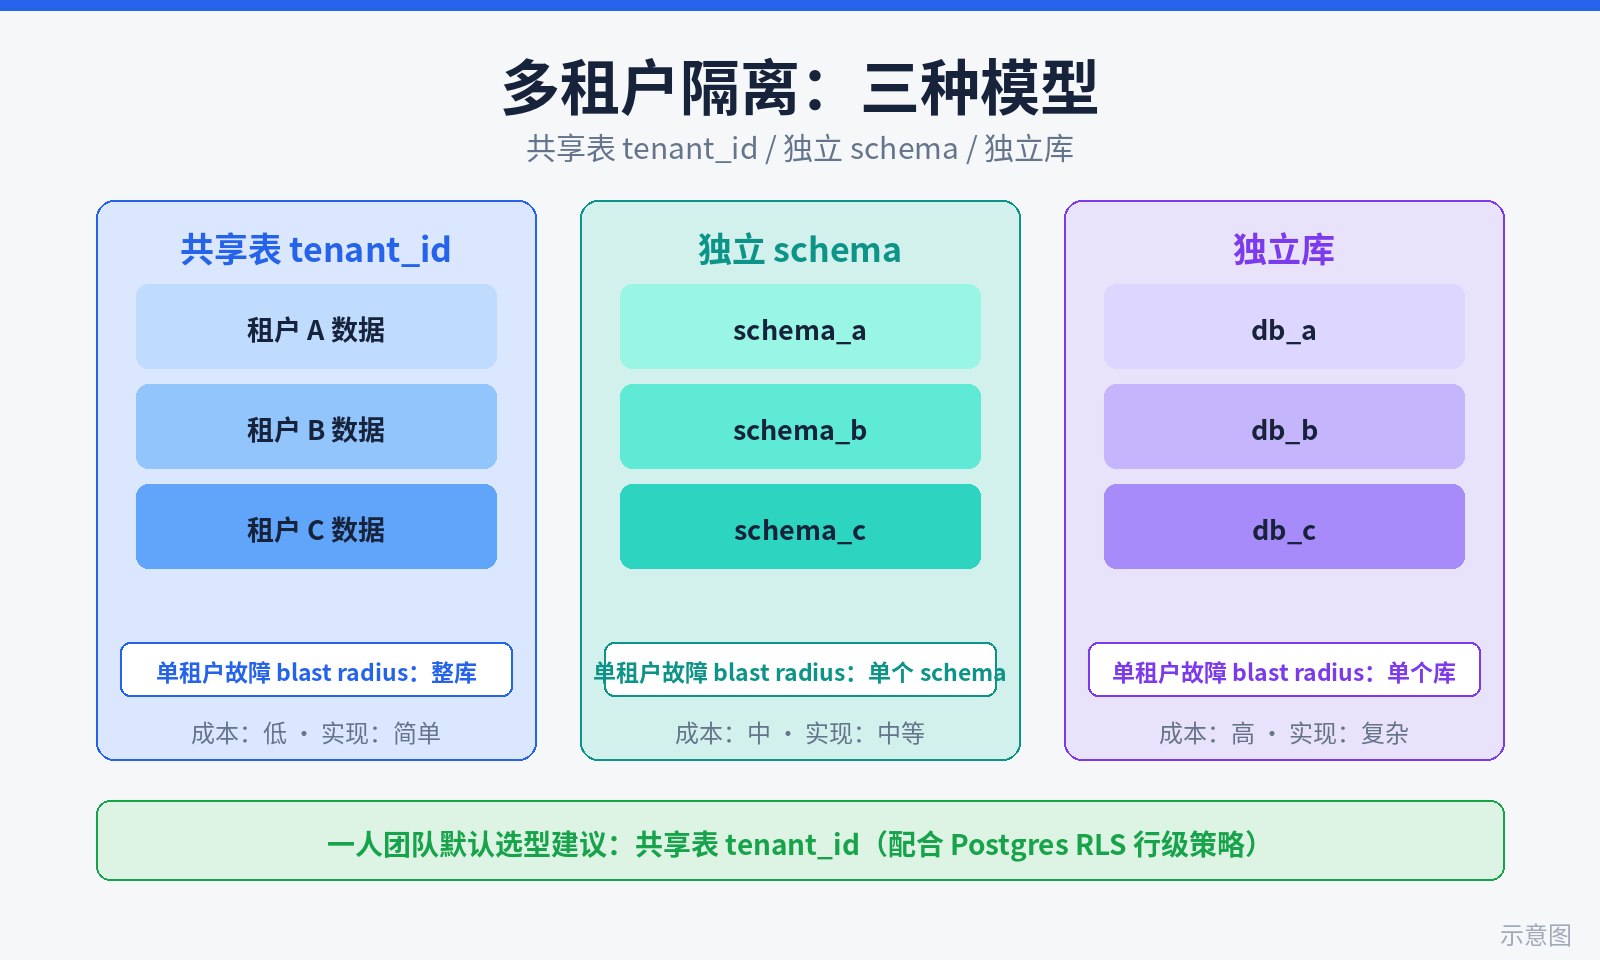
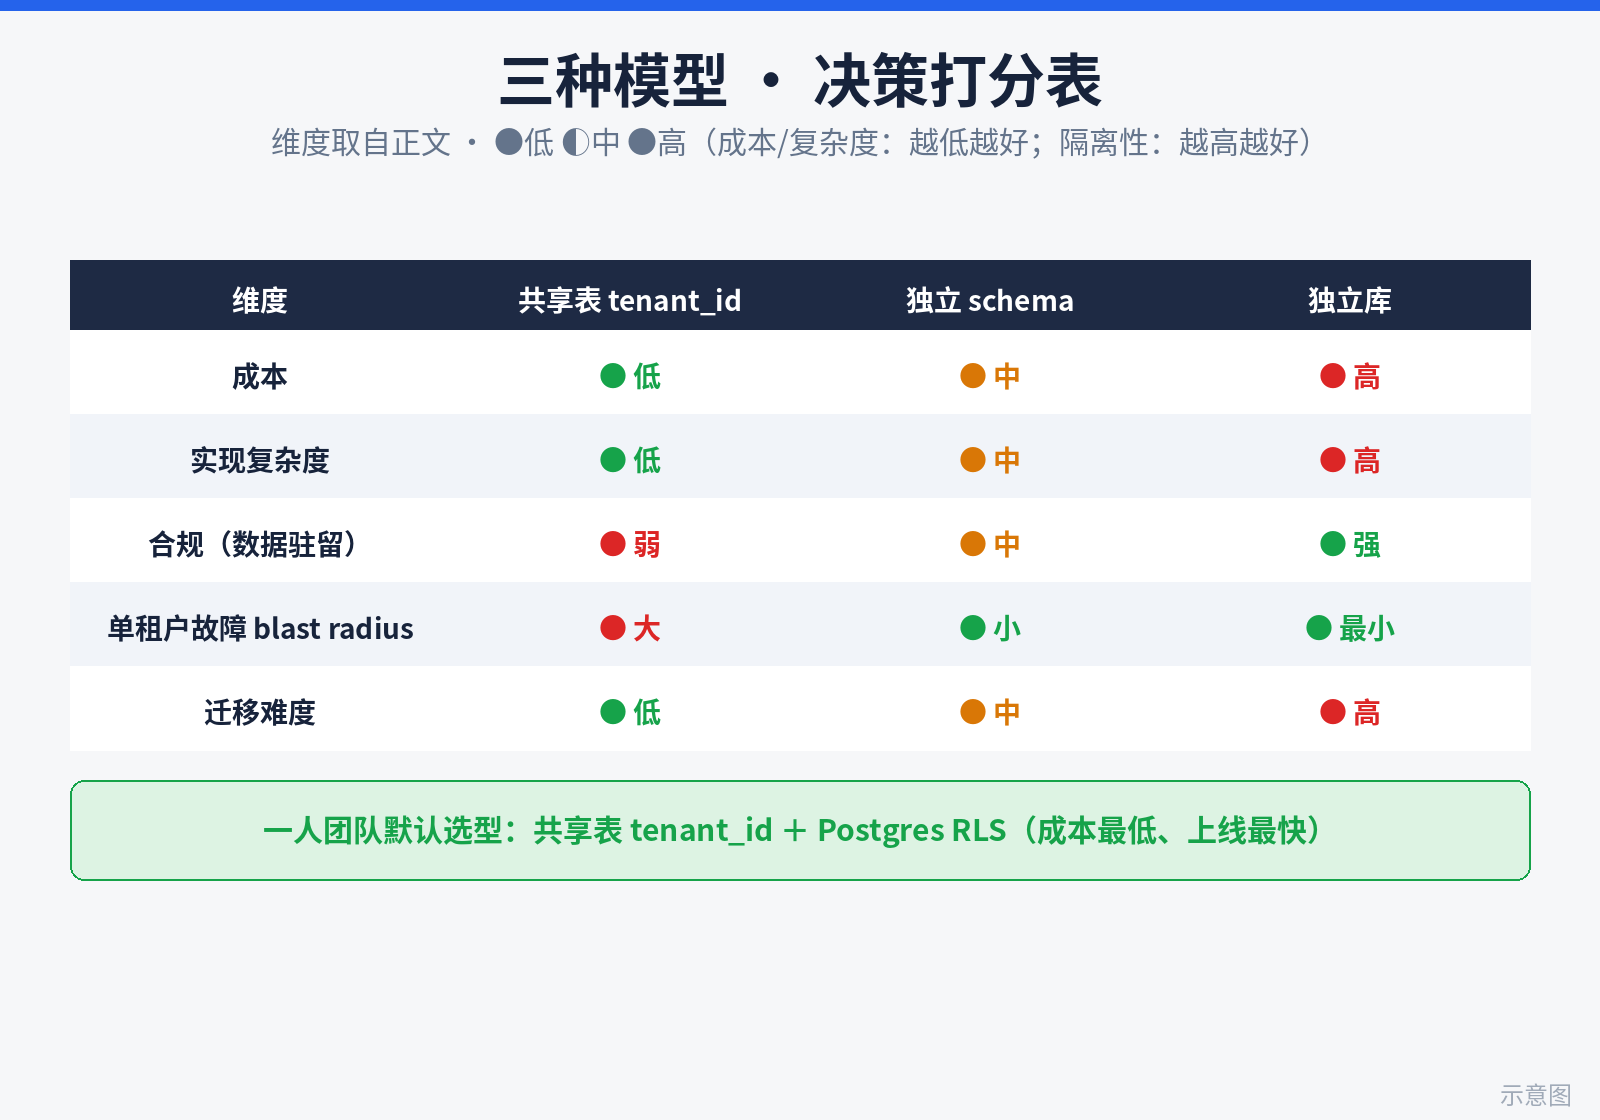
多租户隔离就三种主流做法,没有银弹。我按 6 个维度打了分,★ 在成本类维度代表"代价越高",在能力类维度代表"能力越强":
隔离模型              新增租户成本  实现复杂度  运维负担  合规/数据驻留  故障隔离能力  后期迁移难度
────────────────────  ────────────  ──────────  ────────  ────────────  ────────────  ────────────
共享表(tenant_id 列)      ★           ★★        ★         ★★           ★           ★★★★
Schema-per-tenant        ★★          ★★★       ★★★        ★★★          ★★★          ★★
DB-per-tenant           ★★★★        ★★★★      ★★★★★      ★★★★★        ★★★★★        ★

说明:前三列 ★ 越多=越贵越难;合规/故障隔离 ★ 越多=能力越强;迁移难度 ★ 越多=越难迁走。- 共享表 + tenant_id(行级隔离):所有租户共用一套表,每行带
tenant_id。新增租户成本几乎为零(一行 tenants 记录),代价是每次查询都要带租户条件,写漏一处就是泄露。适合 95% 的 vibe 项目起步。 - Schema-per-tenant:每个租户一个 Postgres schema,表结构相同。天然隔离,备份恢复可以按租户做;代价是 migration 要对 N 个 schema 跑一遍,连接池和 ORM 配置复杂度陡增。适合租户数在几十到几百、且有合规要求的阶段。
- DB-per-tenant:每个租户独立数据库。故障 blast radius 最小(一个租户的慢查询拖不死别人),数据驻留合规最好做;代价是运维地狱——备份、监控、升级全部乘以租户数。适合客单价上万、有专属合规合同的大客户。
一人团队默认选型:共享表 + Postgres RLS,一个都别多想。什么时候升级?出现以下任一信号再动:① 客户合同明确要求物理隔离或数据必须落在特定区域;② 单租户数据量超过约 100GB,或大租户的慢查询已经影响到别人;③ 有大客户愿意为独立数据库付 3-5 倍的价格。三个信号都没出现就别折腾——过早做 DB-per-tenant,是独立开发者最常见的"用运维复杂度给自己加戏"。
反模式预警:我见过有人为了"架构优雅",在只有 3 个客户时上了 DB-per-tenant,结果每周花半天给 3 个库跑 migration,vibe 全耗在运维上。记住:隔离模型的强度应该和客单价成正比,和你的架构审美无关。
三、Postgres RLS 落地:中间件 + 策略 + Prisma 扩展,三件套缺一不可
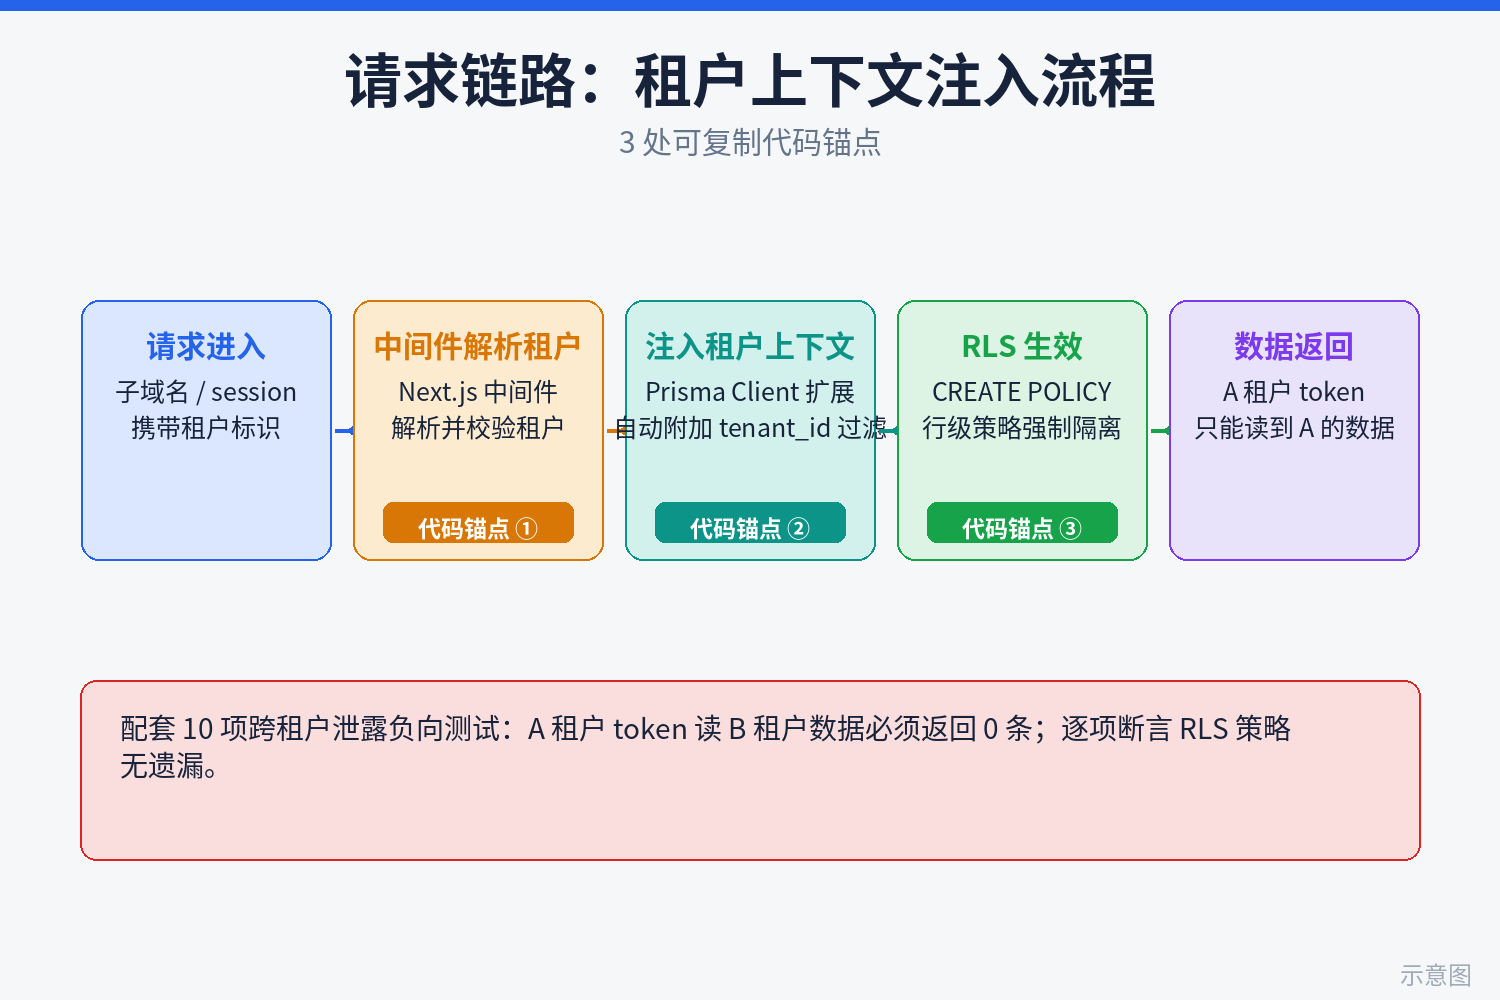
选了共享表模型,隔离就靠三层:中间件解析租户 → 数据库 RLS 强制隔离 → ORM 自动附加过滤。RLS(Row Level Security)是最后一道防线——即使应用层代码写漏了,数据库直接拒绝返回别人的行。下面代码可直接复制,按注释改表名和字段即可。
1. Next.js 中间件:从子域名/session 解析租户并注入上下文
// middleware.ts
import { NextRequest, NextResponse } from 'next/server';
import { getToken } from 'next-auth/jwt';

export async function middleware(req: NextRequest) {
  const res = NextResponse.next();
  // 1) 优先从子域名解析:acme.example.com -> acme
  const host = req.headers.get('host') ?? '';
  const subdomain = host.split('.')[0];
  const reserved = new Set(['www', 'app', 'api', 'localhost']);
  // 2) 兜底从 session/JWT 取(路径前缀路由、本地开发、自定义域名场景)
  const token = await getToken({ req });
  const tenantSlug = !reserved.has(subdomain) && subdomain
    ? subdomain
    : (token?.tenantSlug as string | undefined);
  if (!tenantSlug) return new NextResponse('Unknown tenant', { status: 404 });

  // 3) 查 tenants 表拿租户 id(生产环境务必加缓存,见注释)
  // 注意:Edge Runtime 直连数据库受限,建议把 tenantId 写进 JWT,
  // 这里只做 slug -> id 的缓存查询,避免每次请求打数据库
  const tenant = await lookupTenantBySlug(tenantSlug);
  // 4) 注入请求头:后端只认这个头,不信任前端传参里的 tenantId
  res.headers.set('x-tenant-id', tenant.id);
  return res;
}

export const config = { matcher: ['/api/:path*', '/dashboard/:path*'] };
坑在两处:① 永远不要信任前端传的 tenantId 参数,租户身份只能从子域名、session 或签名过的 JWT 里来,否则就是越权的直通车;② Edge Runtime 下别直连 Postgres,用 JWT 携带 tenantId 或带缓存的 lookup,否则冷启动能把你 P99 干到 2 秒。
2. RLS 策略:数据库层的最后一道墙
-- 1) 业务表加租户列(已有表用可空列 + 回填,见第六节迁移 SOP)
ALTER TABLE projects ADD COLUMN tenant_id uuid NOT NULL REFERENCES tenants(id);
CREATE INDEX idx_projects_tenant ON projects(tenant_id);

-- 2) 开启行级安全:开了之后,没有匹配策略的查询一律返回 0 行
ALTER TABLE projects ENABLE ROW LEVEL SECURITY;

-- 3) 策略:读写都只能碰当前租户的行
CREATE POLICY tenant_isolation ON projects
  FOR ALL
  USING (tenant_id = current_setting('app.tenant_id')::uuid)
  WITH CHECK (tenant_id = current_setting('app.tenant_id')::uuid);

-- 4) 每个请求开始时注入上下文(事务级:SET LOCAL,事务结束自动清除)
-- 在你的 db 中间件 / 请求入口执行:
-- SET LOCAL app.tenant_id = 'xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx';
三个实测要点:① FOR ALL 一把梭最省心,SELECT/INSERT/UPDATE/DELETE 全覆盖,别分开写四个 policy 给自己挖坑;② 索引必须建在 tenant_id 上,否则 RLS 的过滤条件走全表扫描,数据量一大 P99 直接爆炸;③ 用 pgBouncer transaction 模式的注意:SET LOCAL 是事务级的,事务结束自动清除,正好适配连接池复用——但千万别用 SET(会话级),连接被复用给下个租户时上下文还残留着,那就是官方认证的泄露通道。
3. Prisma Client 扩展:让"忘记加 tenantId"在编译期就 impossible
光靠 RLS 不够——RLS 报错是运行时 0 行返回,排查时你根本不知道是"真没数据"还是"策略拦了"。应用层再加一道自动过滤,开发体验好得多:
// lib/prisma.ts
import { PrismaClient } from '@prisma/client';
import { AsyncLocalStorage } from 'node:async_hooks';

// 请求级租户上下文:中间件里从 x-tenant-id 取出塞进来
export const tenantStore = new AsyncLocalStorage<{ tenantId: string }>();

const base = new PrismaClient();

export const prisma = base.$extends({
  name: 'tenant-isolation',
  query: {
    $allModels: {
      async $allOperations({ model, operation, args, query }) {
        const ctx = tenantStore.getStore();
        // 白名单:tenants 表本身、全局配置表等不需要租户过滤
        const skip = new Set(['Tenant', 'GlobalSetting']);
        if (ctx && !skip.has(model!) && args && typeof args === 'object' && 'where' in args) {
          (args as any).where = { ...((args as any).where ?? {}), tenantId: ctx.tenantId };
        }
        return query(args);
      },
    },
  },
});
// 用法:await tenantStore.run({ tenantId }, () => handler(req));记住这个分工:Prisma 扩展管"别写错"(开发期省心),RLS 管"写错了也漏不出去"(生产期保命)。两道都配齐,才算隔离真正落地。另外聚合查询(count/groupBy)和原生 SQL($queryRaw)不会经过这个扩展——凡是手写 SQL 的地方,自己拼 tenant_id 条件,这是 code review 时的必查项。
四、租户路由取舍:子域名 vs 路径前缀 vs 自定义域名
租户路由决定用户怎么访问、也决定中间件怎么写。三选一,没有"最好",只有"最配你当前阶段":
- 子域名(acme.example.com):隔离感最强,用户觉得"这是我的独立后台";中间件解析最自然(host.split 取第一段)。代价是通配符证书和 DNS 配置。适合正式对外、有品牌感要求的 SaaS,我的默认推荐。
- 路径前缀(example.com/acme):零 DNS 成本,本地开发最省事;代价是所有链接、重定向、OAuth 回调都要带前缀,漏一处就 404,且用户感知上"寄人篱下"。适合 MVP 验证期、或租户数极少(<5 个)的内测阶段。
- 自定义域名(app.acme.com):大客户最爱,合同里能写"专属域名";代价是每个域名都要做域名验证 + 证书签发(CNAME 接入 + ACME DNS-01 挑战),还要处理证书续期失败的告警。这是付费增值项,不是默认项。
通配符证书配置清单(子域名方案一次配好,直接照抄):
□ 1. DNS:添加 A/ALIAS 记录 *.example.com 指向你的服务器或 LB
□ 2. 证书:用 DNS-01 挑战签发 *.example.com(HTTP-01 搞不定通配符),
     Let's Encrypt / ZeroSSL 都行,有效期 90 天
□ 3. 自动续期:cron 跑 certbot renew,每周一次;续期失败发告警到你手机,
     别等用户报"证书过期"才发现
□ 4. 本地开发:/etc/hosts 加 127.0.0.1 acme.localhost(现代浏览器支持
     *.localhost 免配 hosts,Chrome/Firefox 均可)
□ 5. 中间件保留字:www/app/api/status/docs 等子域名走公共逻辑,
     别被当成租户 slug 查库查出 404
□ 6. Cookie 域:登录态 Cookie 的 Domain 设为 .example.com,
     否则用户在 acme.example.com 登录后跳到 app.example.com 又要重登
坑在 Cookie 域上——我当初漏了第 6 项,用户每次从子域名跳回主站都要重新登录,被当成 bug 报了三次才定位到。以及自定义域名一定要做域名所有权验证(让客户加一条指定 TXT 记录),否则任何人把 app.evil.com CNAME 到你服务器,就能冒充租户。
五、跨租户数据泄露:10 项负向测试清单(上线前逐条跑)
隔离做没做对,不能靠"我觉得",要靠负向测试——专门证明"不该看到的就是看不到"。下面 10 条直接复制进你的测试文件,条条都是我或同行真实踩过的坑:
□ T1 越权读:用租户 A 的 token,GET /api/projects/<租户B的资源id>,
     期望 404(注意是 404 不是 403——403 会暴露"这个 id 存在")
□ T2 越权写:用租户 A 的 token,PATCH /api/projects/<租户B的资源id>,
     期望 404,且数据库里该行 updated_at 未变化
□ T3 列表穿透:用租户 A 的 token,GET /api/projects(不带任何过滤),
     断言返回条数 == 租户 A 的真实条数,且每条 tenant_id 都等于 A
□ T4 搜索穿透:在搜索框输入租户 B 的独有关键词(如对方公司名),
     期望 0 结果(搜索是最容易漏加租户条件的重灾区)
□ T5 导出穿透:用租户 A 的 token 调"导出全部数据",解压 CSV,
     断言无任何 tenant_id != A 的行(开篇的事故就是这条没测)
□ T6 缓存串味:租户 A 访问 /api/dashboard 后,租户 B 用相同 URL 访问,
     断言拿到的是 B 自己的数据(缓存 key 必须带租户前缀,
     如 dashboard:{tenantId}:summary)
□ T7 后台任务串租户:跑一遍定时任务(如每日汇总邮件),
     断言任务日志里每个租户的上下文切换正确,无"用 A 的配置给 B 发邮件"
□ T8 管理员越界:用租户 A 的管理员 token 访问 /api/admin/tenants,
     期望 403——租户管理员不是平台管理员,跨租户管理走独立的
     平台后台 + 操作审计日志
□ T9 分享链接:把租户 A 的"公开分享链接"发给未登录浏览器打开,
     断言只能看到该分享的单条资源,看不到 A 的其他数据;
     再把租户 B 的资源 id 拼进分享 URL,期望 404
□ T10 删除租户:删除测试租户后,用其旧 token 调任何接口,
     期望 401;且该租户数据在 30 天冷冻期后物理删除(或按合同匿名化),
     期间任何查询不可见
执行建议:T1-T5 进 CI,每次部署自动跑;T6-T10 每月手动跑一遍(缓存和定时任务的行为容易随重构漂移)。记住一句话:负向测试的价值不在"通过",在"第一次失败时拦住了一次泄露事故"。我现在的 CI 里这 10 条跑了大半年,拦下过两次真实的回归。
六、单租户→多租户:5 步迁移 SOP(含每步回滚点)
已经有线上数据和付费客户了,怎么不停机迁?五步走,每步都有明确的回滚点——没有回滚点的迁移计划就是赌博。
第 1 步:加 tenant_id 列,回填默认租户
所有业务表加 tenant_id uuid 可空列,建一个"默认租户"(就是你现有的那个客户),把全量老数据回填上。此时代码完全不动,只是多了个列。回滚点:DROP COLUMN,一分钟恢复。数据量大的表分批回填(每批 1 万行),别一个 UPDATE 锁全表把线上打挂。
第 2 步:代码双写 + 读路径加过滤(Feature Flag 控制)
新写入强制带 tenant_id;读路径通过第三节的 Prisma 扩展自动附加过滤,但用 flag 包起来(if (flags.multitenancy) ...)。先在 staging 全开,生产保持关闭,观察一周。回滚点:关 flag,代码回到老路径,零数据变更。这一步最磨人:逐个过那 47 处裸查询,漏一处就是未来的 T3 失败。
第 3 步:打开 RLS,先审计模式再强制模式
先建 policy 但配成"宽松 + 日志":用一个只记录不拦截的触发器/审计表,对比"RLS 会拦掉的行"和"应用层返回的行"是否一致,跑 3-7 天。差异为 0 后,再把 policy 切到强制模式。回滚点:DROP POLICY,数据库行为瞬间回到从前。坑:记得给 postgres 超级用户和 migration 角色 BYPASSRLS,否则你自己的 migration 会被策略拦住,半夜部署直接卡死。
第 4 步:灰度切流量——先内部租户,再 5% 真实客户
建一个内部测试租户,走完整的新链路(子域名 + RLS + 计费打点)跑两周;然后按 tenants 表的 id % 20 == 0 灰度 5% 客户,盯三个指标:P99 延迟、错误率、T1-T5 负向测试。回滚点:把灰度租户的 flag 关掉,切回老链路;数据层 tenant_id 列还在,不影响。灰度期间每天看一次 RLS 审计日志,确认拦截的全是"真的越权"而不是"误伤"。
第 5 步:tenant_id 设 NOT NULL,清理老代码
全量切完稳定两周后,把列改成 NOT NULL,删掉 feature flag 和老查询路径。但别急着 DROP 旧列/旧表:保留 30 天"墓碑期",每天备份一次;30 天后无异常再物理清理。回滚点:30 天内的任何一天,把备份表恢复、flag 重新打开即可。
整个 SOP 的核心就一句话:每一步都让"新旧两条路同时能走",直到新路被证明没问题,老路才拆。迁移期间多花的存储和代码分支,是你能买到的最便宜的保险。
七、计费映射:按租户计量用量的最小实现
多租户的终点是收钱:每个租户用了多少 API、多少 AI token、多少存储,直接决定账单。最小实现三件套——中间件打点 + Redis 计数 + 定时聚合落库,半天能搭完:
// middleware.ts(节选):每次 API 请求打点,几乎零开销
const day = new Date().toISOString().slice(0, 10); // 2026-10-11
const pipe = redis.pipeline();
pipe.incr(`usage:${tenantId}:${day}:api_calls`);
// AI token 消耗在业务代码里打点:pipe.incrby(`usage:${tenantId}:${day}:ai_tokens`, tokens);
pipe.expire(`usage:${tenantId}:${day}:api_calls`, 86400 * 3); // 保留3天,防聚合任务挂掉丢数
await pipe.exec();
-- 聚合表:每小时的 cron 把 Redis 计数落库
CREATE TABLE usage_daily (
tenant_id uuid NOT NULL REFERENCES tenants(id),
day date NOT NULL,
api_calls bigint NOT NULL DEFAULT 0,
ai_tokens bigint NOT NULL DEFAULT 0,
storage_bytes bigint NOT NULL DEFAULT 0,
PRIMARY KEY (tenant_id, day)
);
-- 套餐限额检查就一句 SQL:
-- SELECT api_calls > plan.monthly_api_limit FROM usage_monthly WHERE tenant_id = $1;四个实测要点:① 打点用 pipeline + incr,单次 Redis RTT,中间件里感知不到延迟;别在请求链路里同步写 Postgres,那是给自己加 P99;② Redis key 保留 3 天,聚合 cron 每小时跑一次,挂了也有时间补——计量数据丢了等于少收钱,宁可重复聚合(幂等 upsert)不可丢失;③ 存储用量别实时算,每天凌晨扫一遍对象存储按租户前缀汇总,写进 storage_bytes;④ 超限策略提前定好:是硬拦截(403 + 升级提示)还是软超限(先记账单月底结算),写进合同,别等客户超了 10 倍用量才吵架。
总结成一句话:多租户隔离的本质,是把代码里所有"默认全站"的假设,一个个改成"默认本租户"。共享表 + RLS 是性价比最高的起点,10 项负向测试是保命的 CI,5 步迁移 SOP 让老项目不停机上车,按租户计量让每一行隔离的代码都对应上账单。从第二个客户开始,你的 vibe 项目才算真正开门做生意。
相关文章
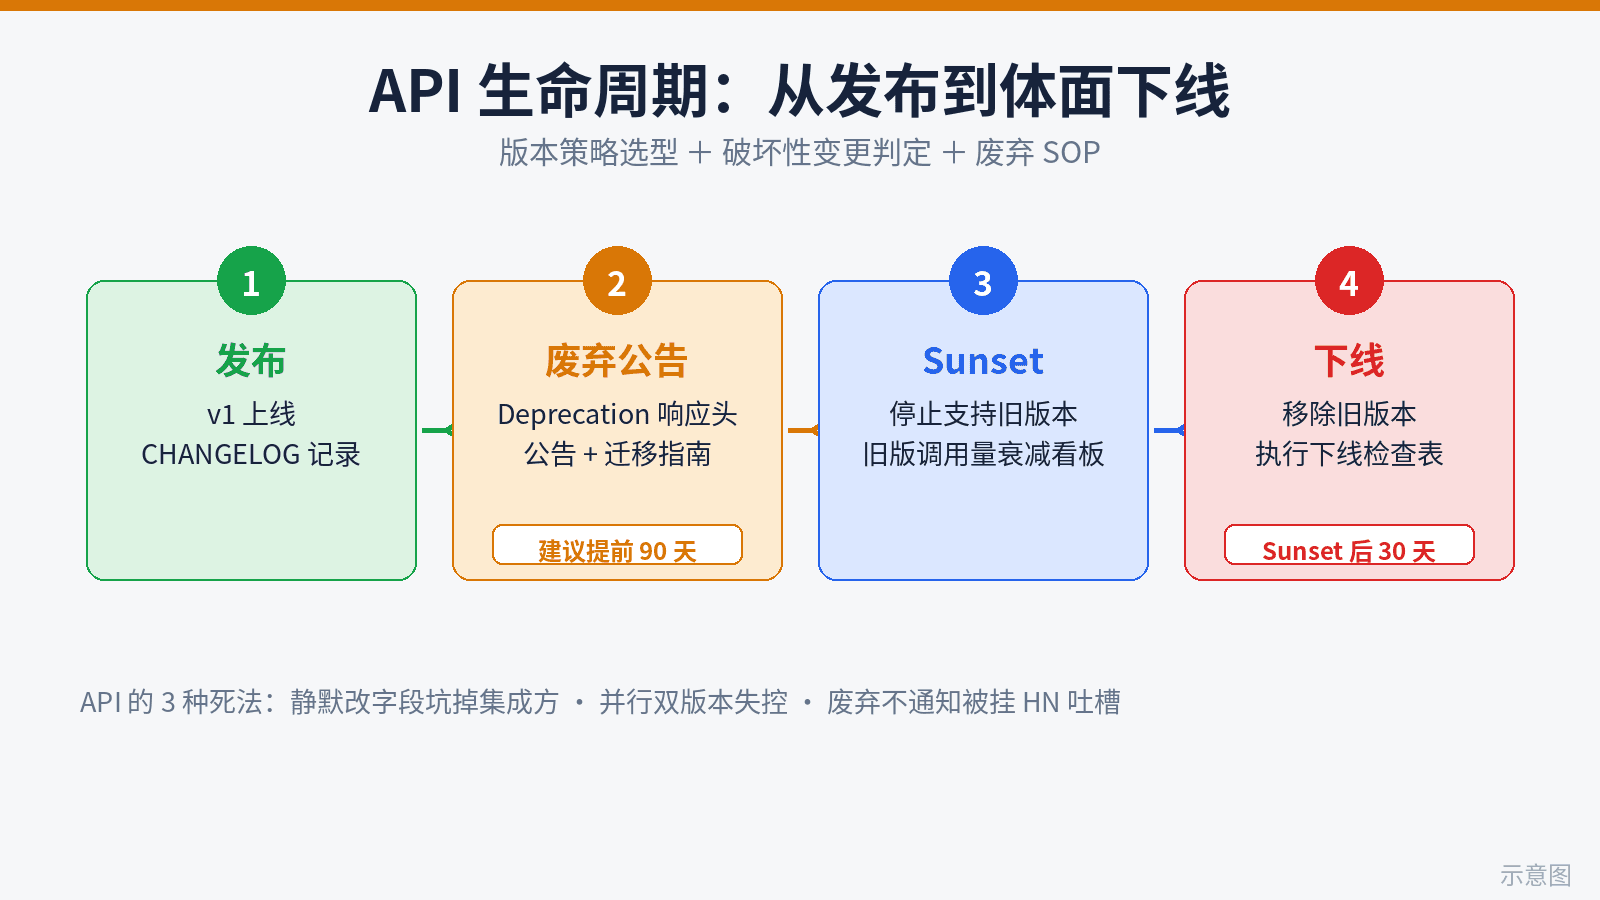
vibe coding 的迭代速度是 API 契约的十倍快,这正是一个人做项目最容易翻车的地方。本文补上 API 治理缺失的那块拼图:vibe 项目 API 的 3 种真实死法、版本策略 5 维度决策表(URL 路径版 vs 请求头版本 vs 无版本)、12 条破坏性变更判定清单(可直接贴墙上)、废弃 SOP 四步(Deprecation/Sunset 响应头、双语废弃公告模板、双跑观察看板、下线执行检查表)、可直接复制的一页纸迁移指南模板,以及一人版本治理的最小配置:CHANGELOG 驱动 + CI 用 openapi-diff 自动卡住 breaking change。
敢收费不敢退费的心态是错的:清晰的退款政策是最便宜的信任广告,处理得当的退款用户有 30% 会回来,而一次处理失当的 Chargeback 可能吃掉一整月利润。本指南覆盖三档退款政策设计与话术模板、Stripe 手动与 API 退款实战、charge.refunded 的 webhook 自动化闭环、挽留还是秒退决策树、争议证据包 6 类材料、Stripe Radar 防欺诈规则,以及 Paddle/Lemon Squeezy 代扣代缴的跨境税务细节。
vibe coding 让做出产品变容易、让人知道更难,社区和开源是少数以时间换流量的公平赛道。这篇获客战术执行手册覆盖:社区为什么是获客杠杆、Discord/微信群/GitHub Discussions 阵地选择、冷启动 0→20 的 5 个种子用户来源、0→100 的每日 15 分钟运营 SOP、低成本参与感设计、README 即落地页的写作公式、GitHub trending 机制与发布时间窗口、issue 驱动营销、build in public 节奏模板、社区危机处理、5 个健康度指标,以及从社区到收入的转化路径设计。