别只当 MCP 的调用方:给你的 vibe 项目写一个 MCP 服务器
这是供给侧的 MCP 指南:把你自己的项目做成 MCP server,让 Agent 来调用你。从 3 个动笔信号、Tools/Resources/Prompts 决策表,到 150 行可运行的 TypeScript 完整代码、Tool schema 设计 7 原则、stdio 与 Streamable HTTP 选型、安全红线检查表,再到注册表提交清单与 README 安装模板——一个下午,让你的项目进入 Agent 的工具箱。
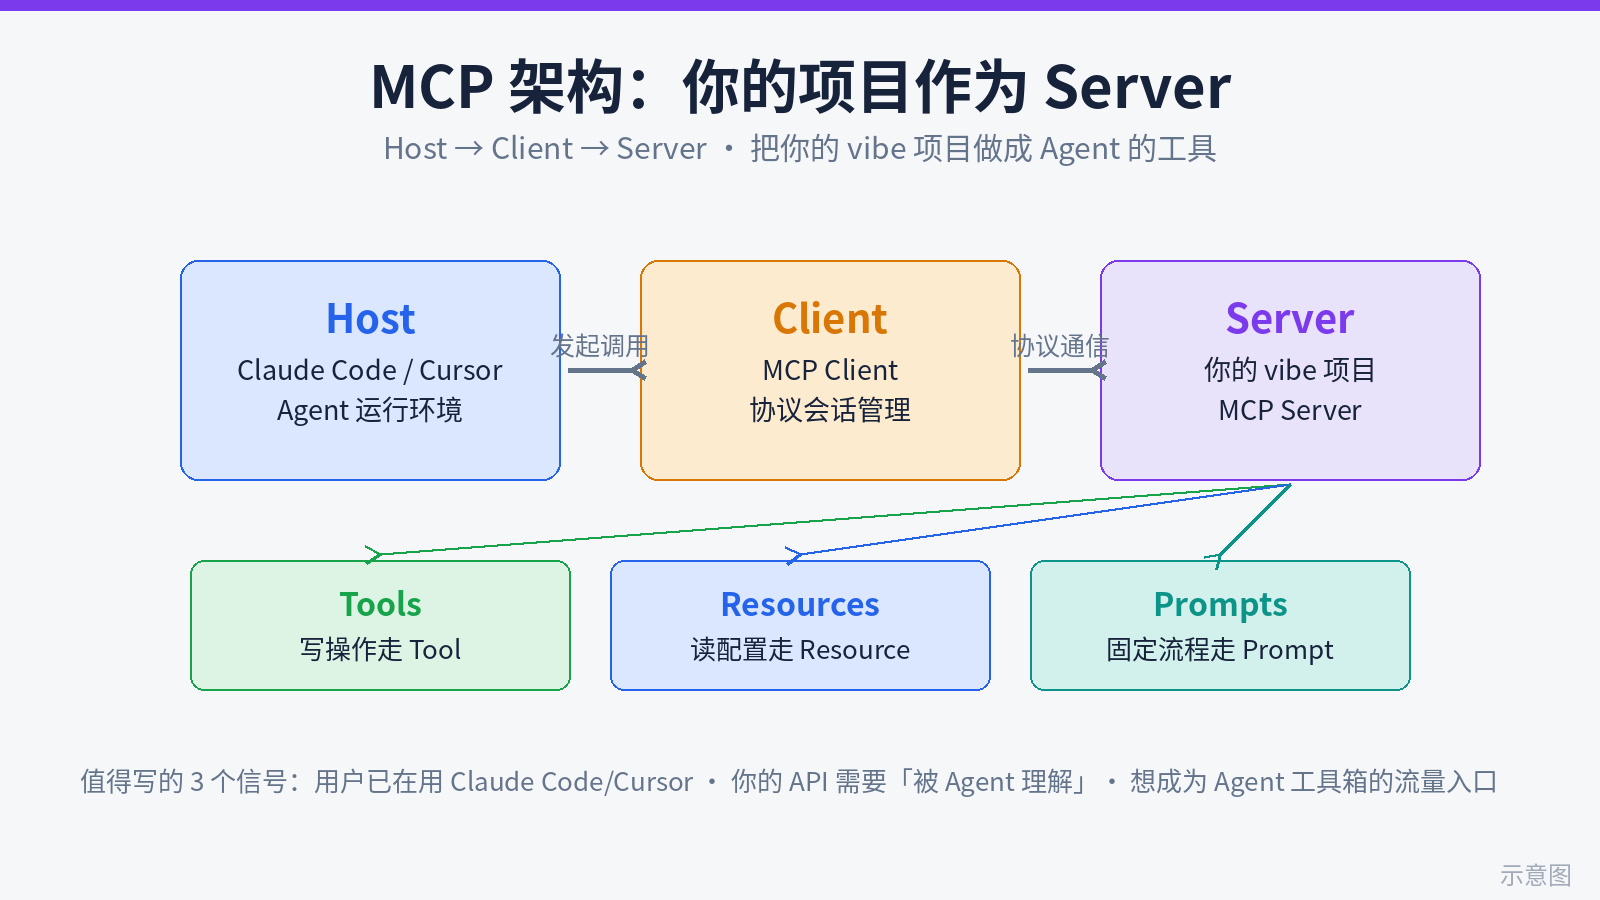
先划清一条线,免得你读串了:之前那篇《mcp-vs-script-agent-tooling-decision》讲的是消费侧——你的 Agent 工作流里,要不要接别人的 MCP server;而这篇讲的是反方向,是供给侧——怎么把你自己的 vibe 项目做成一个 MCP server,让别人的 Agent 来调用你。
为什么这事值得做?我先说一个判断:2026 年的软件分发,正在从"人点开你的网站"变成"Agent 替人调用你的能力"。你的用户已经在 Claude Code、Cursor 里写代码、查资料、跑流程了——如果你的项目只能被人用浏览器打开,它在 Agent 的世界里就是不存在的。给项目写一个 MCP server,本质上是给你的产品开了一扇"Agent 专用入口":不需要改你的后端架构,不需要重写 API,只要把你已有的能力用 MCP 的协议包一层,你的项目就能出现在成千上万个 Agent 的工具箱里。
更现实一点:写一个最小可用的 MCP server,熟练的话一个下午就能跑起来,代码不到 150 行。这篇就是把"值不值得、暴露什么、怎么写、怎么发布"一次性讲透,代码全部可复制运行。读完你会发现,供给侧的 MCP 并没有想象中复杂——复杂的是把"人用的功能"翻译成"模型用得顺手的工具"的产品思考,而这正是 vibe 开发者最擅长的部分。
一、什么时候值得为你的项目写 MCP server:3 个信号
别为了追热点写。MCP server 是有维护成本的(协议升级、客户端兼容、安全),下面三个信号里命中一个,就值得动手;一个都没中,先把项目本身做好。
信号 1:你的用户已经在用 Claude Code / Cursor 干活
最直接的信号来自你的 issue 区和用户群:有人问"能不能让 AI 直接帮我查/改你们的数据""有没有办法在 Cursor 里直接调你们的接口"。当你的重度用户已经把一半工作搬进 Agent 里,他们缺的不是又一个 API 文档,而是一个"Agent 拿起来就能用"的入口。API 文档是写给人看的,MCP schema 是写给模型看的——模型读不懂你的 40 页 REST 文档,但它能读懂一个带 describe 的 zod schema。
我的经验法则是:如果你的用户每周有超过 3 次"我想让 AI 帮我操作你们产品"的场景,MCP server 的 ROI 就是正的。比如笔记应用(让 Agent 帮我归档)、待办工具(让 Agent 帮我排期)、数据看板(让 Agent 帮我拉数做周报)——这些都是天然的高频场景。
信号 2:你的 API 需要"被 Agent 理解"
REST API 有个隐性门槛:调用之前,Agent 得先读文档、理解认证方式、拼对参数、处理分页,一次调用烧掉几千 token,还容易调错。MCP 把这个过程反过来了:你在 server 端把"怎么调、参数什么意思、出错了怎么办"一次性讲清楚(写在 tool 的 description 和参数 describe 里),Agent 每次调用几乎零理解成本。
判断标准很简单:数一下你的核心 API 有多少个"潜规则"——比如"创建订单前必须先调 /quote 拿价格""删除要用 POST 而不是 DELETE""时间字段必须是 UTC 时间戳"。潜规则越多,MCP 的价值越大,因为这些规则可以被编码进 tool 的逻辑里,而不是散落在文档的角落里等 Agent 去踩坑。
信号 3:你想进入 Agent 的工具箱,成为流量入口
这是最功利、也最实在的一个信号。MCP 注册表、awesome-mcp-servers 列表、各家客户端的 server 市场,正在变成新的应用商店。你的 server 一旦被收录,每一个装了它的 Agent 用户,都是你的潜在用户——而且是带着明确任务来的高意向用户,转化率比 SEO 流量高得多。
反过来说也有两个反信号,出现了就别写:第一,你的项目只有纯 CRUD、没有任何"工作流"可言(比如就是个静态展示页),Agent 调你和调数据库没区别,不值得包一层;第二,你的用户根本不在 Agent 里干活(比如你的用户是完全不懂技术的消费者),那 MCP server 写出来也没人装。MCP 是开发者工具的分发通道,先确认你的用户在那条河里。
二、MCP 三件套拆解:Tools vs Resources vs Prompts
MCP 协议给 server 提供了三种暴露能力的方式,新手最常见的错误是"全用 tool",把读配置也做成 tool。记住这句决策口诀:写操作走 Tool,读配置走 Resource,固定流程走 Prompt。下面是展开的决策表,以一个虚构的待办 SaaS "TaskBoard" 为例:
- Tools(工具)——给 Agent 的"手":会产生副作用、需要参数、要执行逻辑的操作。适合暴露:创建/更新/删除数据、触发工作流、调用外部 API。TaskBoard 的例子:
create_task(新建任务)、list_tasks(查任务,带过滤参数)、complete_task(标记完成)。Tool 是唯一会被计入"工具调用"的类型,也是模型最擅长用的。 - Resources(资源)——给 Agent 的"眼睛":只读的数据,Agent 按需拉取,不占工具调用额度。适合暴露:配置信息、静态文档、当前状态快照。TaskBoard 的例子:
config://taskboard/settings(工作区配置:时区、默认列表)、docs://taskboard/shortcuts(快捷语法说明)。注意:resource 是被动供给的——客户端决定什么时候读,server 只管摆在那里。 - Prompts(提示词)——给 Agent 的"剧本":把固定流程预制成模板,用户一句话就能触发一串标准动作。适合暴露:周报生成、代码评审、上线检查清单这类"每次步骤都一样"的流程。TaskBoard 的例子:
weekly-review(拉出本周任务 → 分类 → 生成回顾文本)。Prompt 的本质是把你的最佳实践编码成可复用的指令。
一个反模式我要重点点名:把"读数据"做成 tool。比如 get_config tool,每次调用烧一次工具额度,返回的还是静态配置。正确做法是 resource,客户端可以缓存、可以按需读,token 开销小一个量级。另一个反模式是 tool 粒度太碎:set_task_title、set_task_due、set_task_priority 三个 tool,不如一个 update_task 带可选参数——tool 太多会挤爆模型的上下文窗口,业界经验是单个 server 的 tool 数量最好控制在 15 个以内。
三、最小可用 MCP server 完整代码:从 0 到 npx 可运行
下面是一个完整可运行的例子,还是用 TaskBoard:2 个 tool(create_task、list_tasks)+ 1 个 resource(配置)。TypeScript + 官方 @modelcontextprotocol/sdk,API 形态以官方仓库当前版为准。
先初始化项目,三个命令:
mkdir taskboard-mcp && cd taskboard-mcp
npm init -y
npm install @modelcontextprotocol/sdk zod
npm install -D typescript @types/node
npx tsc --init  # 然后把 tsconfig 里的 "module" 改成 "NodeNext","target" 改成 "ES2022"
package.json 里加两行关键配置(没有这两行,npx 跑不起来):
{
  "name": "taskboard-mcp",
  "version": "1.0.0",
  "type": "module",
  "bin": { "taskboard-mcp": "./dist/index.js" },
  "scripts": {
    "build": "tsc",
    "start": "node dist/index.js"
  }
}
核心代码 src/index.ts,逐行注释版:
#!/usr/bin/env node
// shebang:让编译后的 dist/index.js 可以被 npx / 客户端直接当可执行文件拉起
import { McpServer } from "@modelcontextprotocol/sdk/server/mcp.js";
import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
import { z } from "zod";

// ---- 1. 建 server 实例 ----
// name 会显示在客户端的工具列表里,起名让人一眼看懂这是什么服务
const server = new McpServer({ name: "taskboard", version: "1.0.0" });

// ---- 2. 注册 tool:create_task(写操作走 tool) ----
// registerTool(名字, {标题/描述/参数schema}, 处理函数)
// description 是写给模型看的"使用说明书",后面第四节专门讲怎么写
server.registerTool(
  "create_task",
  {
    title: "Create Task",
    description: "在 TaskBoard 里新建一条任务。当用户说'记一下''加个待办'时用这个。",
    inputSchema: {
      title: z.string().describe("任务标题,一句话说清要做什么"),
      due: z.string().optional().describe("截止日期,YYYY-MM-DD 格式;不填表示无期限"),
    },
  },
  async ({ title, due }) => {
    // 这里换成你真实的数据层:调你的 API、写你的数据库都行
    const task = await fakeDb.insert({ title, due });
    // 返回格式固定:content 数组里放 text 内容
    return {
      content: [{ type: "text", text: `任务已创建:${task.title}(id=${task.id})` }],
    };
  }
);

// ---- 3. 注册 tool:list_tasks(带过滤的读操作,参数多 → 用 tool 不用 resource) ----
server.registerTool(
  "list_tasks",
  {
    title: "List Tasks",
    description: "列出任务,支持按状态过滤。当用户问'我还有哪些没做完'时用这个。",
    inputSchema: {
      status: z.enum(["open", "done", "all"]).default("open")
        .describe("要列出的任务状态:open=未完成,done=已完成,all=全部"),
      limit: z.number().min(1).max(50).default(10)
        .describe("最多返回几条,默认 10"),
    },
  },
  async ({ status, limit }) => {
    const tasks = await fakeDb.list({ status, limit });
    // 只返回模型决策需要的字段,别把整行数据 dump 出来(省 token,见第四节原则 7)
    const slim = tasks.map((t) => ({ id: t.id, title: t.title, due: t.due }));
    return { content: [{ type: "text", text: JSON.stringify(slim, null, 2) }] };
  }
);

// ---- 4. 注册 resource:只读配置走 resource,客户端按需拉取 ----
server.registerResource(
  "config",
  "config://taskboard/settings",
  { description: "当前工作区的配置:时区、默认任务列表、快捷语法定义" },
  async (uri) => ({
    contents: [
      {
        uri: uri.href,
        mimeType: "application/json",
        text: JSON.stringify({ timezone: "Asia/Shanghai", defaultList: "inbox" }),
      },
    ],
  })
);

// ---- 5. 接上 stdio 传输层并启动 ----
// stdio = 客户端用子进程启动你的 server,通过标准输入输出通信,本地运行零配置
const transport = new StdioServerTransport();
await server.connect(transport);

// ---- 演示用的假数据层,换成你自己的 ----
// const fakeDb = { insert: async (t) => ({ id: Date.now(), ...t }), list: async () => [] };
编译运行,两条命令验证:
npm run build && npm start # 能启动且不报错,stdio server 就算跑起来了想可视化调试,用官方 MCP Inspector,一行命令:
npx @modelcontextprotocol/inspector node dist/index.jsInspector 会开一个本地网页,左边是你的 tools/resources 列表,点一下就能填参数调用、看返回——发布之前,先用 Inspector 把每个 tool 手动调一遍,这比写单测更能发现 schema 写得烂的地方(比如模型根本看不懂你的参数描述)。
四、Tool schema 设计 7 原则
Tool 的 schema 是你的 server 和模型之间的唯一合同,写得好坏直接决定 Agent 调用成功率。7 条原则,每条都对应一个真实坑:
原则 1:命名动词化
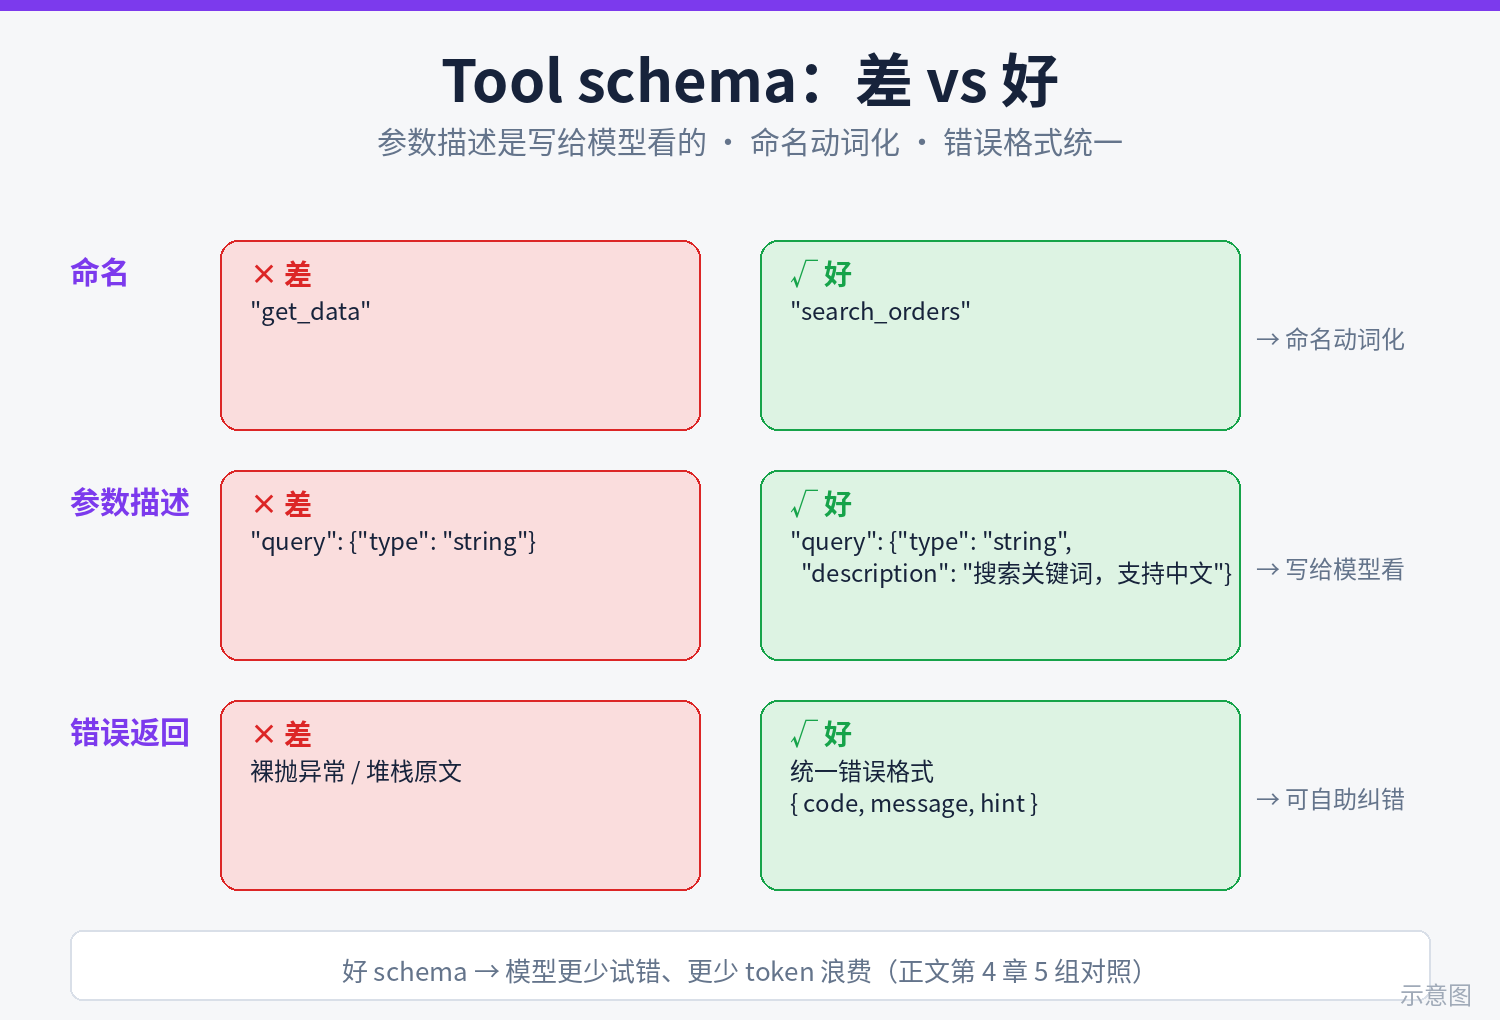
用 create_task、list_tasks、complete_task,不要用 task_create、newTask、taskMgr。动词开头让模型一眼判断"这个工具能干什么",也方便按功能分组时排序整齐。命名用 snake_case,这是 MCP 生态的主流约定。
原则 2:description 第一句写"何时用"
模型决定调哪个 tool,只看 description。模板句式:"当用户说/想……时用这个"。差例子:"创建一个任务。"好例子:"在 TaskBoard 里新建一条任务。当用户说'记一下''帮我加个待办'时用这个;不要用它来查询已有任务,查询用 list_tasks。"——最后一句顺手写了"什么时候别用我",能大幅减少模型调错工具。
原则 3:参数描述写给模型看,不是写给人看
这是最容易翻车的地方。参数的 describe 是模型理解参数的唯一依据,5 组差 vs 好对照:
- 差:
"任务名称"→ 好:"任务标题,一句话说清要做什么,例如'周五前给投资人发周报'"(给了格式 + 例子) - 差:
"截止日期"→ 好:"截止日期,格式 YYYY-MM-DD;用户说'下周三'时你负责换算成具体日期"(把换算责任明确给模型) - 差:
"任务 id"→ 好:"任务 id(数字),从 list_tasks 的返回里取,不要自己编造"(堵住模型幻觉编 id 的路) - 差:
"过滤条件"→ 好:"按状态过滤:open=未完成,done=已完成,all=全部"(枚举值一个个解释) - 差:万能的
options: z.string()("其他参数,JSON 字符串")→ 好:有几个维度就拆成几个具名参数,永远不要让模型手拼 JSON 字符串,那是调用失败的重灾区。
原则 4:参数数量 ≤6,必填最少化
一个 tool 超过 6 个参数,模型的填参错误率会明显上升。能 optional 就 optional,能 default 就 default,能从上下文推导就别让模型传(比如 user_id 应该从鉴权 token 里拿,而不是让模型填)。必填参数只留"没有它这事就办不成"的 1-2 个。
原则 5:错误返回统一格式
Tool 报错不要直接 throw(客户端只会显示一串堆栈),要返回结构化的错误体,并带上 isError: true:
// 统一错误格式:code 给程序判断,message 给人看,hint 告诉模型下一步怎么办
async ({ taskId }) => {
  const task = await fakeDb.find(taskId);
  if (!task) {
    return {
      content: [{
        type: "text",
        text: JSON.stringify({
          ok: false,
          code: "TASK_NOT_FOUND",
          message: `id=${taskId} 的任务不存在`,
          hint: "先用 list_tasks 确认任务 id 是否正确,不要重复尝试这个 id",
        }),
      }],
      isError: true,
    };
  }
  // ... 正常逻辑
};
关键在 hint 字段:告诉模型"下一步该干什么",而不是让它自己瞎试。一个带 hint 的错误,模型一次就能纠正;没 hint 的错误,模型平均要试 3 次才找对路——token 全烧在重试上了。
原则 6:写操作必须幂等
网络抖动、客户端重试,会导致同一个 tool 被调两次。create_task 调两次就多出一条重复任务。解法:给所有写操作加一个可选参数 clientMutationId(字符串,客户端生成),server 端用它做去重——同一个 id 24 小时内重复提交,直接返回第一次的结果。天然幂等的操作(比如 complete_task,完成两次结果一样)也要在 description 里写明"重复调用安全"。
原则 7:返回裁剪,只给决策需要的信息
别把数据库整行 dump 给模型。一条任务可能有 20 个字段,模型做决策只需要 id、标题、截止日期。原则:返回字段白名单 + 分页(limit 默认 10,上限 50)。实测数据:一个返回 5KB 的 tool 和一个返回 500 字节的 tool,在多轮对话里对上下文的侵蚀差出 10 倍——你的 server 被高频调用时,这就是用户 token 账单的直接差距。
五、传输层选型:stdio(本地)vs Streamable HTTP(远程)
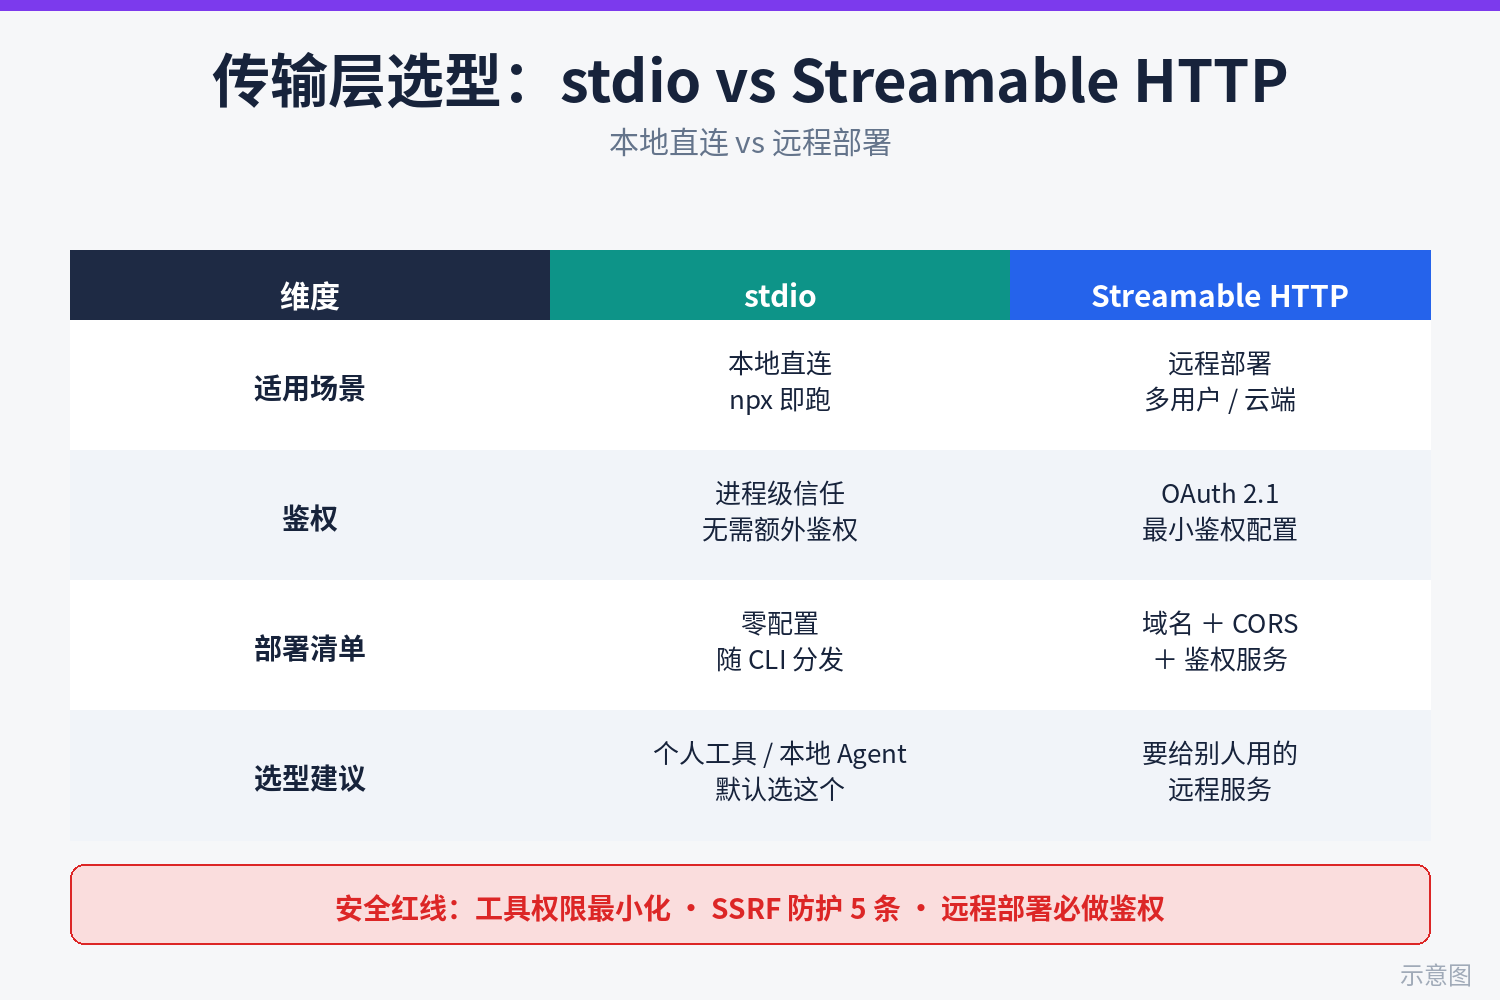
传输层决定你的 server 跑在哪里、谁来运维。先看决策表:
- 运行位置:stdio 跑在用户本机(客户端拉起子进程);Streamable HTTP 跑在你的服务器上(常驻进程或 Serverless)。
- 鉴权:stdio 不需要——本地进程默认就是用户本人,权限天然收敛;HTTP 必须做鉴权(见第六节),这是最大的成本差。
- 适合场景:stdio 适合个人效率工具、本地 dev 工具(比如"把我的本地笔记库变成 MCP");HTTP 适合多用户 SaaS、团队共享服务(比如"公司的任务系统,所有人用同一个 server")。
- 运维成本:stdio 是零——分发就是一个 npm 包;HTTP 要管域名、TLS 证书、限流、监控、扩容。
- 更新:stdio 用户要手动升级 npm 包;HTTP 你在服务端发版,用户无感。
我的建议:先 stdio 跑通,再按需上 HTTP。90% 的独立开发者项目,stdio + npm 分发就够了——用户 npx your-mcp-server 一行命令装好,在 Claude Code 的 .mcp.json 里配三行就能用。只有当你的 server 需要"多用户共享同一份数据/配额"时,才值得付 HTTP 的运维成本。
决定上 HTTP 的话,Streamable HTTP 的 server 端骨架(express 版,SDK API 以官方文档当前版为准):
import express from "express";
import { randomUUID } from "node:crypto";
import { McpServer } from "@modelcontextprotocol/sdk/server/mcp.js";
import { StreamableHTTPServerTransport } from "@modelcontextprotocol/sdk/server/streamableHttp.js";

const server = new McpServer({ name: "taskboard", version: "1.0.0" });
// ... 注册 tools/resources,和 stdio 版完全一样,业务代码零改动
const app = express();
app.use(express.json());

app.post("/mcp", async (req, res) => {
  const transport = new StreamableHTTPServerTransport({
    sessionIdGenerator: () => randomUUID(), // 每个会话独立 id,服务端可据此做限流
    enableJsonResponse: true,               // 不用 SSE,直接回 JSON,部署最简单
  });
  // 连接断开就释放 transport,否则内存泄漏——这是 HTTP 模式最常见的生产事故
  res.on("close", () => transport.close());
  await server.connect(transport);
  await transport.handleRequest(req, res, req.body);
});

app.listen(3000);
远程部署清单(上线前逐项打勾):
- HTTPS 域名:必须,MCP 客户端默认拒绝 http 明文(localhost 除外)。
- 鉴权:OAuth 2.1(见第六节),或至少 API key 走
Authorization: Bearer头;key 支持按用户吊销。 - CORS:只放行你自己的客户端域名,别图省事配
*——配了*就等于把鉴权 token 暴露给任意网页。 - DNS rebinding 防护:SDK 的
StreamableHTTPServerTransport支持enableDnsRebindingProtection+allowedHosts/allowedOrigins,本地测试时打开,防恶意网页把浏览器当跳板调你的 server。 - 限流与配额:按 session id / API key 限流,tool 调用是烧钱的操作(调你的后端 API、写你的数据库),没限流等于把账单交给全世界。
- 健康检查:
/healthz返回 200,给负载均衡和监控用;和/mcp分开,别让健康检查走鉴权。
六、安全红线检查表
MCP server 的特殊风险在于:调用方是模型,不是人。模型会传奇怪的参数、会误解你的 tool 用途、会被 prompt injection 诱导去调不该调的工具。所以安全不能靠"用户不会这么干",要靠机制。
OAuth 2.1 最小鉴权配置(远程 server 必做)
- 用 Authorization Code + PKCE 流程,不用隐式模式(implicit flow 已被 OAuth 2.1 废弃)。
- access token 有效期 ≤1 小时,refresh token 可长但支持吊销;token 只走
Authorization: Bearer头,不放 URL query(query 会进日志)。 - scope 按 tool 划分:
tasks:read/tasks:write,读和写的授权分开申请——用户只想让 Agent 查任务时,别顺手把删除权限也给出去了。 - 鉴权做在网关层或 SDK 的 auth 中间件里,不要每个 tool handler 里手写 token 校验(手写一定会漏)。
工具权限最小化
- 每个 tool 只拿它需要的最小权限:
list_tasks只能读,complete_task只能改状态——server 连接数据库用的账号,按"这个 server 的所有 tool 里权限最大的那个"来设,再小一格都不行。 - 危险操作(删除、转账、发邮件)加二次确认参数:
delete_task必须传confirm: true,description 里写明"此操作不可撤销"。模型误调的概率比你想象的高,confirm 参数是最后一道闸。 - tool 里能拿到的 secrets(API key、db 连接串)只走环境变量,永远不要打进日志——MCP 的日志经常被用户贴到 issue 里求助,一条连接串泄露就是一次安全事件。
SSRF 防护 5 条(你的 tool 要去调外部 URL 时必做)
- 1. 出站域名白名单:tool 参数里的 URL,只能访问你预先登记的域名,其他一律拒绝。不要做黑名单("禁止内网"),要做白名单("只允许这 5 个")。
- 2. 禁止内网 IP:10.0.0.0/8、172.16.0.0/12、192.168.0.0/16、169.254.169.254(云元数据服务)一律拦截——这是 SSRF 打云厂商元数据的经典路径。
- 3. DNS 解析后验 IP 再建连:先 resolve 域名,拿到 IP 后检查是否内网,再发起请求。防 DNS rebinding 和 TOCTOU(解析时是公网 IP,建连时被换成内网)。
- 4. 重定向要重新检查:禁用自动跟随重定向,或每次重定向后把新 URL 重新过一遍第 1-3 条。
- 5. 出站请求设超时:默认 10 秒超时,失败快速返回结构化错误(带 hint,见第四节原则 5),不要无脑重试——重试风暴会把你的 server 自己打挂。
七、发布与分发:让 Agent 找得到、装得上
代码写完只是 half done。MCP server 的分发有两个战场:注册表(让 Agent 发现你)和 README(让人 3 分钟装上)。
MCP 注册表提交清单
- server.json 元数据:name、version、description(一句话说清解决什么问题)、transport 类型(stdio/remote)、鉴权方式、仓库地址。description 写给搜索看的,带上用户会搜的关键词("todo""task manager"而不是你的品牌黑话)。
- 版本号语义化:tool 的增删改就是 breaking change——删 tool 或改必填参数必须升大版本,并在 description/changelog 里写明迁移方式。Agent 的配置是静态的,你悄悄改 schema 只会让用户的 Agent 开始报错。
- 至少一个可运行的示例:注册表审核和用户都会先看"能不能 5 分钟跑起来"。stdio 的提供
npx一行命令;HTTP 的提供一个公开 demo endpoint(只读 tool,限流)。 - 安全声明:远程 server 必须写清鉴权方式和数据收集范围("我们会记录 tool 调用日志用于排障,保留 30 天"),这是现在注册表的硬性要求趋势。
README 里"写给 Agent 看的安装说明"模板(直接复制改)
README 里单独开一节 ## For AI Agents,注意:这一节是写给用户的 Agent看的(用户会把 README 丢给 Agent 说"帮我装上"),所以要用指令式、路径明确、零歧义:
## For AI Agents:安装 taskboard-mcp

这是一个 MCP server,把 TaskBoard 待办工具暴露给 Agent 调用。

### 方式 A:本地运行(推荐个人用户)
1. 安装:npm install -g taskboard-mcp
2. 在 Claude Code 项目根目录创建 .mcp.json,内容如下:
{
  "mcpServers": {
    "taskboard": {
      "command": "npx",
      "args": ["-y", "taskboard-mcp"],
      "env": { "TASKBOARD_API_KEY": "在这里填用户的 API key" }
    }
  }
}
3. 重启 Claude Code,在输入框输入 /mcp 确认 taskboard 已连接。

### 方式 B:远程服务(团队用户)
1. 打开 https://taskboard.example.com/settings/api 创建 API key。
2. 在 Cursor 的 Settings → MCP → Add Custom MCP 里填:
   URL: https://mcp.taskboard.example.com/mcp
   Headers: Authorization: Bearer <你的 API key>
3. 回到对话,问一句"你有哪些 taskboard 工具"验证连通性。

### 可用工具一览(2026-10-11 更新)
- create_task:新建任务(需 tasks:write 权限)
- list_tasks:查询任务,支持状态过滤(需 tasks:read 权限)
- config://taskboard/settings:工作区配置(只读,无需鉴权)模板里三个细节别省:env 变量名写全(用户复制时最容易漏)、验证步骤写具体("/mcp 确认已连接"比"验证一下"有用十倍)、工具清单带日期(schema 会变,日期让 Agent 知道这份文档新不新鲜)。
最后一句总结:写 MCP server 不是追热点,是给你的项目买一张"Agent 时代"的入场券——150 行代码,一个下午,换的是你的产品在成千上万个 Agent 的工具箱里有一个位置。先 stdio 跑通,再考虑远程;schema 写给模型看,安全按红线来。动手吧。
相关文章
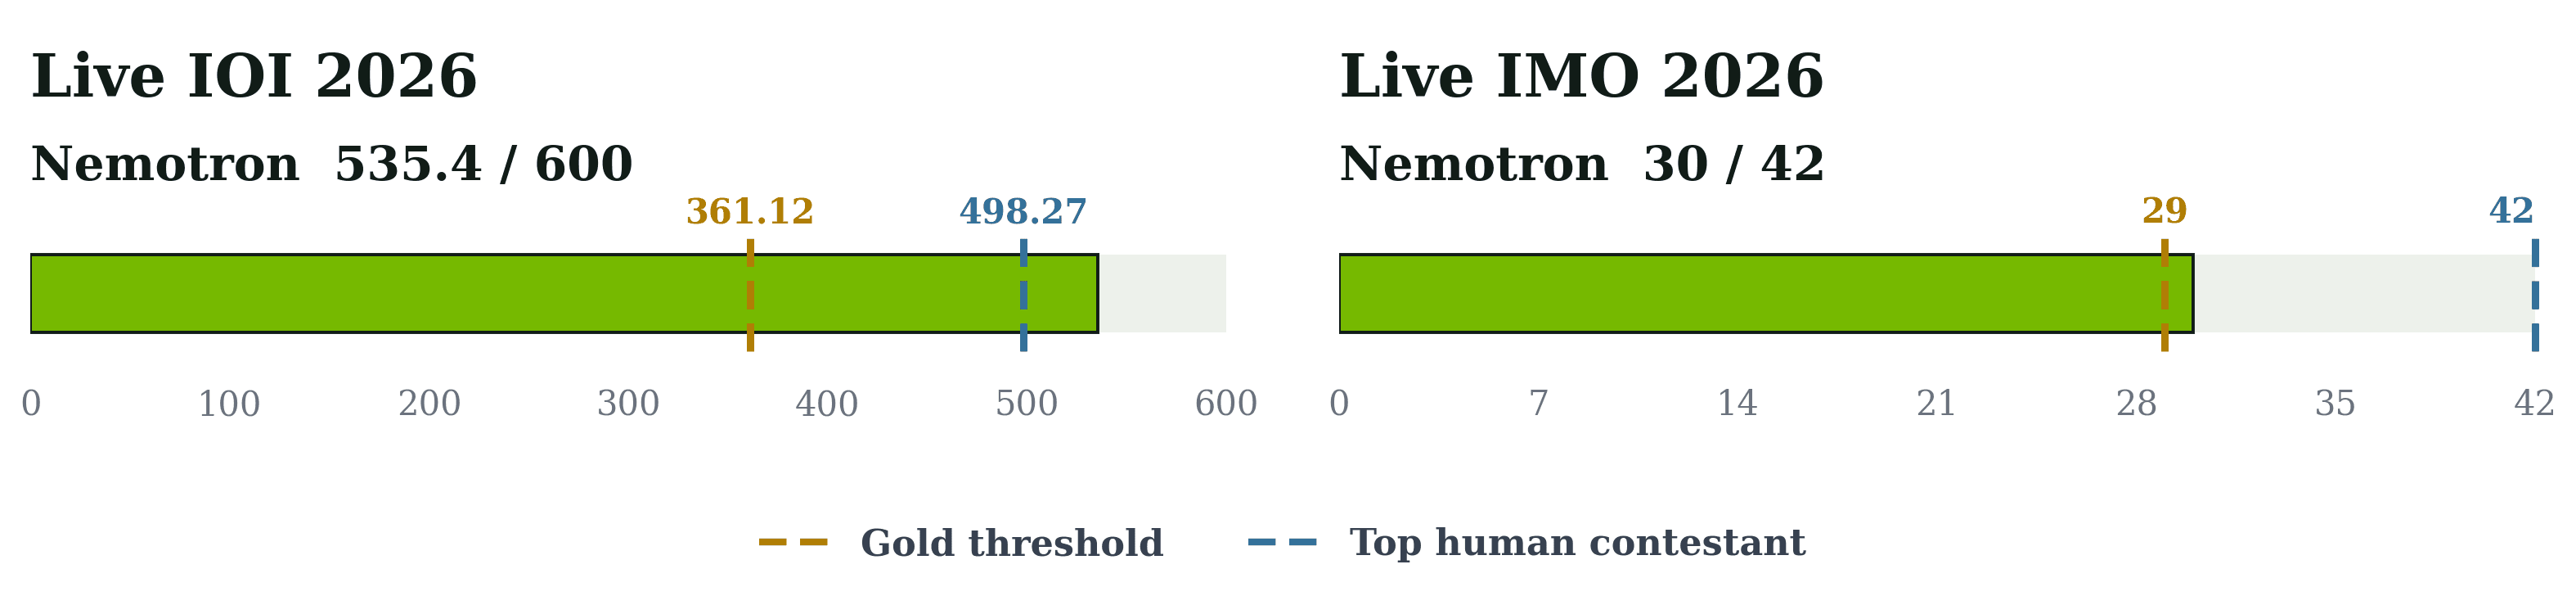
NVIDIA 的 Nemotron 系统在 IOI 2026 拿下 535.4/600(非官方跑分,超过人类最高分 498.27)、在 IMO 2026 拿下 30/42(官方阅卷,越过 29 分金牌线),并把整套配方全部开源:SFT 与 RL 的 checkpoint、两份训练数据集、全新的 200 道奥赛级数学 benchmark、推理管线与 prompt。核心方法是模型、数据、推理循环的协同设计:GenCorrect 的生成-评估-改进循环把 291 分的模型推过 438.3 的金牌线。对一人公司而言,这是一份生产级的测试驱动 agent 循环模板。
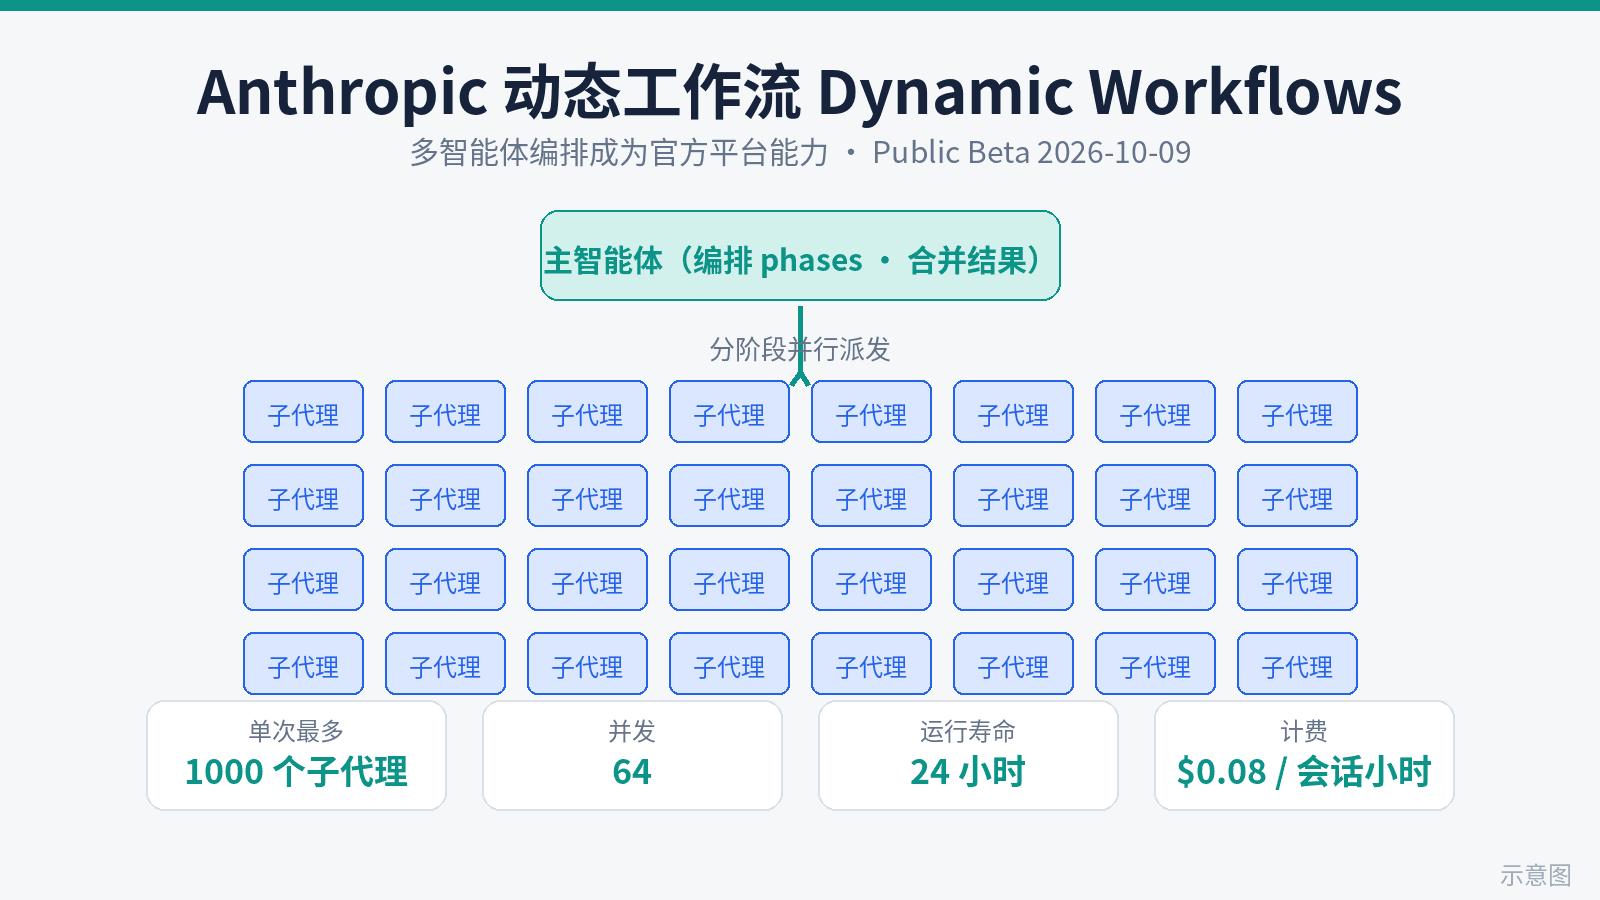
10 月 9 日,Anthropic 把 Claude Managed Agents 的动态工作流推进 public beta:agent 自己写编排程序,分阶段跑很多 agent 再合并结果——单次 run 最多起 1000 个 agent、64 个并发、默认 24 小时寿命、单 session 最多 10 个 run 并行。这次发布自带火药味:一位 OpenAI 资深工程师刚公开称 agent swarm 是“浪费 token”,Anthropic 随即贴出对照实测——11.6 万行代码埋 70 个 bug,单个 agent 三次找出 14/15/27,workflow 三次每次找出 66。计费是各模型正常 token 费率外加 $0.08/会话小时。本文深挖成本模型与适用场景:仓库级审计、迁移、批量文档评审是 workflow 的形状;实时交互和小任务还是单 agent 的形状。
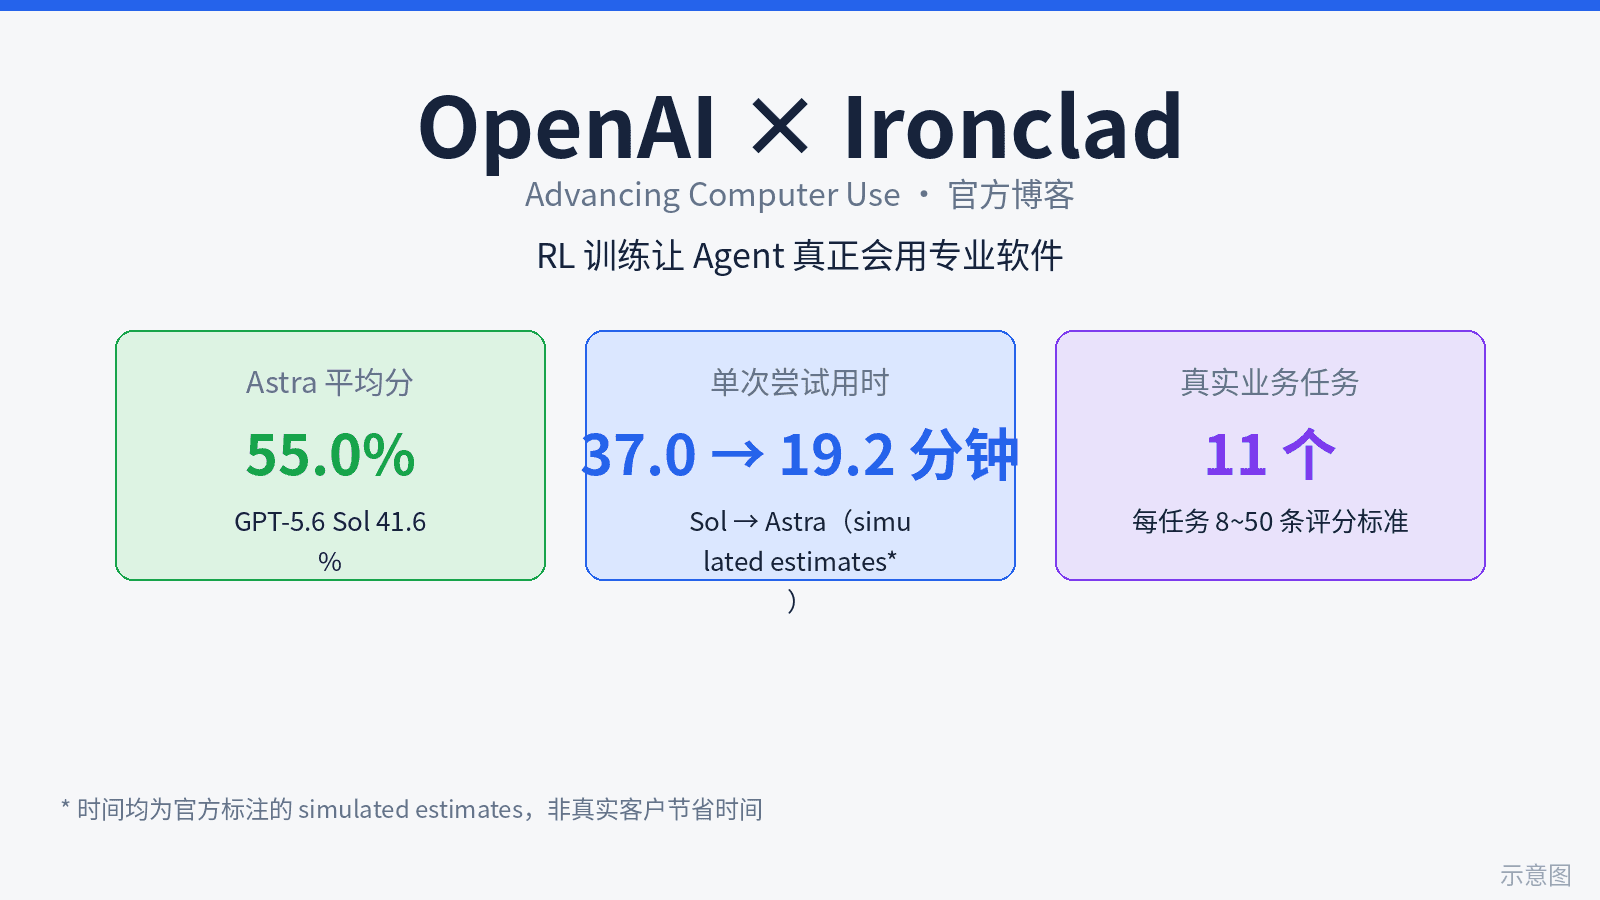
OpenAI 官方博客《Advancing computer use with Ironclad》标志着范式转移:Computer Use 从通用能力展示转向按应用定制训练。首款在 Ironclad 任务上训练的前沿模型 GPT-6 Astra,在 11 道专家设计的合同任务(每道 8~50 条评分标准)上拿到 55.0% 对 41.6%,单次估计耗时从 37.0 分钟降到 19.2 分钟。护城河正在从模型搬到「合作伙伴名单」——而 OpenAI 正在公开招募下一批软件公司。