出事之后才发现没记日志:vibe 项目的审计日志独立实战
审计日志≠业务日志≠运维日志。本文是审计日志独立实战:actor/action/resource 三元组数据模型、哈希链+WORM 不可变存储、“谁删了数据/谁导出了报表/谁改了价格”三类取证查询、删除权 vs 审计留存的法务平衡,以及一人团队一个下午能落地的最小实现(中间件+归档脚本,附可运行代码)。
先划界,避免你点错篇。本文只讲审计日志(audit log)——回答"谁在什么时候对什么做了什么"的那一份记录。它不是业务日志(订单创建了、支付成功了,读者是运营和产品),也不是运维日志(CPU 99%、接口 P99 飙了,读者是值班工程师)。三者的区别不在格式,在读者和用途:审计日志的读者,是未来的你——出事之后要取证、要自证清白、要应付合规检查时的你。业务日志可以丢(丢了顶多报表少一行),运维日志可以滚动删除(磁盘满了就得删),审计日志丢不起:丢了,你在纠纷里就没有证据。
站内和"审计"沾边的指南已经有四篇,各管一段,本文和它们分工明确:vibe-project-rbac-permissions-guide(RBAC 权限)管的是"谁能做什么",审计在那篇里只是配角章节里的一句"记得留痕";vibe-project-human-approval-workflows-guide(人审审批)管的是"高风险操作先让人点头",审计是审批单的附带产物;vibe-project-soc2-compliance-guide(SOC2 合规)管的是"合规框架怎么搭",审计日志在那篇里是检查清单上的一项;vibe-project-log-redaction-guide(日志脱敏)管的是"日志里的手机号、token 怎么擦掉",那是对运维和业务日志的清洗。本文是这条链上的最后一块拼图:审计日志本身怎么做——数据模型怎么设计、存到哪里才算不可篡改、出事了怎么查、以及它和用户删除权的冲突怎么处理。四篇是邻居,本文是正主,互相引用、各不重复。
一句话总结本文要解决的问题:你的 vibe 项目上线三个月后,某天早上你收到一封邮件——"昨晚 23 点,有人把我账号里的数据全删了,你们平台要负责。"你打开数据库,数据确实没了。你现在最想回答的三个问题是:谁干的?他当时还有没有做别的操作?以及,你能不能拿出他自己都改不了的证据证明这件事?如果你的第一反应是"去翻应用日志 grep 一下",那这篇就是写给你的。
一、审计日志记什么:只记"事实",不记"过程"
先给审计日志一个可操作的定义:一条审计记录 = 一个已发生的、不可撤销的事实陈述。"已发生"意味着只记录成功提交的操作——一个因为权限不足被 403 拦下的请求,记的是"有人试图越权",那是安全事件,不是审计事实,两者分开存。"不可撤销"意味着写进去就不能改,改了它就不再是证据。
实践中我见过两种最常见的记错法。第一种是把审计日志当业务日志用:用户每点一次按钮记一条,一天几十万条,三个月后没人敢查,查一次把数据库拖死。第二种是把审计日志当调试日志用:里面塞满了请求参数、堆栈、用户输入的原文,出事要取证时才发现,日志里躺着一堆明文密码和 token,取证没开始,先把自己送进了数据泄露事件。两种都源于同一个误解:以为"记得越多越好"。审计日志的正确心态恰恰相反——记得越少、越准、越不可改,价值越高。
那到底记哪些操作?给一人团队一条简单粗暴的准入线:只记"写"操作里会改变他人可见状态的那部分。具体就是四类:
- 身份类:登录成功/失败、密码修改、API key 创建与吊销、权限变更。登录失败要记——暴力破解的取证全靠它。
- 数据 destructive 类:删除、批量删除、导出(导出本质上是"数据离开了你的系统",和删除一样不可逆)。
- 钱和配置类:价格修改、优惠券创建、订阅变更、系统配置项修改、feature flag 开关。这些是纠纷高发区。
- 管理后台类:管理员查看/操作他人数据的行为。管理员自己就是最大的风险面,"管理员看了谁的数据"必须可查。
注意这个名单里没有"用户改了自己的昵称"——那是业务日志的活。审计日志的筛选标准永远是同一句话:这件事如果上了法庭/上了 Hacker News,你需不需要证明它发生过?需要,就记;不需要,就别往审计表里塞。
二、审计三元组:actor / action / resource 数据模型
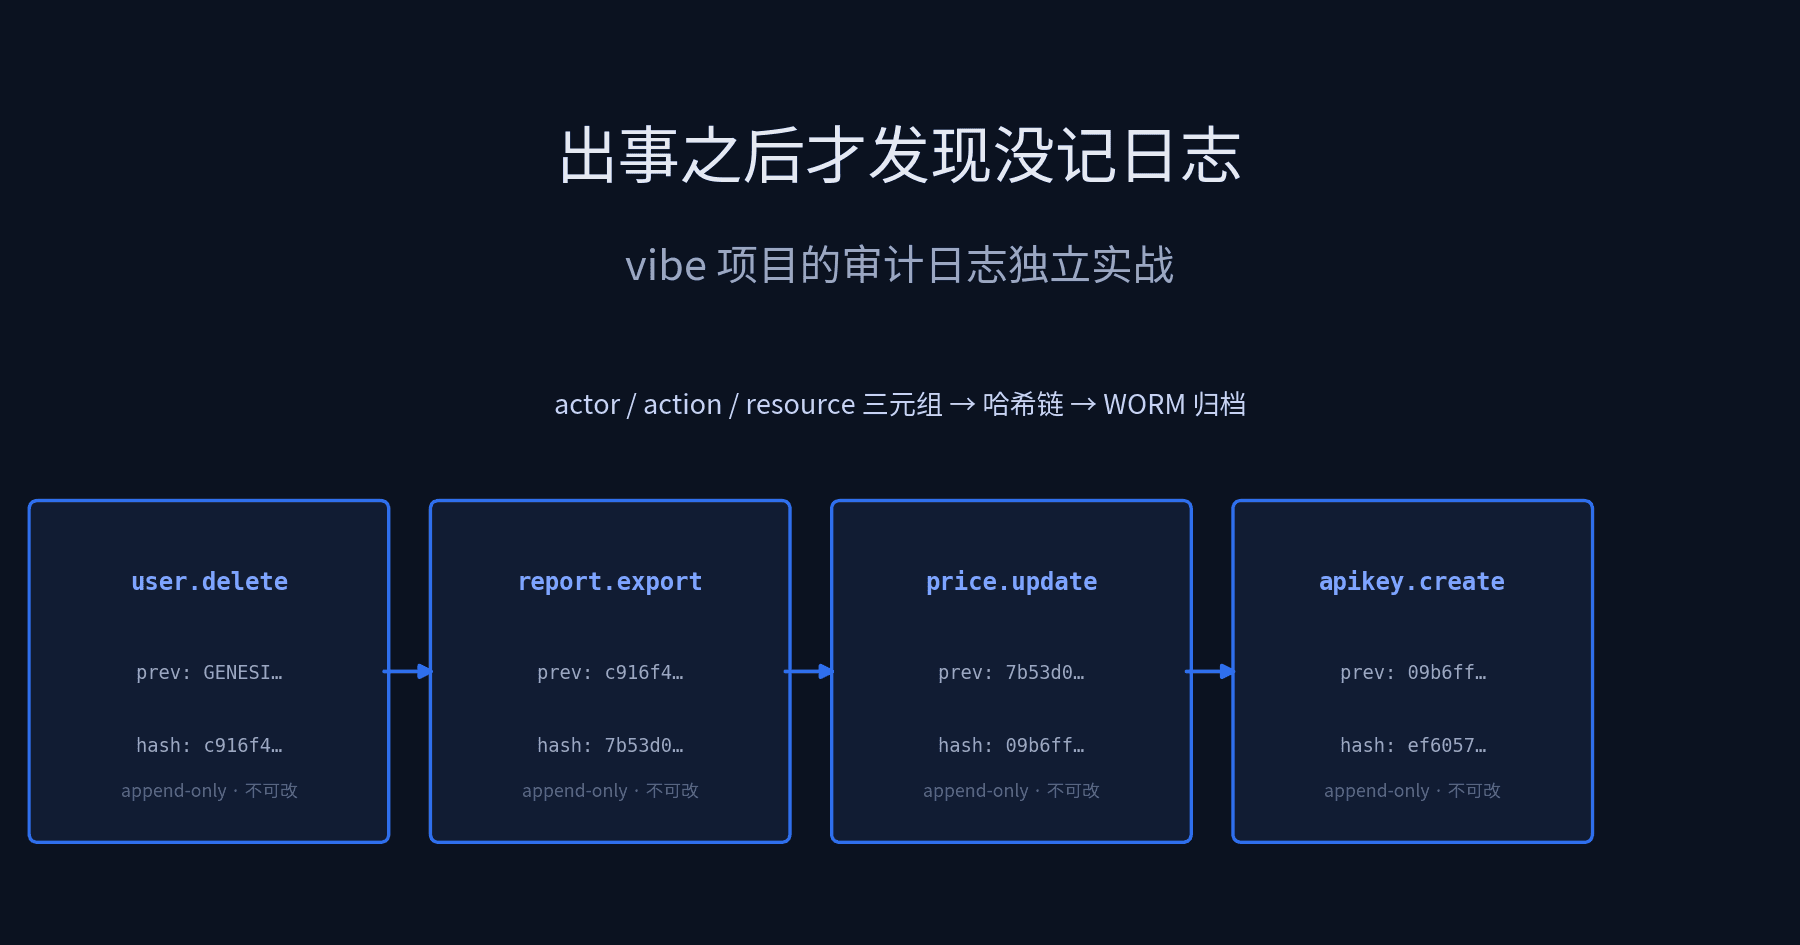
审计记录的核心是一个三元组:谁(actor)、做了什么(action)、对什么(resource)。三元组之外,再配一组"元字段"让记录可取证、可防篡改。这就是全部的数据模型,不需要更复杂的抽象——我见过有人给审计日志设计出 40 个字段的"通用事件模型",最后维护成本全花在填字段上,真正要查的时候发现一半字段是空的。
审计日志实战封面:深色背景上的审计事件哈希链,四个事件块按 append-only 顺序链接" alt="审计三元组数据模型与哈希链示意图:actor/action/resource 组成审计事件,事件按哈希链顺序追加存储" />图 1:审计三元组构成一条审计事件;事件按顺序追加,每条记录都包含上一条的哈希,形成篡改即断裂的哈希链。
三元组的每个位置都有讲究:
- actor(谁):存稳定的身份标识,比如用户 id、服务账号名,不要存邮箱、手机号这类会变的 PII。人离职了邮箱会回收,id 不会。系统内部的定时任务、webhook 回调,也要有自己的 actor 身份(如
system:cron-billing),"系统干的"不是免查金牌,恰恰相反——自动化脚本闯的祸,历史上比人闯的还多。 - action(做了什么):用受控词表,如
user.delete、report.export、price.update,不要直接存DELETE /api/users/123这种原始路由。路由会重构,词表不会。词表维护在一个常量文件里,新增 action 必须走代码评审——这本身就是一道防线:随便什么操作都能往审计里写,审计的可信度就没了。 - resource(对什么):拆成
resourceType+resourceId两列,不要合成一列。取证查询 90% 是"查某类资源的某条记录被谁动过",两列拆开才能建索引。resourceId 存 id,不要存名称——名称会改,id 不会。
三元组之外,元字段一个不能少:
- occurredAt:事件发生时间,用 UTC,数据库列类型用
timestamptz。用本地时区存时间是取证灾难——夏令时切换那一小时,你的日志时间线会出现"先发生的事排在后面"。另外注意:occurredAt 是业务发生时间,不是写入时间,两者分开,写入延迟不污染时间线。 - result:
ok/denied/failed。被拒绝的操作也要记(谁在什么时候试图删别人的数据),但要和成功的分开查。 - ip / userAgent:取证时定位"是不是本人操作"的关键。注意这是 PII,按脱敏指南处理,审计表里的 ip 只给有取证权限的角色看(RBAC 那篇管的就是这个)。
- metadata(jsonb):只放取证需要的最小上下文,比如价格修改的 old/new 值、导出的行数。铁律:metadata 里不许出现密码、token、完整请求体——那是调试日志的活。
- prevHash / hash:防篡改的哈希链,下一节细讲。
Postgres + Prisma 的表结构可以直接抄:
model AuditLog {
  seq          BigInt   @id @default(autoincrement())
  occurredAt   DateTime @default(now()) @db.Timestamptz()
  actor        String   // 谁:用户 id / 服务账号 / anonymous
  actorType    String   @default("user")
  action       String   // 受控词表:user.delete / report.export / price.update
  resourceType String
  resourceId   String
  ip           String?
  result       String   @default("ok") // ok / denied / failed
  prevHash     String
  hash         String   @unique
  metadata     Json?

  @@index([actor, occurredAt])
  @@index([action, occurredAt])
  @@index([resourceType, resourceId])
}
三个复合索引对应三类最高频的取证查询:查某人干过什么、查某类操作发生过几次、查某条记录被谁动过。索引现在就建好,不要等到出事那天才发现全表扫描——取证查询跑在生产库上,一次慢查询可能就是第二次事故。
三、不可变存储:append-only 不是口号,是三层实现
"审计日志不可篡改"这句话,很多人理解为"我们约定不改它"。约定在出事的时候一文不值——能写数据库的人就能改数据库,包括你自己,也包括拿到你数据库凭证的攻击者。不可变必须是机制,不是纪律。我给一人团队的三层实现,按成本从低到高:
第一层:数据库权限收紧(今天就能做,零成本)。给应用用的数据库账号收回审计表的 UPDATE 和 DELETE 权限,只留 INSERT 和 SELECT:
-- 应用账号只能追加和读,不能改、不能删
REVOKE UPDATE, DELETE ON "AuditLog" FROM app_user;
GRANT INSERT, SELECT ON "AuditLog" TO app_user;
就这么两行,效果立竿见影:应用层的 bug、被注入的 SQL、甚至你自己手滑进 psql,都改不了历史记录。注意这防的是"应用层",防不住"直接连数据库的人"——所以还需要下面两层。
第二层:哈希链(防"偷偷改一条"的数学手段)。每条记录在写入时,把上一条记录的哈希值(prevHash)和本条内容一起做 SHA-256,得到本条的 hash。链条一旦形成,改历史上的任何一条,它之后的所有 hash 全部对不上——篡改从"悄无声息"变成"人尽皆知"。创世块的 prevHash 固定为 GENESIS。写入代码:
import { createHash } from "crypto";

// 规范序列化:递归排序所有对象键(含 metadata 的嵌套键),
// 同一内容永远得到同一哈希;数组保持原序(顺序即语义)
function canonical(value: any): string {
  return JSON.stringify(value, (_key, val) => {
    if (typeof val === "bigint") return val.toString();
    if (val && typeof val === "object" && !Array.isArray(val))
      return Object.fromEntries(
        Object.keys(val).sort().map((k) => [k, val[k]])
      );
    return val;
  });
}

export async function appendAudit(prisma: any, fields: {
  actor: string; action: string; resourceType: string; resourceId: string;
  ip?: string; result?: string; metadata?: object;
}) {
  // 取链尾。注意:高并发下这里要用行锁或改由单写者串行化,
  // 否则两个并发写入会算出同一个 prevHash。见第五节。
  const tail = await prisma.auditLog.findFirst({
    orderBy: { seq: "desc" }, select: { hash: true },
  });
  const body = {
    occurredAt: new Date().toISOString(),
    actorType: "user", result: "ok", ...fields,
    // 归一化:缺省的 ip/metadata 显式写 null。JSON 会丢弃 undefined,
    // 但 Prisma 读回的是 null,不归一化验链会误报
    ip: fields.ip ?? null,
    metadata: fields.metadata ?? null,
    prevHash: tail?.hash ?? "GENESIS",
  };
  const hash = createHash("sha256").update(canonical(body)).digest("hex");
  return prisma.auditLog.create({ data: { ...body, hash } });
}

// 取证前先验链:任何一条对不上,整条链不可信
export async function verifyChain(prisma: any) {
  const rows = await prisma.auditLog.findMany({ orderBy: { seq: "asc" } });
  let prev = "GENESIS";
  for (const r of rows) {
    const { hash, seq, ...body } = r; // BigInt 的 seq 不参与哈希
    if (body.prevHash !== prev)
      return { ok: false, at: seq.toString(), reason: "prevHash 断裂:中间被删过记录" };
    if (hash !== createHash("sha256").update(canonical(body)).digest("hex"))
      return { ok: false, at: seq.toString(), reason: "内容哈希不符:记录被改过" };
    prev = hash;
  }
  return { ok: true, count: rows.length };
}两个细节别忽略。第一,canonical 必须用递归排序的函数版,不能用 JSON.stringify(obj, Object.keys(obj).sort()) 的数组版写法——数组 replacer 是白名单语义,metadata 里嵌套的键不在白名单里会被直接丢弃,导致"metadata 改了、哈希却不变",链就形同虚设。写入和校验必须用同一套序列化,否则你自己验自己的链都验不过。第二,seq(BigInt)不参与哈希:它是数据库自增的"行号",不是事件内容的一部分;函数版里顺手把 BigInt 转字符串,避免 JSON.stringify 遇到 BigInt 直接 throw(真实踩过的坑)。另外注意 occurredAt 的往返一致性:写入时是 toISOString() 字符串,读回时是 Date 对象再经 toJSON() 序列化——两者都是带毫秒的 ISO 字符串,Postgres 的 timestamptz 微秒精度经 Prisma 读回会截断到毫秒,恰好与写入侧一致,验链不会误报。第三,undefined 与 null 的往返:JSON.stringify 会直接丢弃值为 undefined 的键,但 Prisma 把缺省字段读回来是 null——写入侧"没这个键"、校验侧"键是 null",哈希对不上。所以 appendAudit 里把缺省的 ip/metadata 显式归一化为 null,两边永远一致。
哈希链防的是"改",不防"删"——删掉链尾几条,链依然自洽。所以验链必须配合条数对账:每天归档时记录当日条数,第二天对账,少了就是有人动了链尾。这就是第三层要解决的事。
第三层:对象存储归档 + WORM(防"连库端掉"的最终手段)。每天凌晨把前一天的审计记录导出为 JSONL,打包计算整体哈希,上传到对象存储(S3 / 阿里云 OSS / R2),并开启对象锁定(Object Lock,合规模式):设定保留期(比如 3 年),保留期内任何人——包括 root 账号——都删不掉、改不了。这就是 WORM(Write Once Read Many):一次写入,多次读取。热数据留在 Postgres 里方便查(保留 90 天),冷数据进对象存储长期封存。归档脚本的核心逻辑:
// 每日 03:00 跑:导出昨日审计 -> 验链 -> 打包 -> 上传 WORM 存储
import { S3Client, PutObjectCommand } from "@aws-sdk/client-s3";
import { createHash } from "crypto";
import { writeFileSync } from "fs";

async function archiveYesterday(prisma: any, s3: S3Client, bucket: string) {
  const start = new Date(); start.setUTCHours(0, 0, 0, 0);
  start.setUTCDate(start.getUTCDate() - 1);
  const end = new Date(start); end.setUTCDate(end.getUTCDate() + 1);

  const rows = await prisma.auditLog.findMany({
    where: { occurredAt: { gte: start, lt: end } },
    orderBy: { seq: "asc" },
  });
  // 先验链再归档:链断了,归档的就是赃物
  const v = await verifyChain(prisma);
  if (!v.ok) throw new Error(`验链失败 seq=${v.at}: ${v.reason},停止归档并告警`);

  const lines = rows.map(r => JSON.stringify(r, (_, val) =>
    typeof val === "bigint" ? val.toString() : val)).join("\n");
  const packHash = createHash("sha256").update(lines).digest("hex");
  const key = `audit/${start.toISOString().slice(0, 10)}.jsonl`;

  await s3.send(new PutObjectCommand({
    Bucket: bucket, Key: key, Body: lines,
    ObjectLockMode: "COMPLIANCE",                       // 合规模式:保留期内不可删改
    ObjectLockRetainUntilDate: new Date(Date.now() + 3 * 365 * 864e5),
    Metadata: { packHash, count: String(rows.length) },  // 条数对账用
  }));
  console.log(`archived ${key}: ${rows.length} 条, packHash=${packHash}`);
}
注意 JSON.stringify 的第二个参数是个 replacer 函数,把 BigInt 转成字符串——和验链时"解构掉 seq"是同一个坑的两种解法,前后要一致。Metadata 里带的 count 就是用来做条数对账的:明天归档时顺手读一下昨天的 Metadata,条数对不上就告警。三层加起来:应用层改不了(权限),偷改会被发现(哈希链),连库端了还有封存副本(WORM)。一人团队做到这三层,审计存储的可信度已经超过 90% 的同体量公司。
四、写入路径:中间件 30 行 + 手动埋点
模型和存储都有了,剩下的问题是:谁来写这些记录?两种写入路径,覆盖 95% 的场景。
路径一:HTTP 中间件,自动记录所有"写"操作。挂在路由之后、错误处理之前(这时 req.route 已经就绪),只拦截 POST / PUT / PATCH / DELETE,读操作一律不记——记读操作是审计日志爆炸最常见的死因。核心逻辑 30 行:
import { appendAudit } from "./audit";

const MUTATING = new Set(["POST", "PUT", "PATCH", "DELETE"]);
// action 词表:路由 -> 受控词表,新增必须走代码评审
const ACTION_MAP: Record<string, string> = {
  "DELETE /api/users/:id": "user.delete",
  "GET /api/reports/:id/export": "report.export", // 导出是 GET,但它是"写"语义,手动加
  "PATCH /api/products/:id/price": "price.update",
};

export function auditMiddleware(prisma: any) {
  return (req: any, res: any, next: () => void) => {
    const key = `${req.method} ${req.route?.path ?? req.path}`;
    const action = ACTION_MAP[key];
    // 不在词表里的写操作:不记。宁可漏记可疑操作时告警,也不要记一堆无名操作
    if (!MUTATING.has(req.method) && !action) return next();
    if (!action) return next();

    res.on("finish", () => {
      if (res.statusCode >= 500) return; // 服务端出错:操作没发生,不记
      appendAudit(prisma, {
        actor: req.user?.id ?? "anonymous",
        action,
        resourceType: action.split(".")[0],
        resourceId: String(req.params.id ?? req.params.reportId ?? "n/a"),
        ip: req.ip,
        result: res.statusCode < 400 ? "ok" : "denied",
      }).catch((e) => console.error("[audit] 写入失败:", e.message));
    });
    next();
  };
}三处设计取舍说清楚。第一,ACTION_MAP 是显式词表而不是"所有写操作自动记"——自动记会把"用户改昵称""点赞"这种业务操作也塞进审计表,三个月就爆炸;显式词表逼你在代码评审时回答"这个操作值不值得进审计"。第二,导出是 GET 请求但语义是"写"(数据离开了系统),所以词表里手动加一条,这是最容易漏记的一类——历史上数据泄露事件的取证,十次有八次卡在"导出没记"。第三,审计写入失败只打日志不抛错:审计是旁路,不能因为审计表写不进去就让用户下不了单;但失败必须告警,console.error 在这里是占位,生产环境要接你的告警通道(PagerDuty/飞书机器人都行),否则"审计悄悄停了三个月"比"没审计"更危险——前者给你虚假的安全感。
路径二:手动埋点,覆盖中间件够不着的地方。三类场景必须手写 appendAudit:定时任务(如 system:cron-billing 批量扣款)、管理后台的"查看他人数据"(读操作但是高敏感,词表里单独加 admin.user.view)、第三方 webhook 回调(如支付成功的回调,要记 system:stripe 这个 actor 干了什么)。手动埋点的规则只有一条:actor 必须显式指定,不许用"当前登录用户"兜底——定时任务没有登录用户,兜底就是 anonymous,等于没记。
并发写入的坑:appendAudit 里"读链尾取 prevHash 再写入"是两步操作,高并发下两个请求可能读到同一个链尾,算出同一个 prevHash,链就分叉了。一人团队的项目 QPS 通常不高,真遇到了有三档解法: Postgres 用 pg_advisory_xact_lock 串行化写入(最简单);或者审计写入走单消费者队列(把 appendAudit 换成发消息,一个 worker 串行写);或者接受"按 seq 排序即链序",把 prevHash 改成"上一 seq 的 hash",用数据库唯一约束保证。一句话:审计写入必须是串行的,这是哈希链成立的前提。
五、取证查询实战:三个你迟早会遇到的问题
审计日志的价值不在"存了",在"出事那天 5 分钟内能查出来"。下面三个查询,对应开篇那封邮件里的三个灵魂拷问,直接在 Postgres 里跑。假设今天是 2026-10-16,纠纷发生在 10-15 深夜。
问题一:"谁删了用户数据?"
-- 先定位:过去 48 小时所有删除类操作
SELECT seq, occurredAt, actor, action, resourceType, resourceId, ip, result
FROM "AuditLog"
WHERE action LIKE '%.delete'
  AND occurredAt >= now() - interval '48 hours'
ORDER BY seq;
查出来 actor = 'u_918273' 在 10-15 23:04 执行了 user.delete,resourceId 是投诉人的 id。别停,接着查这个 actor 当晚还干了什么——删数据的很少只删一条:
-- 再扩散:这个 actor 当晚的全部操作
SELECT occurredAt, action, resourceType, resourceId, result
FROM "AuditLog"
WHERE actor = 'u_918273'
  AND occurredAt >= '2026-10-15 22:00+00'
ORDER BY seq;
如果扩散查询显示他 23:01 先调了 report.export 导出了全量用户表,23:04 才删数据——这就不是"手滑",是"先偷再毁",性质完全不同,法务处理方式也不同。审计的价值在这里:它还原的是行为序列,不是单个动作。
问题二:"谁导出了报表?"
-- 导出类操作按 actor 聚合,看有没有异常
SELECT actor, count(*) AS cnt,
       max(occurredAt) AS last_export,
       string_agg(DISTINCT ip, ', ') AS ips
FROM "AuditLog"
WHERE action = 'report.export'
  AND occurredAt >= now() - interval '30 days'
GROUP BY actor
ORDER BY cnt DESC;
重点看两个异常信号:平时一个月导出 2 次的人突然一天导了 40 次;或者导出 ip 和常用 ip 不在同一个城市。前者是"离职前打包带走"的经典画像,后者是"账号被盗"的画像。metadata 里如果记了导出行数(metadata->>'rows'),再加一列 sum((metadata->>'rows')::int),能量化泄露规模——跟监管/客户交代时,"导出了 12 万行"和"导出了一些数据"是两种完全不同的对话。
问题三:"谁改了价格?"
-- 价格变更:新旧值都在 metadata 里,直接还原现场
SELECT occurredAt, actor, resourceId AS product,
       metadata->>'old' AS old_price,
       metadata->>'new' AS new_price,
       ip
FROM "AuditLog"
WHERE action = 'price.update'
  AND occurredAt >= now() - interval '7 days'
ORDER BY seq;
价格纠纷的取证要点是 old/new 值必须当时就记,事后去订单表反推是推不出来的(订单表只存了成交价,没有"改价前是多少")。这也是 metadata 设计原则的实例:只记取证需要的最小上下文,但该记的一定要在事件发生时记——审计没有"事后补"这个选项。
三个查询的共同前提:先验链再查。取证第一步永远是跑一遍 verifyChain,链是好的,查出来的结果才是证据;链断了,先解决"谁动了审计表"这个更大的问题,再谈原来的纠纷。顺序不能反。
六、删除权 vs 审计留存:最难的一道法务题
好,现在来到最棘手的部分。用户行使删除权(GDPR 第 17 条、中国《个人信息保护法》第 47 条),要求你"删除我的一切个人数据"。但你的审计日志里躺着他的 actor id、ip、操作记录——删,还是不删?
审计日志实战封面:深色背景上的审计事件哈希链,四个事件块按 append-only 顺序链接" alt="删除权 vs 审计留存决策流程图:收到删除请求后,按法定义务与合法权益分支决定删除、假名化或限制处理" />图 2:收到删除请求后的决策流程——不是"全删"或"全留"的二选一,而是按法律依据分流处理。
先说法律结论,再说工程做法。GDPR 第 17 条第 3 款明确列了删除权的例外,其中第 (e) 项:为法律主张的提出、行使或抗辩而必须处理的数据,不适用删除权。翻译成人话:审计日志如果留存的目的是"将来打官司时自证",法律允许你不删。中国《个人信息保护法》第 19 条则是另一条路:留存期限应当为实现处理目的所必要的最短时间——也就是说,你可以留,但必须有个期限,到期就删。两条合在一起,工程上的标准答案是四步:
- 分流:删除请求进来,先区分数据类型。业务数据(订单、profile、上传文件)走
data-subject-request-dsr-guide(站内 DSR 删除权指南)那套流程删干净;审计日志单独走下面的流程。两类数据用两套流程,这是开篇划界的延续——那篇管"删除权怎么做",这篇管"删除权碰到审计日志怎么办"。 - 找法律依据:你的审计日志留存,依据是什么?三选一,且要写下来(写进隐私政策,不是写进代码注释):法定义务(如税务、金融行业有强制留存年限,留存期=法定期限);合法权益(GDPR 第 6(1)(f) 条:防欺诈、纠纷举证,留存期=你自己定的合理期限,比如 180 天或 3 年);用户同意(最弱,尽量别用这条,因为同意可以撤回)。依据不同,留存期不同;没有依据,就没有留存的理由。
- 假名化 + 限制处理:这是平衡术的核心。用户要求删除后,审计记录里的
actor从用户 id 替换为不可逆的假名(如HMAC(user_id, 密钥),密钥单独保管或直接销毁映射关系),ip 截断到 /24,metadata 里的人名、邮箱全部清除。记录本身保留——"2026-10-15 23:04 有人删除了用户 X 的数据"这个事实还在,链条不断,但已经无法直接定位到真人。同时把这批记录标记为"受限处理":只有法务/取证角色能查(RBAC 那篇的权限模型在这里派上用场),日常运营看不到。 - 到期自动删:留存期一到,归档和热库一起删。S3 的 Object Lock 是"保留期内不可删",保留期过了就可以设生命周期规则自动过期删除;Postgres 热库用分区表按月删。关键是自动——靠人记着删,等于没删。
一人团队最容易犯的两个错:一是"用户说删我就全删了,包括审计日志"——三个月后纠纷来了,你手里没有证据;二是"审计日志我永久保留"——《个人信息保护法》的"最短必要时间"可不是摆设,超期留存本身就是违法。正确姿势是中间那条路:有依据、有期限、可假名化、到期自动删。把这四条写进你的隐私政策,删除权请求来了按图 2 的流程走,你就同时对用户、对监管、对未来的自己都有交代。
七、一人团队最小实现:今天下午就能上线
把前面所有内容压缩成一个可执行的清单。按顺序做,一个下午能做完:
- 建表(30 分钟):把第二节的 Prisma model 抄进 schema,跑迁移,建好三个复合索引。
- 收权限(10 分钟):第三节第一层的两行 SQL,REVOKE 掉应用账号的 UPDATE/DELETE。
- 写 appendAudit + verifyChain(1 小时):第三节的代码直接用,注意 BigInt 序列化的坑。写完先对自己跑一遍验链:插入 3 条,改其中一条的 metadata,再跑 verifyChain,确认它能报出"内容哈希不符"——防篡改机制必须亲手验证它真的能报警,否则等于没装。
- 挂中间件 + 定词表(1 小时):第四节的中间件,先只加 5 个最高危的 action(user.delete、report.export、price.update、apikey.create、admin.user.view),跑起来再慢慢加。词表小步快走,不要一上来定 50 个。
- 归档脚本 + cron(1 小时):第三节的 archiveYesterday,cron 每天 03:00 跑。S3 bucket 开 Object Lock(注意:Object Lock 必须在建 bucket 时开启,建完开不了——这是 AWS 上真实存在的限制,规划时就要定)。保留期先设 1 年,以后按法务要求调。
- 写进隐私政策(30 分钟):加一段"审计日志留存声明":留存目的(安全与纠纷举证)、留存期限、删除权请求时如何处理(假名化+限制处理)。第六节的四步就是这段的素材。
- 演练一次取证(30 分钟):在 staging 环境模拟"删数据",用第五节的三个查询走一遍,计时。超过 10 分钟查不出来,说明词表或索引有问题,调完再上线。
总成本:一个下午 + 每月几块钱的对象存储费用。换回来的是:出事那天,你不是在 grep 日志里赌运气,而是有链可验、有数可查、有证据可交。这笔账对一人团队尤其划算——大公司有法务部和取证团队,你没有;你的审计日志就是你的法务部。
八、四个坑:都是别人用真金白银踩出来的
坑一:审计表没有 TTL,三年后成了性能炸弹。热库只留 90 天,90 天前的只在归档里查——这是架构,不是建议。见过最多的死法是"审计表 8000 万行,取证查询把主库拖死",然后有人为了救库把审计表 truncate 了,证据也没了。分区表 + 定期归档 + 热库 TTL,三件套缺一不可。
坑二:把"谁看了"和"谁改了"记在同一个地方用同一个权限查。管理员查看他人数据的记录(admin.user.view)本身也是敏感信息——它暴露了"谁在被调查"。这类记录的查询权限要比普通审计更高,至少是"只有创始人/法务能看"。RBAC 那篇的权限分级在这里要再收紧一档。
坑三:哈希链写了,但从来没跑过 verifyChain。防篡改机制和灭火器一样,买了不检查等于没买。把 verifyChain 接进你的每日健康检查(和归档脚本放一起),链断了立刻告警。前面归档脚本里"先验链再归档"就是这个意思——顺序写进代码,不要靠人记。
坑四:审计日志里记了不该记的东西,取证时先把自己送走。metadata 里出现过明文密码、完整 JWT、用户聊天原文——取证时你把这份日志交给第三方(律师、监管),等于主动提交了一份数据泄露证据。写一条 CI 检查:审计写入前扫描 metadata 的键名,出现 password、token、secret 直接拒绝写入并告警。脱敏是 vibe-project-log-redaction-guide 那篇的主题,审计表是它最应该覆盖的地方。
最后回到开篇那封邮件。"昨晚 23 点,有人把我账号里的数据全删了。"有了这套审计,你的回复可以是:"我们查到了,23:04,账号 u_918273 从 ip x.x.x.x 执行了删除,之前 23:01 他导出了你的数据报表。这是哈希校验通过的审计记录,原始档案封存在对象存储,保留期 3 年。"——纠纷到这里,基本就结束了。而没有审计的版本是:"我们正在排查……",然后排查三个月。
相关阅读:RBAC 权限模型(vibe-project-rbac-permissions-guide)告诉你"谁能做什么";人审审批(vibe-project-human-approval-workflows-guide)管住高风险操作的事前;SOC2 合规(vibe-project-soc2-compliance-guide)是审计日志要满足的框架;日志脱敏(vibe-project-log-redaction-guide)保证你的审计表里不躺着明文密码;用户删除权全流程(data-subject-request-dsr-guide)处理业务数据的删除,本文第六节处理审计日志的例外。四篇邻居加一篇 DSR,合起来就是一人团队的完整合规拼图。
评论 (0)
相关文章
AI 默认把你的 vibe 项目部署到 serverless,然后账单就多了一个零。本文拆解 Vercel、Cloudflare Workers、AWS Lambda 的真实计费模型,给出可计算的成本拐点公式(何时 serverless 比 VPS 贵),曝光 AI 生成代码最爱踩的五大架构陷阱(长连接、本地状态、定时任务当常驻、大包冷启动、egress 流量费),并附六步可落地优化清单——先省钱,再谈迁移。
头像存在 ./uploads 里,上线第一周就翻车?本文讲预签名 URL 直传、公开/私有/图片变体三种存法、R2 零流出费选型,以及孤儿文件清理、环境隔离、存量迁移的全套实战,附上线 checklist。
console.log 里躺着用户邮箱和登录 token?这篇指南给你一人团队一天能落地的日志脱敏全方案:PII 四级分级表、可直接复制的 TypeScript 脱敏三件套、console.log 到 pino 的最小迁移、请求日志中间件模板、Sentry beforeSend 配置、分级保留策略与成本账,外加 8 个真实踩坑。