没点过恢复按钮的备份都是纸:vibe 项目的数据库备份与灾难恢复实战
备份回答的是数据丢没丢,灾难恢复回答的是丢了之后多久能回来、回来多少。这篇实战指南覆盖 RPO/RTO 定级、五种故障场景矩阵、Postgres/Supabase/Neon/SQLite 四套可直接抄的 PITR 方案、每周自动恢复演练脚本、一页纸 runbook 模板与降级开关。
先划清边界:这篇和 10-06 那篇备份指南不是一回事
10 月 6 日我们发过一篇《别让 Agent 删了你的生产库:Vibe 项目的数据备份实战》,讲的是怎么把备份做出来:三层备份策略、给 Agent 的权限画线、以及"没验证过的备份等于没有备份"这条铁律。如果你还没读过,先去看那篇——它是这篇的前置课。
这篇讲的是备份之后的事:真出事那天,你能不能在用户发现之前把服务救回来?备份文件躺在 S3 里,和你在凌晨三点把它恢复成一个能跑的数据库之间,隔着一道巨大的鸿沟。这道鸿沟的名字,叫灾难恢复(Disaster Recovery)。
备份回答的是"数据丢没丢";灾难恢复回答的是"丢了之后多久能回来、回来多少"。这是两个完全不同的问题,而 99% 的独立开发者只回答了第一个。
核心观点:没点过"恢复"按钮的备份,都是纸
做个诚实的小测试:你的项目现在有备份吗?好。第二个问题:你上一次实际执行"恢复"是什么时候?不是"备份成功了"的绿勾,是真的从备份里起了一个数据库,跑通了登录、下单、读数据这些核心流程。
如果你的答案是"从来没有",那你的备份状态和没有备份没有本质区别。这不是危言耸听,是恢复流程里藏着的坑决定的:
1. 备份可能根本不可读。pg_dump 中途被 OOM killer 干掉,生成了一个 0 字节的"成功"文件;cron 的报错邮件进了垃圾箱,三个月没人看。
2. 恢复步骤可能缺了一半。数据库恢复了,但连接它的新环境变量在哪?迁移脚本的版本和备份对得上吗?对象存储里的用户上传文件和数据库快照是同一时刻的吗?
3. 恢复时间可能长到无法接受。500GB 的数据库从 S3 拉下来再导入,你以为 20 分钟,实际可能是 6 小时——而你第一次知道这个数字,是在真出事的那天。
所以这篇的立场很鲜明:备份是成本,恢复是能力。备份花的是每个月几美元;恢复能力花的是你每个季度几个小时的演练。而一次真实灾难里,前者一文不值,后者决定生死。

第一步:给你的项目定 RPO 和 RTO(两分钟版本)
所有灾难恢复讨论都从两个指标开始。别被术语吓到,它们翻译成大白话就是:
RPO(恢复点目标):出事时,你最多能接受丢多少数据?RPO = 24 小时,意味着每天备份一次,丢一天数据你认了;RPO = 5 分钟,意味着你需要近乎实时的日志复制。
RTO(恢复时间目标):出事时,服务最多能瘫多久?RTO = 4 小时,意味着从你发现事故到用户能正常用,整个恢复流程必须在 4 小时内跑完。
独立项目不需要照抄大厂的"四个九",但需要写下来。写不下来,等于没目标;没目标,等于出事时现场拍脑袋。给 vibe 项目的三档参考:
| 项目阶段 | RPO 建议 | RTO 建议 | 对应手段 |
|---|---|---|---|
| 玩具 / 副业验证期 | 24 小时 | 24 小时 | 每日自动全量备份,人肉恢复 |
| 有付费用户 | 1 小时 | 4 小时 | WAL 日志归档 + 每周自动恢复演练 |
| 核心收入 / 合规要求 | 5 分钟 | 1 小时 | 实时日志复制 + 一键故障转移 + runbook |
关键洞察:RPO 是由备份策略决定的,RTO 是由演练决定的。你把备份频率调到每小时一次,RPO 自然降到 1 小时;但 RTO 不靠调参数,靠你实际跑过几次恢复流程——第一次恢复永远比你想象的慢 3 到 5 倍。
故障场景矩阵:你以为的灾难 vs 真实的灾难
一提灾难恢复,很多人脑子里只有"机房着火"这种好莱坞剧情。但 vibe 项目的真实事故统计里(按我们观察到的独立开发者事故复盘),排名前五的根本不是天灾:
| 场景 | 典型触发 | 丢什么 | 恢复手段 |
|---|---|---|---|
| 误删 / 误操作 | Agent 跑了个 DROP TABLE;手滑删了生产 bucket | 部分或全部数据 | 时间点恢复(PITR)到事故前 5 分钟 |
| 逻辑错误 | 坏迁移把字段洗掉了;Bug 批量写坏数据 | 数据的"正确性" | PITR + 坏数据时间窗口定位;注意:最新备份里也有坏数据 |
| 勒索 / 密钥泄露 | AK 泄露到 GitHub,攻击者删库+删备份 | 数据 + 备份本身 | 异账号、不可变(immutable)备份;轮换所有密钥 |
| 区域级故障 | 云厂商某个可用区/区域挂了 | 服务可用性 | 跨区域只读副本 + 流量切换 |
| 供应商锁定 / 跑路 | 小众 BaaS 涨价、关停、改条款 | 整个技术栈 | 定期全量导出到开放格式;保持可迁移架构 |
看出来了吗?前两种(误删、逻辑错误)占真实事故的大头,而它们恰恰是"有备份也未必能恢复"的场景。逻辑错误的阴险之处在于:你的自动备份兢兢业业地把坏数据也备份了三份。这就是为什么恢复手段必须是 PITR(回到任意时间点),而不是"拿昨天的全量覆盖"——昨天的全量里可能早就躺着坏数据了。
而第三种场景(勒索/删备份)对应一条血泪规则:备份必须和生产环境不在同一个权限域。备份用的存储账号,要和生产账号分开;最好开启对象锁定(Object Lock),让备份在保留期内连你自己都删不掉——能防住手滑,也能防住拿到你密钥的攻击者,更能防住权限过大的 Agent。
工具链实战:四种常见栈的恢复方案
理论讲完,上硬货。按 vibe 项目最常见的四种数据栈,给出能直接抄的配置。
1. 自建 Postgres:pg_dump + WAL 归档(wal-g)
这是 RPO 能压到分钟级的经典组合。全量备份解决"从零恢复",WAL(预写日志)归档解决"回到任意时间点":
# 每日全量(cron)
0 2 * * * pg_dump --format=custom --file=/backups/db-$(date +\%F).dump $DATABASE_URL

# WAL 持续归档:postgresql.conf
archive_mode = on
archive_command = 'wal-g wal-push %p'
# wal-g 的存储后端指向异账号 S3,开启服务端加密
恢复时:先加载最近的全量,再按时间顺序重放 WAL 日志,在目标时间点停下。这就是 PITR。wal-g 还支持备份的完整性校验,跑 wal-g backup-list 能看到每个备份是否健康——把这个检查也塞进你的监控里。

2. 托管 Postgres(Supabase / Neon):把 PITR 开关打开,别只用默认
Supabase 和 Neon 都提供时间点恢复(Point-in-Time Recovery),但注意两点:第一,PITR 通常只在付费档可用,免费档的备份保留期很短——你的 RPO 目标如果是一小时,免费档的默认备份策略是撑不住的;第二,托管 PITR 保的是数据库,不保对象存储里的用户上传文件、也不保你的 Edge Function 配置,文件和配置要另做版本化备份。
Neon 有个独特优势是分支(branch)机制:恢复演练可以直接从某个时间点开一个分支出来验证,演练不污染生产,这是"验证层"的天然好工具。Supabase 则建议把 PITR 保留期和你的 RPO 对齐:保留 7 天意味着你最多能回到 7 天前的任意时间点——如果坏迁移是 10 天前上线的,PITR 也救不了你,逻辑错误的发现延迟本身就是 RPO 设计时要考虑的输入。
还有一个常被忽略的备份对象:数据库的访问凭证和连接拓扑。恢复出一个裸数据库只是成功了一半——应用要连上它,需要连接串、连接池配置、IP 白名单、VPC 对等连接。这些基础设施配置也要进版本控制(Terraform / Pulumi),否则你会在恢复现场花两小时翻聊天记录找连接串。灾难恢复恢复的不只是数据,是"数据 + 连上数据的路"。
3. SQLite(Turso / 本地文件):litestream
别小看 SQLite 栈——大量 vibe 项目跑的就是它。litestream 把 SQLite 的 WAL 实时复制到 S3,RPO 能到秒级,恢复就是重新下载 + 重放,一条命令的事:
# litestream.yml
dbs:
  - path: /data/app.db
    replicas:
      - url: s3://my-backup-bucket/app.db
# 恢复:litestream restore -o /data/app.db s3://my-backup-bucket/app.db
4. 对象存储与密钥:版本化 + 离线备份
用户上传的头像、生成的图片、导出的文件都在对象存储里:开版本控制(Versioning),误删文件可以找回任意版本;再配一条生命周期规则,把历史版本转到低成本存储。密钥和 .env 则走另一条路:加密后离线备份(1Password / Doppler 这类 secrets 管理器自带历史版本),千万别把生产密钥和代码一起塞进 Git——10-06 那篇已经讲过,这里不再展开。
一句话总结选型逻辑:你的 RPO 目标决定你要不要 WAL/实时复制;你的 RTO 目标决定你要不要一键恢复脚本和演练。目标写在前面,工具只是实现手段。
备份验证自动化:让机器替你点"恢复"按钮
前面说"没点过恢复按钮的备份都是纸",但人肉点按钮不可持续——这个月记得,下个月就忘了。正确姿势是:把恢复演练写成 cron,让机器每周替你点一次。
一个最小可用的自动演练脚本长这样(每周日凌晨跑):
#!/bin/bash
# restore-drill.sh — 自动恢复演练
set -e
STAMP=$(date +%F)
# 1. 从最新备份恢复到演练库(绝不碰生产)
pg_restore --clean --dbname=$DRILL_DB_URL /backups/db-latest.dump
# 2. 冒烟测试:核心表可读、行数在合理区间
psql $DRILL_DB_URL -c "SELECT count(*) FROM users;" | grep -q '[0-9]'
psql $DRILL_DB_URL -c "SELECT count(*) FROM orders WHERE created_at > now() - interval '30 days';"
# 3. 计时并上报:这就是你的真实 RTO 水位
echo "drill_ok duration=${SECONDS}s date=${STAMP}" | curl -X POST $METRICS_ENDPOINT -d @-
# 失败时 set -e 直接非零退出,cron 告警接住
注意三个细节:第一,演练库和生产库物理隔离,恢复演练的第一戒律就是别把演练搞成第二次灾难;第二,冒烟测试要查业务语义("最近 30 天有订单"),而不只是"表存在"——空表也能通过"表存在"检查;第三,把每次演练的耗时记下来,这就是你的 RTO 实测水位,画成曲线,三个月后你会感谢自己。
演练失败时不要只发告警,要回答三个问题:备份文件本身坏了?恢复步骤缺东西?还是耗时超了 RTO?每个答案对应不同的修复动作,修完下周接着验——在演练里失败是赚的,在真灾难里失败是赔的。
灾难恢复 runbook:一页纸模板
真出事时人的脑子是宕机的,runbook 就是给宕机的大脑准备的提词卡。它必须满足:凌晨三点被电话叫醒、半梦半醒之间也能照着做对。模板如下,抄走改吧改吧就是你的:
# 灾难恢复 runbook — <项目名>
RPO 目标:____  RTO 目标:____  最后演练日期:____

## 1. 判定(5 分钟)
- 症状:____(如:全站 500 / 数据明显不对 / 收到勒索信息)
- 先看监控面板:<链接>;确认是局部故障还是全挂
- 局部故障走常规排障,不要启动灾难恢复

## 2. 止血(10 分钟)
- 切只读降级开关:<环境变量/配置项>(保住读流量,停止写入扩大损伤)
- 在状态页/群里发公告:"我们正在处理数据问题,预计 X 小时恢复"

## 3. 选恢复点
- 误删/坏迁移:PITR 到事故前 5 分钟(命令:____)
- 勒索/备份被删:用异账号不可变备份(位置:____)
- 区域故障:切跨区域只读副本(连接串:____)

## 4. 恢复与验证(计时开始)
- 执行恢复命令:____
- 冒烟测试三件套:登录 / 核心读接口 / 最近 N 天数据行数
- 全部通过 → 切流量回写;任一失败 → 回滚到上一个恢复点重试

## 5. 收尾
- 关闭只读降级,恢复写入
- 填事故复盘表(见下节),24 小时内发出
- 更新本 runbook 里所有"实际耗时"和踩到的坑
runbook 有三条军规:命令要能复制粘贴(别写"恢复数据库"这种正确的废话);链接要是裸 URL(出事时你可能连书签栏都找不到);每次演练/事故后必须更新(过期的 runbook 比没有更危险,因为它给你虚假的安全感)。

故障转移与降级:先活着,再恢复
恢复需要时间,短则几十分钟,长则几小时。这段时间用户看到什么,决定了你是"出了一次事故"还是"失去了一批用户"。策略是:降级先行,恢复随后。
给 vibe 项目准备三档降级开关,按严重程度逐级开:
1. 只读模式:关掉所有写操作(下单、评论、上传),读流量正常。这是性价比最高的止血动作——用户能看、不能写,配合一句诚实的公告,大部分用户会等你。实现上建议用一个环境变量做总开关,而不是每个接口单独判断:
// 中间件:一行开关,全站进入只读
if (process.env.READ_ONLY_MODE === "1" && ["POST","PUT","PATCH","DELETE"].includes(req.method)) {
  return res.status(503).json({ error: "只读维护中,写入已暂停", retryAfter: 3600 });
}
这个开关要在平时就接好、演练时真开一次——出事现场才第一次写的降级代码,本身就是新的故障源。
2. 静态降级页:数据库彻底不可用时,CDN 上放一个静态状态页,告诉用户发生了什么、预计多久回来、去哪里看进展。一个写清楚的 503 页面,胜过十个超时的白屏。
3. 核心功能子集:如果你的产品有多个模块,先恢复最核心的那一个。比如内容社区先恢复"看帖",回帖和私信可以晚两小时——恢复也是有优先级的,runbook 里写清楚顺序。
降级开关本身也要演练:一个从来没打开过的"只读模式"开关,和没写过没区别。把它加进季度演练清单,开一次,确认写接口真的被拦住了,再关掉。
复盘表:每次演练或事故后填一张
灾难恢复能力的复利来自复盘。不复盘,同样的坑下次还踩。表格不用复杂,五个格子:
| 项 | 填什么 |
|---|---|
| 时间线 | 发现时间 → 判定时间 → 恢复完成时间,精确到分钟 |
| RPO / RTO 达标吗 | 实际丢了多少数据、瘫了多久,对照目标打勾或打叉 |
| 根因 | 连续问 5 个为什么,找到能修的那个 |
| 做得好的 1 件事 | 下次要保留的(比如 runbook 的某条命令一次跑通) |
| 下次改进的 1 件事 | 只列一件,列多了等于没列;指定负责人和截止日期 |
复盘有个反直觉的结论:演练的价值不在"通过",而在"失败"。一次全绿的演练只证明了上周的配置是对的;一次失败的演练告诉你下周要修什么。所以别追求演练通过率 100%,追求"每次演练都发现一个真问题"。
我们怎么看:恢复能力是 vibe 项目的成人礼
vibe coding 让一个人一天搭出一个产品,但"搭出来"和"能负责"之间,差的就是灾难恢复这套东西。用户把数据交给你,信任的不是你的备份 cron,而是出事时你能把他们的数据找回来。
算笔账:wal-g + 异账号 S3 存储,一个月几美元;每周自动演练,机器跑,你只看告警;一页纸 runbook,写一次,季度更新。这套东西的总成本,不到你一个月咖啡钱的零头。而它防住的,是那种"删库→用户流失→口碑崩塌→项目死亡"的连锁反应。
最后送一句这篇最想让你带走的话:这个周末花 30 分钟,从备份里恢复一次你的数据库。如果一次跑通,恭喜你,你的 RTO 是真实的;如果跑不通,恭喜你,你用 30 分钟买到了真灾难那天最贵的东西——提前知道。
备份是成本,恢复是能力。从今天起,做一个有恢复能力的人。
评论 (0)
相关文章
导入是脏数据入口,导出是数据主权出口。本指南讲透导入三段式(暂存、校验预览、确认导入)、五类校验引擎、幂等 upsert、流式导出、异步队列加签名链接,以及十条反模式清单,附可直接复制的 TypeScript 代码。
Web Push 看似半小时能跑通,上线后全是坑:iOS 收不到、VAPID 报 401、订阅表越养越肥。这篇代码续集带你走完完整链路——VAPID 密钥生成与保管、权限申请的最佳时机、Service Worker 推送接收与点击处理、服务端 web-push 实战、iOS 16.4 适配、410 过期订阅清理与排错清单,所有代码均可直接落地。
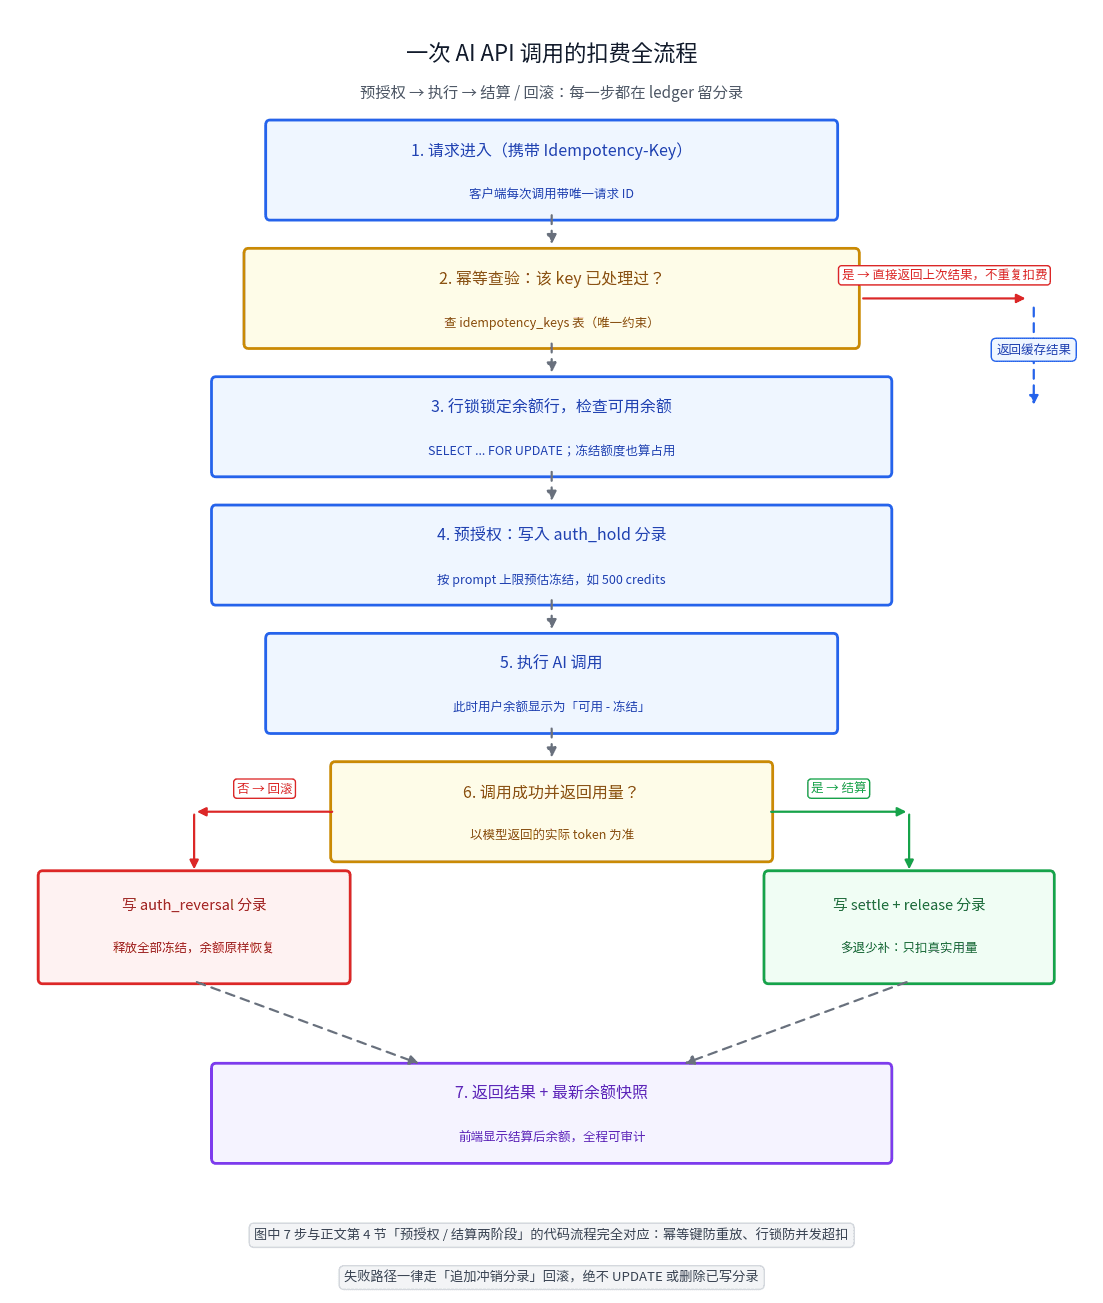
用户的 credits 不是一个余额字段,而是一本账。这篇指南为 AI SaaS 打造复式记账式积分账本:可直接抄的不可变流水表结构、幂等键 + 行锁的并发扣减、应对 token 用量不可预测的预授权/结算两阶段、退款与过期的回写规则、三方每日对账、负余额熔断,以及防薅清单。