版本号别再随手写:语义化版本与自动化发版实战
1.2.3 涨成 2.0.0 还是 1.3.0,只看公共 API 变了什么。本文按 semver.org 规范与 Changesets 官方文档讲三位数字的涨法、预发布排序、breaking 判定清单、Changesets 三步循环与约定式提交的取舍,附发错版的补救办法。
先把这篇的边界说清楚。站里已经有几篇讲“发版”的指南,但讲的都不是这篇的东西。《变更日志写作指南》讲的是 changelog 怎么写才有人看,其中顺带提了三句话,讲版本号按语义化版本来定;这篇讲的就是版本号本身怎么定、定了之后发版怎么一步步走。《发布说明写作指南》讲的是 release notes 的写法;《API 版本管理与废弃 SOP》讲的是对外 API 的版本策略、废弃公告和迁移期;《CI/CD 最小流水线指南》讲的是代码从提交到上线怎么跑起来。这篇讲的是它们中间缺的那一段:从“这次改动算什么版本”到“版本号涨上去、包发出去、tag 打上去”的完整发版动作。写 changelog 是告诉用户“这次变了什么”,这篇是保证“这次变的版本号没写错、发版的步骤没漏掉”。
下面用到的“tiny-table”是一个虚构的练手项目:一个把表格转成 Markdown 的 npm 小库,只有一个包、一个作者。本文所有以它为例的版本号、提交记录和发版命令,都是为了讲清楚做法编出来的,不是真实记录。所有关于语义化版本的规则,都来自 semver.org 的官方规范;所有关于 Changesets 的流程,都来自 Changesets 的官方文档,来源见每篇的 meta 信息与 evidence 记录。
先定义公共 API,再谈版本号
语义化版本规范的第一条就写得很死:用 SemVer 的软件,必须先声明一个公共 API。这个 API 可以写在代码里,也可以只写在文档里,但必须清楚、完整。为什么先有 API 才有版本号?因为版本号的每一位,衡量的都是“公共 API 变了没有、怎么变”。没有公共 API,MAJOR、MINOR、PATCH 就没有衡量的对象,版本号就退化成了一个随手写的数字。
对一个 npm 小库来说,公共 API 就是它导出的东西:导出的函数名、参数、返回值、抛出的错误、配置文件里用户会填的字段。对一个网站、一个 App 来说,公共 API 是另一副面孔:用户看得见的界面、对外提供的接口、保存下来的文件格式、别人依赖的链接地址。先把这张清单写下来,贴在 README 或者仓库的显眼处——这张清单,就是你以后每次发版前要对照着打勾的东西。
规范还写了一句经常被忽略的话:版本号一旦发布,这个版本的内容就不许再改。发现 1.2.0 里有个 bug,哪怕只是改一个错别字,也要发 1.2.1,不能回去把 1.2.0 的包偷偷换掉。已经装了 1.2.0 的用户、已经锁了 1.2.0 的 lockfile,凭什么相信一个被改过的 1.2.0 和他们手里的是同一个东西?版本号是用户和你之间的一个约定:同一个号,永远是同一份内容。改内容,就换号。
三位数字怎么涨:MAJOR、MINOR、PATCH
版本号是 X.Y.Z 三位:MAJOR 是第一位,MINOR 是第二位,PATCH 是第三位。规则只有三条,背下来就能用:只修 bug、而且修法向后兼容,涨 PATCH;加了新功能、而且是向后兼容的,涨 MINOR;改了公共 API、而且不向后兼容,涨 MAJOR。涨一位的时候,右边的位要归零:从 1.2.3 加了一个不兼容的改动,变成 2.0.0;从 1.2.3 加了一个兼容的新功能,变成 1.3.0。还有一条容易写错的:三位都是按数字比大小,不按字符串比——1.9.0 之后是 1.10.0,不是 1.9.0 的下一个“1.9.1”。
三条规则里最容易踩坑的是第一条和第二条的边界。“修 bug”涨 PATCH 的前提,是这个 bug 的修复没有动公共 API。修了一个函数内部算错的数,涨 PATCH;修 bug 顺手把函数的参数改了,那就不是 PATCH,是 MAJOR。第二条也有一个经常被漏掉的细节:把某个公开功能标记为“已废弃”,也要涨 MINOR——因为“废弃”本身就是一次对公共 API 的改动,哪怕功能本身还能用。规范还留了一个口子:如果只是在私有代码里做了大的改进,也可以涨 MINOR;但这条是“可以”,不是“必须”,别拿它当借口,把本该涨 PATCH 的修 bug 写成 MINOR。
0.y.z 是给“还在起步”的项目留的。规范写得直白:大版本是 0 的时候,公共 API 被认为是不稳定的,什么都可能变。实操上最省事的做法,是从 0.1.0 起步,每发一个版本就把 MINOR 加一:0.1.0、0.2.0、0.3.0……等到 API 稳下来、有人真的在生产里依赖你了,就发 1.0.0。规范的 FAQ 里有一句话值得贴在墙上:如果你的软件已经在生产里被人用了,它大概率早就该是 1.0.0 了;如果你整天在担心向后兼容,它也大概率早就该是 1.0.0 了。0.x 不是“永远不用负责”的挡箭牌,拖着不发 1.0.0,只会让用户不知道你到底稳不稳。
预发布版本是给“还没准备好叫正式版”的版本留的。在 PATCH 后面加一个连字符,再加一串由点分隔的标识符:1.0.0-alpha、1.0.0-alpha.1、1.0.0-beta、1.0.0-rc.1。排序有一条完整的链,规范直接给了例子:1.0.0-alpha < 1.0.0-alpha.1 < 1.0.0-alpha.beta < 1.0.0-beta < 1.0.0-beta.2 < 1.0.0-beta.11 < 1.0.0-rc.1 < 1.0.0。注意三点:预发布版永远比它对应的正式版小;纯数字的标识符按数字比(beta.2 < beta.11,别按字符串比,字符串比会得出 beta.11 < beta.2 的错结论);数字标识符永远比带字母的小。构建元数据是另一回事:在版本号后面加一个加号,比如 1.0.0+20130313144700,写的是构建信息,排序的时候完全忽略它——1.0.0+001 和 1.0.0 的优先级是一样的。
什么算 breaking:发版前先打勾的判定清单
“不向后兼容”这五个字,写在规范里只有一行,落到代码里却有十几种样子。发版之前,对着下面这张清单逐条打勾,有一条中了,这次就是 MAJOR。
第一类是删东西:删掉一个导出的函数、删掉一个配置项、删掉一个命令行参数、删掉一个用户依赖的接口。删了,用户原来的代码就跑不起来了,这是最直接的 breaking。第二类是改签名:函数多了一个必填参数、少了一个参数、参数换了位置、返回值从对象变成数组。第三类是改行为:同一个输入,以前返回 A,现在返回 B;以前不抛错,现在抛错;以前默认开着的功能,现在默认关了。第四类是改格式:配置文件换了字段名、保存的文件换了结构、对外接口的响应字段改了名。第五类是升级依赖:你的库依赖的另一个库升了大版本,而且那个大版本本身就是不兼容的,你的用户间接受到了影响。
还有三类是 vibe coding 的项目里最常见的。第一类是“顺手重构”:让 AI 把代码整理了一遍,导出名字没变,但某个函数的参数顺序被调换了、某个错误信息的文字被改了——错误信息的文字也是公共 API 的一部分,有用户的代码在按文字匹配错误。第二类是“修 bug 修过了头”:用户已经依赖了那个 bug 的行为,比如某个函数在边界情况下返回空数组,用户代码里写了“如果是空数组就跳过”,你把 bug 修成返回报错,用户的跳过逻辑就永远走不到了。第三类是“改默认值”:分页默认从 10 条改成 20 条、超时默认从 5 秒改成 30 秒,看起来是小事,但依赖默认值的用户,行为全变了。
判定清单的用法是:每次发版之前,先写一句话说明“这次改动里,公共 API 哪一条变了”,再对照清单打勾。写不出来这句话,或者写出来发现清单里有一条中了,就别犹豫,直接 MAJOR。版本号涨错的代价是不对称的:MINOR 错写成 MAJOR,用户最多晚一点升级;MAJOR 错写成 MINOR,用户的代码会在升级之后悄悄坏掉,而且坏掉的时候不会有人想到是版本号撒了谎。

Changesets 工作流:让写 changelog 的人来定版本号
版本号定下来了,下一个问题是:谁来定、什么时候定。Changesets 的答案是:让改代码的人在改代码的时候就定下来。一个 changeset 就是两条信息:这次改动按 semver 算什么版本类型,以及要写进 changelog 的一句话。改代码的人最清楚这次改动是 breaking 还是新功能还是修 bug,让他当场写下来,比发版那天再翻提交记录去猜要准得多。
整个循环只有三步。第一步,改代码的时候顺手加一个 changeset:跑 npx @changesets/cli,它会问你改了哪个包、算什么版本类型、changelog 里写一句什么话,问完在 .changeset 目录下生成一个 Markdown 文件,跟着代码一起提交。第二步,准备发版的时候跑 changeset version:它会把所有攒着的 changeset 消费掉,按里面写的版本类型把每个包的版本号涨上去,同时把每条 changelog 信息写进各包的 CHANGELOG.md。第三步,检查一遍涨上去的版本号和写好的 changelog,确认没问题了再跑 changeset publish:它会对每个比 npm 上已有的版本新的包跑 npm publish。
装起来也很简单。官方文档给了两条命令,二选一:yarn add -D @changesets/cli && yarn changeset init,或者 npx @changesets/cli init。初始化之后,仓库里会多一个 .changeset 目录和一份 config.json。官方文档还写了一个很容易被忽略的建议:version 和 publish 这两步可以放进 CI 里跑,但 version 跑完之后、publish 之前,一定要留一个人工检查的口子——看一眼涨上去的版本号对不对、changelog 里的话写得像不像人话。自动化是把“动手”的部分自动化,不是把“动脑”的部分也自动化。
Changesets 最初是为 monorepo 设计的,这一点在单包项目里看不出来,在多包仓库里才是它真正值钱的地方:如果 A 包的改动是 breaking,而 B 包依赖 A 包,Changesets 会顺手把 B 包依赖的 A 的版本也 bump 上去,不用你一个个包去算依赖关系。反过来,它也写明了一条纪律:不是每次改动都要写 changeset。只改了测试、只改了文档、只改了内部脚本,这些不需要发版也不需要进 changelog 的改动,不写 changeset——官方文档的原话是,不要为了“没有 changeset 就不让合”去卡贡献者,changeset 只服务于发版和 changelog。
单包最小落地:一页纸的发版 SOP
如果你的项目只有一个包、不用 monorepo,Changesets 的三步循环照样能用,但也可以先从更轻的“一页纸 SOP”起步。SOP 只有五行:第一,改代码,提交信息里写清楚改了什么;第二,对照判定清单,定这次是 MAJOR、MINOR 还是 PATCH;第三,改 package.json 里的 version 字段,数字按规则涨;第四,在 CHANGELOG.md 里加一段,写这次变了什么、谁会受影响;第五,打 tag、发包、写 Release:git tag v1.3.0 && git push --tags,npm publish,再去 GitHub 上建一个 Release、把 CHANGELOG 里那段话贴进去。
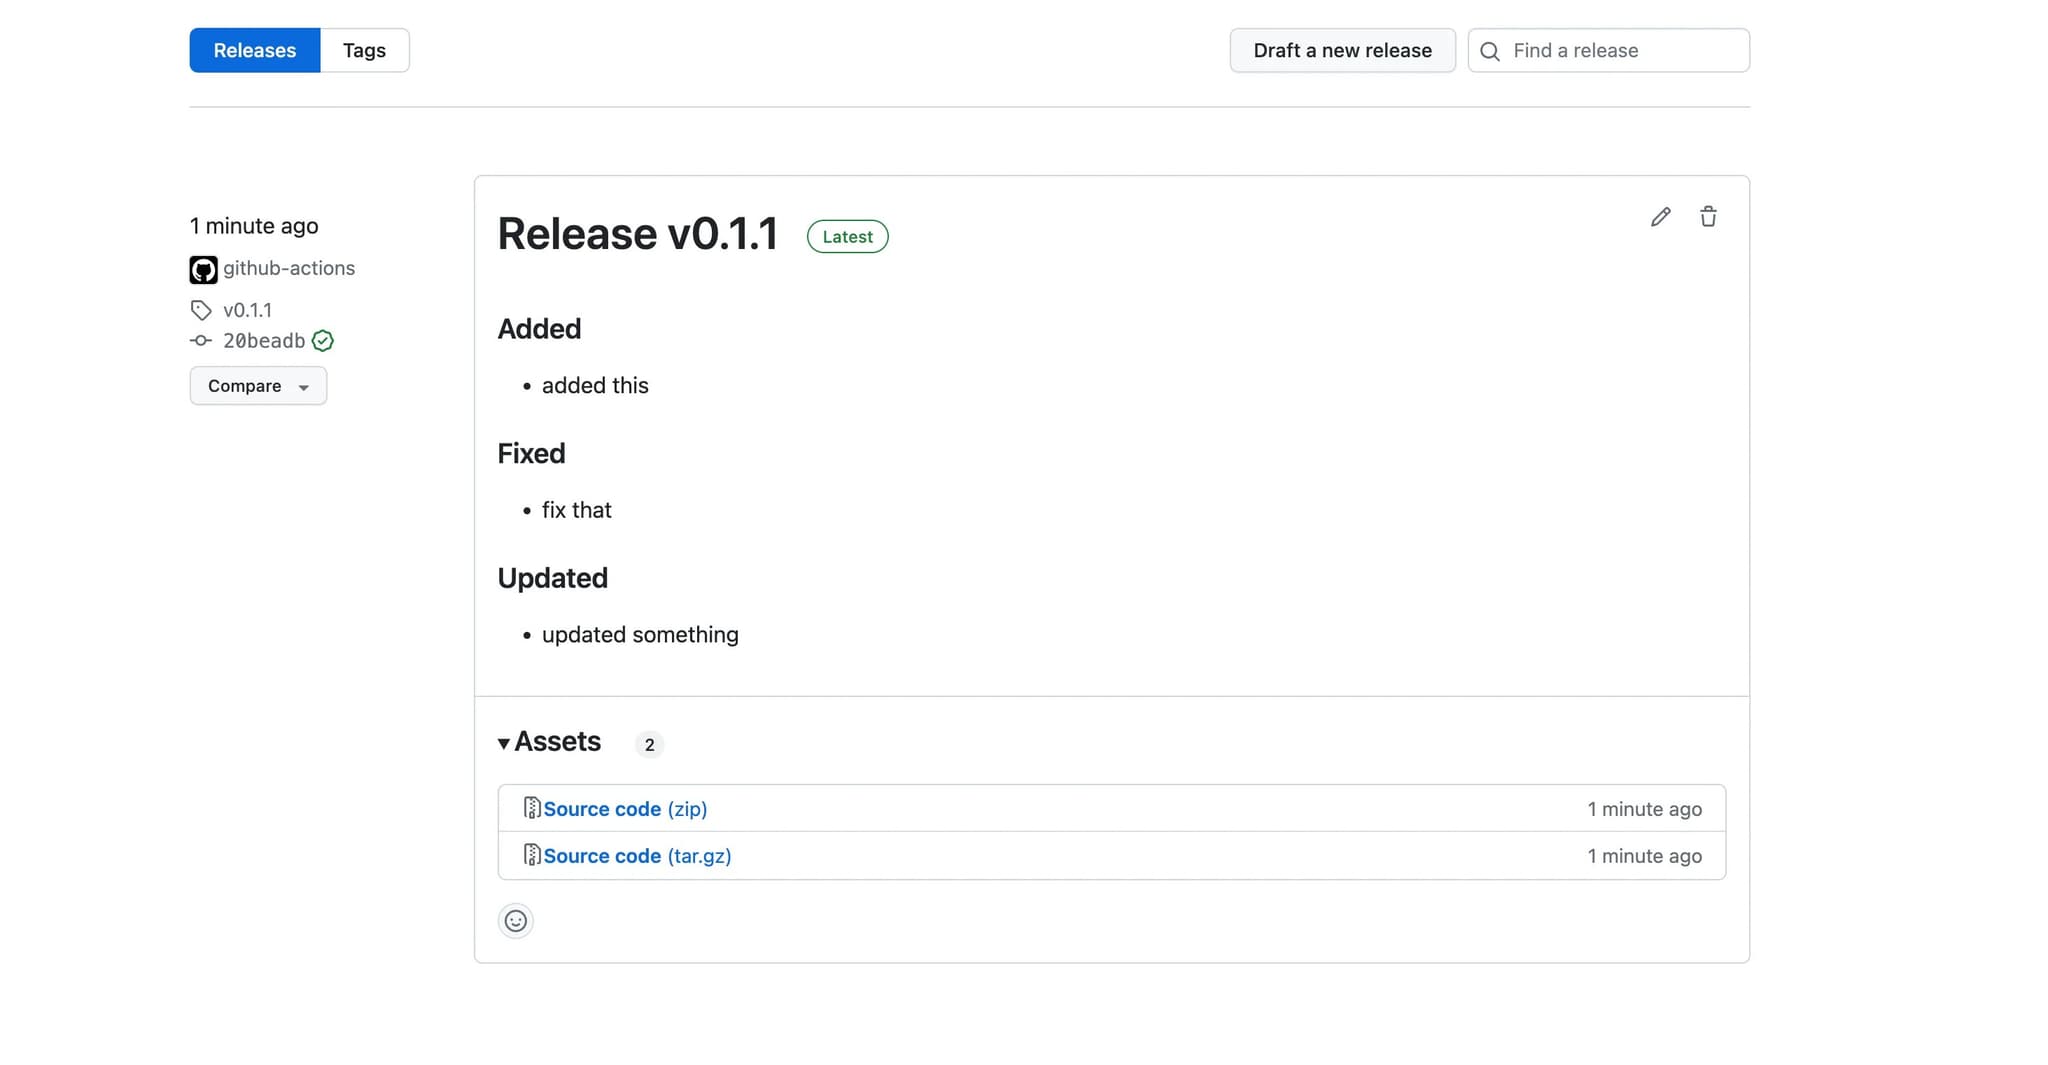
这五行里最容易漏的是第四行和第五行里的“写 Release”。很多人发版只发包、不写 Release,用户只能去翻 CHANGELOG 或者翻提交记录。Release 是用户看发版的第一现场:标题写版本号,正文写这次变了什么、breaking 的改动怎么迁移。站里的《发布说明写作指南》已经把 Release 的写法讲透了,这里只记一条:发版不写 Release,等于发了版没告诉任何人。
等这五行跑顺了,再把 Changesets 接进来,替换掉 SOP 里的第二、第三、第四行:版本号不再手改,changeset version 会按 changeset 里写的类型自动涨;CHANGELOG 不再手写,changeset version 会把 changeset 里的话自动写进去。你要做的只剩下第一行(改代码时顺手加 changeset)和第五行(检查完就 publish)。从手写 SOP 到 Changesets,变的只是“谁来算版本号、谁来写 changelog”,发版的顺序和检查点一个没少。
两条自动化路线:Changesets 还是约定式提交
发版自动化有两条主流路线,选哪条取决于你的项目长什么样。第一条是 Changesets:人写 changeset,机器按 changeset 办事。版本号的决定权在改代码的人手里,机器只负责执行。第二条是约定式提交加 semantic-release:人不写 changeset,机器读提交信息来定版本号——提交信息写 feat: 开头就是 MINOR,写 fix: 开头就是 PATCH,写 BREAKING CHANGE: 就是 MAJOR,机器读完自动涨版本、自动写 changelog、自动发包。
两条路的差别不在“自动多少”,而在“决定权在谁手里”。Changesets 把决定权留给人:改代码的人当场判断这次算什么类型,判断错了,检查 changelog 的时候还能改回来。约定式提交把决定权交给提交信息的格式:格式写对了,全程不用人管;格式写错了,版本号就跟着错——而且错的时候你往往要到发版之后才发现。单人小项目、提交信息一直写得很规矩的,用约定式提交最省事;多包 monorepo、或者团队里每个人的提交习惯不一样的,用 Changesets 更稳,因为它不依赖所有人把提交信息写成同一个格式。
还有一条判断标准:你的项目有没有“公开 API”之外的发版内容。Changesets 的 changeset 里除了版本类型,还能写一句人话进 changelog;约定式提交的 changelog 是机器从提交信息里拼出来的,人话的味道要淡得多。如果你的用户会认真读 changelog、会按 changelog 决定要不要升级,Changesets 的人话更值钱;如果你的用户只看版本号、升级全靠 lockfile,约定式提交的省事更值钱。两条路都能跑通,选一条、跑到底,别在同一个仓库里混着用——混着用的结果是:同一份改动,Changesets 说是 MINOR,提交信息说它是 PATCH,两个人说了两种话。
预发布通道:别把测试版推成最新版
新功能想先给一部分人试试,别直接发正式版,走预发布通道。做法分两层:版本号那层,发 1.3.0-beta.1、1.3.0-rc.1 这种带预发布标识的版本;分发那层,npm 上用 dist-tag 把它挂在 next 或者 beta 下面,别挂在 latest 下面。挂在 latest 下面,等于告诉全世界“装最新版就是装这个”,用户 npm install 一下就装到了一个还没准备好的版本。
GitHub Release 那边也有对应的开关:新建 Release 的时候,有一个“Set as a pre-release”的复选框,勾上它,这个 Release 就会被标成非生产就绪。正式版发的时候再勾“Set as the latest release”。这两个复选框看着小,管的是同一件事:别让一个测试版在用户面前冒充正式版。预发布版的测试期也别拖太久:beta 超过一个月没人反馈,问题不在测试的人太少,而在测试的版本本身没人关心——要么直接发正式版,要么承认这个功能不值得发。
还有一个细节:预发布版的版本号涨法。1.3.0-beta.1 修了个 bug,下一版是 1.3.0-beta.2,不是 1.3.1-beta.1;等到 beta 测完了、要发正式版了,才是 1.3.0。预发布标识后面的数字,只在同一个预发布系列里涨;正式版的 PATCH 位,要等正式版发出来才动。这个顺序写错了,用户会看到 1.3.1-beta.1 这种版本号,完全看不懂它和 1.3.0 是什么关系。
发错了怎么办:别改已发布的版本
发错版本是每个维护者都会遇到的事,处理办法只有一条:别动已经发出去的那个版本。规范写得斩钉截铁:已经发布的版本,内容不许改;改了,就要发新版本。发错的常见情况有三种,处理办法各不相同。
第一种,把不兼容的改动发成了 MINOR。规范的 FAQ 给了标准答案:马上发一个新的 MINOR 版本,把不兼容的地方改回去、恢复向后兼容。注意,是“恢复兼容”,不是“把版本号改成 MAJOR 再发一遍”——已经发出去的那个 MINOR 版本,版本号已经错了,错了就错了,补救的办法是让代码重新变回兼容的,而不是去改历史。第二种,发出去的版本有个严重 bug。处理办法一样:修 bug,发一个 PATCH 版本,CHANGELOG 里写清楚“这个版本修了上个版本的问题”。第三种,发出去的包根本不能用、或者发错了包。npm 上可以跑 npm deprecate 给那个版本打一个“不建议用”的标记,GitHub Release 的文字可以编辑、可以补充一句“这个版本有问题,请用更新的版本”,但 tag 指向的提交、包里的内容,都别动。
删包重发同号,是最不能碰的红线。npm 对删包有自己的限制,删了重发同号在很多情况下根本不被允许;就算技术上能做到,已经装了旧包的用户、已经锁了版本号的 lockfile,都会因为“同一个号、两份内容”而对不上。发错了就认错、发新版,用户对“发错了又发了一个修正版”的容忍度,远高于对“同一个版本号今天和昨天不是同一个东西”的容忍度。
五个反模式
反模式一:版本号随心情涨。今天觉得改动挺大就涨 MINOR,明天觉得差不多就涨 PATCH,后天高兴了直接跳到 2.0.0。版本号不是心情指数,是公共 API 的变化记录,涨法只看判定清单,不看感觉。
反模式二:修 bug 涨 MINOR、加功能涨 PATCH。修 bug 涨 PATCH,加功能涨 MINOR,这两条写反了,用户从版本号里读到的信息就全错了:以为是修 bug 的升级,装完发现多了新功能;以为是加功能的升级,装完发现只是修了个 bug。版本号撒一次谎,用户以后就再也不看版本号了。
反模式三:breaking 改动发 PATCH。这是最贵的一种错。用户的 lockfile 里写着“PATCH 可以自动升”,结果一次 PATCH 升级把他的代码升坏了。所有 breaking 改动,不管多小,都是 MAJOR,没有例外。
反模式四:改已发布的 tag 和包。发现 tag 打错了、包里多个文件,回去改 tag、重新发同号的包。tag 和包一旦发布,就是历史记录,改历史的代价是让所有已经拿到旧版本的人手里的东西都对不上号。错了就发新版,别改历史。
反模式五:发版不写 changelog、不写 Release。版本号涨上去了,包发出去了,用户不知道这次变了什么、要不要升级、升级要注意什么。发版的最后一公里是“告诉用户”,不是“把包推出去”。CHANGELOG 里那段话,和版本号本身一样重要。
检查表:下次发版前过一遍
发版之前:公共 API 清单写好了吗?这次改动对照判定清单,算 MAJOR、MINOR 还是 PATCH?0.x 的项目,这次是不是该发 1.0.0 了?预发布版挂在 next 下面了吗、没挂在 latest 下面吧?
发版的时候:changeset 写了吗、版本类型写对了吗?changeset version 跑完之后,版本号和 CHANGELOG 检查过了吗?npm publish 之前,确认要发的包比 npm 上的新吗?tag 打上去了吗、Release 写了吗?
发版之后:去一台干净的机器上 npm install 一次,确认装到的是新版本;打开 Release 页面,确认正文写的是这次的改动、不是上次的;如果这次是 MAJOR,迁移说明写了吗、旧版本的 deprecate 标记打了吗?版本号、changelog、tag、Release,四样东西对得上,这次发版才算发完了。发版不是把包推出去就结束了,是让用户能装上、能看懂、能决定要不要升——这四件事都做到了,版本号才算真正有了意义。
评论 (0)
原始来源
相关文章
2026 年 11 月 10 日,Amp 推出 Boxes:每月 18 美元起的常开小电脑,专门部署你用智能体造出来的软件。每个 box 自带 runner,智能体能直接在上面改生产数据;同一周 Amp 还上线了 Spaces、告别了 Dial、登陆了 Windows——智能体的工作场,正在从笔记本搬到云端。

localStorage 只能存字符串、没有索引。IndexedDB 是浏览器里真正的数据库:能存结构化数据、容量大得多、能建索引、能用事务。本文按 MDN 的《Using IndexedDB》《IDBDatabase》《IDBObjectStore》三篇官方文档讲清楚:五步套路、开库、升级、主键、索引、事务、add 与 put、get、游标、范围与多标签页升级。

函数你每天都在调,这篇把你一直在做的事讲清楚。本文按 MDN 的《Functions》《Arrow function expressions》《Rest parameters》三篇官方文档讲清楚:声明与表达式、参数与实参、默认值、剩余参数、展开语法、返回值、箭头函数省写规则、this 的坑、回调与高阶函数、作用域。