指南
Agent 的 7 种死法:从无限循环到自信胡说,一份失败模式图鉴每个用 Agent 写过代码的人都见过:它卡在同一个错误里转圈、它自信满满地交出一份全错的方案、它悄悄删了你的文件。Agent 的失败不是随机的,是有固定套路的。本文整理 7 种最常见的死法,每种配症状、根因和一句话对策。
开发工作流工具技巧AI 编程实践
VIBEFIX EXPLORE
从实战指南到工具资讯,把值得沉淀的创作经验和行业变化整理成可复用的内容。
每个用 Agent 写过代码的人都见过:它卡在同一个错误里转圈、它自信满满地交出一份全错的方案、它悄悄删了你的文件。Agent 的失败不是随机的,是有固定套路的。本文整理 7 种最常见的死法,每种配症状、根因和一句话对策。
Agent 重度用户每月账单 60 到 200 美元,但一半的钱花在了不值得的任务上。本文给出一套模型路由实战规则:什么任务配什么模型、怎么设置自动降级、以及三个立刻能省 40% 的具体做法。省下来的不是小钱,是你下个月的服务器预算。
你的 Agent 可能在不知不觉中把 GPL 代码粘进你的闭源项目——而「是 AI 写的」在法庭上不是辩护理由。本文讲清 AI 生成代码的许可证风险到底在哪:训练数据的传染、Copilot 官司的现状、以及一份独立开发者今晚就能跑完的合规自查清单。
10 月 4 日 Axios 独家爆料:由两位前 DeepMind 研究员创立、Nvidia 参投的 Reflection,准备在本月发布首个开源权重基础模型,直接对标 DeepSeek 和 Qwen。公司已锁定 2029 年前超 70 亿美元算力。但先别开香槟:模型名字、参数量、许可证、跑分,一个都没公布。
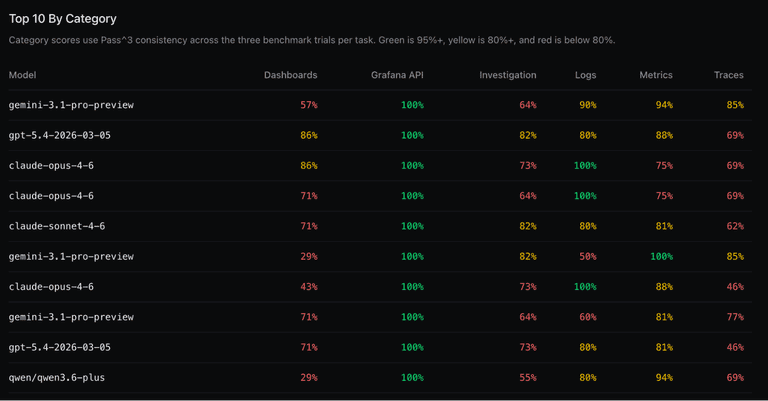
10 月 2 日更新的 SWE-bench Pro 显示,Claude Opus 5.5 以 89.9% 领跑,Sonnet 5.5(81.3%)和 Claude Fable 5.1(81.2%)紧随其后。但别急着下单:OpenAI 今年 7 月的审计估计,这个基准公开题集里约 30% 的题目是坏的,连榜单维护方自己都说别拿它做购买决策。
10 月 5 日 AWS 官方确认:Bedrock Managed Agents 公开预览——OpenAI 的 Agent 技术栈第一次完整跑在微软之外的云上。Agent 的推理、工具调用、记忆全部留在客户自己的 AWS 账户里,用 IAM 身份和权限管起来。过去七年,想在生产环境用 OpenAI 模型就得走微软的云,这条铁律被打破了。
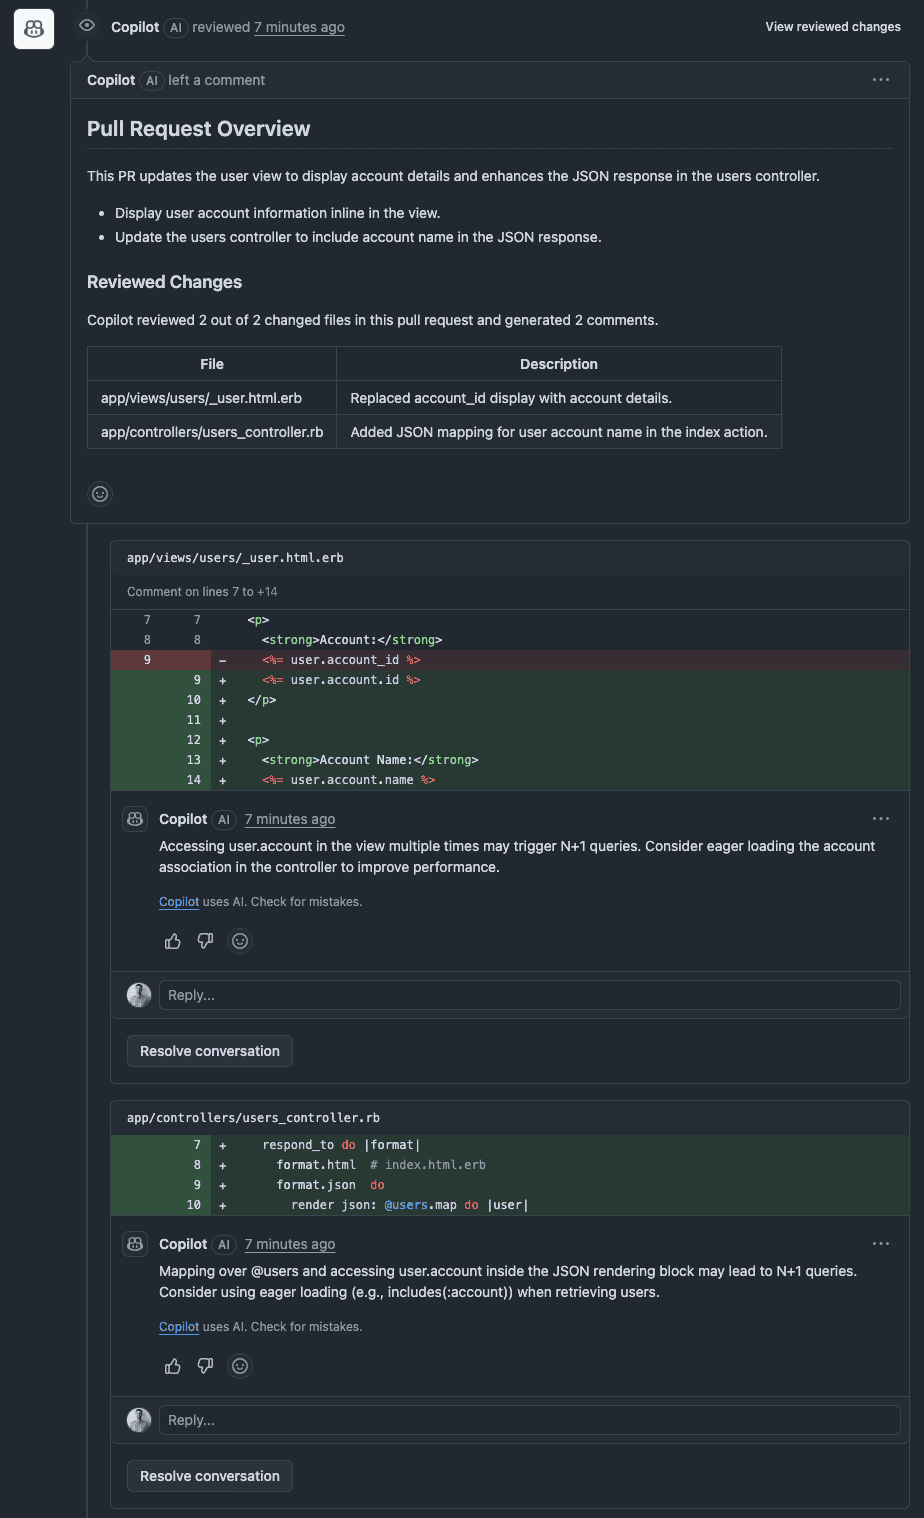
10 月 2 日,GitHub 在 changelog 里宣布:Copilot 代码评审现在可以通过 REST 和 GraphQL API 触发,还能为每次请求单独设定评审力度。同时,Balanced(均衡档)成为新的默认力度,替代了 Lite。这意味着代码评审从「编辑器里的按钮」变成了「流水线里可编排的一步」。
只要你的应用把用户输入喂给 AI,有人就能用一句话让它「忘记之前的指令」。这不是理论:2026 年真实攻击里,Agent 被网页里的隐藏指令劫持、被文档里的恶意 prompt 套出系统提示。本文讲清注入的三种形态和四层防御,vibe 应用上线前必读。
10 月 1 日,GitHub 宣布 Copilot Computer Use 进入公开预览:Copilot CLI 和桌面 App 现在能直接看屏幕、点控件、打字、滚动、跨窗口操作。目标很明确——那些没有 API、没有命令行、连 MCP 都没有的「老古董」专业软件。功能默认关闭,每次接管应用前都要你点头。
AI 把编码成本压低了十倍,也把调研成本压低了十倍。本文给一人开发者一份可复制的竞品调研工作流:上午画竞品地图、下午跑 12 个对比维度、晚上输出一页纸决策——以及为什么它最大的价值是告诉你「什么不做」。
让 agent 重构祖传代码,最大的风险不是它写错代码,而是它删掉正确的代码——那些承载着血泪教训的冗余。本文给出 5 条军规:先建安全网、切片小到可回滚、让 agent 当考古学家、锁定行为不锁定实现、把隐性知识写下来,另附重写 vs 重构的判断框架。
Agent 时代最大的浪费不是模型不行,是人没把意图说清楚就让 agent 开工。本文给出 Spec-Driven 开发的完整方法论:一份能驱动 agent 的规格 5 件套、Spec→Plan→Task→Verify 开发循环、4 条铁纪律,以及什么时候不值得写规格的诚实判断。