别让用户盯着转圈看:AI 应用流式输出的 UX 实战手册
流式输出不是把字一个个吐出来那么简单。从三种输出形态的决策表,到 TTFT 首字时间优化、可打断的停止按钮状态机、流中断的三级降级,再到长文本渲染不卡顿的四个技巧与取消重发的计费规则——这篇实战手册把 AI 应用流式体验拆成可逐项落地的工程清单,并点名三个最常见的反模式。
AI 应用的回答是怎么"长出来"的,直接决定了用户愿不愿意等。一个需要 20 秒才能出结果的生成任务,用整段返回用户大概率在第 5 秒就关掉了;换成流式逐字输出,同样 20 秒,大多数人会耐心看完。这不是玄学,是感知延迟的工程问题。本文不谈模型能力,只谈传输形态:三种输出形态怎么选、首字时间怎么压、可打断怎么做、流断了怎么降级、长文本怎么渲染不卡——全部是能直接落代码的实战经验。
三种形态:先选对,再谈优化
所有 AI 输出的呈现方式,归根结底只有三种。选错形态,后面一切优化都是裱糊。
整段返回:结果一次性到位
后端等模型生成完,把完整文本一次返回,前端整体渲染。这是最被低估的形态——很多人觉得"都 2026 年了还不用流式",其实整段返回在三个场景里是更优解:短答案(一两句话的问答,流式的 overhead 反而让体验更碎)、需要全文后处理的结果(生成代码后要整体做语法高亮、生成表格后要一次性排版,流式中途渲染半成品反而难看)、确定性 / 可缓存内容(翻译、摘要模板,命中缓存时整段返回就是最快的)。它的代价很明确:TTFT(首字时间)等于总生成时间,用户在等待期看到的只有 loading。
打字机逐字:对话场景的默认答案
token 级流式,前端收到一个 token 追加一个。这是对抗"等待焦虑"最有效的形态:用户在 1 秒内看到第一个字,大脑就把"等待结果"切换成了"阅读过程",忍耐度直接翻倍。适合开放式对话、创意写作、解释说明类长回答。但它有两个隐性成本:第一,渲染压力,高频 setState 会让低端机掉帧(解法见第五节);第二,半成品尴尬,markdown 表格、代码块在流式中途是残缺的,用户会看到一闪而过的乱码——能接受就用,不能接受就换下一种。
结构化分块渲染:长文档的体面做法
按语义块(段落、标题、代码块、表格)为单位流式输出:后端可以按块 flush,前端收到完整一块再渲染一块。适合生成报告、教程、带代码的长回答。体验上比逐字更"稳"——用户看到的永远是排版完整的块,不会有半截表格;又比整段快得多——第一块通常几秒就到。代价是实现复杂度最高:需要后端配合分块协议(比如每块带 block_id 和 block_type),或者前端做增量 markdown 切分。
决策表
| 形态 | 首字感知 | 适合场景 | 别用在 | 技术要点 |
|---|---|---|---|---|
| 整段返回 | 慢(=总耗时) | 短答案、可缓存结果、需全文后处理 | 超过 5 秒的生成 | 超时兜底 + loading 状态设计 |
| 打字机逐字 | 快(<2s 可做到) | 对话、创意写作、解释类长回答 | 含大量表格/代码的严肃文档 | SSE + 渲染节流 |
| 结构化分块 | 中(首块 2-4s) | 长报告、教程、混合排版内容 | 短平快的问答 | 分块协议 + 增量解析 |
判断标准就一条:用户要"读过程"还是"要结果"。读过程用流式,要结果用整段。拿不准的时候,记住这条经验线:生成超过 5 秒,流式几乎总是更优;3 秒以内,整段返回的简单可靠压倒一切。
TTFT:把"多久开始冒字"当核心指标
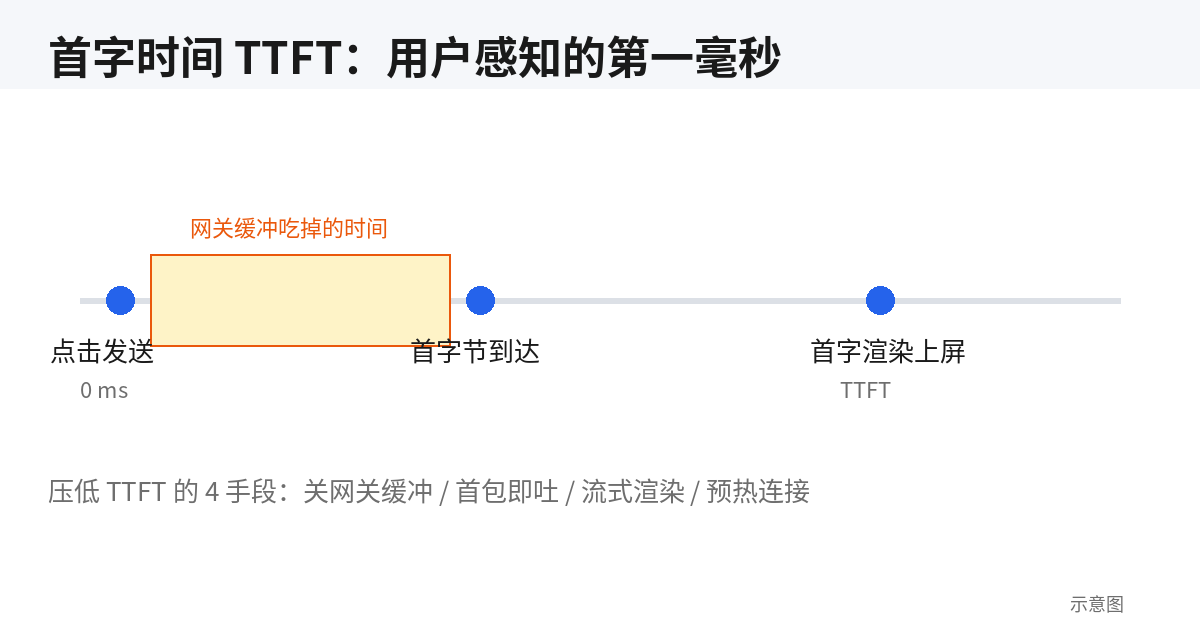
TTFT(Time To First Token)指从用户点击发送,到屏幕上出现第一个可见字符的时间。它是流式体验里唯一值得死磕的数字,原因很现实:用户对"没反应"的忍耐极限大约是 2~3 秒(纯 loading 状态下),一旦第一个字冒出来,忍耐极限会延长到几十秒甚至几分钟。你优化总生成时长 30%,用户可能无感;你把 TTFT 从 4 秒压到 1 秒,体感是质变。
先学会测量,再谈优化。前端在发送请求时打一个时间戳,第一个 token 渲染上屏时再打一个,两者之差就是用户真实感知的 TTFT。注意是渲染上屏,不是收到第一个字节——中间还隔着解析和 React 提交的时间。用 performance.now() 打点,把这个数字打进你的监控,它应该和 API 成功率一样被每天看一眼。
手段一:让后端尽早 flush,别让网关吃掉你的流
这是最常见也最冤的 TTFT 杀手:模型 0.5 秒就吐出了第一个 token,但 Nginx / CDN 默认开了响应缓冲,把数据攒到几 KB 才往客户端发,用户的首字时间硬生生被拖到 3 秒。自查清单:Nginx 加 proxy_buffering off 和 X-Accel-Buffering: no 响应头;确认 CDN / API 网关没有整包缓存 SSE;后端写完每个 chunk 后显式 flush(Node 的 res.flush()、Python 的流式 response 逐 yield)。上线前用 curl 直接打后端看首字节时间,再对比走网关的时间,差值就是网关吃掉的部分。
手段二:连接复用,别让握手吃掉 1 秒
每次新建 HTTPS 连接,TCP + TLS 握手在弱网下轻松吃掉 500ms~1s,而这段时间完全不产生任何 token。对策:前端用 fetch 的 keep-alive(浏览器默认复用同源连接,别为了"干净"每次换域名);SSE 长连接场景下保持心跳避免中间设备掐线;移动端弱网下,这个优化的效果经常超过提示词优化。
手段三:提示词层面让模型"先说结论"
模型是按顺序生成 token 的,TTFT 不只取决于 infra,还取决于第一个 token 什么时候"值得"输出。如果 system prompt 要求模型先做大段隐性推理再输出,用户看到的第一个字自然就晚。实战做法:在 system prompt 里写死"先用一句话给出结论,再展开论述";对结构化输出,要求模型先输出标题行。这一招不花钱,效果立竿见影——代价是你要接受回答结构被固定下来。
手段四:骨架先行,流到达后替换
当前三种手段都榨干、TTFT 还是超过 2 秒时(比如必须调用外部工具、RAG 检索很慢),别硬扛:前端先渲染一个内容骨架——"正在检索资料…"、"正在生成大纲…"这种带进度的占位,流真正到达后再替换为真实内容。这本质上是把"无反馈等待"变成"有反馈等待",用户的焦虑曲线完全不同。注意骨架文案要诚实:写"正在检索"就必须是真的在检索,别拿假进度条糊弄人(假流式的问题见第七节)。
可打断设计:停止按钮不是装饰
任何超过 5 秒的生成,都必须给用户一个随时喊停的权力。这不只是体验问题:用户发现模型跑偏了却停不下来,只能眼睁睁看着 token 烧钱——这种无力感是对产品信任最直接的磨损。可打断设计的核心是一个小状态机,外加前后端配合的一次 abort。
停止按钮的状态机
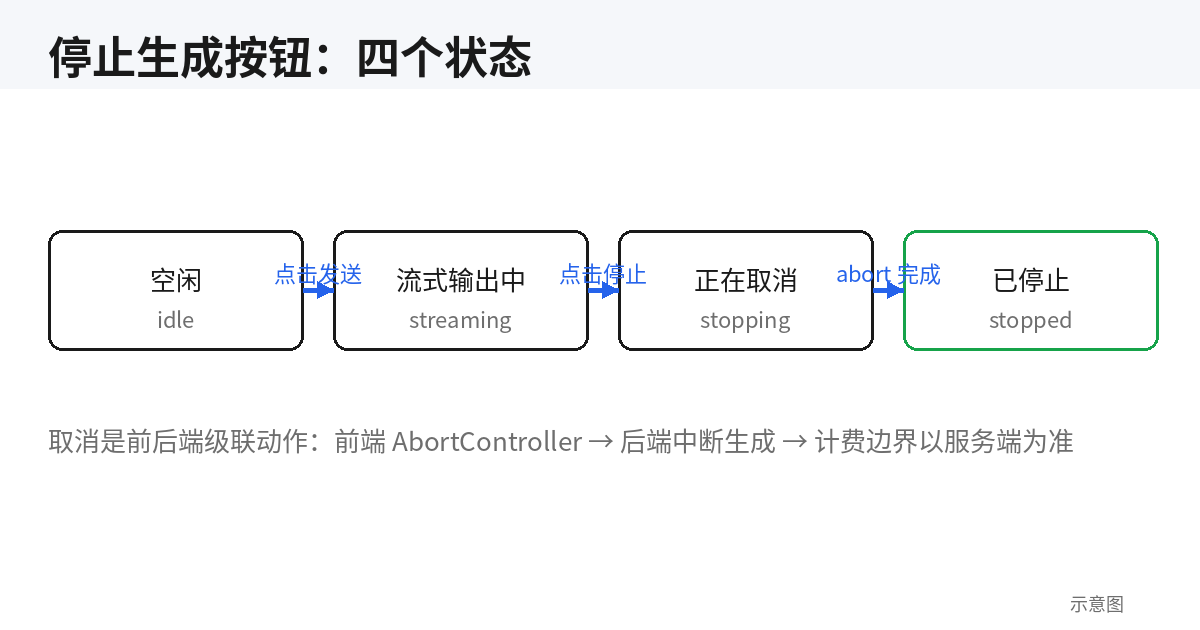
按钮只有两种可见状态,但背后的状态流转要想清楚:idle(显示"发送")→ streaming(显示"停止",输入框锁定或进入排队模式)→ 用户点击停止 → stopping(按钮变灰显示"正在停止",防止重复点击)→ 后端确认终止 → stopped(消息保留已生成部分,标注"已停止",出现"重新生成"和"继续"两个操作)。stopping 这个中间态最容易被省略,但它很关键:abort 是异步的,从点击到后端真正停掉上游请求有几百毫秒延迟,没有中间态,用户会连点三次,然后给你提 bug 说"停止按钮没用"。另一个细节:流自然结束后按钮要立刻切回"发送",别让用户对着一个"停止"按钮发愣——轮询 reader.read() 返回 done 的那一刻就是切换时机。
最小可用代码:前端 abort + 后端感知取消
前端用 AbortController,把 signal 传给 fetch;读取流的循环里,abort 会让 reader.read() 抛出 AbortError,catch 住它,把状态切到 stopped 即可。关键在后端:前端 abort 只断了浏览器到你服务器的连接,你的服务器到模型 API 的请求还在烧钱,必须监听客户端断开事件并级联取消上游请求。Node(Express)示例:
// 前端:可取消的流式请求
const controller = new AbortController();
setStatus('streaming');

try {
  const res = await fetch('/api/chat', {
    method: 'POST',
    signal: controller.signal,
    body: JSON.stringify({ message }),
  });
  const reader = res.body.getReader();
  const decoder = new TextDecoder();
  while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    appendChunk(decoder.decode(value, { stream: true }));
  }
  setStatus('idle'); // 自然结束
} catch (err) {
  if (err.name === 'AbortError') setStatus('stopped');
  else setStatus('error');
}

// 停止按钮:controller.abort(); setStatus('stopping');
// 后端:客户端断开时级联取消上游(Node + fetch 上游示例)
app.post('/api/chat', async (req, res) => {
const upstream = new AbortController();
// 浏览器 abort / 关闭页面 / 断网都会触发 'close'
req.on('close', () => upstream.abort());
res.setHeader('Content-Type', 'text/event-stream');
res.setHeader('X-Accel-Buffering', 'no');
try {
const r = await fetch(MODEL_URL, { signal: upstream.signal, /* ... */ });
for await (const chunk of r.body) { res.write(chunk); res.flush?.(); }
} catch (e) {
// 上游被 abort 是预期内的取消,不是错误,不用打 error 日志
} finally { res.end(); }
});记住这条铁律:没有后端级联取消的停止按钮是假的,它只停了显示,没停计费。联调时验证方法很简单:点停止后去看模型服务商后台的 token 用量,那次请求的上游 token 应该在你点击后 1 秒内不再增长。
流中断的三种 UI 降级:别把技术异常甩给用户
流式连接比普通请求脆弱得多:CDN 掐空闲连接、用户进电梯、服务端超时,都会让流在半截断掉。用户看到的是"字不冒了",你的 UI 必须在 3 秒内给出交代——超过 3 秒无反馈,用户默认产品挂了。三种降级手段,按场景选用:
降级一:断点续传重试(长生成的首选)
适用于已经生成了可观内容(比如超过 500 字)的中断。做法:把已生成文本拼进重试请求的上下文,告诉模型"接着往下写,不要重复"。UI 上显示"连接中断,已自动续传"的一次性提示,流恢复后提示自动消失。注意两个坑:续传 prompt 要显式要求"不要复述已有内容",否则模型大概率从头重写一遍;续传次数设上限(比如 2 次),一直失败就降到第二种方案。它的价值在于保住用户已经读进去的内容——长回答看到一半被清空重来,是体验上最不可接受的一种。
降级二:整段重试(短回答直接重来)
适用于生成内容还很少(几十字)或内容不值得保留的中断。直接丢弃已有输出,显示"生成中断,点击重试",用户点一次重新发起完整请求。别做静默自动重试——短回答重发成本低,但用户可能已经在看别的东西,突然开始冒字会吓人一跳。给用户控制权,一次点击的事。
降级三:降级为非流式(通道本身不可靠时)
当 SSE 通道反复失败(比如某些企业内网代理会掐 SSE、部分地区的运营商劫持长连接),最务实的做法是退回整段返回:前端捕获到连续 2 次流失败后,自动用普通 POST 重发一次,UI 显示"网络不稳定,已切换为完整加载模式"。这是一次性的会话级降级,下次对话再试流式。很多独立开发者死磕"让 SSE 在所有网络下 work",投入产出比极低——承认通道会坏,并准备好 Plan B,比把 Plan A 修到完美更划算。
三者的选择逻辑可以写成一句话:如果内容值得保留→断点续传;不值得保留→整段重试;通道本身有问题→降级非流式。以及统一的底线:任何降级都要告诉用户发生了什么,"已自动续传"四个字,比默默恢复更能建立信任。
长文本流式渲染不卡顿的四个技巧
逐字流式最大的技术债不在网络,在渲染。模型吐 token 的速度(几十 token/秒)远超 React 舒适的 setState 频率,不做处理的话,几千字的回答流到后半段,低端安卓机会肉眼可见地掉帧。这四个技巧按投入产出比排序:
技巧一:节流追加,别每 token 都 setState
把收到的 chunk 先攒进一个 ref 里的字符串缓冲区,用 requestAnimationFrame 每帧(或每 100ms)把缓冲区内容一次性 setState。token 到达频率再高,渲染频率也被钳制在 60fps 以内。实测这是性价比最高的单点优化,一行 rAF 循环解决 80% 的卡顿。注意收尾:流结束时把缓冲区残余一次性刷掉,别漏了最后一截。
技巧二:markdown 增量解析,别全量重排
流式内容通常要渲染 markdown,而 markdown 解析是 O(n) 甚至更贵的操作——每来一个 token 就把全文重新 parse 一遍,文本越长越卡。两种务实做法:延迟渲染,流式过程中只显示纯文本(pre-wrap 保留换行),流结束后再一次性渲染 markdown——用户阅读纯文本毫无障碍,还省掉了所有中间态的解析;增量解析,缓存上一次的解析结果,只对新增部分做解析并拼接到 AST 后。延迟渲染实现简单、效果稳定,推荐大多数场景;只有"边生成边看排版"是核心卖点的产品才值得做增量解析。
技巧三:把流式内容隔离在独立组件里
卡顿的另一个来源是连带重渲染:流式消息每更新一次,整个消息列表跟着重渲染一遍,历史消息里的代码高亮、图片又被折腾一次。解法是把"正在流式的那条消息"做成独立组件,用 memo 包住历史消息,确保流更新只触及正在写的那一条。配合技巧一的节流,这一步做完,万字长文的流式在千元机上也能稳住。
技巧四:超长列表用虚拟化
当前三招都做了、单条消息超过几千字(比如生成长报告、批量表格)还是卡时,说明瓶颈在 DOM 节点数量本身。这时上虚拟滚动(react-window / virtua 这类库):只渲染视口内的行,非视口的用占位撑高度。但要注意,虚拟化和流式追加是互斥思路——虚拟列表要求内容分行可测量,流式追加时行高在变。折中方案:流式过程中不虚拟化(靠前三招顶住),流结束、内容定型后再切换为虚拟列表。这个切换用户无感,但能把万字文档的常驻 DOM 从几千个节点降到几十个。
取消与重发的交互细节:魔鬼在三处
停止按钮能点只是起点。点完之后输入框是什么状态、历史里那条半截消息怎么展示、token 账怎么算——这三处细节决定了用户敢不敢点第二次"停止"。
输入框状态:streaming 时到底让不让打字
两种路线都有大厂在用,选哪个取决于你的产品形态。路线 A:锁定输入框,streaming 期间输入框 disabled,配文案"生成中…可随时停止"。简单、无歧义,适合单轮问答、工具型产品。缺点是用户想追问必须先停,操作多一步。路线 B:允许输入,进入排队,用户可以在生成过程中继续打字,发送后新消息进入队列,当前生成结束后自动执行。适合重度对话场景。但 B 有两个必须做对的细节:排队中的消息要明确标识"等待中",不能让用户以为发出去了没反应;用户点了停止,队列里的待发送消息要不要清空?建议默认清空并 toast 告知"已取消排队消息",因为用户点停止时大概率想换个问法,留着旧问题自动发出去只会添乱。独立开发者建议从 A 做起——B 的排队状态机复杂度是 A 的三倍,等用户真的抱怨"不能边等边打字"时再升级。
历史消息:半截回答不是垃圾,要留档
用户主动停止后,那条没写完的消息怎么处理?最差的做法是直接删掉——用户可能已经读了前半段,删掉等于没收他的阅读成果。正确做法:保留原文 + 灰色小字标注"已停止生成",下方给两个操作:"继续生成"(断点续传,见第四节)和"重新生成"(整段重试)。继续生成是默认主按钮,因为它尊重用户已经投入的阅读时间。还有一个边界:如果用户在停止后直接发了新问题,旧的半截消息就地保留,不要自动折叠——历史记录的第一职责是忠实, collapsed 的"智能"只会让用户找不到自己看过的内容。
token 计费的三条规则:提前说清楚,别等账单日吵架
流式 + 可打断把计费问题从"后台逻辑"变成了"前台信任问题"。三条规则,建议直接写进你的 FAQ 或计费说明页:
规则一:取消前已生成的 token 照常计费。模型确实干了活,调用方(你)确实被服务商扣了费,这笔钱只能如实传导。但前端要在停止的那一刻就明示——在"已停止"标注旁边加一句"本次已生成约 X 字",把"扣费"变成"可见的消费",用户对"看得见的扣费"的容忍度远高于"莫名其妙少了额度"。
规则二:重发是独立计费,不与上次合并。"重新生成"本质是一次全新的模型调用,计费从零开始。不要在 UI 上暗示"重试免费",除非你真的打算补贴。也不要搞"重试半价"这种自作聪明的规则——计费规则越简单,用户越不需要动脑子。
规则三:断点续传时,已生成部分不重复收模型推理费,但上下文 tokens 照算。这是最容易被误解的一条:续传需要把已生成文本作为上下文再喂给模型,这部分输入 tokens 服务商是要收费的(虽然比重新生成整段便宜得多)。诚实的做法是在"继续生成"按钮旁标注"将消耗少量上下文额度"。三条规则背后的统一原则:计费逻辑可以复杂,但呈现给用户的规则必须简单、可预测。用户不怕花钱,怕的是花得莫名其妙。
反模式:这三件事别做
反模式一:假流式——前端定时器逐字吐预设文本
做法:后端一次性返回完整文本,前端用 setInterval 每 30ms 吐几个字,营造流式假象。为什么有人这么干?因为它实现简单,还能"保证"首字时间(第一个字可以瞬间冒出来)。但它是饮鸩止渴:第一,延迟一点没降,用户感知的总等待时间 = 后端整段生成时间 + 假打字机时间,比真流式更长;第二,弱网下穿帮,后端那一下整段返回如果卡了 10 秒,用户看到的是 10 秒 loading + 突然开始"打字",TTFT 造假在首屏就被识破;第三,打字速度是固定的,长回答的假流式慢得让人想砸屏幕,短回答又一闪而过,节奏永远别扭。判断标准:如果你的"流式"不需要 SSE / WebSocket,后端是一次性返回,那就是假流式,趁早拆了。
反模式二:没有取消按钮的长生成
有些产品觉得"反正也就 20 秒,忍忍就过去了",于是只给 loading 转圈。这 20 秒里用户想改问题、发现选错了模型、或者单纯不想等了——没有出口的等待是最差的体验,没有之一。更隐蔽的版本是"有按钮但点不了":停止按钮调的只是前端状态,前面第三节说的后端级联取消没做,用户点了停止,字不冒了,但后台还在烧 token,账单日用户会回来找你算账。记住:取消按钮 = 前端 abort + 后端级联取消 + 明确的 stopped 状态,缺一不可。
反模式三:流中断后整页报错
流断了,前端抛一个大红 error boundary 把整个对话页盖掉,用户之前的十轮对话全看不见,只能刷新。这是最粗暴的错误处理:一次网络抖动,惩罚了用户全部的上下文。正确做法是错误边界只包住出问题的那条消息组件,页面其他部分(历史消息、输入框、侧边栏)纹丝不动;那条消息内部按第四节的三种降级处理。实现上就是给每条消息包一层小的 ErrorBoundary,而不是在页面级包一层大的。这个改动通常不超过 20 行代码,但它是"产品经不经得起折腾"和"一碰就碎"的分水岭。
结语:流式体验是工程问题,不是审美问题
回顾全文,流式 UX 的每一环都有明确的工程解:形态用决策表选,TTFT 用打点 + flush + 骨架压,可打断用状态机 + AbortController + 后端级联取消,中断用三级降级,卡顿用节流 + 隔离 + 虚拟化,取消重发用三条明规则,避开三个反模式。没有哪一环需要"灵感",只需要逐项落实。
最后给一个落地顺序建议,按投入产出比:第一周,把 TTFT 打点加上,修掉网关缓冲,加上停止按钮(含后端级联取消)——这三件事做完,80% 的用户投诉会消失。第二周,做中断降级和渲染节流。第三周,再考虑分块渲染和排队输入。流式体验没有银弹,但有清晰的施工图,照着打勾就行。
相关文章
AI 生成的 UI 从不按 Tab、不开读屏,无障碍问题在它的视觉反馈闭环里全部隐形。这篇实战指南给出 P0/P1/P2 三级优先级清单、四套可直接复制的 prompt 模板、30 分钟免费审计流程,以及 6 组高频翻车代码的 before/after 修法,附上线前验收清单。
UX 再好也挡不住用户想确认政策、搜报错信息、付款前做信任检查。这篇指南给一人开发者一套可落地的帮助中心方法论:四象限决策矩阵决定写什么、6 个顶层分类模板、6 种文章类型的写作骨架、用 AI 从代码库起草文档的三段式工作流、一人份 docs-as-code 最小搭建、绑进发版的 doc-debt 清单,以及每月 1 小时的维护 SOP。
模型、提示词、工具三者任一变化,都可能在你庆祝修好的同时悄悄破坏 Agent 的能力。本指南从零讲透评估基准搭建:从真实流量挑 20 个 case 组成黄金测试集,代码评分器加校准过的 LLM 裁判,三层分开记分,防自欺清单,CI 门禁真正拦下合并,再用线上采样与影子运行形成闭环。