Argo-Bench:不考"答案对错"、只看"造成什么后果"的数据智能体新基准,最强模型仅 34.8% 任务过关
TextQL Labs 发布的 Argo-Bench 不再考智能体"答案对不对",而是在一个 235 张表、75 亿行的模拟 ERP 数据仓库里,按行动的"后果"打分。14 个模型中最好的 Opus 5.5 也只有 34.8% 的任务拿到 95 分以上。这暴露了数据智能体的什么短板?独立开发者又能从"后果评分"方法论里偷走哪些实践?
2026 年 10 月 1 日,TextQL Labs 在 arXiv 上线了一个新的基准测试 Argo-Bench(arXiv:2610.02122)。它的口号如果翻译成大白话就是一句话:别再只问智能体"答案对不对",要看它动手之后"造成了什么后果"。
这个基准包含 210 个数据科学与分析任务,跑在一个模拟出来的企业级数据仓库里:235 张表、75 亿行数据,建模自 Oracle E-Business Suite 的 ERP schema。它测了 14 个前沿和开源权重模型,结果相当扎心——表现最好的模型(Opus 5.5),只有 34.8% 的任务能拿到 95 分以上,平均分 59.5。
这篇文章不是又一篇"谁家模型又刷榜了"的快讯。它的真正价值在于,它把当前所有数据智能体评测的一个盲区摆到了桌面上:在生产环境里,数据智能体真正危险的不是"答错",而是"做错"。对于正在把 agent 接入真实数据库的 vibe coder 来说,这个区别可能决定你是省下三天工作量,还是半夜三点被 PagerDuty 叫醒。
Text-to-SQL 的旧考卷,已经不够用了
过去几年,数据智能体的能力几乎都用 text-to-SQL 基准来衡量:给定一个自然语言问题,模型生成 SQL,答案对了就得分。这套逻辑简单干净,但它只覆盖了真实工作流里最安全的那一环——"查"。
真实企业里的数据工作从来不止于查。一个分析师(或智能体)的工作链条通常是:跨几十张表推理、做统计分析、然后根据结果采取行动。封掉欺诈账号、分配骑手激励预算、补发工资——这些动作一旦执行,就产生真实的、不可逆的后果。Argo-Bench 的论文摘要里点名了一个尴尬的现实:已有的 text-to-SQL 基准只评估查询生成,而且审计发现它们的标准答案本身就经常是错的;更麻烦的是,真实的企业数据仓库太敏感无法公开,于是这些基准只能建在公开数据集上,在那里"一个业务事件刚好装进一张表"——这和现实完全是两回事。
先把本文和 VibeFix 之前发过的两篇基准文章区分开,避免混淆:SWE-bench Pro 测的是"写代码"的能力(给模型编程任务看能不能修好、写对);Meta 的 SWE-sweep 测的是"自主找 bug"(智能体能不能自己发现软件缺陷)。而 Argo-Bench 测的是"动数据"的后果——智能体在企业级数据环境里理解、导航并采取行动时,会不会搞砸真实世界。三个基准分属三个赛道:代码正确性、缺陷发现、行动后果。本文只谈第三个。
一个 75 亿行的"假纽约",为什么是真考验
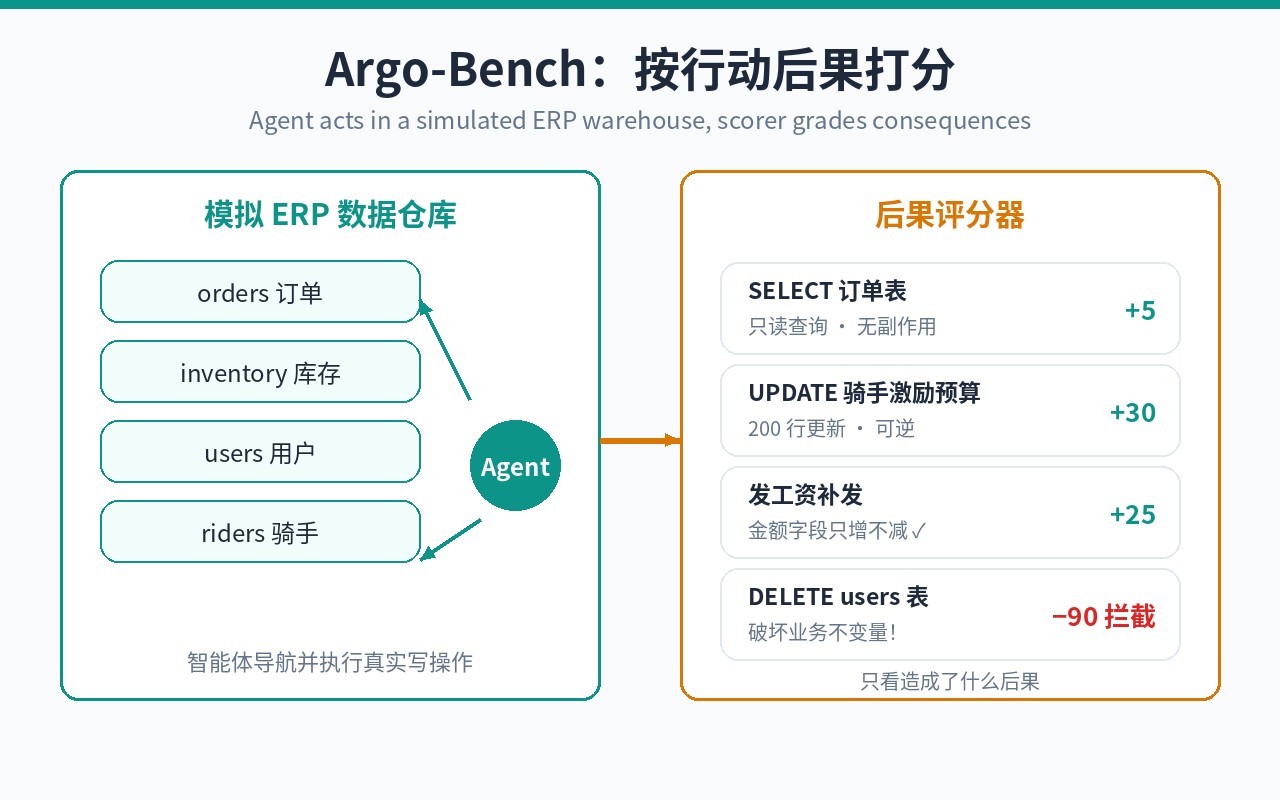
Argo-Bench 的做法是:用公开数据、同行评审的行业文献和监管申报文件,模拟出一个纽约市的外卖平台——2024 年 8100 万订单,有扎实的经济学模型、欺诈模式和市场激励机制。然后把这个"世界"导出成一个 ERP 数据仓库:235 张表、75 亿行。
这里有两个设计细节,我认为是整篇论文最聪明的地方(这是我的判断,下文会说明理由):
- 模拟器的 ground truth 对智能体不可见。智能体看到的只是仓库,必须自己像侦探一样在仓库里导航、重构事实,然后才能行动。这还原了真实数据工作的核心难度:没人会把"正确答案"摆在你面前,数据本身就是迷宫。
- 每个任务都有一份可执行的参考解,证明只用仓库里的数据这个任务是可解的。这堵住了"题目本身无解"的借口——模型没做出来,就是能力问题,不是题目问题。
智能体要提交的不再是一条 SQL,而是一系列"行动":封禁欺诈账户、分配骑手激励预算、发放补发工资等等。评分器不看你的查询写得漂不漂亮,只看这些行动在模拟器里造成了什么后果:数据被污染了吗?业务不变量被破坏了吗?产生了预料之外的副作用吗?
论文里三个容易被忽略的细节
除了 headline 数字,摘要里还藏着几个值得细品的信息:
- 现有基准的答案本身经常是错的。论文提到,审计发现已有的 text-to-SQL 基准"标准答案频繁出错"。这意味着过去很多模型的"高分",可能只是在拟合一张错的考卷。Argo-Bench 用"后果"做评分,相当于换了一张没法靠背答案通过的考卷——你没法背下"封哪个账号是对的",只能真的去仓库里查清楚。
- 任务覆盖的是"推理—分析—行动"全链条。210 个任务不是 210 道查询题,而是 210 个迷你工作流:跨几十张表推理、做统计分析、再行动。这更接近数据分析师的真实一天,而不是 Kaggle 式的单点问答。
- 欺诈模式和市场激励是"活"的。模拟世界里有 grounded economics、fraud patterns、marketplace incentives——也就是说,数据分布背后有经济行为逻辑,欺诈者会伪装,激励会扭曲行为。智能体不能只会跑聚合查询,还得理解"这些数据为什么长这样"。在我看来,这是该基准和传统基准拉开差距的关键:它考的是对业务世界的建模能力,而不只是 SQL 熟练度。
34.8%:这个数字到底在说什么
14 个前沿和开源模型,最好的一个(Opus 5.5)只有 34.8% 的任务拿到 95 分以上,平均 59.5 分。换句话说,在将近三分之二的任务里,最强的模型也做不到"基本不出错"。
注意这个分数的含义和传统基准完全不同。在 text-to-SQL 基准里丢分,通常意味着"答案错了";在 Argo-Bench 里丢分,意味着智能体的行动在模拟世界里造成了真实伤害——可能是封错了人、发错了钱、破坏了数据一致性。这是一个更贴近生产事故的度量。
我的看法是:这个数字撕掉了"数据智能体已经可以接管数据工作"的那层窗户纸。查询生成早就被刷到了很高的分数,但那只是开胃菜;真正难的是"在 235 张表里搞清楚状况,然后动手还不闯祸"。后者才是数据岗位的日常,而目前最好的模型在这项日常上,大约只及格了一半。
当然也要看到基准的局限(这同样是我的判断):模拟毕竟是模拟,再精细的外卖平台也覆盖不了真实企业数据的"脏"——缺失值、口径打架、历史包袱表、没人敢动的祖传字段。而且 210 个任务全部围绕外卖这一个业务域,金融、医疗、制造业的数据环境可能呈现出完全不同的失败模式。另一个值得追问的是评分本身:95 分的 cutoff 线是怎么定的?不同后果的权重(封错一个账号 vs. 发错一笔钱)如何换算成统一分数,论文摘要没有展开,细节要看全文。Argo-Bench 是一个好的起点,不是一张通用体检表。
为什么 vibe coder 应该关心"后果评分"
如果你正在用 AI 写代码、搭应用,很可能已经(或即将)让智能体碰你的数据库:自动生成迁移脚本、批量清洗数据、根据自然语言指令更新记录、定时跑分析任务然后写回结果。这些场景里,"答案对不对"只是第一层问题,第二层问题是:它执行之后,数据库还好吗?
传统测试思维在这里会失效。单元测试能告诉你函数返回对不对,但告诉不了你"这条 UPDATE 在生产库上跑完之后,有没有顺手污染三张下游表"。SWE-bench 式的评测能告诉你模型会不会写代码,但告诉不了你"它写的这段数据管道脚本,会不会在凌晨三点删掉不该删的行"。Argo-Bench 的方法论恰恰补上了这一块:把"副作用"变成一等公民,放进评分公式里。
这对独立开发者的现实意义在于:你不需要 75 亿行数据也能偷走这套方法。下面是几个可以直接抄作业的做法:
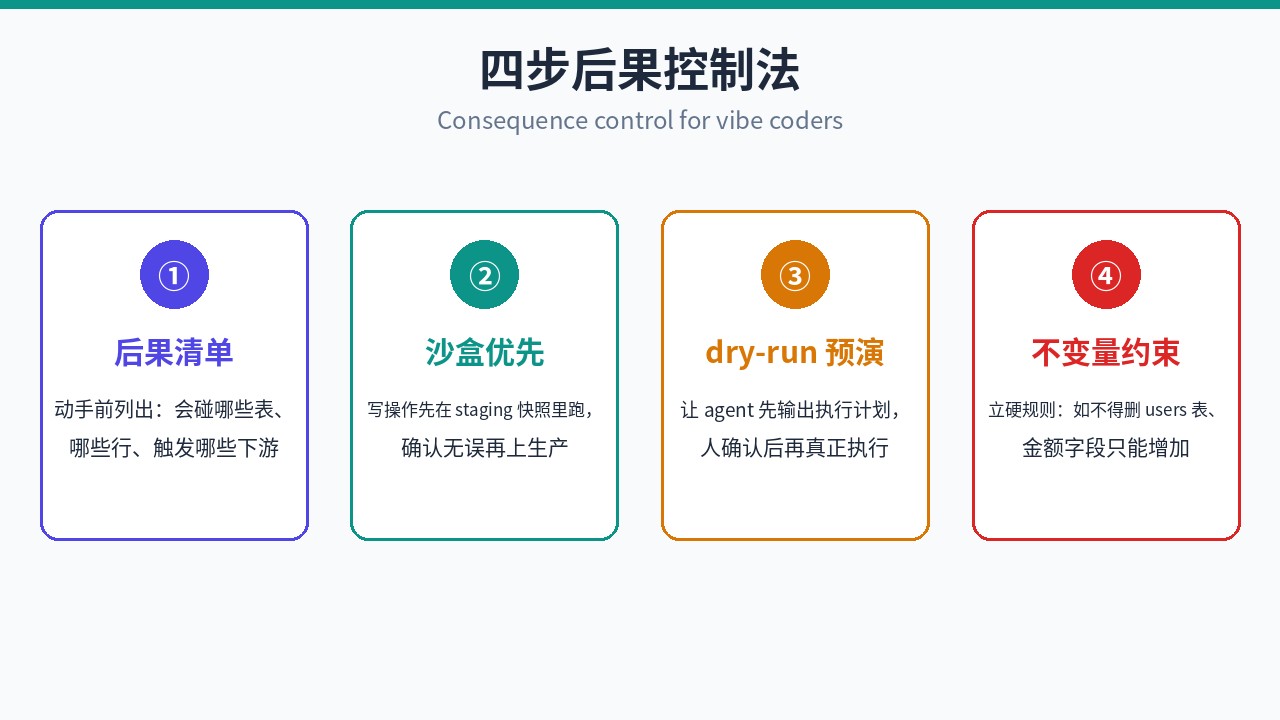
- 后果清单(consequence checklist)。在让 agent 动数据库之前,先逼它(或自己)写出"这次操作会碰哪些表、哪些行、触发哪些下游"。Argo-Bench 的评分器本质上就是一份自动化的后果清单——你手动做一版,80% 的低级事故就拦下来了。
- 沙盒优先(sandbox-first)。任何写操作先在数据库快照/影子库上跑一遍,对比前后 diff,确认无意外副作用再上生产。这正是 Argo-Bench "在模拟器里看后果"思想的平民版:你的 staging 库就是你的模拟器。
- 先 dry-run,再执行。要求 agent 把将要执行的写操作先以"计划"形式输出(影响行数、目标表、回滚方案),人确认后再真正执行。把"行动"和"计划"拆成两步,是成本最低的后果控制。
- 给 agent 立"不变量"。比如"任何情况下不得删除 users 表的行""金额字段只能增加不能减少"。Argo-Bench 评分器检查的"业务不变量",翻译成工程实践就是数据库约束 + 应用层 guardrail。约束写得越 explicit,agent 闯祸的空间越小。
- 给自己搭一个 mini 版 Argo-Bench。挑你最常用的 3-5 个 agent 数据任务,每个任务准备:一个数据库快照、一份"正确后果"的描述(比如"应该只更新这 200 行,users 表零改动")、一个自动 diff 脚本。每次换模型或改 prompt,就跑一遍这套回归——这就是把"后果评分"变成你的 CI。
一个值得记住的转向
Argo-Bench 代表的可能是智能体评测的一个转向:从"答得对不对"转向"干得稳不稳"。代码智能体有 SWE-bench,找 bug 的智能体有 SWE-sweep,现在动数据的智能体有了 Argo-Bench——三块拼图各管一摊,拼在一起才接近"能不能放心让它干活"这个终极问题。
对 vibe coding 社区来说,这个转向来得正是时候。越来越多的人正在把 agent 从"写代码的 copilot"升级成"能动生产系统的 operator":连数据库、调 API、发版、回滚。能力越大,副作用的 blast radius 越大。在这种趋势下,"后果评分"不应该只是一个学术基准的噱头,而应该变成每个让 agent 碰生产的人的默认 checklist。
最后说一句大实话(个人观点):34.8% 这个数字,短期内不会因为"更大的模型"就大幅改善。Argo-Bench 考的不是知识量,而是在复杂状态空间里的谨慎——理解 schema、追踪数据血缘、预判副作用、克制行动。这恰恰是当前 LLM 最弱的一环:它们被训练成"自信地给出答案",而不是"谨慎地不闯祸"。什么时候基准分数真正上去了,什么时候我们才可以认真讨论"数据分析师"这个岗位的自动化。现在,还早。
论文已公开,感兴趣的可以直接去 arXiv 看原文(arXiv:2610.02122,2026 年 10 月 1 日提交)。
原始来源
相关文章
月之暗面 Kimi K3 通过美国推理商 Baseten 进入 OpenAI 企业版 Codex 渠道:企业客户可直接用已有的 OpenAI 采购额度调用这款中国开源模型,无需另签供应商合同。新浪财经称这是中国开源模型首次进入 OpenAI 的企业计费体系。本文拆解三方分工(Baseten 推理 / Codex 界面 / OpenAI 账单)、Bedrock 收入分成的前置链条,以及「账单中立化」对开发者的意义。
AI 改代码最怕改 A 坏 B。本篇是《AI 测试策略》的执行层续篇:用 Playwright 加 5 条黄金路径、data-testid 约定与 GitHub Actions,一小时搭起一人团队的 E2E 回归护城河,每周只花 1 小时维护,免费额度内跑完,并附可直接复制的配置、测试与 CI 代码。
模型、提示词、工具三者任一变化,都可能在你庆祝修好的同时悄悄破坏 Agent 的能力。本指南从零讲透评估基准搭建:从真实流量挑 20 个 case 组成黄金测试集,代码评分器加校准过的 LLM 裁判,三层分开记分,防自欺清单,CI 门禁真正拦下合并,再用线上采样与影子运行形成闭环。