AI 时代的一人回归测试:Playwright E2E 最小成本方案
AI 改代码最怕改 A 坏 B。本篇是《AI 测试策略》的执行层续篇:用 Playwright 加 5 条黄金路径、data-testid 约定与 GitHub Actions,一小时搭起一人团队的 E2E 回归护城河,每周只花 1 小时维护,免费额度内跑完,并附可直接复制的配置、测试与 CI 代码。
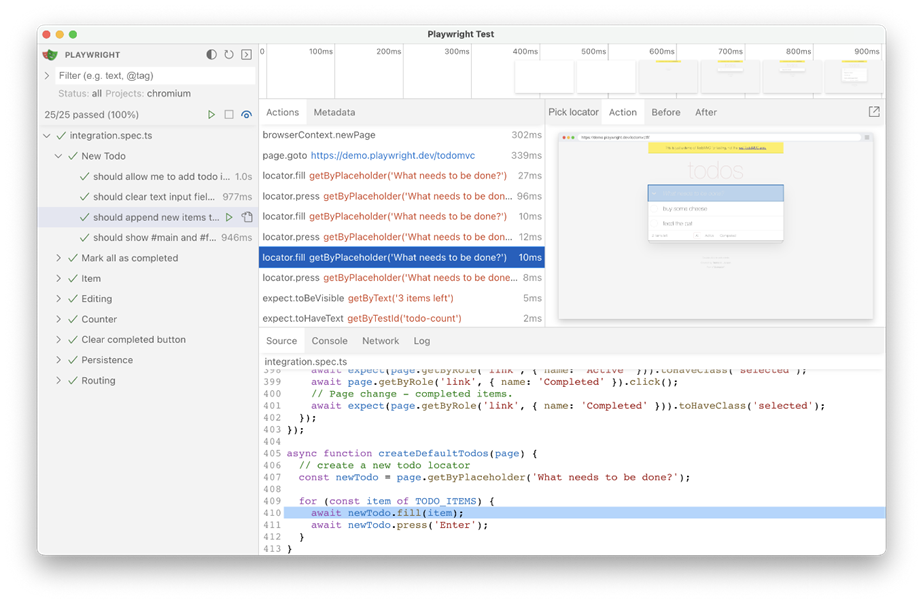
先说清楚分工:本站之前发过《AI 测试策略》,那篇讲的是策略层——测什么、为什么测、测试金字塔怎么摆。本篇讲的是执行层——用什么测、怎么测、成本多少。策略回答"为什么出发",执行回答"怎么走到",两者是上下游关系,不重复。如果你还没读过策略篇,建议先去读;这篇默认你已经认同"回归测试值得做",只解决"一个人怎么做才划算"。
核心问题很具体:AI 改代码最怕"改 A 坏 B"。没有回归测试的一人项目,每次发布都靠手点一遍走个过场,上线即翻车只是时间问题。这篇给你一套最小成本方案:Playwright + 5 条黄金路径 + data-testid 约定 + GitHub Actions,搭建 1 小时,每周维护 1 小时,免费额度内跑完。
一、为什么单元测试不够:AI 改代码的三种典型翻车
先下一个判断:AI 改代码很少改坏某个函数,它改坏的是"协作"。而单元测试 mock 掉一切外部依赖,恰好也 mock 掉了翻车现场。你让 AI 重构一个组件,单元测试全绿, production 却挂了——这种剧本每个 vibe coder 都演过。下面是三种最高频的翻车模式:
翻车一:样式回归——"能跑,但没法看"。AI 重构组件时最爱顺手"优化" className。你让它把登录表单改成双栏布局,它可能把全局的 button 样式类名也改了。单元测试全绿,因为按钮的 onClick 逻辑没变。但用户看到的是满屏错位的按钮。单元测试断言的是行为,E2E 断言的是"用户看到的东西"——关键元素的可见性断言才能抓住这类问题。判断:样式回归是 AI 重构的最高频副作用,没有之一,任何只靠单元测试的一人项目都迟早在这栽跟头。
翻车二:表单校验丢失——"逻辑对了,门没了"。你让 AI 给注册表单加个"公司名称"选填字段,它加了字段,却顺手把"密码至少 8 位"的校验规则删了——因为它重写了整个校验 schema,只记得新需求。单元测试如果只覆盖了"新字段渲染正常",这条就漏网了。E2E 的注册黄金路径会输入一个 6 位密码点提交,断言错误提示出现——这条用例写一次,永久防住"AI 顺手删校验"。
翻车三:鉴权状态泄漏——"A 用户看到了 B 用户的数据"。这是最危险的一类。AI 改 API 路由时可能把中间件顺序调换,或者把 userId 从 session 取改成从 query 取。单元测试里 auth 都是 mock 的,mock 永远不会背叛你。E2E 用两个真实账号登录,断言 A 看不到 B 的订单——这是唯一能在发布前抓住鉴权回归的手段。样式回归丢的是脸,鉴权回归丢的是命。
核心结论:单元测试回答"函数对不对",E2E 回答"用户能不能用"。AI 的强项是写函数,弱项是守住协作边界;所以对 vibe coder 来说,测试金字塔应该倒过来建:先搭 E2E 这条护城河,再补集成测试,单元测试随缘。这反了传统教科书,但符合 AI 时代的翻车分布——把精力花在 AI 最容易犯错的地方,而不是教科书说"应该"的地方。
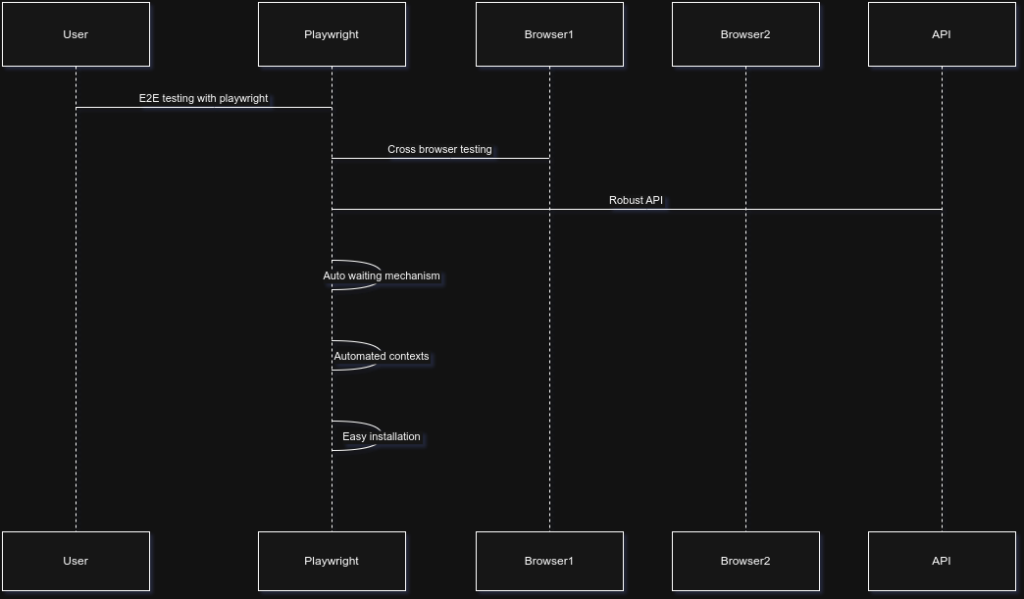 Playwright 接入 CI/CD 流水线架构图
二、最小可用 E2E 套件:5 条黄金路径,一小时搭起来
观点先行:E2E 的失败模式从来不是"测得不够",而是"测得太多然后维护不起"。一人团队的 E2E 套件必须小到"跑一遍不超过 5 分钟,读一遍不超过 10 分钟"。我的建议很克制:只测 5 条黄金路径。
- 注册→登录→退出:身份链路,翻车三的高发区;
- 核心流程走完:你的产品"啊哈时刻"那条路,比如发帖、下单、生成报告——每个产品只有一条,问自己"用户为什么付钱"就能找到;
- 支付链路:能下单、能看到成功态,用沙盒环境,不真扣钱;
- 关键页面渲染:首页、定价页、核心功能页——无白屏、关键文案在;
- 表单校验:注册与核心表单,非法输入被拦下、错误提示可见,专防翻车二。
判断:这 5 条覆盖了一人产品九成以上的"上线即翻车"场景。从第 6 条开始,边际收益断崖式下跌,维护成本直线上升——克制是 E2E 的第一美德,后面算 CI 账时你会看到克制直接等于省钱。
一小时搭建:Playwright + TypeScript
为什么是 Playwright 而不是 Cypress:自动等待(auto-waiting)是 E2E flaky 的头号杀手,Playwright 的断言自带重试;多浏览器、并行、录像、trace viewer 全家桶开箱即用;TypeScript 的类型提示让 AI 生成的代码质量高一档。Cypress 也能用,但 2026 年的新项目选 Playwright 是更省心的决定——这是判断,不是中立。
安装只有一行命令,官方脚手架全包:
npm init playwright@latest脚手架会问你要不要 TypeScript、tests 目录放哪、要不要生成 GitHub Actions workflow——全选 Yes,它连 CI 文件都帮你生成好。这就是"一小时"的底气:脚手架 5 分钟,写 5 条用例 40 分钟(AI 生成初稿),你审校 15 分钟。
最小可运行配置 playwright.config.ts:
import { defineConfig, devices} from '@playwright/test';

export default defineConfig({
testDir: './tests', // 用例目录:约定优于配置
fullyParallel: true, // 用例并行跑:5 条用例从串行 3 分钟压到 1 分钟内
retries: 2, // CI 里失败自动重试 2 次:flaky 的第一道防线
workers: process.env.CI? 2: undefined, // CI 用 2 个 worker,本地不限
reporter: 'html', // 生成可视化报告:红了点开看录像
use: {
baseURL: 'http://localhost:3000', // 所有 page.goto('/login') 自动拼接
trace: 'on-first-retry', // 只在重试时录 trace:省磁盘,够排查
screenshot: 'only-on-failure', // 失败才截图:通过的不留垃圾
video: 'retain-on-failure', // 失败才留录像:同上
},
projects: [
{ name: 'chromium', use: {...devices['Desktop Chrome']}},
// 一人团队先只跑 chromium:firefox/webkit 等用户投诉了再加。
// 三个浏览器全跑 = 三倍时间,ROI 现在是负的。
],
webServer: {
command: 'npm run dev', // 跑测试前自动起本地服务
url: 'http://localhost:3000',
reuseExistingServer:!process.env.CI, // 本地复用已起的服务,CI 每次新起
},
});
关键行解读,每行都是省钱的:
retries: 2:flaky 测试不直接判死刑,九成偶发失败重试一次就过,省掉你半夜爬起来看 CI 的命;trace/screenshot/video的only-on-failure策略:E2E 产物的磁盘和上传时间是隐性成本,全量录像的套件跑一次多花三成时间;webServer:新人(包括三个月后的你)clone 下来npx playwright test就能跑,零手工步骤——"能一键跑"是套件不烂尾的前提;- 只跑 chromium:等你的用户里出现"在 Safari 上挂了"的工单再加,现在加就是给未来的自己交税。
第一个测试文件:注册→登录黄金路径
tests/auth.spec.ts:
import { test, expect} from '@playwright/test';

test('注册→登录→退出:身份链路全通', async ({ page}) => {
const email = `e2e-${Date.now()}@example.com`; // 每次用新邮箱:测试数据隔离
const password = 'Test1234!';

// 1. 注册
await page.goto('/signup');
await page.getByTestId('signup-email').fill(email);
await page.getByTestId('signup-password').fill(password);
await page.getByTestId('signup-submit').click();
// 断言用户可见的结果,而不是 URL 或内部状态:
await expect(page.getByTestId('user-menu')).toBeVisible();

// 2. 退出
await page.getByTestId('user-menu').click();
await page.getByTestId('logout-button').click();
await expect(page.getByTestId('login-link')).toBeVisible();

// 3. 登录
await page.goto('/login');
await page.getByTestId('login-email').fill(email);
await page.getByTestId('login-password').fill(password);
await page.getByTestId('login-submit').click();
await expect(page.getByTestId('user-menu')).toBeVisible();
});
注意三个细节,它们决定了这套用例能不能活过三个月:第一,全用 getByTestId,不用 CSS 选择器、不用文本匹配——理由见第三节的 data-testid 约定;第二,邮箱带时间戳,每个用例用独立数据——理由见第四节"隔离测试数据";第三,断言只断言用户可见的东西(菜单出现了、登录链接出现了),不去断言 localStorage 里有没有 token——那是实现细节,AI 一重构就变。
三、让 AI 写测试用例的正确姿势
观点:AI 写测试用例的质量,取决于你给的约束,而不是模型的能力。裸 prompt("给登录页写个 E2E 测试")产出的是垃圾——元素选择器靠猜、断言靠编、等待靠 sleep。正确姿势是:约定先行,prompt 模板化。
四条铁律(先立规矩,再让 AI 干活)
铁律 1:data-testid 约定——测试锚点与样式解耦。给所有可交互元素加 data-testid,命名规则是 <页面>-<模块>-<动作>,如 login-submit、pricing-cta。为什么?AI 改代码最爱动 className 和文案(翻车一),但它几乎不会动 data-testid——因为那是"给测试用的",不在它的重构直觉里。测试锚点一旦和样式文案解耦,AI 随便改 UI,测试都不挂。这条约定是整套方案里 ROI 最高的一行要求,5 分钟讲清楚,受用整个项目周期。
铁律 2:页面对象模式(Page Object)——哪怕只有 5 条用例。把"登录"这个动作封装成函数或类,所有用例都调它。AI 改登录表单字段名时,你只需要改一处,而不是 5 个文件。5 条用例时觉得多余,第 15 条时救命。示例:
// tests/pages/login.page.ts
import { Page, expect} from '@playwright/test';

export class LoginPage {
constructor(private page: Page) {}
async goto() { await this.page.goto('/login');}
async login(email: string, password: string) {
await this.page.getByTestId('login-email').fill(email);
await this.page.getByTestId('login-password').fill(password);
await this.page.getByTestId('login-submit').click();
// 登录成功 = 用户菜单可见:断言收敛在这一处
await expect(this.page.getByTestId('user-menu')).toBeVisible();
}
}
铁律 3:断言只断言用户可见结果。允许:按钮可见、文案出现、页面跳转到了用户能感知的地址、错误提示出现。不允许:断言 localStorage、断言内部 state、断言 API 返回的 JSON 结构——那些是集成测试和单元测试的活。E2E 越界断言的最大代价是"实现一改测试全挂",然后你就不想维护了。
铁律 4:禁止 waitForTimeout(硬 sleep)。Playwright 的 expect 自带自动重试和等待,getByTestId(...).click() 会等到元素可点才点。凡是 AI 写出 await page.waitForTimeout(3000),一律打回——这是 flaky 的头号制造机,见第四节。
测试生成 prompt 模板(直接复制用)
为以下用户流程生成 Playwright + TypeScript E2E 测试用例。


<粘贴:用户故事,如"用户在定价页点升级,跳 Stripe 沙盒支付,回来看到 Pro 徽章">


1. 定位元素只用 page.getByTestId('...');若页面缺少 data-testid,
先列出需要补的 testid 清单,不要猜 CSS 选择器。
2. 断言只断言用户可见结果(元素可见、文案出现、页面跳转),
不断言 localStorage / 内部状态 / API 响应体。
3. 禁止 waitForTimeout;用 expect(...).toBeVisible() 等自带重试的断言。
4. 测试数据必须隔离:邮箱 / 用户名带 Date.now() 时间戳或随机串。
5. 登录等公共动作复用 tests/pages/ 下的 Page Object,没有就先建一个。
6. 每个测试只测一条黄金路径,命名格式:"<路径名>:<用户视角的期望>"。


- 完整的 spec 文件代码(含 import)
- 需要补的 data-testid 清单(如有)
- 你不确定的页面事实清单(如实际文案、跳转地址),不要编造
最后一条是关键:逼 AI 说出"我不知道",而不是编一个看起来对的断言。AI 的幻觉在测试代码里比在业务代码里更致命——业务代码的幻觉跑起来就崩,测试代码的幻觉是"静静地测了个寂寞",给你虚假的安全感。
AI 生成测试的三类常见幻觉及审校法
幻觉一:凭空编造元素和文案。症状:getByTestId('pay-now-btn'),但你的代码里这个 testid 根本不存在;或者断言 toContainText('支付成功!'),实际文案是英文。审校法:跑一遍。Playwright 的错误信息会精确告诉你哪个 locator 超时找不到。更省事的办法是 prompt 模板第 1 条要求它"先列 testid 清单",你对着页面源码勾选,5 分钟搞定。
幻觉二:用 sleep 代替等待。症状:满篇 waitForTimeout(2000),本地能过,CI 随机红。审校法:全局搜索 waitForTimeout,出现一次打回一次。替换方案永远是"断言某个用户可见状态",而不是"等 N 秒"。这是条红线,没有例外。
幻觉三:过度断言(把 E2E 写成集成测试)。症状:一个"下单"用例里断言了 12 件事,包括"数据库里订单状态为 paid"。审校法:数断言。黄金路径用例的断言超过 5 个就值得怀疑——问自己"用户感知得到吗",感知不到的删掉或下沉到集成测试。E2E 的断言很贵(跑得慢、易碎),要花在刀刃上。
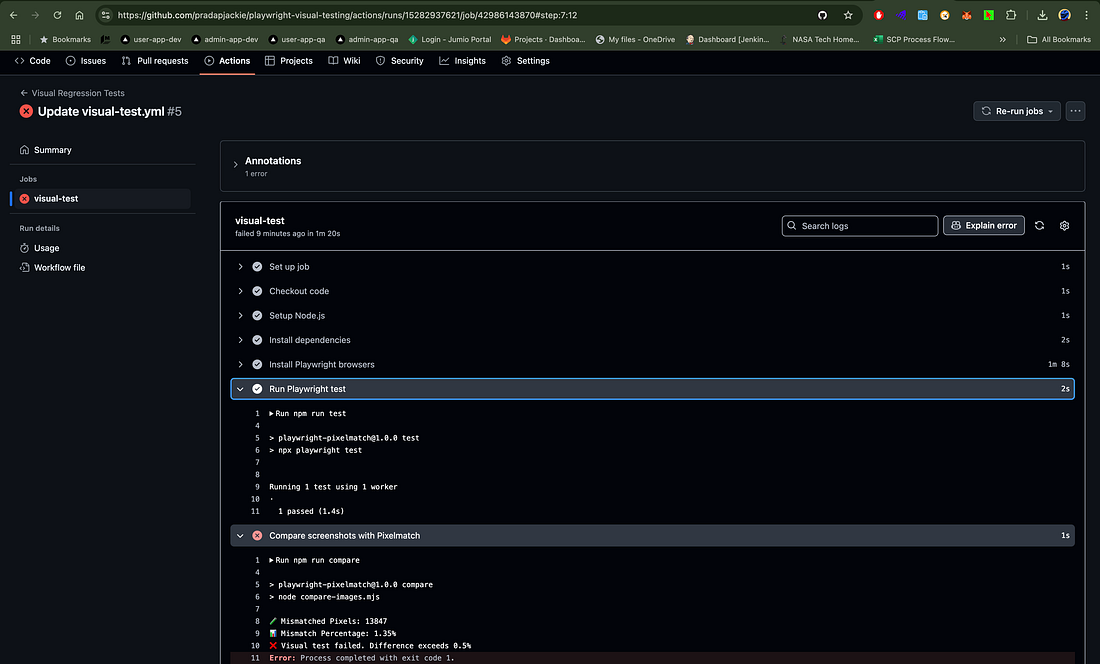 Playwright + GitHub Actions 视觉测试流程图
四、接入 CI 的成本账:GitHub Actions 免费额度够不够?
先给结论:够,而且绰绰有余。下面是具体数字。
额度账:GitHub Actions 对公共仓库完全免费,私有仓库每月 2000 分钟免费额度。5 条黄金路径的 E2E 套件并行跑,通常 2–4 分钟(含 npm install 缓存命中、浏览器下载缓存)。按每天 push 5 次、每次全量跑一遍算:每天约 20 分钟,一个月 30 天约 600 分钟——私有仓库额度用了不到三分之一,公共仓库直接不用算。这就是"最小套件"的经济意义:用例数翻 4 倍,CI 时间翻 4 倍,免费额度立刻吃紧——克制直接等于省钱。
workflow 配置(.github/workflows/e2e.yml,直接复制):
name: E2E

on:
push:
branches: [main] # 只在合入主分支时跑:feature 分支靠本地跑
pull_request: # PR 必跑:拦住翻车代码合入
branches: [main]

jobs:
e2e:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4

- uses: actions/setup-node@v4
with:
node-version: 20
cache: npm # 依赖缓存:install 从 2 分钟压到 20 秒

- run: npm ci
- run: npx playwright install --with-deps chromium
# --with-deps 装系统依赖;只装 chromium:见配置节的 ROI 判断

- run: npx playwright test
env:
# 测试用的环境变量走 GitHub Secrets,别写进仓库
TEST_USER_PASSWORD: ${{ secrets.TEST_USER_PASSWORD}}

- uses: actions/upload-artifact@v4
if: failure() # 只有失败才上传:省 artifact 存储和时间
with:
name: playwright-report
path: |
playwright-report/
test-results/
retention-days: 7 # 报告只留 7 天:失败截图看完就删,不囤积
关键行解读:
on.push.branches: [main]+pull_request:feature 分支 push 不跑 CI(本地npx playwright test自测),只有合入主线和 PR 才跑——这是把 CI 分钟数砍掉一半的最简单手段;cache: npm:不加缓存,每次 CI 多花 1–2 分钟装依赖,一个月下来就是几百分钟烧掉;if: failure()+retention-days: 7:E2E 产物的存储也是成本,失败才留、只留 7 天,排查够用;- Secrets 走环境变量:E2E 需要测试账号密码时放 Secrets,绝不 hardcode——AI 生成的 workflow 经常把测试密码写死在 yaml 里,审校时第一眼就看这个。
失败截图与录像自动上传就是上面配置里 upload-artifact 那一步。CI 红了之后,点开 Actions 里失败的 run,拉到页面底部的 Artifacts 下载 playwright-report,用浏览器打开 index.html,能看到每一步的截图、失败点的录像、trace 时间线。一人团队没有 QA 帮你复现,这个报告就是你的"第一现场勘查"。判断:配 E2E 不配报告上传,等于装了监控不接显示器。
flaky 测试的三板斧(按顺序用,别跳步)
第一板斧:重试(retries: 2)。配置里已经有了。它解决的是"偶发网络抖动、CI 机器慢"这类真随机失败。判断:如果一个用例靠重试能稳定过,它就是 flaky 不是真 bug,先放行、再修根因,别让它在半夜卡住你的发布。重试是止血,不是治病。
第二板斧:等待策略。把 waitForTimeout 全换成"断言用户可见状态"。Playwright 的 auto-waiting 会轮询到条件满足或超时(默认 5 秒,可调)。九成的 flaky 死在这个环节,修完这一条,flaky 数量级下降。
第三板斧:隔离测试数据。每个用例用独立账号和独立数据(时间戳邮箱、随机订单号),用例之间不共享、不依赖执行顺序。最隐蔽的 flaky 来源是"用例 A 建的数据被用例 B 删了"——并行跑起来之后,这种交叉污染会从"偶尔"变成"经常"。终极方案是每个 worker 连独立的测试数据库,一人项目用"时间戳隔离"通常就够了。
三板斧用完还 flaky 的用例,降级处理:移到 nightly 跑(每天凌晨跑一次),不卡 PR。E2E 的信誉只有一次——一个长期飘红的套件,结局永远是"大家开始无视 CI",那比没有测试更糟。这是维护心法的前置判断。
五、维护心法:测试代码也是 AI 维护的
最后一节回答那个终极问题:套件搭起来了,三个月后会不会烂尾?
先说残酷的真相:E2E 套件烂尾从来不是因为"写测试难",而是因为"需求变了,测试没跟上"。你让 AI 把注册流程从两步改成三步(加了个邮箱验证页),它改完业务代码就收工了,测试还停留在两步的假设上,下次 CI 全红,你花一晚上修测试,从此对 E2E 产生心理阴影。断掉这个循环的办法只有一条:把"同步更新测试"写进需求变更的工作流,让 AI 维护测试代码,就像它维护业务代码一样。
需求变更时的标准流程(prompt 模板)
需求变更:<粘贴需求描述,如"注册流程增加邮箱验证码步骤">
受影响的测试文件:<粘贴 tests/ 下相关 spec 文件内容>

任务:
1. 更新上述测试用例以匹配新流程,遵循既有约定
(getByTestId 定位、只断言用户可见结果、禁止 waitForTimeout、
测试数据时间戳隔离、复用 Page Object)。
2. 列出需要新增 / 修改的 data-testid。
3. 如果某条黄金路径因此需要拆分或新增,说明理由。
4. 不要动与本次需求无关的用例。
第 4 条是护栏:AI 有"顺手重构"的毛病,不加约束它可能把你整个 tests/ 目录"优化"一遍——而这正是我们要防的翻车模式本身。
"每周只花 1 小时"的具体账
这是本篇的成本承诺,拆开给你看:
- 周一看 CI(10 分钟):过去一周的 run 全绿?绿就关页面。红了→点开报告→看是真 bug 还是 flaky。真 bug 修业务代码(那是开发时间,不算维护成本);flaky 进下一项;
- 修 flaky(30 分钟):把 flaky 用例的失败录像和截图丢给 AI,prompt:"这个用例在 CI 偶发失败,附失败截图和 trace,按三板斧(等待策略→数据隔离)修复,只改这个文件。"大多数 flaky 都是等待策略问题,AI 一轮就能修好;
- 需求同步(20 分钟):本周有需求变更?用上面的 prompt 让 AI 同步更新用例,你审 diff。没变更?这 20 分钟省下来。
合计 60 分钟。一人团队、一周 5 次发布、5 条黄金路径——这个数字是按"套件保持最小"的前提算的。什么时候会超?两种情况:第一,你没忍住加到了 20 条用例(flaky 和维护量非线性增长);第二,你三个月没管它,攒了一屁股技术债。前者靠第二节的克制,后者靠每周这 1 小时。判断:E2E 维护不是技术问题,是纪律问题——而纪律恰好是可以用日历提醒外包的。
三个"反直觉"的维护判断
第一,测试代码的 AI 生成比例应该比业务代码更高。业务代码你要逐行审,测试代码的初稿可以放心让 AI 写——因为测试跑一遍就知道对不对,验证成本极低。这是测试代码独有的优势:它是"自验证"的。
第二,删测试比加测试更需要勇气,也更重要。黄金路径变了(比如砍掉注册流程改成邀请制),旧用例要第一时间删掉,而不是"先留着"。一个挂掉的旧用例对套件信誉的杀伤力,远大于少一条覆盖。
第三,E2E 是你和 AI 协作的"契约"。你会越来越频繁地让 AI 大改代码,E2E 套件就是你敢让它放手改的底气。没有这条护城河,你每次 prompt 都要加一堆"别改坏 XX"的约束——那些约束词迟早会超过你的 token 预算,而 5 条 E2E 用例跑一遍只要 3 分钟。
一句话总结:策略篇告诉你"为什么测",这篇给你"怎么测"——Playwright + 5 条黄金路径 + data-testid 约定 + GitHub Actions,搭建 1 小时,每周维护 1 小时,免费额度内跑完。AI 时代写代码越来越快,唯一稀缺的是"敢发布的底气",而底气是可以工程化的。
相关文章
模型、提示词、工具三者任一变化,都可能在你庆祝修好的同时悄悄破坏 Agent 的能力。本指南从零讲透评估基准搭建:从真实流量挑 20 个 case 组成黄金测试集,代码评分器加校准过的 LLM 裁判,三层分开记分,防自欺清单,CI 门禁真正拦下合并,再用线上采样与影子运行形成闭环。
你不需要一个客服团队,你需要一套客服系统。这篇指南给一人开发者完整实战打法:工单分类记账、三层防御漏斗、能挡工单的 FAQ 写法、AI 回复草稿流水线(含可直接抄的 prompt 模板)、5 类快捷回复模板、绝不能自动化的红线,以及每周 30 分钟复盘 SOP——每一节都附带拿来即用的模板。
谷歌、摩根大通、Weaviate、法国 DINUM、印尼 Tangerang 市政府——五支互不相关的安全团队,各自独立确认并修复了自家 MCP 服务器里的同一个 SSRF 漏洞。独立研究者 Syed Anas Mohiuddin 的十月更新指出:这是协议设计的结构性缺陷,而非某家的实现问题。本文拆解 Protocol Pivoting 攻击原理、对比五家修复方案,并给 vibe coder 一份最小防御清单,附 10 月 23 日 MCPCon 演讲前瞻。