不用每次重发整段对话了:Anthropic 让 Claude 记住上下文,Agent 等待时间缩短约 35%
2026 年 11 月 2 日,Anthropic 把 message threads 推入 Claude 平台公开测试版:对话第一次全量发送,之后每轮只发新增消息。50 万到 100 万 token 的请求,首次 token 中位等待时间降低约 35%,但 token 用量、定价与速率限制都不变。本文讲清它怎么工作、限制在哪。
2026 年 11 月 2 日,Anthropic 在 Claude 平台上把 message threads(消息线程)推入公开测试版。做法一句话就能说清:对话第一次照常全量发送,之后每一轮只发新增的消息,剩下的历史由 API 帮你存在服务端。Anthropic 称,在 Claude Code 里默认开启后,50 万到 100 万 token 的请求,首次 token 的中位等待时间降低了约 35%。这是一个很“后端”的更新——没有新模型、没有新界面、没有新能力,改的只是请求在网上传输的方式。但对每天跑长会话 Agent 的人来说,等待时间的缩短是每天都能感受到的差别。

它解决的是什么问题
要理解 message threads,先要理解 Agent 的对话是怎么跑的。一个编码 Agent 在一次会话里可能发出几百次请求,每次请求都要把之前所有的消息和工具结果再发一遍。对话还短的时候,这没什么感觉;但当历史攒到几十万 token,事情就变了味:每一轮都在重复上传一份越来越厚的对话记录,API 还要重新校验、重新分词,然后模型才开始回答。等待时间里的大头,不再是模型思考,而是“把历史再搬运一遍”。
Anthropic 在公告里点名了三类最受影响的场景:长时运行的编码 Agent(每一轮工具结果和文件编辑都在让对话变长)、计算机操作 Agent(截图如果每轮都重传,体积会非常可观)、文档与图片密集型工作流(请求体本身就很大)。这三类有一个共同点:上下文越长,重复搬运的浪费越严重。message threads 的思路就是把“搬运”这件事从客户端手里接过来,交给服务端在两次请求之间暂存。
这个痛点对 VibeFix 的读者并不陌生。用 Claude Code 做 vibe coding 的人都有过类似体验:会话跑到后面,每一轮都要等上更久,明明只改了一行代码,响应却越来越慢。很多人以为是模型变慢了,其实相当一部分时间花在了重复发送历史记录上。message threads 瞄准的正是这段“看不见的等待”。
三步怎么用:创建、续接、重放
用法本身很简单,只有三个动作。第一次请求照常发送完整对话,加上系统提示词和工具定义,并带上 thread 参数声明创建一个线程;API 把对话连同 Claude 的回复一起存在这个线程里,以响应的 ID 为标识。从第二轮开始,请求里只发新增的消息,并附上上一条响应的 ID,系统提示词和工具定义不用再发——API 会在服务端把对话拼回去,再调用模型。
直接调 API 的话,还需要在每个请求上加 beta 请求头 message-threads-2026-08-12。官方 SDK 则提供了 thread 助手函数,帮你处理这些细节:自动加请求头、第一轮发全量、后续只发增量,并在特定错误下自动重放一次完整对话。对大多数开发者来说,用 SDK 的助手函数是正路,自己手写请求体容易在字段规则上踩坑。
第三个动作是重放(replay),也是最容易被忽略的一环。线程是尽力而为(best-effort)的:API 不保证每一轮都成功存下来,也不通过任何响应告诉你“这一轮存没存上”。你只有在下一轮续接失败时才知道——续接请求会返回 404 错误,错误码为 thread_not_found。这时客户端必须用自己保存的完整对话重新创建一个线程。换句话说,你自己的程序永远是真相来源,服务端线程只是加速层。Anthropic 的文档明确要求应用保留自己的完整对话副本,并从一开始就把重放路径写好,而不是等到 404 出现才临时想办法。
最容易误解的一点:账单不动
这是整篇公告里最重要的一句澄清,也是最容易被误读的地方:message threads 不省 token、不省钱。Claude 每一轮仍然会完整阅读整个对话,所以 token 用量不变,定价与速率限制也不变。变小的只是请求体——Anthropic 称,长对话里的中位请求体积从约 800 KB 降到了 1.8 KB——以及随之缩短的首次 token 等待时间。
把这句话翻译成大白话:你付的钱一分不少,省下来的是“等模型开口”的时间。对按量付费的用户来说,这个功能不会让账单变薄;对追求响应速度的 Agent 来说,它让长会话的每一轮都更快开始。两者不要混淆。如果有人告诉你“用了 threads 能省 35% 的成本”,那是对公告的误读——35% 说的是等待时间,不是费用。
这里还有一个相关的细节:线程不会替你做提示缓存(prompt caching)。想让每一轮都命中缓存,仍然需要在每次请求上显式带上同样的顶层 cache_control。一个带 thread 的请求最多只能有 4 个缓存断点,顶层那个也算一个,多了会返回 400 错误。线程与缓存是两套并行的机制,各管各的事,不能互相替代。
数字核查:35% 是怎么来的
公告里最亮眼的数字只有一个:50 万到 100 万 token 的请求,中位首次 token 等待时间降低约 35%。这个数字来自 Claude Code 的实际 rollout,而且已经对大多数 Claude Code 用户默认开启。但有三点必须说清楚。
第一,这个数字的适用范围很窄:它只针对 50 万到 100 万 token 之间的大请求。更短的对话能快多少,Anthropic 没有公布数字。如果你平时的会话只有几万 token,别指望也能快 35%,实际收益要自己测。
第二,Anthropic 没有公布样本量、时间范围与测量方法。这是一个厂商自报的内部 rollout 数据,不是第三方基准测试。截至目前,也没有独立机构对 message threads 做过复测。把它当作“方向可信、幅度待验”的参考,比当作承诺更合适。
第三,800 KB 到 1.8 KB 的请求体积缩减,同样是 Anthropic 自报的长对话中位数字,描述的是传输体积,不是模型实际处理的内容量。Claude 每一轮照样要读完整对话,所以这个数字再好看,也不会反映在账单上。评价这个功能,要看它承诺的指标——首次 token 等待时间——而不是被体积数字带偏。
限制清单:用之前先读完这一节
公开测试版就意味着“能用,但有边界”。Anthropic 的文档把限制写得很具体,这些限制直接决定了 threads 适不适合你的场景。
五分钟过期
线程在最后一次请求后 5 分钟过期,每存入一条响应就重新计时;API 最迟在最后一次使用后 1 小时内删除线程。超过 5 分钟没动静,线程就没了,下一轮必须重发完整对话。对持续运行的 Agent 来说,5 分钟通常够用;但对“人看一步、再发一步”的半自动流程来说,review 一轮很容易超过 5 分钟,线程大概率已经过期。设计流程时,要把 5 分钟当作硬约束,而不是“大概够用”。
只能追加,不能改写
线程是追加式(append-only)的:每个响应 ID 只能被续接一次。想修改、分支或回溯早期的消息,就必须开一个新线程。压缩历史、清理思考内容这类上下文管理操作也大多不兼容——按文档说法,按需压缩(compaction on demand)与绝大多数上下文编辑都不能与 threads 同用,只有一个例外是带 keep: "all" 的 clear_thinking_20251015。这意味着 threads 适合“往前走”的任务,不适合需要反复整理历史的任务。
字段规则很严,错了就 400
创建请求与续接请求能带的字段是不一样的,搞错就会报错。系统提示词与工具定义只在创建请求里发,续接请求里带上它们——哪怕值是 null——都会返回 400。模型、工具选择、思考配置、MCP 服务器、上下文管理、输出配置、容器技能、顶层缓存控制、beta 头集合,这些在每一轮都必须保持一致,否则会返回 thread_fingerprint_mismatch。想中途换模型或换工具集,只能开新线程。相对自由的字段只有 max_tokens、停止序列、流式开关、元数据与服务层级。SDK 的助手函数会帮你管这些,但手写请求的人必须逐项核对。
合规与功能 exclusions
这一条对企业用户最关键:message threads 不适用于零数据保留(ZDR)与 HIPAA 场景。线程内容以加密形式保存在服务端内存里,不写入磁盘,但这仍不符合 ZDR 的要求。同样不能与 threads 同用的还有消息批处理(Message Batches)、token 计数 API、按需压缩,以及开启了推理钩子(inference hooks)的组织。还有一个管理上的缺口:目前没有 API 可以列出、读取或删除线程,你既看不到服务端存了什么,也删不掉它,只能等它过期。
它不是记忆功能,别和别的“线程”搞混
名字里带 thread 的东西,Anthropic 家里不止一个,搞混的代价不小。首先,message threads 不是 Claude 那个带做梦与显著性筛选的 Agent 记忆功能——它不做长期记忆、不筛选重要内容、不跨会话保留,5 分钟不用就消失,更像一个“请求之间的暂存篮”。其次,它也不是 Claude Managed Agents 里的 session threads,那是另一套会话机制,文档里专门做了区分。
更准确的定位是:message threads 是请求层面的加速机制,不是应用层面的状态管理。你的应用仍然要自己存对话、自己做记忆、自己处理分支与压缩。把它理解成“给长对话的快递服务”更贴切:东西还是你的,只是搬运的人换了。
对谁最有用,对谁可以先等等
最值得立刻用上的是三类人。第一类是直接用 Claude Code 的人:功能已经默认开启,大多数用户什么都不用做,长会话的等待时间就会缩短——当然,11 月 3 日的 Claude Code 更新日志里并没有提到这次开启,所以不要去找一个特定的版本号来验证。第二类是自己搭 Agent 循环的开发者:用 SDK 的 thread 助手函数接入,收益直接体现在每一轮的首次 token 等待上。第三类是跑计算机操作或文档图片密集型 Agent 的团队:截图与大文件不再每轮重传,请求体积的缩减最明显。
可以先等等的也有三类。第一类是合规要求严格的团队:需要 ZDR 或 HIPAA 的场景目前直接排除,推理钩子开启的组织也不能用。第二类是人机协作节奏慢的流程:每步 review 超过 5 分钟,线程会反复过期,收益会被重发抵消。第三类是重度依赖批处理、token 计数或按需压缩的管线:这些功能目前与 threads 互斥,接了 threads 就得先放下它们。对这三类来说,等正式版再看兼容性清单的变化更划算。
对 vibe coding 的人意味着什么
对用 Claude Code 做 vibe coding 的人来说,这次更新几乎是“无感升级”:不用改配置、不用换版本,长会话的等待时间就可能变短。真正值得做的,是下次跑长任务时留意一下体感——以前越跑越慢的会话,现在是不是稳住了。如果体感没变化,也不必纠结:你的会话可能还没到 50 万 token 的量级,收益本来就不明显。
对自己写 Agent 循环的开发者,意义更大一些。过去为了让长会话快一点,常见的办法是自己做上下文压缩、截断历史、或者忍受越来越长的等待。message threads 提供了一个官方的、不用改模型行为的加速路径,代价是接受 5 分钟过期与追加式写入的约束。接入成本不高:SDK 助手函数包办了大部分细节,关键是把“保留自己的对话副本 + 404 后重放”这条路径从第一天就写进代码,而不是事后补。
还有一个更长远的视角:Anthropic 最近一年在做的事,其实有一条暗线——先是提示缓存(2024 年 8 月),再是上下文工程指南(2025 年 9 月),现在是 message threads。主题始终是同一个:长上下文 Agent 的成本与延迟。缓存解决的是“重复计算”的问题,threads 解决的是“重复传输”的问题。两者叠加,长会话 Agent 的体验才真正接近“实时”。对独立开发者来说,这意味着用 Claude 做长任务 Agent 的门槛又低了一点:以前只有大团队才玩得起的长会话优化,正在变成平台默认能力。
如果 5 分钟不够用,流程该怎么设计
5 分钟过期是 threads 最硬的一条约束,流程设计必须围着它转。最直接的办法是让 Agent 的每一轮都落在 5 分钟内:工具调用快、模型响应快,线程就能一直续下去。一旦流程里有人要 review、要等外部系统返回、或者要跑一个耗时的编译与测试,线程过期几乎是必然的。这时正确的做法不是去“保住线程”,而是接受它会过期:客户端手里始终有一份完整对话,过期后用这份副本重新创建线程,代价只是一次全量重发。把“过期后重建”当作正常路径来设计,而不是当作异常来处理,系统反而更稳。
还有一个细节值得写进代码:续接失败时要先读错误码再重放。404 有两种完全不同的含义——线程找不到了,或者模型不存在。前者重发完整对话就能解决,后者重发多少次也没用。Anthropic 的文档把错误码放在 error.details.error_code 里,thread_not_found 才走重放路径。SDK 的助手函数已经处理了这层判断,自己手写请求的人要把这个分支写清楚,否则一次普通的线程过期可能被误判成更严重的问题。
还有一个群体值得单独提一句:正在用 Claude API 搭自己 Agent 产品的独立开发者。过去这类产品要在“响应快”和“上下文全”之间做取舍,常常被迫在客户端做各种截断与压缩的脏活。message threads 把一部分脏活收进了平台,虽然换来的是 5 分钟过期与追加式写入的新约束,但对大多数“用户发一句话、Agent 连续干活”的产品形态来说,这个交换是划算的。关键是上线前先在真实流量上跑一周,看看 404 重放的频率与等待时间的实际变化,再决定要不要全量推广。
判断:小改动,真收益,但别指望它省钱
message threads 是 Anthropic 近期发布里最“不性感”但最实在的一个。它没有新模型、没有新界面,改的只是请求怎么发。但对长会话 Agent 来说,首次 token 等待时间是每天要付几百次的税,35% 的缩减如果属实,体感会很明显。Claude Code 用户已经默认受益,自己搭 Agent 的开发者用 SDK 助手函数接入也不难。
但它的边界同样清晰:不省 token、不省钱、5 分钟过期、追加式写入、不兼容 ZDR 与 HIPAA、不兼容批处理与按需压缩。把它当成“长会话加速器”是对的,把它当成“记忆系统”或“省钱工具”是错的。正式版什么时候来、短对话的收益是多少、会不会放宽 5 分钟限制,Anthropic 都还没有说法。
建议的做法很简单:Claude Code 用户不用做任何事,留意长会话体感即可;自己搭 Agent 的开发者,先在测试环境接上 SDK 的 thread 助手函数,在自己的真实流量上测首次 token 等待时间,再决定是否推广到生产。厂商的 35% 是参考值,你自己的数字才是决策依据。
评论 (0)
原始来源
相关文章
2026 年 10 月 28 日,微软推出 Microsoft Pro Badge,首枚为 GitHub Copilot 专项:不用考试、不用花钱,点一下参加、继续照常写代码,熟练度引擎会按你日常使用 Copilot 的情况打分。本文讲清三件套、五档、它到底评估什么,以及三个还没回答的问题。
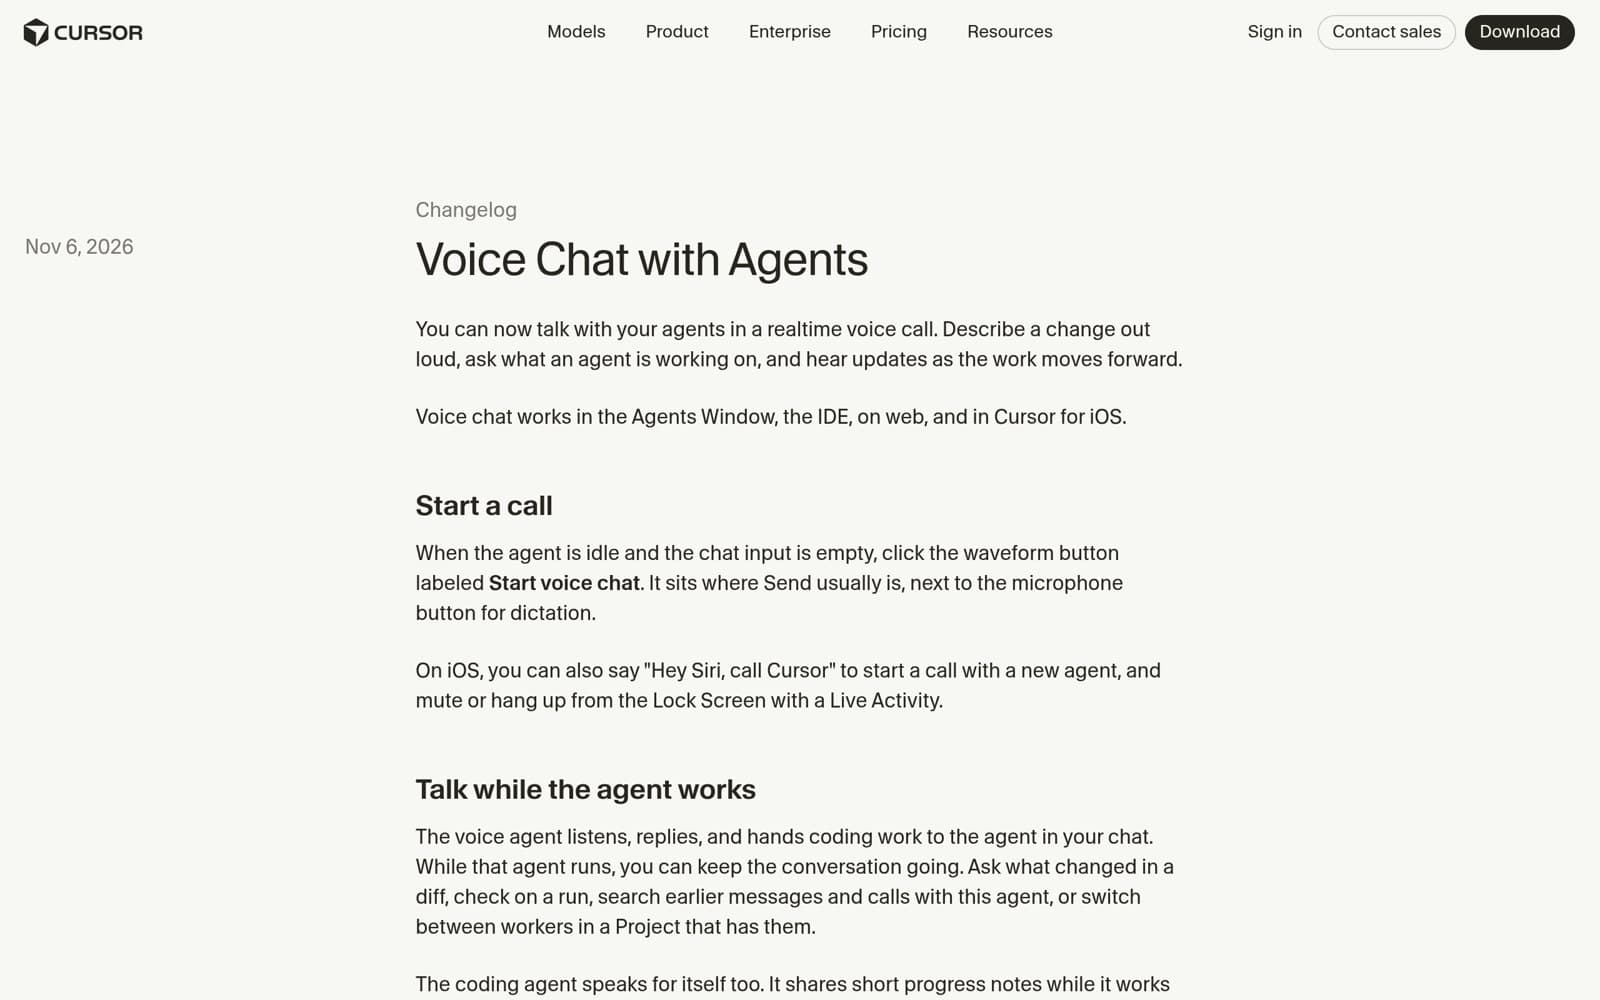
2026 年 11 月 6 日,Cursor 上线 Voice Chat with Agents:Agents Window、IDE、网页端与 iOS 都能跟 Agent 打实时语音电话,语音层由 Grok Voice 负责,写代码的还是你选的模型。继前一天 Live Apps 之后,IDE 从“打字指挥”转向“开口指挥”。本文拆开它怎么开、通话里能干什么、限制在哪,以及还没回答的问题。
2026 年 11 月 6 日,Anthropic 发表记忆研究长文:笔记、显著性判断与离线“做梦”。宝可梦红实验里,写 413 个记忆文件的模型只拿 1 个徽章,写 9 个文件的拿了 4 个。本文拆解 CL-Bench 闭环、显著性实验与做梦纠错、建 wiki 的全部数据,以及能直接复用的三条工程结论。