Agent 的记忆不是越多越好:Anthropic 拆解“笔记、显著性判断与做梦”
2026 年 11 月 6 日,Anthropic 发表记忆研究长文:笔记、显著性判断与离线“做梦”。宝可梦红实验里,写 413 个记忆文件的模型只拿 1 个徽章,写 9 个文件的拿了 4 个。本文拆解 CL-Bench 闭环、显著性实验与做梦纠错、建 wiki 的全部数据,以及能直接复用的三条工程结论。

2026 年 11 月 6 日,Anthropic 在官网发表了一篇研究长文《The components of agent memory》,讲的是一个 vibe-coding 开发者每天都会撞上的问题:给 Agent 配记忆,到底该记什么、什么时候记、记错了怎么办。文章没有发布新产品,也没有开源新工具,它值钱的地方是实验和数据——Anthropic 让 Claude 在长程任务里自己写记忆、自己判断什么值得记,再用离线"做梦"回放日志纠错,然后把每一环的得分都公开了。
结论先说在前面,一句话:Agent 的记忆不是越多越好。记 413 个文件的模型只拿了 1 个徽章,记 9 个文件的模型拿了 4 个;给强模型立死规矩反而拖后腿;真正让记忆变好的,是离线整理的那一步——Anthropic 把它叫作"做梦"(dreaming)。这篇文章就是把这三件事拆开讲清楚。
一、先说清楚:这篇和 10 月的记忆文章不是一回事
站内 10 月已经发过四篇记忆主题的内容,读过它们的读者可能会问:这篇是不是又在炒同一锅饭?先划清界限,避免重复。
10 月 3 日的《Agent 记忆论战》写的是 Kevin Liao 的一篇博客引发的争论:他说记忆插件本质上是"RAG 切片抽奖",Hacker News 炸出 300 多条讨论,那是一场观点之争。同月,《Devin 学会"做梦"》讲的是 Cognition 给 Agent 记忆立的开源标准——Devin 把记忆做成仓库里的文件和规范,那是一套工程标准。《腾讯混元 Hy Memory 2.0》则是腾讯开源的一个 30B 模型,专门判断"AI 该记住什么",加一个打通 10 款工具的记忆中枢,那是一个产品。还有站内的指南《Agent 记忆系统设计》,讲的是三层架构和记忆污染怎么清理,那是一份设计手册。
而 Anthropic 这篇是 11 月 6 日新发表的研究长文,全新实验与数据首次披露:它不争论插件对不对、不发布新产品、不给架构图,而是回答一个更底层的问题——记忆这件事本身由哪几个部件组成,每个部件到底起了多大作用。论战讲"该不该记",这篇讲"记这件事是怎么运转的"。两边互补,不重复。如果你只想知道"我的 Agent 该怎么配记忆",直接看第八节的结论;如果你想知道这些结论从哪来,往下看实验。
二、Agent 记忆到底指什么:先把三个"不是"划掉
Anthropic 在文章开头先给"Agent 记忆"下了个窄定义:模型从经验里学到的知识——包括和用户的互动、被分派的任务——并且能在会话之间保留下来,以后可以读到的上下文。这个定义特意排除了另外三种东西,搞清楚这三点,后面的实验才看得懂。
第一,不是改权重。训练时调模型内部参数,那叫学习,不叫记忆。第二,不是单次会话里的上下文学习。一场对话里模型现学现用,窗口一关就没了,那也不算。第三,不是 compaction 摘要。Claude 写摘要替换掉旧对话、腾出上下文窗口继续干活,那是上下文管理,不是跨会话的记忆。
剩下的才是本文讨论的记忆:会话之间留存的经验知识。Anthropic 借了人脑的分工来打比方:人脑的海马体在事情发生时快速记下经历,只有部分经历会在睡梦中被巩固成长时知识;Agent 也一样,会话中写"记忆笔记"标记显著事件,离线"做梦"时回放日志、修正错误、生成新的表征。整篇文章就是沿着这两个动作展开的:什么时候写笔记、写什么,以及离线那一步到底能干多少活。
三、记忆是一次预测:CL-Bench 的闭环实验
文章里有个说法值得先拎出来:记忆偶尔是一种预测。Agent 写下一条规则,等于在预测"这个规律以后还会用上";写下一个验证过的事实,等于在预测"以后的我会想直接用它,不用再查一遍"。预测得准,记忆就是资产;预测得不准,记忆就是垃圾。这个判断标准,贯穿了后面所有实验。
第一个实验用的是 Continual Learning Bench(CL-Bench)1.0,一个测 Agent 长程学习能力的基准。其中一道题让 Claude 查数据库回答一连串问题,每答完一题会告诉它正确答案,它可以写一条记忆帮自己答后面的题。理想的学习循环是这样的:答错了,记下失败,想几个"为什么错了"的理论,逐个验证,再把验证过的结论写成规则。
不同模型走到哪一步,差距非常大。Sonnet 4.6 只走到了"想理论"这一步:它的记忆文件夹里散落着一堆文件,每个文件列着几个没验证过的猜想。Opus 4.7 进了一步,把笔记整合成一份参考文档,开始标注哪些事实查过、哪些还没确认。Sonnet 5 再进一步,每道题答完都会标注"已确认",答错了就写一条更正。
Opus 5 是第一个真正把循环闭合的模型:它的大多数条目都包含一条规则、这条规则是怎么验证为真的、前面题目的答案,以及一路踩过的陷阱的明确警告。Opus 5.5 和 Sonnet 5.5 同样闭合了循环,用记忆记录验证过的答题规则,带记忆的得分和 Opus 5 大致相当——虽然它俩不用记忆时的基线本来就略高一点。
这组实验说明了两件事。第一,写记忆本身不难,难的是"验证"这一步:猜想和规则之间,差的是一次动手检验。第二,模型越强,越能自己把循环跑完;弱一点的模型不是不会写记忆,是写完了不验证、不回头看。对开发者来说,这意味着记忆系统的第一道关不是存多少,而是每条记忆有没有"怎么验证的"这一栏。
四、记多少才对:宝可梦红的 413 个文件 vs 9 个文件
第二个实验最直观,也最有冲击力。Anthropic 让 Claude 玩《宝可梦红》,测它判断"什么值得存进记忆"的能力。每个模型开局拿到一个记忆文件夹,边玩边读写。跑到大约 1 万步时,研究人员对比了 Sonnet 3.7 和 Fable 5 的文件夹。
Sonnet 3.7 的做法是"什么都可能有用,那就什么都记"。它的记忆文件夹里是遭遇战的存档:每打一场架、每捡一个道具、每遇到一个 NPC,都单独存一个文件。最后它写了 413 个记忆文件,分在 225 个文件夹里,只拿到 1 个徽章——徽章是游戏进度的标志。
Fable 5 只写了 9 个文件,分在两个文件夹里,外加一个顶层文件 global.md,拿到了 4 个徽章。
问题不只是文件多。游戏状态一直在变,Sonnet 3.7 那份事无巨细的记录一直在过期。越往后玩,它花在翻记忆上的时间越多,花在玩游戏上的时间越少。跑到 1 万步上下,它开始建第四个"总"记忆文件夹;接下来的 17 步里,它新建了 6 个文件、删了 9 个,游戏里一步都没走。记忆从帮手变成了负担。
Fable 5 的分法很不一样:屏幕上每回合都能直接读到的东西——比如身上有多少钱、玩家在地图的哪——它不存,因为存了也是重复;它只存那些"不写下来就会丢"的东西:策略、计划、验证过的规则。它的 global.md 像个仪表盘,放着当前目标、打道馆的预写计划和它自己定下的记忆使用规则;locations 文件夹放各条路线的走法,gameplay 文件夹放它摸索出来的游戏机制。比如连续 7 个精灵球都没抓住鲤鱼王——游戏里最容易抓的宝可梦之一——之后,它写下了一条:"如果连续 3 个球以上失败,就换个节奏(在菜单步骤之间多按几次等待),上次就是这么抓到的。"
Opus 5.5 也走了精简路线:一个小文件夹跟踪当前目标和下一步,边玩边改写,最后通关了整场游戏。
这组对照给开发者的启示很实在:记忆的第一条筛选标准不是"重要吗",而是"不记会不会丢"。能从环境里随时重新读到的状态,别存;只有模型自己推导出来的策略、计划和验证过的规则,才值得占一个文件。413 个文件不是勤奋,是不会取舍。
五、别给强模型立死规矩:引导方式的实验结果
知道该记什么之后,下一个问题是:要不要告诉模型该怎么记?Anthropic 的答案分两层,对强模型和弱模型完全不同。
在 CL-Bench 上,他们一开始只告诉模型"有个记忆文件夹可以用",没给具体规则。这点通用指引对 Opus 4.7 和 Opus 5 已经够了,两者都有效用上了记忆,得分明显提升。然后他们试了逐条加死规矩,每次只加一条,对比有规则和没规则时记忆带来的增益。
结果是:给 Opus 5 和 Opus 4.7 立一条"只记失败"的规矩,两者的记忆增益大部分都被吃掉了。对强模型来说,让它自己判断什么显著,比提前定死规则更有效;硬性规则反而会削弱表现。Anthropic 的常规做法也印证了这一点:对前沿模型,他们只给简单指引——有人要求时写记忆笔记,或者明显值得记的时候写——判断权留给模型自己。
但对弱一点的模型,引导的帮助最大。Sonnet 4.6 常常不读记忆文件夹里的文件,也不去验证自己"为什么答错"的理论。研究人员提示它"先读记忆再答题,并且明确验证理论",它的基准分接近翻倍。Sonnet 5 不用提示自己就会这么做:10 次里有 9 次答题前先读记忆;Sonnet 4.6 不到一半。
这对实际开发是条可以直接用的分界线:模型越强,给的指引越要松,只讲记忆是干什么用的,不讲具体怎么用;模型越弱,越要给明确的操作步骤——先读、再验证——而不是只给一句"有个记忆文件夹"。同一套提示词用在所有模型身上,是浪费。
六、做梦是干什么的:纠错、建 wiki、分层
会话里写的笔记有个先天缺陷:写的时候模型只看得到当下,不知道未来会发生什么,也不知道自己是不是记错了。写错的笔记会被以后的会话当真话读。做梦就是补这个窟窿的:离线回放原始记录,对照着改。
最生动的例子还是宝可梦红。游戏里要穿过月见山(Mt. Moon),入口在地图西侧、出口在东侧,入口附近有个单向悬崖:掉下去就回到来时的路,爬不回来。Claude 拿山脚的宝可梦中心(PokéCenter)当地标,往哪边走取决于它以为宝可梦中心在山的哪一侧。有一次它错误地记下宝可梦中心在东侧,走出中心后宣布"月见山在我身后了",笔记更新为"月见山已完成"。其实根本没有。没走几步它掉下悬崖,回到来时的路,而它的导航工具没显示这次掉落,于是它得出结论"我往西走过头了",以为自己一直在正确的一侧——其实没有。
研究人员对这份含错笔记的文件夹跑了一轮做梦:Claude 把笔记和会话 transcript 对照,抓住了错误并改写了笔记。拿着改好的笔记,它直接走回月见山,最终到达了华蓝市(Cerulean City)。而没纠错的对照组,三次掉回同一条老路,第三次之后它写道"我要停下来,而不是一直循环"。系统自动回复让它继续,于是它一路走回之前的城镇常青市(Pewter City),想回血补给——这趟运行到最后也没到华蓝市。一条错笔记和一条对笔记的差别,就是通关和原地打转的差别。
做梦的第二种本事是建新的表征。Anthropic 用了"wiki"这种形式:一组由 Claude 写和维护的页面,把它对某个主题的了解汇总起来、互相链接,相当于给记忆画一张地图。他们拿 Stainless 公司(Anthropic 5 月收购的一家软件公司)约 35 万份内部文档、约 4.2 亿 token 做语料,出了 25 道题,让 Opus 5 的 Agent 在 128 轮会话里探索文件、写改 wiki 页面、合并重复项、对照原文核查说法。做梦轮次从 2 轮扩到 128 轮,25 道题的得分从 13% 升到 48%。
wiki 最管用的时候,是和搜索一起用。只用 wiki 答题,最好成绩是 48%;只用搜索工具,是 53%;两者一起用,随着 wiki 变丰富,总分从 54% 升到 61%,每道题还省了约 2 万 token。另一组关于并购的 24 道题里,一半以上需要跨多个文档找信息、还要做判断或计算,查 wiki 的得分是 87%,只用搜索是 73%。wiki 不是搜索的替代品,是搜索的地图。
做梦还能把笔记往记忆层级上推。被推到顶层的记忆会在每场会话开始时预先注入上下文,模型不用搜、甚至不用知道有东西可搜。但注入要谨慎:注入的记忆占 token,错的笔记会被带进每一场会话,而且塞进去也不保证模型照做——Claude Code 的文档就警告过,指令文件越长,遵守率越低。所以顶层必须保持很小,做梦的大量工作其实是把细节往下挪、只留链接在上面。Claude Code 的自动记忆就是这么做的:它不会把全部自动记忆都塞进每场会话,只加载 MEMORY.md 的前 200 行或 25KB,那几行是个索引,告诉 Claude 它知道什么、去哪找。
做梦还能按目标塑形记忆。另一组实验用 Harvey LAB 基准加一组并购合同文档,让 Claude 生成法律简报。起初的 wiki 生成指令没告诉 Claude"这个 wiki 是干什么用的",几份合同的关键条款被几个 Agent 同时写进一张共享表,互相覆盖,丢了不少。拿这份 wiki 生成的简报只覆盖了 57 个事实里的 41 个(72%)。研究人员让 Claude 反思失败、改写指令、重建 wiki:每份合同独立成页、由单个 Agent 写、逐字引用条款而不是汇总进共享表。改进后的 wiki 生成的简报,100% 的标准都达到了。做梦不光能整理记忆,还能发现"指令本身哪里不对"。
做梦还能补会话留下的缺口。建 wiki 时,Claude 有时会链接到还没建好的页面,第二轮做梦能把这些缺口补上:在一项任务里,它找到 9 个指向缺失页面的链接,把它们重定向到已有的同文档页面,还新增了 3 个页面,包括一份索引。
七、wiki 也会失控:当天图大过帝国
但这篇文章没有只报喜。wiki 也会失控,而且失控的方式很值得记住。
在一项 LAB 任务里,wiki 长得比原始文档本身还大。Anthropic 引用了博尔赫斯那篇一页纸的小说《论科学的精确性》:里面的制图师画了一张和帝国一样大的地图,精细到毫无抽象可言。Claude 也干了同样的事:做了一份极其详细的 wiki,实际上什么都没抽象出来。地图和领土一样大,地图就没用了。
另一项 LAB 任务里,简报的标准大多能从单个文档里用文本搜索直接找到,wiki 没有带来明显增益。wiki 不是万能药:信息本来就集中、一次搜索就能命中的任务,建 wiki 是白花算力;只有信息分散在多处、需要跨文档拼起来的时候,地图才值钱。做梦要花算力,什么值得做梦、多久做一次,都得按记忆被访问的频率和变化的可能性来调——Anthropic 在文末承认,这一点他们也还在摸索。
八、给 vibe-coding 开发者的三条结论
这篇研究长文离工程很近,读完可以直接拿走三条结论。
第一,少记,记规则。记忆文件夹的第一条筛选标准是"不记会不会丢":能从环境里随时读到的状态别存,只存模型自己推导出的策略、计划和验证过的规则。每条记忆最好带上"怎么验证的"和"踩过的陷阱",像 Opus 5 那样写成"规则+验证依据+陷阱警告",而不是像 Sonnet 4.6 那样攒一堆没验证的猜想。文件少不是偷懒,是取舍。
第二,引导要分模型给。强模型只给目标、不给死规矩,"只记失败"这种硬性规则会吃掉它的记忆增益;弱模型要给明确的操作步骤,"先读记忆、再验证理论"这句提示能让 Sonnet 4.6 的分数接近翻倍。提示词不是越细越好,要看模型自己会不会读、会不会验证。
第三,记忆要离线整理,而且顶层要小。会话里写的笔记一定会错、一定会过期,得留一条离线纠错的通道:对照原始记录回放,改写错的笔记。整理出来的东西要分层,常用的、验证过的推到顶层预先注入,但顶层必须小——Claude Code 只读 MEMORY.md 前 200 行的做法就是现成的参照。剩下的放下面、留链接,需要时再查。
还有一条隐含的提醒:记忆系统要按任务调。合同简报的例子说明,wiki 的组织方式得跟着任务走——条款是核心,就每份合同独立成页、逐字引用;换个任务,组织方式也得换。没有一种记忆结构能通吃所有任务。
九、Anthropic 自己也没回答的问题
文章结尾列了一串开放问题,诚实得值得单独拎出来。
什么时候创建记忆?会话里当场写,显著性抓得准、立刻就能用,但会分散模型对主任务的注意力;推迟到离线做梦,省了注意力,但产出不一定马上能用。怎么保证记忆持续新鲜?模型会写错、环境会变,做梦能修,但全量检查所有记忆不现实——也许该优先处理最可能变化、访问最频繁的那部分。还有一个更基础的设想:也许 transcript 搜索才是记忆的地基,wiki 这类表征是建在它上面的楼;但表征要花算力维护,还得防着它积累错误和幻觉。
这些问题没有答案,Anthropic 的原话是"我们还有很多要学"。但这篇的价值恰恰在这里:它把记忆拆成了可以逐个实验、逐个打分的部件——笔记、显著性判断、做梦、表征、分层——而不是把它当成一个玄乎的整体。做 Agent 记忆的开发者,第一次有了一张可以对照着调的清单:记什么、怎么记、错了怎么办、什么时候整理,每一项都有实验数字撑着。
对 vibe-coding 来说,这篇的意义比一场论战实在。论战告诉你别人错在哪,这篇告诉你自己该怎么做:少记、记规则、离线整理。Agent 记不住不是因为它记性差,是因为没人教它什么值得记——现在,Anthropic 把这份教学大纲和考试成绩一起公开了。
一手来源:Anthropic 官方研究博客《The components of agent memory》,2026 年 11 月 6 日发表(页面 Additional Details 栏标注 Published: 2026-11-06T00:00:00.000Z,Updated: 2026-11-06T21:15:32.000Z)。本文所有实验数据与引述均出自该文;与本站 10 月记忆主题文章的划界见第一节。
评论 (0)
原始来源
相关文章
2026 年 11 月 6 日,Cursor 上线 Voice Chat with Agents:Agents Window、IDE、网页端与 iOS 都能跟 Agent 打实时语音电话,语音层由 Grok Voice 负责,写代码的还是你选的模型。继前一天 Live Apps 之后,IDE 从“打字指挥”转向“开口指挥”。本文拆开它怎么开、通话里能干什么、限制在哪,以及还没回答的问题。
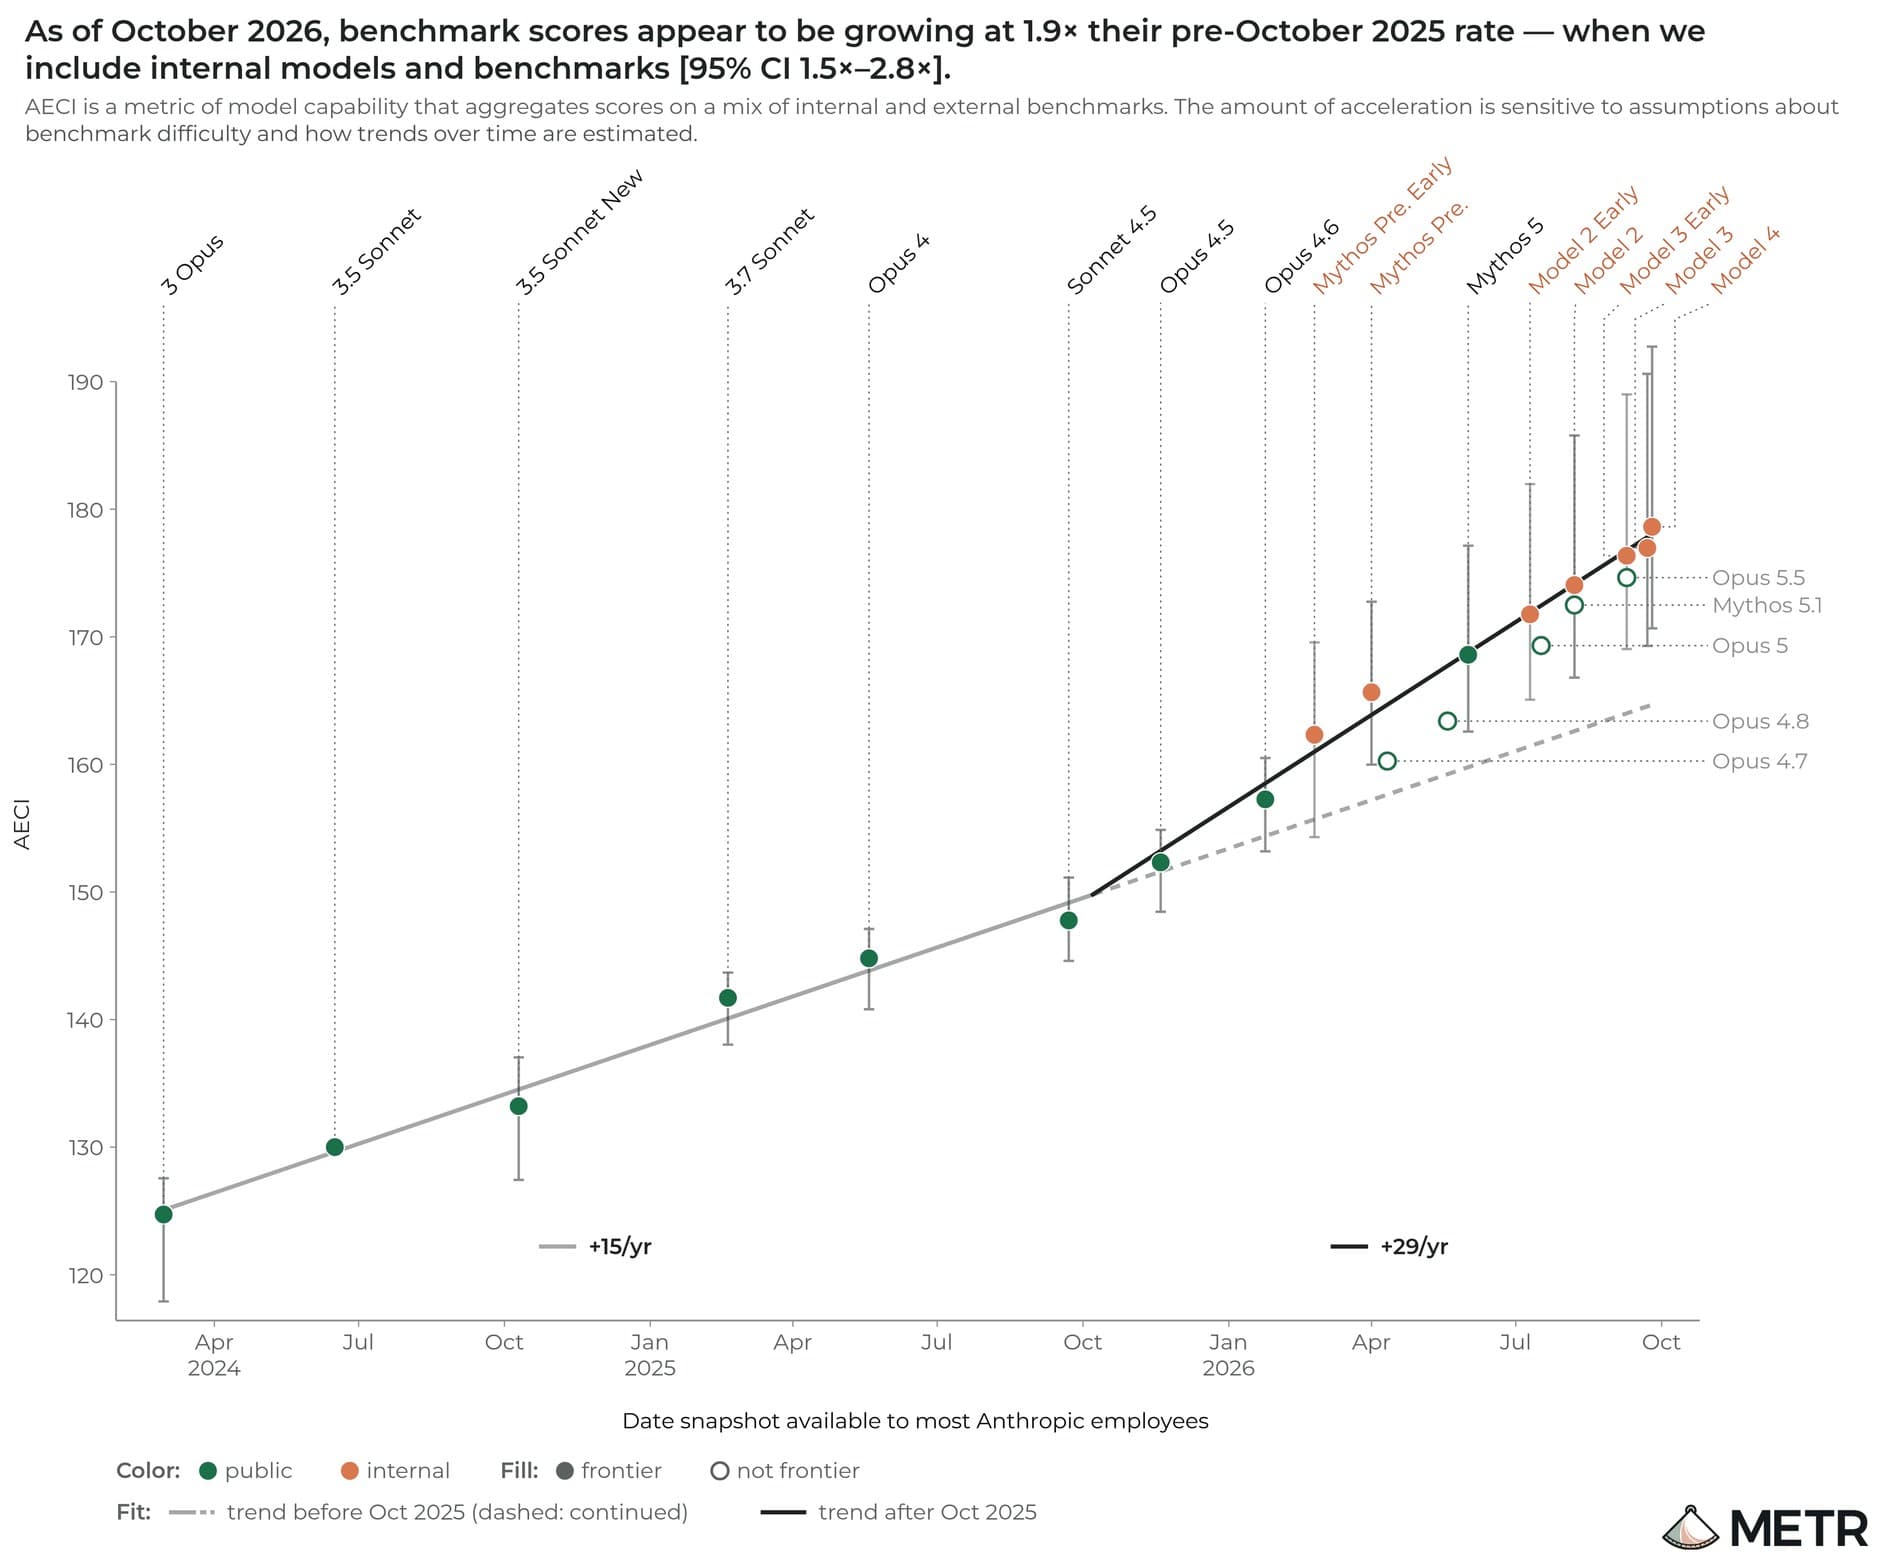
METR 在 Anthropic 内部待了 11 周,评估称其模型能力进步速度约为此前两倍,加速大部分来自 AI 自身。但最关键的证据大多被涂黑了。
11 月 5 日 Thinking Machines 发布第二代模型 Inkling 2 Small:594B 总参数、17B 激活,智能指数 31 分,能 4.5 小时无人值守训出一个预测模型。但权重现在还是闭源的,Apache 2.0 开源要等下周安全测试做完。