Google 把 AI 视频生成做成基础设施:Gemini Omni 1.2 Flash 全面可用,15 秒只要 1 美元
11 月 5 日 Google 正式推出 Gemini Omni 1.2 Flash:单条视频做到 15 秒、720p 每秒 0.07 美元、多轮对话编辑不用重生成。真正的新意不是更长更便宜,而是 AI 视频第一次可以按生产流程来用。
11 月 5 日,Google 把 Gemini Omni 1.2 Flash 推向了全面可用(GA)。这不是一次常规的模型小版本更新:这是 Gemini Omni 这个视频生成系列第一次以正式产品的身份、带着企业级服务保障和公开定价站到开发者和商家面前。同一天,Google 还把单条视频的时长上限从 10 秒拉到 15 秒,把 720p 生成的价格砍了三成,降到每秒 0.07 美元。15 秒的 720p 片子,按这个价算大概 1.05 美元。

一句话说清这次发布的分量:AI 视频生成正在从“演示很惊艳、生产不敢用”变成“可以写进预算表、排进上线计划”的基础设施。时长、价格、编辑方式这三件事同时动了,缺一不可。只加时长不降价,那是给发烧友的玩具;只降价不给编辑,那是给一次性尝鲜的;三者一起给,才是给要成批量出片的团队准备的。
这次到底新在哪
先把官方博客里列出来的变化摊开说。第一,时长:原生生成和编辑最长 15 秒,比 Omni 1.1 的 10 秒多了一半,而且时长可以在 3 到 15 秒之间以 1 秒为步长自由指定。第二,价格:比 1.1 便宜 30%,720p 每秒 0.07 美元。第三,多轮对话编辑:同一条片子可以一轮一轮改,换产品、换背景、改光线天气、换画幅,都不用从头重新生成,而且多轮编辑覆盖完整的 15 秒片子。第四,参考图 adherence 更好:可以用人物、产品、风格图,加上最长 3 秒的动态参考片段和音频提示去引导生成,脸、衣服、包装上的字、品牌色在不同机位下能保持住。第五,口型和对白更自然:多说话人可以分别指定声音,口型同步更清楚。第六,运镜更稳:连续的 FPV 穿梭、大变焦、环绕这类复杂运镜,跳切明显少了。
另外两个容易被忽略的细节同样重要。工作流上可以先用 360p 或 720p 快速出草稿,改到满意再把成片放大到 1080p 或 4K——这意味着试错成本和成片成本分开了,团队不用为每一次“看看效果”都付全价。交付层面,输出带有人眼看不见的 SynthID 水印,并且支持 Provisioned Throughput,也就是可以预留算力保证高峰期的出片速度。这两条是写给采购和法务看的,不是写给演示观众看的。
15 秒为什么是个关键数字
10 秒和 15 秒,看起来只差 5 秒,但对实际用途来说是两道不同的门。10 秒够做一个氛围镜头、一个转场、一个产品的旋转展示;15 秒够讲完一个最小的故事——一个问题、一个转折、一个落点,或者一个广告的完整结构:钩子、卖点、行动号召。Google 在博客里举的例子也很直白:完整的社交广告、产品讲解、一次 360 度虚拟试穿。这不是修辞,是 15 秒刚好踩进短视频广告和电商详情页视频的常用长度。
更值得注意的是时长可以按秒指定。3 到 15 秒、每秒一档,意味着出片长度可以按投放位去裁:信息流要 6 秒、详情页要 12 秒、品牌片要满 15 秒,不用再靠后期剪辑去凑。这对成批量生产广告变体的团队来说,比单纯的“更长”更实用。时长自由度的真正价值不在最长那一档,而在每一档都能直接用。
便宜了,但账要这么算
每秒 0.07 美元,15 秒就是 1.05 美元左右。这个数字单独看很便宜,但别急着把它理解成“一条广告 1 美元”。真实账单由三部分组成:出草稿的钱、改来改去的钱、放大的钱。Omni 1.2 Flash 的打法是把这三段拆开计价:草稿可以用低分辨率便宜出,修改只改局部不重生成全片,放大只对最终选定的成片做一次。省钱的逻辑不在单价,而在“不用为每一次尝试付全价”。
反过来也要说清楚:这次降价针对的是 API 的 720p 生成。不同入口的计费方式不一样——Flow、Vids、Gemini App 和 Google Ads 各有自己的套餐和额度规则。博客里提到,Vids 里 15 秒生成对有 Google 账号或 Workspace 订阅的用户没有额外费用,Gemini App 里的 15 秒则在向 Google AI Ultra 订阅用户逐步开放。也就是说,同一条 15 秒片子,在哪个入口做、花多少钱、多久能用上,是三件不同的事。做预算之前,先确认自己走的是哪个入口。
真正的卖点不是时长,是“改得起”
如果只看参数表,15 秒和降价 30% 是最显眼的两行。但对真正要把 AI 视频用进工作流的人来说,多轮对话编辑才是这次最值得认真对待的变化。过去 AI 视频最大的隐性成本不是生成的那几秒,而是“改一个字就得整条重来”:换个背景重抽一次,改句台词重抽一次,调个光线又重抽一次。每一次重抽不仅花钱,还可能把上一版里已经满意的部分也改丢了。
Omni 1.2 Flash 的做法是把同一条片子当成一个可以持续对话的对象:背景可以从条纹帐篷一轮轮换成橡树林、马厩、集市、石头城堡,人物表演、盔甲反光和机位保持不变;产品可以换、光线可以改、画幅可以调,底子不动。这对广告团队的意义很具体:一个母版可以快速衍生出不同受众、不同投放位的多个变体,而不用为每个变体重新讲一遍需求。AI 视频的竞争,正在从“谁生成的画面更惊艳”转向“谁改起来更便宜、更可控”。
参考图 adherence 的提升也是同一条逻辑的延伸。虚拟试穿的例子很能说明问题:一张模特图加三套衣服的正反面照片,生成 15 秒里 360 度转身加跳切,模特的身份、每件衣服的剪裁、垂感和背面细节都要保持住。这类任务考的不是想象力,是“别跑偏”。对电商和品牌方来说,跑偏一次就是一次不可用的成片,consistency 不是加分项,是及格线。
别急着吹:官方没给的数字
这篇博客有一个值得注意的空白:全文没有给出任何量化评测分数。关于一致性、画质、口型同步的说法,全部来自官方挑选的并排示例,而不是第三方基准测试。示例当然可以说明问题,但它说明的是“这个模型在官方挑好的场景里能做到什么”,不是“它在你的场景里有多大概率做到”。任何一篇转述这条新闻的文章,如果把示例效果写成普遍性能,都是在替 Google 把话说满。
Google 自己也在博客里留了口子:快速体育动作、快速台词切换、复杂物理效果还在持续改进中。这句话翻译过来就是:高速运动和复杂物理仍然是这个模型的弱项。打算用它拍运动产品、动作场面或者有复杂物理互动的镜头的人,应该先拿自己的素材实测,而不是看发布会示例下单。
还有一个现实提醒:GA 不等于所有人今天都能用上。API 和企业侧是这次 GA 的主体,Gemini App 里的 15 秒是向 Ultra 订阅用户逐步开放,Workspace 的推送也要一到三天陆续到达。看到“全面可用”就以为打开 App 就能生成 15 秒,很可能会扑空。
谁该马上试,谁可以等等
最适合马上动手的是三类人。第一,做短视频广告和电商内容、已经有固定母版和投放流程的团队:15 秒加多轮编辑直接对应“批量出变体”这个真实需求,可以先拿一条已有母版做对照测试。第二,已经在用 Gemini API 或 Google Cloud 做视频能力的开发者:GA 意味着服务等级协议和预留算力可以谈了,之前 preview 阶段不敢接的生产需求,现在可以重新评估。第三,在 Flow 和 Vids 里做内部讲解、培训视频的内容团队:多轮改稿的成本下来了,内部视频的迭代可以更快。
可以再等等的也有一类:对画质和一致性要求极高、且没有容错空间的品牌大片。官方示例很漂亮,但没有公开基准分数背书,第一次合作就押注在关键战役上,风险不在模型,而在你没有留出验证的时间。先跑小批量、建自己的对照样本,再决定放量,是更稳妥的顺序。
三个入口,三种用法:API、Flow 与 Vids、广告
同一条 15 秒片子,在 Google 的体系里有三个不同的入口,面向的是三类不同的人,搞混了很容易用错地方。第一个入口是 Gemini API 和 Google Cloud:这是给开发者的,模型名是 gemini-omni-1.2-flash,可以在 Google AI Studio 里先做原型,再按文档和定价页接入自己的产品。GA 的意义主要落在这里——有了正式可用状态,才有服务等级协议可谈,才有 Provisioned Throughput 可以预留算力,之前预览阶段不敢接的生产需求,现在可以重新排期了。
第二个入口是 Flow 和 Google Vids:这是给内容团队的。Flow 里可以直接导演场景、做多轮编辑;Vids 里用 Google 账号或 Workspace 订阅就能生成 15 秒片子,博客的说法是不产生额外费用。对做内部培训、产品讲解、周会汇报视频的人来说,这个入口比 API 更直接:不用写代码,不用算 token,按提示词改几轮就能交差。第三个入口是 Google Ads:给投放团队的,视频广告可以直接按投放位批量生产。三个入口的计费、额度和开放节奏各不相同,选入口之前先问一句:我是要把它接进产品、还是要它帮我出内容、还是要它帮我跑广告?答案不同,入口也不同。
还有一个容易踩的坑:Gemini App 里的 15 秒目前只向 Google AI Ultra 订阅用户逐步开放。如果你不是 Ultra 用户,打开 App 大概率还看不到这个选项。这不是 bug,是分批推送。等不及的人可以先走 AI Studio 或者 Vids,别在 App 里反复刷新。
对独立开发者意味着什么:产品视频不用外包了
这条新闻对 VibeFix 的读者还有一层更具体的意义。独立开发者和小团队做产品,最缺的往往不是想法,而是“让人一眼看懂这是什么”的演示视频。以前要么自己剪、要么外包,花钱花时间,还不一定改得动。现在 15 秒、多轮改、按秒计费这三件事凑在一起,意味着产品演示视频可以变成开发流程里的一环:上线前用一张产品截图加几句提示词出一条 15 秒讲解,改两轮,放大到 1080p,挂到落地页上。成本是一两美元,时间是十几分钟。
虚拟试穿的例子换成软件产品也一样成立:一张界面截图、一段操作流程描述,生成一条带运镜的产品演示;换个配色方案、换句文案,不用重新拍、不用重新剪。对做 AI 产品的独立开发者来说,这等于把“会不会做视频”这个门槛从技能清单里划掉了。当然,前提是你接受 AI 生成视频的质感上限:它适合做讲解、演示、广告变体,不适合做需要精确还原真实操作的高保真录屏。分得清这两件事,它就是个好工具;分不清,它就是个坑。
水印这件事,正在变成标配
输出自带人眼看不见的 SynthID 水印,这行字在博客里只占半句,但它代表的趋势值得单独说一句。AI 生成内容的可识别性,正在从各家自愿做的加分项,变成行业默认的交付标准。Google 从图片、音频到视频都在推同一套水印,逻辑很清楚:当生成成本跌到 1 美元一条的时候,产量会暴涨,暴涨之后第一个出问题的一定是“这条视频是不是真的”。水印解决不了所有问题——它能被裁剪、能被转录、能被绕过——但它至少给了平台和观众一个核验的起点。
对使用者来说,这意味着两件事。第一,用它生成的商用内容要预留合规检查:你的投放平台认不认这个水印、你的客户接不接受 AI 生成标识,这些问题要在上线前确认,而不是上线后被问。第二,别把水印当成免责牌:水印证明的是“这是 AI 生成的”,不是“内容是真实的”。视频里出现的人物、产品、场景如果与事实不符,水印帮不了你背书。
上手之前,先确认四件事
如果你打算今天就试,先把这四件事确认了再动手。第一,走哪个入口:API、Flow、Vids 还是 Gemini App,不同入口的价格和开放状态不一样。第二,1080p 和 4K 放大的单价:博客只给了 720p 每秒 0.07 美元,高分辨率放大的价格没有单独公布,批量出片之前先在定价页上核对。第三,你的场景是不是它的弱项:快速体育动作、快速台词切换、复杂物理效果,官方自己承认还在改进,先拿自己的素材跑一小批验证。第四,免费层:定价页显示 API 免费层暂不可用,按量付费是这次 GA 的默认姿势,别按免费额度去排预算。
降价背后的算盘:视频生成的价格战才刚刚开始
降价 30% 这个数字,值得单独算一笔账。按官方给出的每秒 0.07 美元反推,Omni 1.1 的 720p 大约是每秒 0.10 美元——这个旧价是算术反推,不是官方公布的数字,但量级不会错。按这个口径算,一条 15 秒的片子从 1.50 美元降到 1.05 美元,单条看省了不到 5 毛钱,没什么感觉。但批量生产的账不是这么算的:一个广告系列要出 10 个草稿、每个 15 秒,旧价是 15 美元,新价是 10.50 美元;一个月跑 20 个系列,差价就是 90 美元。一年下来,省的是真金白银。
更关键的是降价发出的信号。视频生成这个赛道,模型能力正在快速趋同:15 秒、多轮编辑、参考图一致性,这些功能今年内大概率会成为各家的标配。能力趋同之后,竞争就会落到两个地方:价格和工作流。Google 这一轮同时打了这两张牌——降价 30%,再把“草稿便宜出、成片再放大”的工作流写进官方推荐做法。这不是一次孤立的调价,更像是在给全行业定锚:720p 视频生成的合理价位,应该往每秒 7 美分这个方向走。
对用户来说,好消息是价格战通常只会让选择变多、价格变低;要盯的变量是两条:第一,1080p 和 4K 的放大价格会不会跟着降——现在博客只给了 720p 的价,高分辨率还是个未知数;第二,其他厂商会不会跟进,以及跟进的时候拼的是价格还是别的东西。如果对手选择不跟进价格、反而去拼更长的时长或者更好的物理效果,那这场竞争会比单纯的价格战有意思得多。无论如何,对要批量出片的团队来说,现在是重新谈合同、重新比价的好时机:手里有了 Google 这张公开报价,再去谈别家,心里就有底了。
一句话判断
Gemini Omni 1.2 Flash 的真正新闻不是“视频能到 15 秒了”,而是 Google 第一次把 AI 视频当成可以签合同、排预算、跑生产的产品来卖:公开定价、预留算力、水印合规、多轮编辑。时长和降价让它便宜,编辑和一致性让它可用,GA 让它可信。三者缺一个,都撑不起“基础设施”这四个字。这次三者齐了,剩下的就是各家拿自己的真实需求去验证——示例很漂亮,账单很便宜,但你的场景是不是真能用,还得自己跑一遍才知道。
评论 (0)
原始来源
相关文章
11 月 5 日 Thinking Machines 发布第二代模型 Inkling 2 Small:594B 总参数、17B 激活,智能指数 31 分,能 4.5 小时无人值守训出一个预测模型。但权重现在还是闭源的,Apache 2.0 开源要等下周安全测试做完。
2026 年 11 月 5 日,OpenAI 发布 GPT-6 Cyber:ExploitGym 48.5%,一次扫描写出 948 个 Linux 提权利用、挖出 81 个 Firefox 高危漏洞。但它不对公众开放,只给通过 Daybreak Red 审核的安全团队。
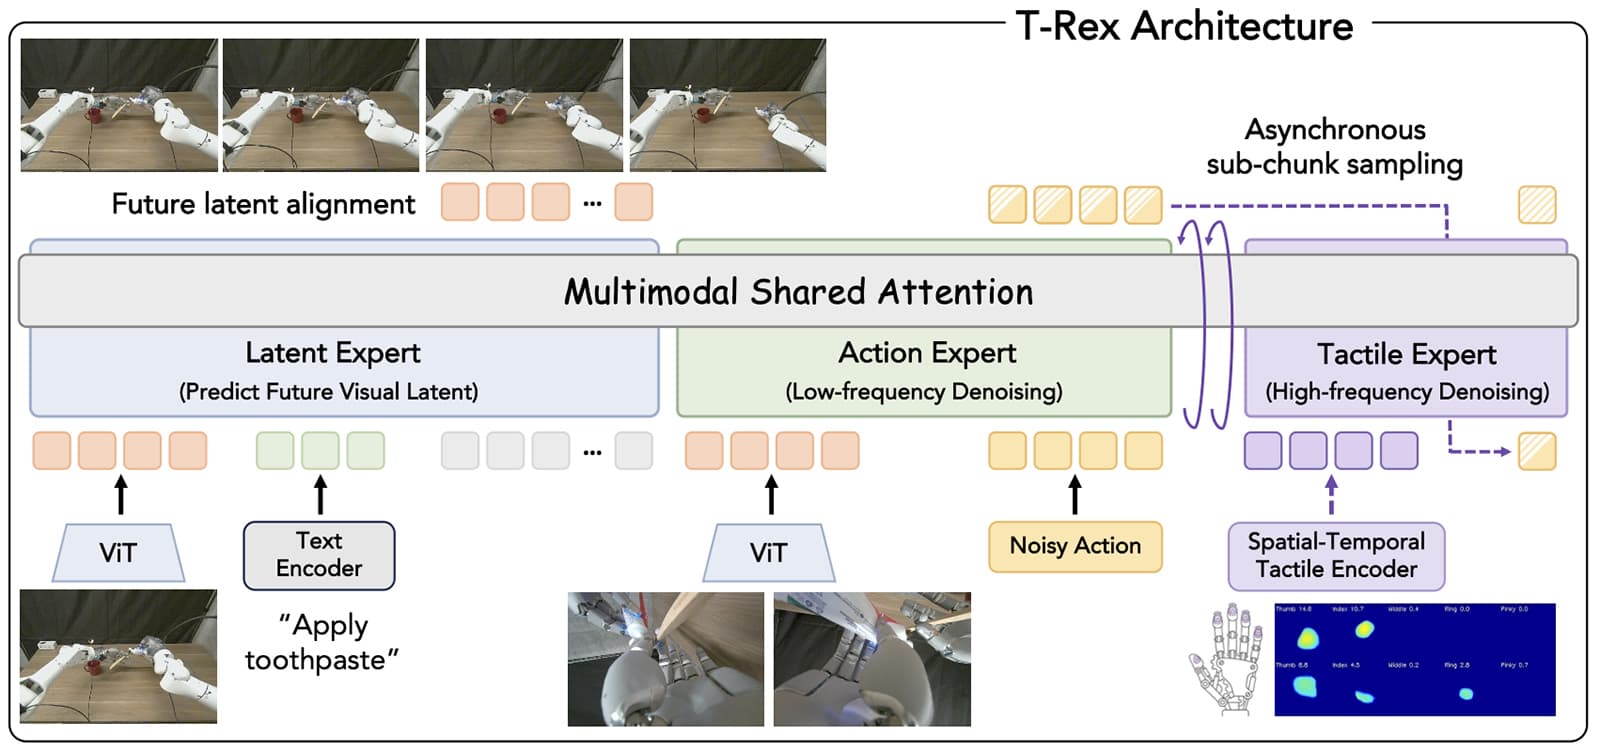
2026 年 11 月 5 日,松下联合 UC 伯克利、NVIDIA 与斯坦福发布 T-Rex:给 VLA 模型接上十根指尖的触觉,动作规划 5Hz、触觉修正 20Hz 双时钟并行。12 项精细操作平均成功率 65%,最强基线只有 35%;拿掉触觉,它自己跌回 42%。