机器人终于学会了“手感”:松下 T-Rex 凭指尖触觉挪鸡蛋、拧灯泡,成功率比纯视觉方案高 30 个点
2026 年 11 月 5 日,松下联合 UC 伯克利、NVIDIA 与斯坦福发布 T-Rex:给 VLA 模型接上十根指尖的触觉,动作规划 5Hz、触觉修正 20Hz 双时钟并行。12 项精细操作平均成功率 65%,最强基线只有 35%;拿掉触觉,它自己跌回 42%。
先说判断:视觉模型撞上的墙,触觉未必能撞开——但这次有人找到了绕开墙的路

2026 年 11 月 5 日,松下控股(Panasonic HD)联合松下美国研发公司、加州大学伯克利分校、NVIDIA、斯坦福大学、罗马第一大学与 ItalAI,发布了一个叫 T-Rex 的机器人操作模型,全名 Tactile-Reactive Dexterous Manipulation,直译是“触觉反应式灵巧操作”。它做的事情一句话就能说清:让双手机器人一边看、一边摸,摸到打滑、摸到捏得太紧,立刻改动作。
数字先摆出来:在翻书页、挪鸡蛋、挤牙膏、钥匙开锁、抽卡片、拧灯泡等 12 项需要精细力控的真实任务上,T-Rex 的平均成功率是 65%。之前最好的方法只有 35%。30 个百分点的差距,在机器人操作这个领域里不常见——它不是在某个单项上取巧,而是 12 项任务全都拿了第一。我的判断是:这篇工作的价值不在“65%”这个数字本身,而在于它证明了一件事——给视觉模型加触觉,粗暴地加是会起反作用的,得换个架构才行。这对所有在做具身智能、机器人 Demo 的开发者来说,都是一个值得记住的教训。
为什么机器人一直“手笨”?眼睛看得见,手指却没感觉
先把背景说清楚。现在主流的机器人操作模型叫 VLA,也就是视觉—语言—动作模型:摄像头看到画面、读懂一句人话指令,然后输出机械臂该怎么动。过去两年 VLA 进步很快,抓取、摆放、分拣这些任务做得有模有样。但一碰到需要“手感”的活,它就露馅了。
松下通稿里举的例子很实在:从一叠卡片里抽出一张、把钥匙插进去再拧动,这些动作人做起来全凭指尖的力、打滑和形变反馈,眼睛只是辅助。传统 VLA 主要靠摄像头,就算接了触觉信号,也常常把它当成静态输入——读一次就不管了,动作过程中接触状态变了,模型反应不过来。更麻烦的是两个现实瓶颈:第一,带触觉标注的大规模训练数据几乎没有;第二,视觉语言模型的更新频率很低,而触觉反馈需要高频控制,两边的节奏根本对不上。
这就解释了为什么 T-Rex 论文里有一组看起来很反直觉的对照数字:拿掉触觉信息,T-Rex 自己的成功率从 65% 跌到 42%;而把触觉硬塞进已有的 π0.5 模型里,成绩反而从 17% 掉到 6%。触觉不是“加上就变好”的调料,放错位置,它会拖垮整个系统。这组数字是整篇工作最诚实的部分,也是它最值得读的地方。
双时钟是核心:慢的想动作,快的改动作
T-Rex 的解法可以概括为“两个时钟各干各的”。它把模型拆成快慢两个专家:负责看画面、读指令的动作生成模块,大约以 5Hz 的频率规划整体动作;负责读指尖触觉的修正模块,以大约 20Hz 的频率实时微调。触觉每秒钟修正四次,视觉才更新一次——手指打滑、鸡蛋壳受力过大这种瞬间变化,不用等视觉模型重新跑一遍就能处理。
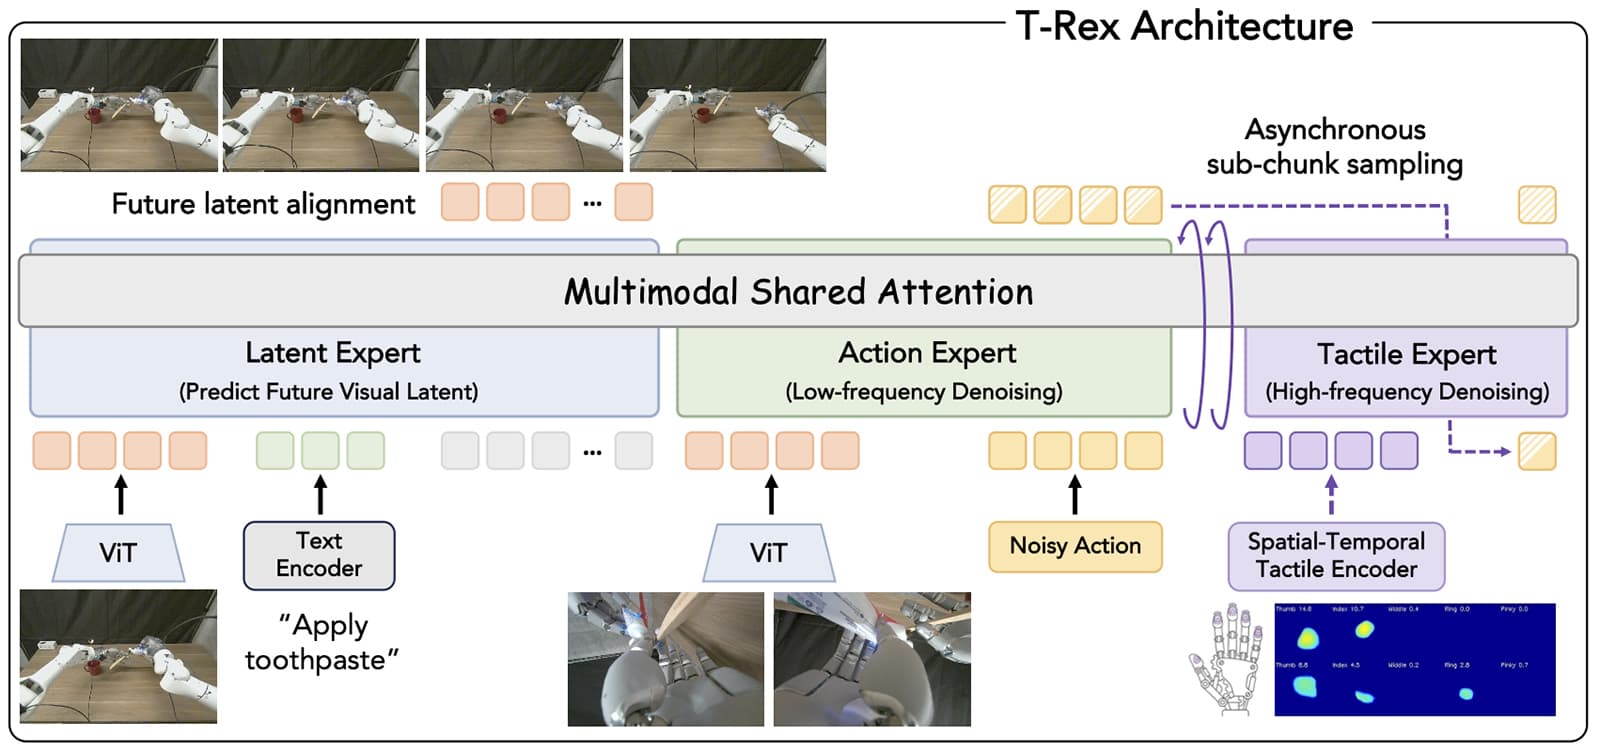
论文把这个结构叫做可变速率混合 Transformer(Mixture-of-Transformer,MoT),配上一个时序触觉 VQ-VAE 编码器,专门把高频触觉信号压缩成模型能用的表示。三个专家分工明确:潜变量专家预测未来的视觉状态,动作专家做低频去噪生成动作,触觉专家做高频去噪修正动作。松下通稿的架构图上,这三个模块由一层“多模态共享注意力”连在一起,触觉专家通过异步子块采样与动作专家交换信息。
说人话就是:别让跑得慢的大脑去管手指的毫秒级反应,给手指单独留一条高速通道。这个思路本身不算全新,但 T-Rex 是第一个把它在双手灵巧操作上完整做出来、并且用 12 项真实任务成绩单背书的工作。
100 小时“玩”出来的数据:先学人看世界,再学机器人摸东西
数据是这篇工作的另一半。研究团队用一台 58 自由度的双手灵巧机器人采集数据:Dexmate Vega-1 的两条 7 自由度手臂,加上两只 22 自由度的 Sharpa Wave 灵巧手,每只手五个指尖都装了触觉传感器。200 多种日常物品,搭配 22 种基础动作,攒出 7700 多段演示、总计 100 小时。每次演示同步记录头顶和手腕两个摄像头的画面、机器人自身状态与动作、十根指尖的力与形变信号,以及一句自然语言指令。
训练分三步走:先用 22889 小时的人类第一视角视频学通用的视觉与运动知识,再用这 100 小时带触觉标注的机器人数据做中期训练,最后每个任务只用大约 100 次演示做微调。这个“先看人、再摸物”的配方值得注意——它承认了一个现实:机器人自己的触觉数据太贵、太少,注定要靠人类视频先把底子打好,触觉数据只用在最关键的中期训练上。
数据集已经开源。这对做具身方向的独立开发者和小团队是个实打实的消息:以前想复现这类工作,第一步就被数据卡住了,现在至少有 100 小时带同步触觉信号的“玩耍”数据可以直接拿来用。论文挂在 arXiv 上,编号 2606.17055,项目主页也已上线。
12 项任务的成绩单:赢在哪里,输在哪里
评测覆盖三类难度:力敏感接触、形变感知操作,以及最难的双手力—形变协同任务。T-Rex 平均 65%,最强基线 EgoScale 35%,π0.5 是 17%,Tactile-VLA 15%,RDP 6%,给 π0.5 硬加触觉的版本 6%,ViTacFormer 只有 3%。T-Rex 在 12 项任务里每一项都是第一,比最弱的基线高出 20 倍以上。
但 65% 这个数字要冷静着看:它意味着每三次尝试仍有一次失败。鸡蛋挪过去了两次,第三次可能还是会碎;灯泡拧上了两次,第三次可能还是拧歪。这离“能进工厂、进仓库干活”还有距离。研究团队自己在通稿里给出的下一步也很实在:先瞄准制造业里的插拔、拧紧等装配环节,和物流里搬运柔软易碎品的场景,目标是减轻一线工人的负担、缓解人力短缺——而不是先讲一个“通用家务机器人”的大故事。这种克制,反而让这篇发布更可信。
还有一个时间点值得记:这项成果将于 11 月 9 日至 12 日在美国奥斯汀举行的机器人学习大会 CoRL 上报告。也就是说,现在看到的是会前通稿与 arXiv 论文,同行评议的现场讨论还没发生,数字全部来自团队自己的评测。读的时候要带着这层意识:65% 是厂商自报口径,未经独立复现。
这不是 T-Rex 第一次露面:8 月预告时数据集只有一半
眼尖的读者可能觉得 T-Rex 耳熟:今年 8 月,NVIDIA 的 Jim Fan 已经在 X 上预告过这项工作,当时提到的数据集规模是 50 小时、约 5500 段演示。到了 11 月正式发布,数据集翻倍到 100 小时、7700 多段演示,评测也从初步结果扩展成完整的 12 项任务成绩单。11 月 5 日这个节点,是它从“预告”变成“完整论文 + 开源数据集”的正式发布,而不是第一次出现。区分这一点很重要:如果你 8 月就关注过它,这次值得看的是翻倍后的数据和完整的基线对照,而不是重复读一遍旧闻。
对 vibe coding 开发者意味着什么
VibeFix 的读者大多不直接造机器人,但 T-Rex 里有两个经验是通用的。第一,往系统里加一个新信号之前,先问它跟现有模块的节奏合不合拍。触觉信号本身没错,错的是把它塞进为视觉设计的慢通道里——这和给 AI 应用加新功能时,不顾原有架构硬塞一个实时模块,最后把整体拖垮,是同一个坑。第二,公开数据集比公开模型权重更能降低门槛。T-Rex 的模型本身未必人人跑得起,但 100 小时带触觉标注的数据一开源,任何一个想试手具身方向的小团队都有了起点。
更远一点看,VLA 正在从“看得懂”走向“摸得着”。视觉模型教会机器人认东西,下一步就是让它在接触的瞬间做出反应。T-Rex 的 65% 说明这条路走得通,但也说明它刚起步。对普通人来说,最值得期待的不是某一天机器人能帮你挤牙膏,而是制造业和物流业里那些“眼睛看得见、手却做不好”的环节,开始有了能落地的解法。松下这篇通稿的落点也是这里:先解决工厂和仓库里的具体问题,再谈更大的愿景。
三个专家到底各管什么?把架构图翻译成人话
论文的架构图乍看很吓人:潜变量专家、动作专家、触觉专家,头顶上还压着一层“多模态共享注意力”。拆开看其实每块的分工都很直观。潜变量专家负责“想”:根据摄像头画面和语言指令,预测接下来几步视觉上应该是什么样子,相当于在脑子里先过一遍动作的画面。动作专家负责“动”:在低频下去噪、生成整体动作轨迹,决定手臂往哪走、手掌怎么张开。触觉专家负责“改”:指尖传感器一传回力与形变的信号,它就以高频去噪的方式给出残差修正——不是重算整个动作,只是在原动作上加一个小修正量,捏轻一点、松一点、换个角度。
这种“残差修正”的设计很关键。触觉专家不抢方向盘,它只在方向盘上做微调。这也是为什么它能跑到 20Hz:修正量小、算得快,不用每次都把视觉模型重新跑一遍。反过来想,如果让视觉模型以 20Hz 的频率全量重算动作,延迟和算力都扛不住,机器人会变得一卡一卡。双时钟的本质,是承认不同信号有不同的自然频率,硬把它们同步到同一个节奏上,谁都别想跑好。
触觉信号本身也不是直接灌进模型的。团队用了一个时序触觉 VQ-VAE 编码器,先把十根指尖连续的力与形变读数压缩成离散的“触觉词元”,再交给触觉专家。这一步很容易被忽略,但它决定了触觉信号能不能被模型稳定地用起来:原始触觉读数噪声大、维度高,直接喂给 Transformer 很容易学歪,先编码、再建模,是整个管线里很务实的一环。
还有一个细节值得单独拎出来:异步子块采样。触觉专家和动作专家不是锁步交换信息的,而是触觉侧攒够一个小块就采样一次、把修正递过去。这种异步设计让两个时钟真正解耦——触觉修正不用等视觉那边的整拍走完,视觉规划也不用被触觉打断。论文把这个机制画在架构图右上角,两条紫色虚线来回穿梭,看着花哨,作用就一个:让快慢两边互不堵车。
硬件也不便宜:这成绩是在什么机器人上跑出来的
只谈算法不谈硬件,会误导人。T-Rex 的 65% 是在一台 58 自由度的双手灵巧机器人上跑出来的:Dexmate Vega-1 的本体,两条 7 自由度手臂,两只 22 自由度的 Sharpa Wave 灵巧手,每只手的五个指尖都装有触觉传感器。换句话说,这台机器人光手指的自由度就比很多工业臂全身的自由度还多,指尖传感器的密度也是普通夹爪完全没法比的。
这意味着两件事。第一,65% 这个数字有硬件红利,不能直接平移到你家里的扫地机器人或者仓库里那台只有两指夹爪的搬运臂上。第二,真正稀缺的可能不是算法,而是这样一台能稳定采集 100 小时触觉数据的硬件平台——数据采集本身就是一道门槛,采数据的过程中手坏了、传感器漂移了、标定跑偏了,都会直接反映在最终成绩里。团队能攒出 7700 多段干净的同步数据,本身就是工程能力的证明。
对想跟进的开发者来说,现实的路径不是照抄这套硬件,而是盯着开源数据集里的 100 小时数据:它记录了 200 多种日常物品和 22 种基础动作的组合,覆盖了力敏感、形变感知和双手协同三类任务。哪怕你的机器人只有一只手、只有几个触觉点,这些数据里的“接触—修正”模式仍然有参考价值。先读数据、再谈复现,是更诚实的顺序。
65% 背后的另一面:机器人操作离“能用”还有多远
把 65% 翻过来看,就是 35% 的失败率。在实验室的 12 项任务里,三次尝试失败一次,放在真实产线是不可接受的——鸡蛋碎一次是浪费,产线上的精密零件装错一次可能是整批返工。所以 T-Rex 的正确定位是“研究里程碑”,而不是“产品发布”。松下通稿的措辞也留了余地:说的是“力争”把技术用在制造与物流场景,而不是“已经可以部署”。
另外要提醒一点:12 项任务全是团队自己设计、自己评测的,任务难度、成功标准、基线选择都由同一拨人定。EgoScale、π0.5 这些基线在 T-Rex 的任务集上跑出 35%、17% 的成绩,并不等于它们在自己的主场上也只有这个水平。跨论文横向比较成功率数字向来要小心,真正有说服力的,是 T-Rex 在自己的任务集上 12 项全胜、以及拿掉触觉就跌回 42% 的消融实验——后者至少证明了触觉在这个架构里是真正在干活,而不是摆设。
还有一个开放问题:100 小时数据的“泛化边界”在哪里。200 多种日常物品听起来不少,但真实世界的物品是无限的;22 种基础动作覆盖了捏、推、拧、抽等常见原语,可一旦碰到没见过的材质、没见过的形状,触觉修正还能不能兜底,论文里没有答案。CoRL 大会 11 月 9 日的现场报告值得关注:同行会追问的第一件事,很可能就是这套方法在任务集之外的表现。
不过,方向本身是对的。视觉语言模型过去两年把机器人带到了“看得懂、说得通”的阶段,接下来要过的关就是“摸得着、拿得稳”。T-Rex 的意义在于,它给出了一个可行的组织方式:别把所有信号塞进同一个慢模型里,让快信号走快通道,慢信号走慢通道,中间用残差修正衔接。这个组织方式即使以后换了更大的模型、更好的硬件,大概率还会留下来。
小结
松下、伯克利、NVIDIA 与斯坦福的 T-Rex,用“5Hz 规划 + 20Hz 触觉修正”的双时钟结构,让双手机器人在 12 项精细操作上做到 65% 成功率,比最强基线高 30 个点;拿掉触觉跌回 42%,硬塞触觉反而让基线从 17% 掉到 6%——这组对照比 headline 数字更值得记住。100 小时触觉数据集已开源,论文将在 11 月 9 日的 CoRL 大会上报告。65% 不是终点,但它证明了一件事:机器人想把活干细,得先学会“摸着干”。
评论 (0)
原始来源
相关文章
印度 Sarvam AI 于 11 月 3 日发布决策模型 Prism:不生成长文本,只在给定选项中打分,平均 71.8 分、44 毫秒响应,权重以 Apache 2.0 开源。它的真正卖点不是最聪明,而是校准可靠、顺序稳定,适合塞进自动化链路里做判断层。
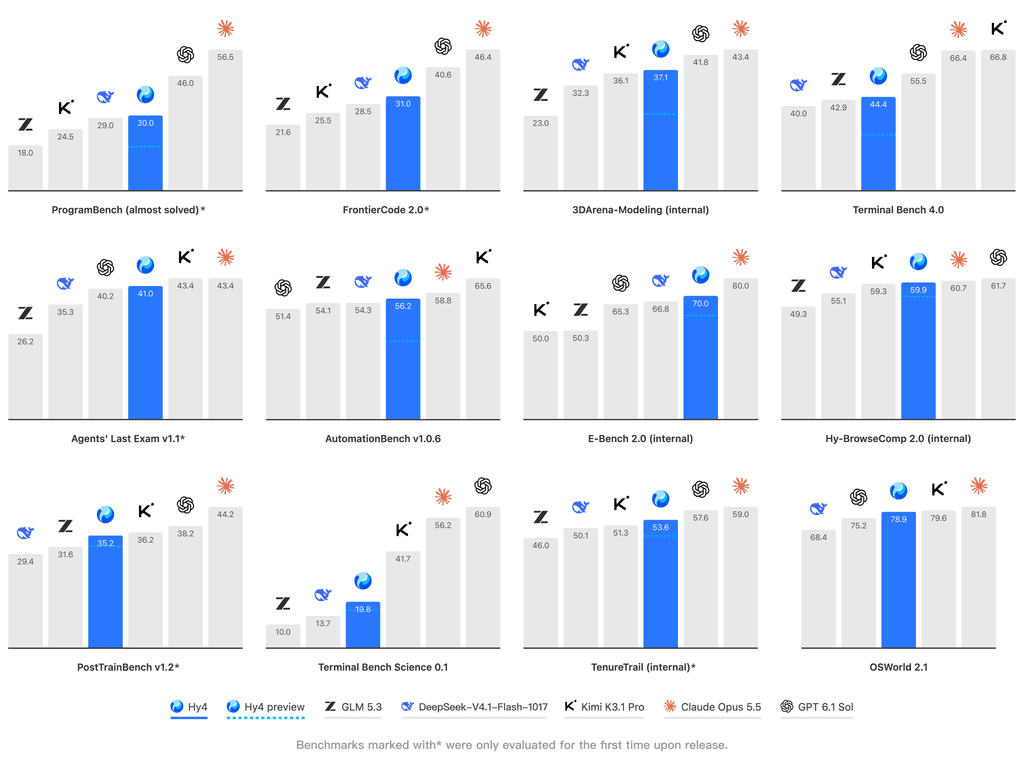
腾讯 11 月 4 日正式发布 Hy4 完整版,补上视觉理解和电脑操作两块短板,价格与预览版持平。但完整版权重尚未公开下载,今天的 Hy4 首先是一个托管服务,而非可本地部署的开源模型。
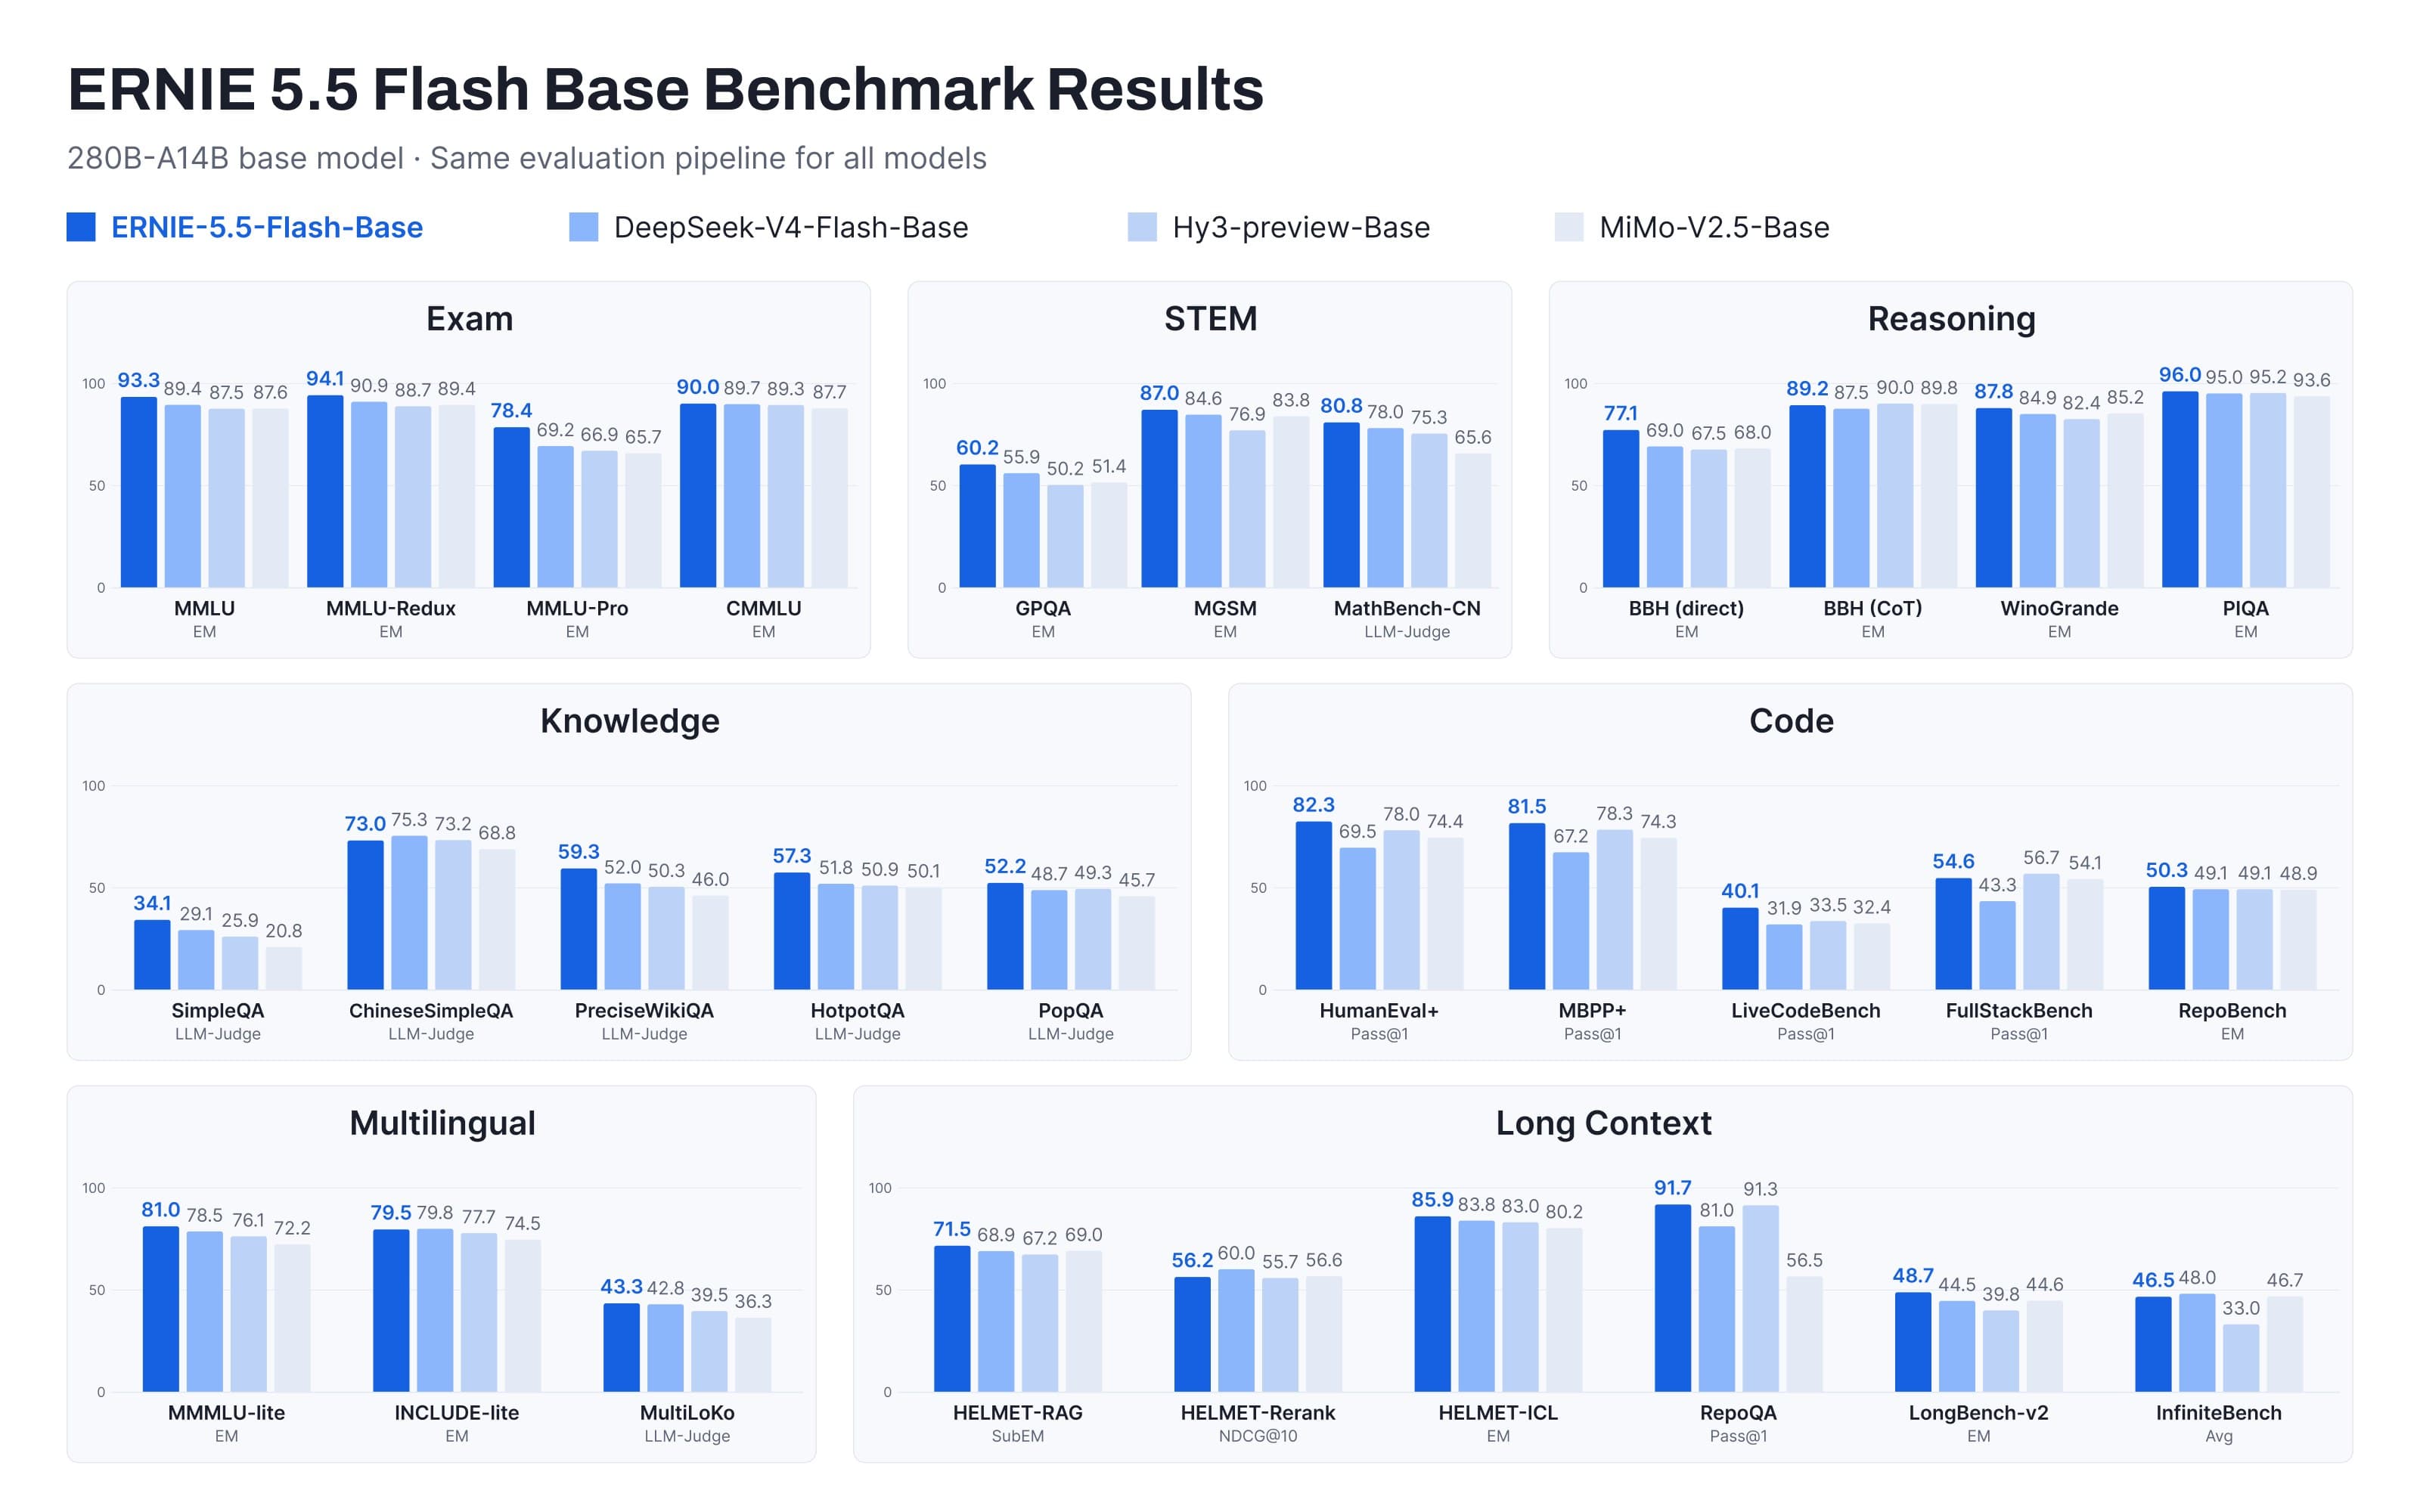
百度 11 月 5 日发布 ERNIE-5.5-Flash-Base:2800 亿参数、每次激活 140 亿,百度自报 30 项评测拿了 24 项第一。权重可以下载,但定制许可证把欧盟、英国、韩国排除在外,免费商用还卡着 5000 万美元收入线。