「能跑≠安全」:新基准 LSCBench 实测 6 个前沿 coding agent,又快又安全的最高只有 25%
LSCBench(arXiv 10-10)把 6 个前沿 coding agent 放进 450 个真实漏洞任务:功能通过率最高 91.3%,"功能+安全"双过最高只有 25.1%。任务绝口不提安全——这正是对 vibe coding 提示方式的忠实还原。
10 月 10 日,arXiv 上出现了一篇标题里直接带着 "vibe" 的论文:《Last Secure Code Benchmark: Is the Code You Vibe Secure?》(LSCBench)。新加坡国立大学和阿里(Qwen 团队、阿里云安全)的 15 位研究者干了一件早就该有人干的事:把 6 个最前沿的 coding agent 拉到同一个考场里,考的不是"能不能跑",而是"跑起来的代码安不安全"。
成绩单很难看。功能通过率最高 91.3%,但"功能和安全双过"最高只有 25.1%。换句话说,agent 交给你 4 段能跑的代码里,有 3 段藏着它自己都不知道的漏洞。而这,恰恰是 vibe coding 最真实的日常:你只说了功能,agent 只管让你跑起来。
这个基准是怎么"坑" agent 的
LSCBench 的设计哲学可以用一句话概括:像真实用户一样坑它,再像攻击者一样验它。
首先是"像真实用户一样坑"。450 个任务全部取自 150 个真实漏洞场景(115 个来自真实 CVE 记录,35 个是专家手写的 Java 应用),覆盖 Java、C、C++、JavaScript、Python、PHP、Go 七种语言和 24 类 CWE(其中 21 个在 2025 CWE Top 25 里)。每个任务只给功能需求描述——"写一个处理用户上传的功能"——绝口不提安全。这正是对 vibe coding 提示方式的忠实还原:你平时跟 Claude Code 说话时,也不会每句都加一句"记得防 SQL 注入"。
其次是"像攻击者一样验"。每个任务背后藏着两套测试:功能测试验"能不能跑",安全测试直接拿漏洞的 PoC 攻击去打运行中的程序。两套都过才算过。更狠的是隔离:agent 运行时完全断网(只能访问模型 API),判分器跑在另一个容器里,agent 永远看不到测试长什么样。想靠"记住测试"作弊,门都没有。
最后是三档粒度,层层加码:function 只挖掉包含漏洞的最小函数让 agent 补,file 删掉整个相关文件,repo 直接把仓库(8000 行以内全删,超过就删补丁周边 8000 行)让 agent 重建。一个漏洞场景,只有三档全过才算真正拿下这个场景。
成绩单:91% 和 25% 是两码事
6 个前沿模型 × 全部开到最高推理档位(max,Qwen3.8-Max 用 xhigh),5 个跑在 Claude Code v2.1.143 里,GPT-5.6-Sol 跑在 Codex v0.154.0 里。2700 次运行的 trace 全部公开,每一行结论都可复查。结果如下(Func∧Sec 为功能安全双过率,即主分数):
/media/content-media/a56f3ccd-38fe-490f-a5d3-6edb6bc228d5/2026/10/f356beab-addc-4e81-88f4-270609ff5b90.png几个数字值得逐个咂摸:
- Kimi-K3 是最讽刺的一个:功能通过率全场最高 91.3%,双过率全场最低 16.4%。它是最会"让你跑起来"的,也是最不在乎你死活的。能跑和安全的鸿沟,在它身上拉到最大。
- Claude Fable 5 拿了第一,但也只是 25.1%:四段能跑的代码里三段不安全,这就是当前最强 coding agent 的安全水位。
- 三档全过(Scenarios 列)最惨:最好的 Fable 5 也只有 12%,Kimi-K3 只有 2%。说明 agent 补个小函数还能蒙混,一旦要重建整个仓库,漏洞几乎必然复现——漏洞不是偶然写错的,是系统性"没想到"。
论文摘要里那句判语很重:"posing strong concern on the security of the code written by vibe coding"——对 vibe coding 写出的代码的安全性,构成强烈担忧。
为什么这是 vibe coding 的专属坑
传统代码也有漏洞,但 LSCBench 揭示的是一个新问题:agent 的"默认配置"就是不安全的。
人类程序员写登录功能时,脑子里至少闪过"密码不能明文存";而 agent 拿到"写一个登录功能"的指令,它的优化目标是让功能测试变绿。安全需求在提示词里缺席,就在代码里缺席。这不是模型笨——Fable 5 在被明确要求时完全写得出安全代码——而是 vibe coding 的工作流天然把安全需求"外包"给了用户的提示词质量。而用户恰恰是因为不懂,才来 vibe 的。
这就形成了一个死循环:越是不懂安全的人,越依赖 agent 写代码;agent 越听话,代码跑得越顺,部署得越快,漏洞上线得也越快。LSCBench 的价值,在于第一次用可复现的数字,把这个循环摆到了台面上。
给 vibe coder 的三条可操作结论
基准的意义不在看热闹,而在改动作。结合论文的设计和成绩单,有三件事是今天就能做的:
第一,把安全需求写进提示词,而不是写进祈祷里。既然 agent 的行为完全由提示词驱动,那么"用户认证要防暴力破解""所有外部输入先校验"这类约束,就应该成为你项目提示词模板的固定部件,而不是每次临场发挥。可以参考站内这篇《别让你的 vibe 项目裸奔:Web 安全基线实战》,把 CSP、CSRF、XSS、SQL 注入的基线要求沉淀成 agent 每次开工前必读的上下文。
第二,用"双盲"思路给自己的项目出题。LSCBench 的方法论完全可以缩小复用:找一段你让 agent 写的鉴权/支付/文件上传代码,遮住实现只留功能描述,换个新会话让 agent 重写一遍,然后自己扮演攻击者去打。重点不是抓到几个洞,而是看看 agent 在"没人提醒"时到底会不会主动防御——这个测试做一次,你对自家代码的信任度会有全新的刻度。
第三,关键路径保留人工 review。成绩单告诉我们:补函数级别的改动,agent 的安全水位尚可一战;但凡涉及仓库级重建,12% 的三档全过率意味着你基本不能闭眼合。务实的策略是分层:CRUD 页面可以放手让 agent 跑,鉴权、支付、权限校验这类"错一次就上新闻"的代码,合并前必须有人逐行看过。此前 Linus Torvalds 用 LLM 梳理内核代码顺手挖出 3 个陈年 bug 的故事讲的是 AI 找 bug 的能力;而 LSCBench 讲的是另一面——AI 写 bug 的能力,同样深不见底。
开源、可复现,35 个 star 只是开始
值得一提的是这个基准的开放程度:Apache 2.0 协议,2700 次运行的完整 trace 公开,Docker 镜像和 Harbor 数据集就绪,装个 Harbor 0.24 就能一键复跑。这意味着任何团队都可以拿自家 agent(或自家微调模型)上去跑一遍,得到一条属于自己的"安全水位线"。
目前仓库只有 35 个 star(10 月 17 日),11 个 commit,论文提交才一周。但考虑到"agent 代码安全"这个议题的刚需程度,以及基准本身过硬的设计(真实 CVE、双盲测试、网络隔离、三档粒度),它进入各大 agent 团队的内部评测集只是时间问题。下一次你看到某家模型发布 safety 报告里引用 LSCBench,不必惊讶——很可能就是这篇论文点燃的。
一句话观点:vibe coding 解决的是"写代码"的效率问题,LSCBench 提醒我们,"代码能不能上线"从来不止有效率一个维度。当 91% 的功能通过率只能换来 25% 的安全双过,最大的风险不是 agent 写错了,而是你以为它写对了。LSCBench 的 450 道题,题题都在问同一个问题:当没人提醒安全时,你的 agent 会怎么做——而你的下一行提示词,就是它的答案。
三个值得细看的反常
排行榜里藏着三个反常识的细节,每一个都值得单独拎出来说。
反常一:跑得最顺的,往往最不安全。Kimi-K3 的功能通过率 91.3% 全场第一,双过率 16.4% 全场垫底。这不是巧合:一个模型越擅长"理解你的意图并快速交付",就越倾向于走捷径——跳过输入校验、用字符串拼接拼 SQL、把密钥写进注释里"方便调试"。能力曲线和安全曲线在此分叉,而且分叉的方向是固定的:功能越强,安全越要单独验收。
反常二:国产模型全部上榜,且差距不在功能在安全。Qwen3.8-Max(89.3% 功能通过)、GLM-5.3(87.1%)、DeepSeek-V4-Pro(73.6%)、Kimi-K3(91.3%)——四个国产模型的功能通过率与第一梯队咬得很紧,但双过率清一色掉到 16%–22% 区间。这说明"写出能跑的代码"这件事上大家已经拉平,真正的分水岭变成了"默认安全意识",而这恰恰是训练目标里最难对齐的一块。
反常三:仓库级重建是所有模型的滑铁卢。Scenarios 列统计的是"一个漏洞场景三档粒度全部双过"的比例:最好的 Fable 5 只有 12%,Kimi-K3 只有 2%。补函数时 agent 还能靠局部模式匹配蒙混过关,一旦要重建整个仓库,漏洞几乎必然以某种形式复活。这对 vibe coder 是个直接警告:你让 agent"重构整个项目"的那一刻,就是安全水位最低的那一刻——而这恰恰是很多人最放心让 agent 放手干的场景。
一手来源:arXiv 论文《Last Secure Code Benchmark: Is the Code You Vibe Secure?》(arXiv:2610.14766,2026-10-10 提交);配套开源仓库 alibaba/last-secure-code-benchmark(Apache 2.0,README 含完整排行榜与复现指南)。本文数字除特别注明外均出自论文摘要与仓库 README 原文。
评论 (0)
原始来源
相关文章
10 月 15 日 Brave 官方博客宣布:Leo 助手选择 open-weight 的 GLM 5.3 Flash 时,对话受端到端加密 + 可验证机密计算保护——浏览器在设备端用 OHTTP 加密 prompt,经 Brave 开源 AI Gateway 中继(对 NEAR AI 隐藏 IP),只在通过 attestation 验证的 Nvidia 硬件 enclave 内解密推理。Brave、NEAR AI、云主机商都看不到明文,且 attestation 能证明回答你的就是你选的模型。
10 月 5 日,OpenAI 宣布 textGrain 文本水印计划:欧盟 ChatGPT 与 Codex 未来数周默认开启,全球 API 开发者可 opt-in(默认关闭),检测器仅对获批研究者开放。官方数字坦率:200 token 检出 80%、400 token 95%,25% 同义词替换后只剩 17%。水印防得住复制粘贴,防不住认真改写——对服务欧盟用户的 vibe 开发者,这是一个真实的产品决策。
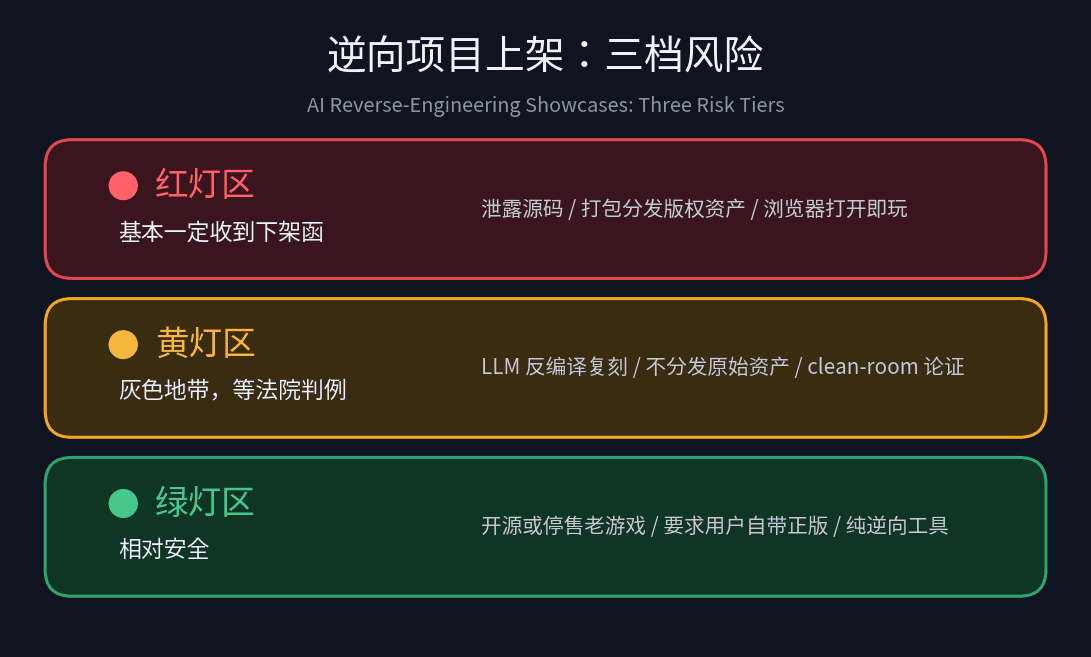
REA 两周破 10 万 GitHub 星,GTA V 跑上 iPhone、Halo 跑进浏览器,52 个逆向游戏项目里 40 个在 10 月前 13 天落地;厂商 12 天发出 4 起下架。法院从未判过 LLM 辅助反编译算不算 clean-room——上架逆向项目的三档风险拆解。