别让你的 vibe 项目裸奔:Web 安全基线实战(CSP、CSRF、XSS、SQL 注入全覆盖)
AI 写代码快,但默认不写安全代码:本地跑通不等于线上安全。这篇实战指南带你补上 vibe 项目的 Web 安全基线——CSP 安全头、CSRF Token、XSS 防护、SQL 参数化、Cookie 三件套、依赖供应链门禁,外加一份可直接复制的上线前 10 项验收清单。
你的 vibe 项目在本地跑得很顺,部署到 Vercel 一把梭,域名也绑好了。你甚至加了登录、加了支付,心里想的是:下一个功能做什么。有一个问题你可能从来没问过 AI:这个项目现在如果被扫一遍,能活多久?
答案是:大概率活不过一个晚上。不是危言耸听——我看过太多 vibe 项目的代码结构,AI 写出来的东西有一个结构性盲区:它默认不写安全代码。它写的功能代码能跑通测试、通过类型检查、看着像个样子,但它不会主动给你加 CSP 头、不会给表单做 CSRF 防护、不会把 Cookie 设成 httpOnly。这些东西不属于"跑通"的范畴,所以 AI 从来不会提醒你。
这不是 AI 的错,这是提示词的错,更是认知的错。安全债是复利:上线第一天没人碰你是运气,上线第 30 天被脚本小子扫到是数学期望。修复一个上线半年的 XSS 可能要重构三层代码,而在第一天加上只需要五行配置。这篇指南不讲高深的攻防,只讲底线:一个 vibe 项目在上线前必须补上的 Web 安全基线。
先认清敌人:vibe 项目最常见的 5 类漏洞
每类漏洞后面都跟一句"AI 为什么不会提醒你",认清这个模式,你才能学会自己给自己做安全评审。
1. XSS(跨站脚本)。 用户输入了一段 <script>,你的页面原样把它渲染了出来,攻击者的代码就在你用户的浏览器里跑起来了。AI 不会提醒你,因为它的训练数据里"渲染用户输入"这件事本身没问题——它不知道你的项目已经上线、已经暴露在公网。
2. CSRF(跨站请求伪造)。 攻击者诱导你的登录用户点了一个链接,浏览器自动带上 Cookie 发了一个 POST 请求,删库了。AI 不会提醒你,因为它生成的表单和接口在本地测试时完全正常——CSRF 只有在"另一个站点发请求"这个场景下才会爆炸,本地永远复现不了。
3. SQL 注入。 你把用户输入拼进了 SQL 字符串,攻击者输入 ' OR '1'='1 就绕过了登录。AI 不会提醒你,因为它写的是"能跑通"的代码,字符串拼接在功能测试里跑得好好的,测试用例里没人会写恶意输入。
4. 不安全的 Cookie。 会话 Cookie 没加 httpOnly,一次 XSS 就能把管理员的会话偷走;没加 Secure,中间人直接明文抓包。AI 不会提醒你,因为 Cookie 的属性是"部署细节",AI 默认你懂。
5. 依赖漏洞。 你 npm install 了一个 4000 个依赖的包,其中有一个 3 年没人维护的库带已知 CVE。AI 不会提醒你,因为它只管"这个功能需要这个包",供应链安全不在它的职责表里。
看到规律了吗?AI 的安全盲区全部集中在"从本地到线上"的那个断层上:本地能跑 ≠ 线上安全。这篇文章就是填这个断层的。
图1:请求生命周期安全检查流程
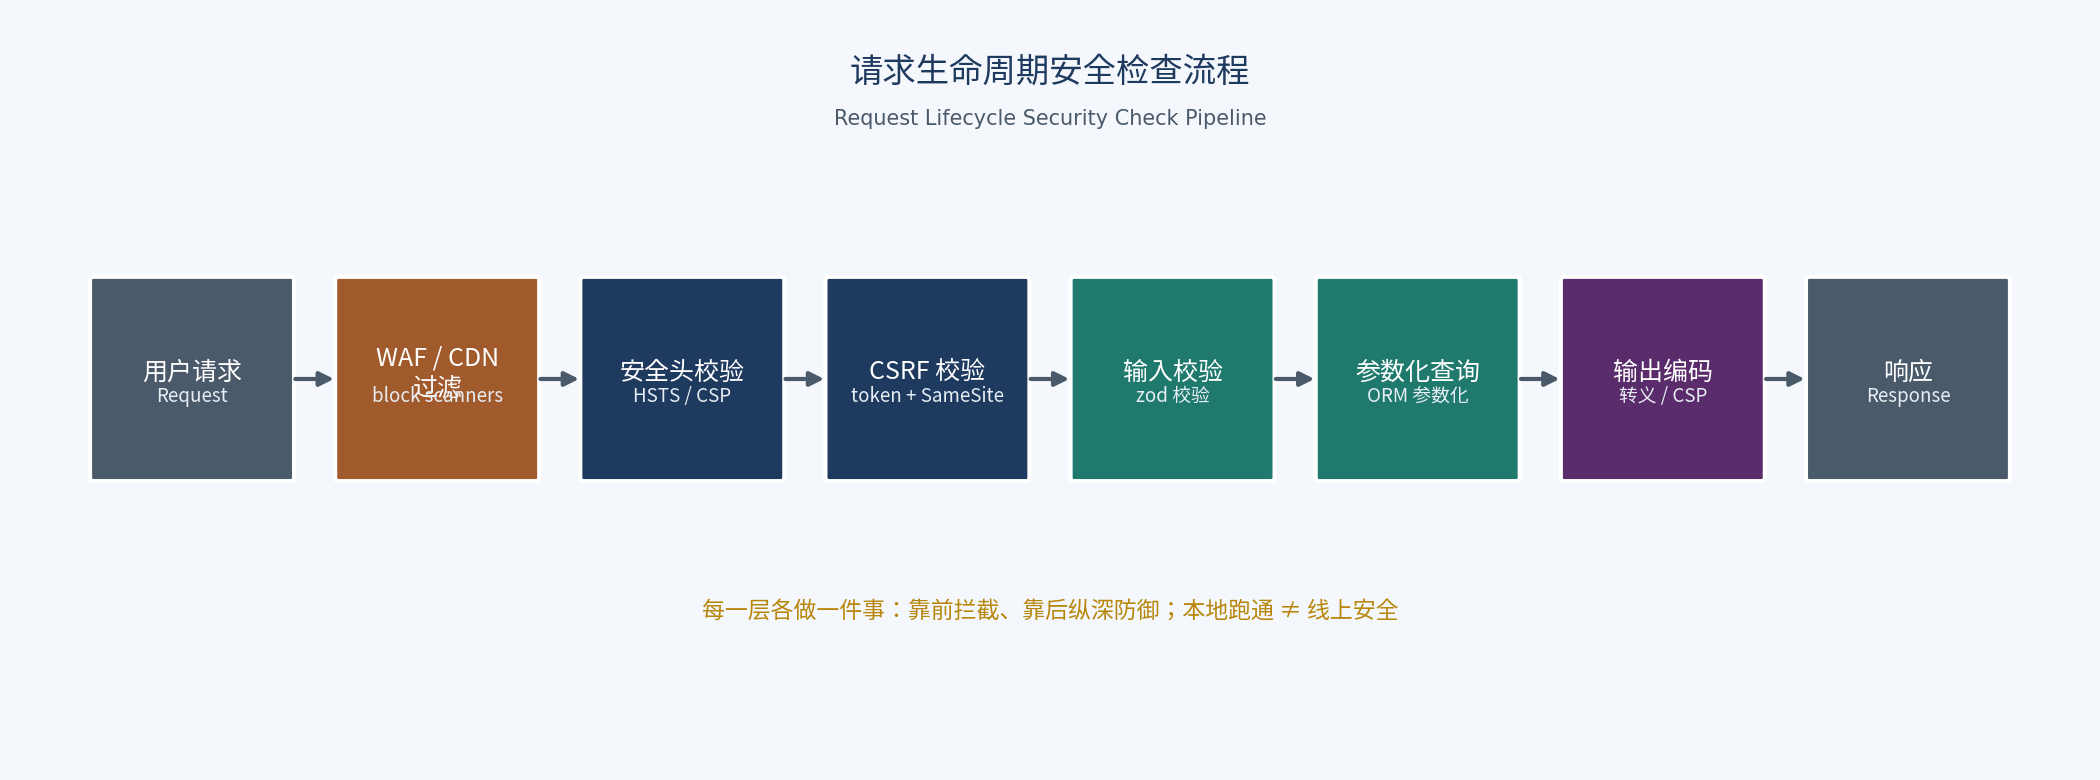 请求生命周期安全检查流程。每一层只做一件事:靠前的层负责拦截,靠后的层负责纵深防御。一个请求要经过 6 道检查才触及业务逻辑。
记住这张图的顺序,它就是这篇指南的骨架:WAF → 安全头 → CSRF token → 输入校验 → 参数化查询 → 输出编码。 每一层都有一句话职责:WAF 挡住扫描器和自动化攻击;安全头告诉浏览器"怎么对待我的页面";CSRF token 确认"这个请求真的是用户自己点的";输入校验拒绝畸形数据;参数化查询保证数据永远只是数据;输出编码保证渲染永远只是渲染。
这套流程还有一个重要性质:它是纵深防御。WAF 被绕过不怕,安全头还在;CSRF token 漏了一个接口,输入校验还能拦一道。安全的本质不是"一道墙",而是"让攻击者必须同时犯 6 个错"。vibe 项目最危险的形态恰恰是 0 层防御:AI 默认生成的脚手架,一个都不带。
HTTPS 与安全头:5 分钟能加、90% 的人都没加
先讲个残酷的事实:我见过的 AI 生成的 next.config.ts,从来没有一个自带安全头。不是 AI 偷懒,是因为这些配置和"功能"无关,训练语料里的大部分示例项目也都没写。于是每个 vibe 项目上线时都是"裸"的:浏览器不知道这个页面能不能被嵌进 iframe、不知道脚本从哪加载算合法、不知道引用来源要不要隐藏。
补救只需要一个 headers()。在 Next.js 里,这是标准写法:
// next.config.ts
const securityHeaders = [
  {
    // 强制全站 HTTPS,防中间人降级攻击;includeSubDomains 覆盖子域
    key: 'Strict-Transport-Security',
    value: 'max-age=63072000; includeSubDomains; preload',
  },
  {
    // 禁止被嵌进 iframe,防点击劫持
    key: 'X-Frame-Options',
    value: 'SAMEORIGIN',
  },
  {
    // 禁止浏览器猜测 MIME 类型,防"图片里藏脚本"类攻击
    key: 'X-Content-Type-Options',
    value: 'nosniff',
  },
  {
    // 跨站跳转时只带来源域名,不带完整路径(防 token 泄漏到第三方)
    key: 'Referrer-Policy',
    value: 'strict-origin-when-cross-origin',
  },
  {
    // 脚本/样式只允许从本站和明确白名单加载,是 XSS 的最后一道网
    key: 'Content-Security-Policy',
    value: "default-src 'self'; script-src 'self'; style-src 'self' 'unsafe-inline'; img-src 'self' data: https:; object-src 'none'; base-uri 'self'; frame-ancestors 'self'",
  },
];

export default {
  async headers() {
    return [{ source: '/:path*', headers: securityHeaders }];
  },
};几点实战判断:HSTS 一旦开了就回不了头(浏览器会记住两年强制 HTTPS),所以先确保全站 HTTPS 没问题再开 preload,否则自己把自己锁在外面。CSP 是最有价值也最容易把自己玩死的一个:上面给的是保守起步版,如果你用了 Google Analytics、Sentry 这类第三方脚本,必须把它们的域名加进 script-src 白名单,否则线上直接白屏。上线前先在 Content-Security-Policy-Report-Only 模式下跑一天,看控制台报什么再收紧。
X-Frame-Options 设 SAMEORIGIN 而不是 DENY,是因为很多后台管理页自己会用 iframe 嵌预览,DENY 会误伤自己。记住原则:安全头不是越严越好,是"严到刚好不误伤自己"为止。
XSS 实战:React 帮你挡了 80%,剩下的 20% 全是坑
先区分三种形态,一句话版:存储型是恶意脚本存进了你的数据库、每个访问者都中招(评论区、用户名);反射型是恶意脚本藏在 URL 参数里、点链接的人中招(搜索页回显关键词);DOM 型是前端 JS 自己把 URL 参数拼进了页面、压根没经过后端。
React 默认对所有插值做转义,所以 {userInput} 这种写法是安全的——这是 React 帮你挡掉的 80%。剩下的 20% 全是开发者自己挖的坑,AI 尤其爱挖,因为它写出来的代码"看起来没问题":
红线一:dangerouslySetInnerHTML。 名字里都带 dangerously 了,AI 还是会在"渲染富文本"场景下毫不犹豫地用它。规则很简单:凡是用户可控的内容进 dangerouslySetInnerHTML,必须先过 DOMPurify:
import DOMPurify from 'isomorphic-dompurify';

// 错误:AI 最爱这么写
<div dangerouslySetInnerHTML={{ __html: post.content }} />

// 正确:先清洗再渲染
<div dangerouslySetInnerHTML={{ __html: DOMPurify.sanitize(post.content) }} />;
红线二:Markdown 渲染。 vibe 项目十个有八个要渲染 Markdown(博客、文档、AI 输出结果)。react-markdown 默认不渲染 HTML 是安全的,但很多人为了"支持更丰富的格式"打开 rehype-raw,等于亲手拆掉了护栏。判断标准:如果你开了 rehype-raw,输出必须再过一遍 DOMPurify;如果没开,保持默认就是安全的。
红线三:URL 拼接。 <a href={userInput}> 看似无害,但用户输入 javascript:alert(1) 就中招了。所有用户可控的 URL,上线前必须校验协议白名单(https:/http:/mailto:),其余一律拒绝。
记住一个心智模型:凡是"字符串变成代码"的地方,就是 XSS 的温床。 HTML 字符串、URL 字符串、JS 字符串——AI 写代码时在这三个地方最不设防,你 review 时就盯这三个地方。
CSRF 实战:SameSite 不是银弹
先把 SameSite 讲透,因为这是 90% 的人一知半解的地方。Cookie 的 SameSite 有三个值:Strict(任何跨站都不带 Cookie,最严但体验差,连从搜索引擎点进来都是未登录态)、Lax(跨站的顶级导航 GET 请求会带 Cookie,比如从别的网站点链接进你的站;跨站 POST 不带,这是浏览器默认值)、None(全带,必须配 Secure)。
所以"SameSite=Lax 是默认值"这句话的潜台词是:跨站 POST 已经被浏览器默认挡掉了,但跨站 GET 顶级导航依然会带 Cookie。 这就是为什么"GET 只读、POST 校验"是铁律:只要你的"删除""转账""改密码"接口是 GET 请求,一个 <img src="https://你的站/api/delete?id=1"> 就能让登录用户在不知情的情况下执行操作。AI 生成的 REST 接口经常把动作挂在 GET 上("图方便"),这是 CSRF 的头号温床。
但 Lax 不是银弹,原因有二:第一,顶级导航 GET 仍然带 Cookie,所以所有有副作用的操作必须用 POST/PUT/DELETE,这是架构层面的要求,不是配置能解决的;第二,老浏览器和某些 WebView 不认 SameSite。所以关键接口还要加 Token 模式,最小实现长这样:
// 服务端:签发 token(存 session 或签名后放 Cookie)
import { randomBytes } from 'crypto';

export function issueCsrfToken(): string {
  return randomBytes(32).toString('hex');
}

// 表单里带上隐藏字段
// <input type="hidden" name="csrfToken" value={csrfToken} />

// 服务端:校验(双提交模式:对比 Cookie 与表单字段是否一致)
export function verifyCsrf(cookieToken: string | undefined, bodyToken: string | undefined): boolean {
  if (!cookieToken || !bodyToken) return false;
  return cookieToken.length === bodyToken.length &&
    crypto.timingSafeEqual(Buffer.from(cookieToken), Buffer.from(bodyToken));
}
注意校验用 timingSafeEqual 而不是 ===,防时序攻击——这是 AI 永远不会主动写、但安全审计一定会挑的细节。如果你用的是 Next.js Server Actions,好消息是它内部已经做了 CSRF 防护;坏消息是,一旦你为了"灵活"手写了 API Route,这层保护就没了,得自己补。
SQL 注入实战:ORM 不是免死金牌
"我用 Prisma 所以没有 SQL 注入"——这句话对了一半。ORM 的常规查询确实是参数化的,但每个 ORM 都有逃生舱口,而 AI 特别喜欢钻逃生舱口。先看对比:
// 反模式:字符串拼接(AI 在"动态查询"场景下经常这么写)
const email = req.body.email;
const users = await prisma.$queryRawUnsafe(
  `SELECT * FROM users WHERE email = '${email}'`
);
// 输入:' OR '1'='1  →  直接绕过

// 正确:参数化(Prisma 的 $queryRaw 是模板字符串参数化,不是拼接)
const users = await prisma.$queryRaw`
  SELECT * FROM users WHERE email = ${email}
`;
// ${email} 会被当成参数绑定,永远只是数据,不会变成 SQL 代码关键区别:$queryRawUnsafe 是字符串拼接,$queryRaw 是参数化。名字里带 Unsafe 的那个,AI 在"这个 ORM 方法不支持我的复杂查询"时会主动推荐你用——它甚至会在注释里写"注意 SQL 注入风险",然后继续用。
还有一个 AI 重灾区:动态 where 拼接。比如管理后台的筛选器,用户选了 5 个条件,AI 会写出这样的代码:
// 反模式:手动拼 where 条件字符串
let where = '1=1';
if (status) where += ` AND status = '${status}'`;
if (keyword) where += ` AND name LIKE '%${keyword}%'`;

// 正确:用 ORM 的对象式 where,让参数化发生在框架层
const where: Prisma.OrderWhereInput = {};
if (status) where.status = status;
if (keyword) where.name = { contains: keyword };
const orders = await prisma.order.findMany({ where });原则只有一条:永远不要让用户输入出现在 SQL 字符串里,哪怕看起来"只是个状态枚举"。 枚举值也可以被篡改,请求参数永远不可信。
会话与登录周边:Cookie 三件套 + 密码 + 限流
会话 Cookie 必须同时满足三个属性,缺一个都是裸奔:httpOnly(JS 读不到,XSS 偷不走)、Secure(只走 HTTPS,中间人抓不到)、SameSite=Lax(挡跨站 POST)。在 Next.js 里:
cookies().set('session', token, {
  httpOnly: true,
  secure: process.env.NODE_ENV === 'production',
  sameSite: 'lax',
  path: '/',
  maxAge: 60 * 60 * 24 * 7, // 7 天
});
密码存储只认 bcrypt / scrypt / argon2,别碰 MD5/SHA256(那是哈希不是密码学,彩虹表秒破)。bcrypt 的 cost 取值:12 是当前甜点——单次哈希约 200-300ms,用户登录无感,暴力破解者每试一个密码都要烧这么久。cost 10 太低,cost 14 会让你的登录接口在流量高峰时自己把自己打挂。记住:cost 每加 1,计算时间翻倍。
登录接口必须限流:防撞库、防暴力破解。具体的限流算法和实现我们之前发过一篇《API 限流》指南(令牌桶 vs 滑动窗口、按 IP+账号双维度限流),这里不展开,直接套用那篇的方案即可。底线数字:登录接口同一 IP 每分钟超过 10 次直接 429,同一账号 5 次失败锁定 15 分钟。
依赖供应链:你 npm install 的不只是代码
一个典型的 Next.js 项目 node_modules 里躺着上千个包,你写的代码可能只有 5%。供应链攻击这几年越来越猖獗:投毒的是维护者账号被盗、是冷门包被收购后加恶意代码、是 typosquatting(loadsh vs lodash)。AI 在这件事上的风险是结构性的:它推荐包的依据是"训练语料里这个包出现频率高",而不是"这个包现在还活着、还没被投毒"。它甚至会编造不存在的包名(幻觉包),你 npm install 一个不存在的包名,攻击者只需要提前抢注这个名字就能投毒——这叫 slopsquatting,2024 年之后真实发生过。
上线门禁三件套,缺一不可:
1. npm audit / pnpm audit 进 CI。 高危漏洞直接卡死合并:
# package.json scripts
"audit:ci": "pnpm audit --audit-level=high"
# CI 里跑,high 以上直接失败,不许上线
2. Dependabot / Renovate 自动提 PR。 安全补丁的窗口期是以天计算的,靠人肉 npm update 永远跟不上。开了自动更新后,记得把测试跑通作为合并前提,别让自动更新把线上搞挂。
3. AI 引入冷门包时的风险判断法。 AI 推荐了一个你没听过的包,别急着装,先查三件事:GitHub star 数和最近 commit 时间(半年没更新的直接 pass)、npm 周下载量(低于 1 万的要警惕)、包的 maintainer 是不是只有一个人。三个全挂,宁可让 AI 用标准库手写一个简单实现,也别装这个包。
图2:攻击面分层架构
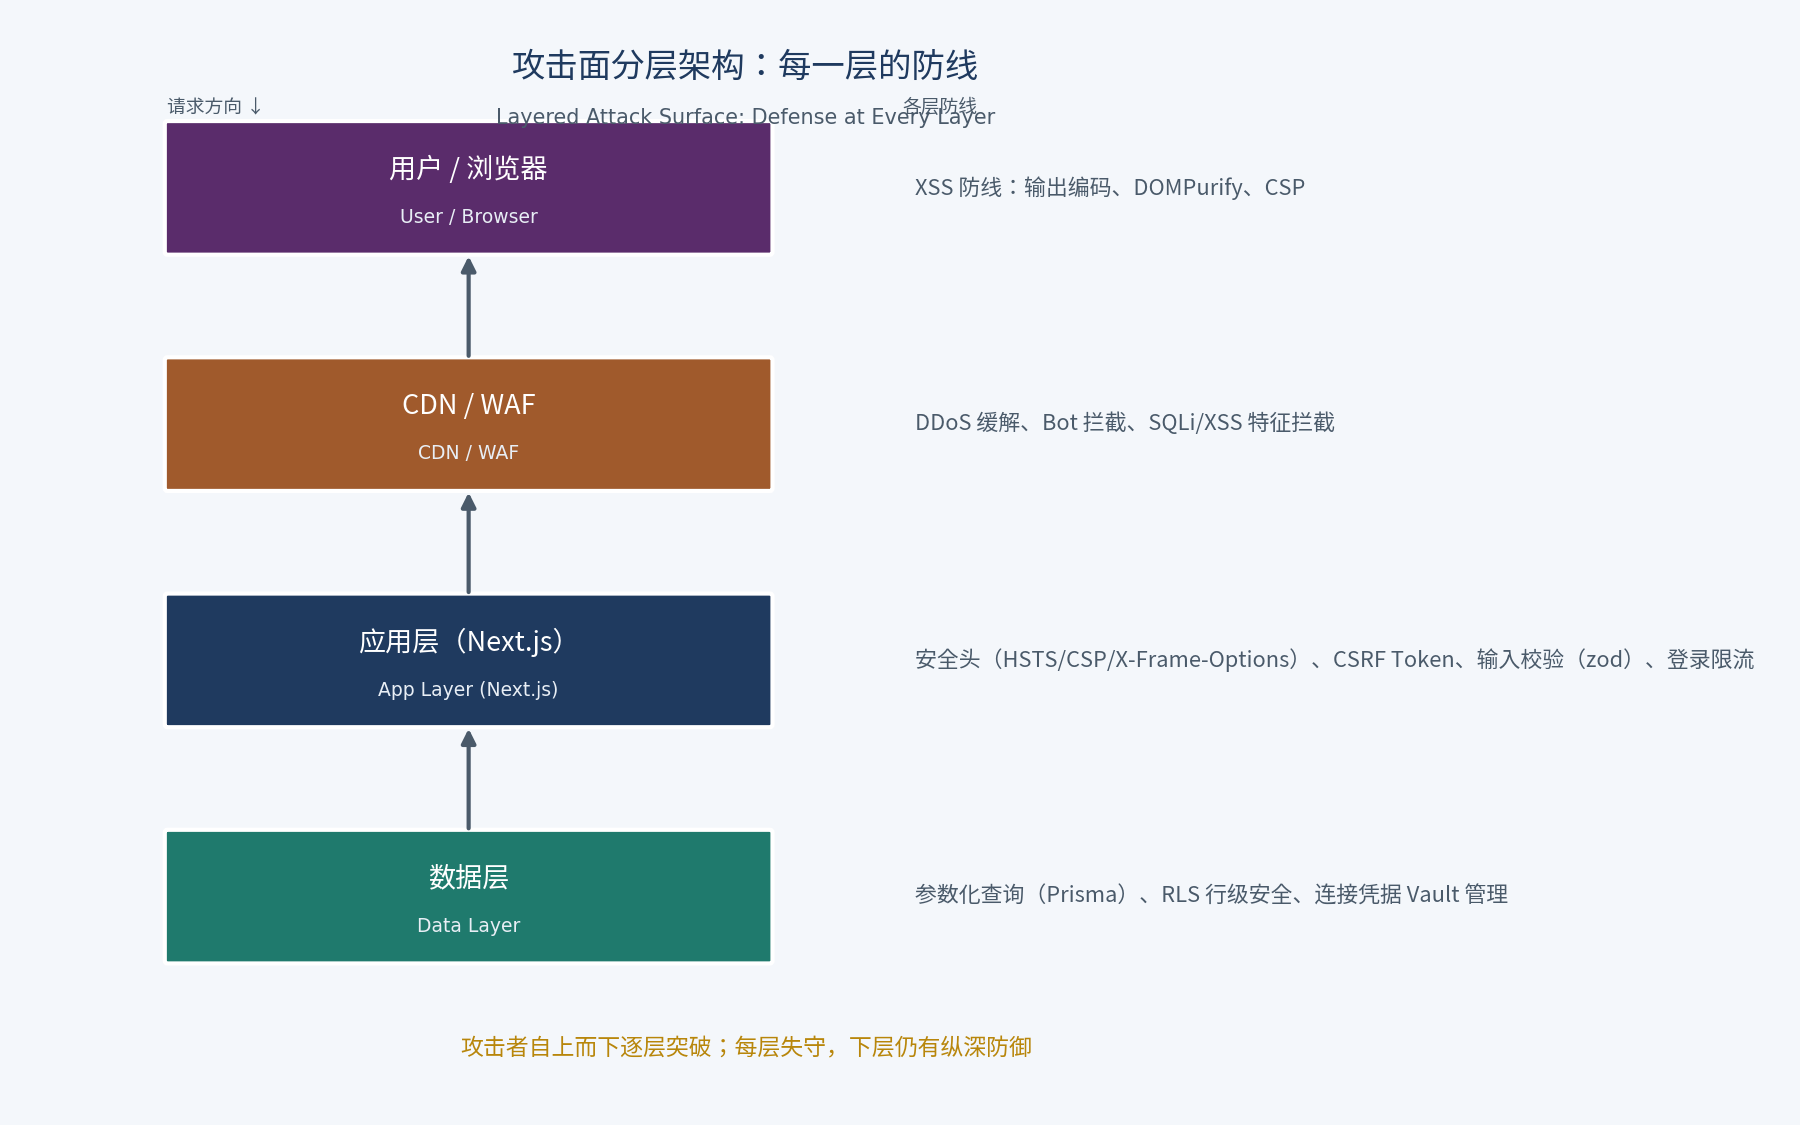 攻击面分层架构。攻击者自上而下逐层突破:CDN/WAF 挡 DDoS 和扫描器,应用层靠安全头、CSRF Token、输入校验和登录限流,数据层靠参数化查询和行级安全。每层失守,下层仍有纵深防御。
把这张图打印出来贴在显示器旁边。每次 AI 给你生成新功能,你就从上往下问一遍:这一层的新代码,有没有绕过某一层的防线?比如 AI 给你加了个"导出 CSV"功能——输出编码那层过了吗?给你加了个管理后台的搜索框——参数化查询那层过了吗?安全 review 不需要你成为黑客,只需要你养成"逐层过一遍"的习惯。
上线前 10 项安全验收清单(直接复制去用)
□ 1. 全站 HTTPS,HSTS 已开启(curl -I 看 Strict-Transport-Security)
□ 2. 安全头齐全:CSP / X-Frame-Options / X-Content-Type-Options / Referrer-Policy
□ 3. 所有有副作用的接口都是 POST/PUT/DELETE,没有 GET 改数据的
□ 4. 关键表单/接口有 CSRF Token 校验(或确认框架自带且未被绕过)
□ 5. 全局搜索 dangerouslySetInnerHTML:每一处都有 DOMPurify 或确认内容不可控
□ 6. 全局搜索 $queryRawUnsafe / 字符串拼接 SQL:零容忍
□ 7. Cookie 三件套:httpOnly + Secure + SameSite=Lax
□ 8. 密码用 bcrypt(cost=12) 或 argon2,无明文、无 MD5
□ 9. 登录接口限流(IP 维度 + 账号维度),失败锁定
□ 10. pnpm audit 无 high 以上漏洞,Dependabot 已开启
这 10 项全部打勾,你的项目就达到了"脚本小子扫一遍扫不动"的水平。注意第 5、6 项是"全局搜索"——AI 写的代码里,这两类问题不会只出现一次,搜出来要一个一个修。
收尾:别裸奔是底线,不是天花板
说句实话:这篇指南里的基线,防不住 APT,防不住 0day,防不住内鬼。它防的是互联网上 95% 的攻击——那些用自动化扫描器全网扫 /.git/config、扫 SQL 注入 payload、扫弱口令的脚本小子。你的 vibe 项目大概率不会成为 APT 的目标,但一定会成为扫描器的目标,因为扫描器不挑食。
安全投入的性价比曲线是这样的:从 0 到基线的这 10 项,投入一下午,挡掉 95% 的攻击;从基线到"高枕无忧",投入无上限,边际收益递减。对独立开发者来说,正确的策略是:基线必须一次做到位,高级防护按需再加。
最后回到开头那个问题:AI 默认不写安全代码,但这不怪 AI——怪的是我们默认"能跑就行"。从今天起,给你的提示词里加一句话:"所有用户输入都要校验,所有输出都要编码,所有 Cookie 都要 httpOnly+Secure+SameSite。" 一句话,换你每晚睡个安稳觉。这买卖,值。
评论 (0)
相关文章
AI 默认生成的是永远在线的应用,而你的用户在地铁、电梯、高铁隧道里直接白屏。本指南把离线能力分成四档(L0–L3),逐层讲透实战技术栈:Dexie 本地存储、Service Worker 缓存策略决策表、带幂等键的 outbox 写操作队列、按场景选择的三种冲突解决策略,并附上线 checklist 与四条真实反模式。
AI 帮你 deploy 到 xxx.vercel.app 只是借住。这篇实战指南带你走完买域名、DNS 解析、Cloudflare 上线链路、HTTPS 落地、邮箱三件套全链路——域名是你唯一真正拥有的资产。
AI 写的代码在单用户世界里完美运行,上线第一天就可能被 100 个并发打崩。这篇指南教你 15 分钟跑通第一条 k6 脚本:从真实用户行为反推压测场景,读懂 p95/p99 与饱和信号,用三板斧定位 DB、连接池与第三方 API 瓶颈,再把压测数字换算成能撑多少付费用户,最后让压测进 CI 自动守门。