没网也能用:vibe 项目的离线优先与数据同步实战
AI 默认生成的是永远在线的应用,而你的用户在地铁、电梯、高铁隧道里直接白屏。本指南把离线能力分成四档(L0–L3),逐层讲透实战技术栈:Dexie 本地存储、Service Worker 缓存策略决策表、带幂等键的 outbox 写操作队列、按场景选择的三种冲突解决策略,并附上线 checklist 与四条真实反模式。
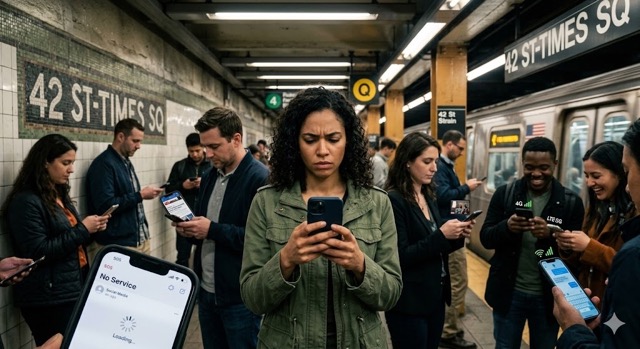
AI 默认给你写的,是"永远在线"的应用。
你把提示词喂给 Claude Code、Cursor 或者任何一个 AI 编程工具,它吐出来的架构都是:页面加载调 API,按钮点击调 API,表单提交调 API。fetch 成功了皆大欢喜,fetch 失败了——大多数 vibe 项目甚至连失败分支都没写,直接白屏。
这在开发者的书桌上没问题。用户的真实世界可不是书桌。
三个真实的翻车现场
先说第一个。某个笔记类应用的用户,在高铁上花了四十分钟改了一篇长笔记,穿过一段隧道时网络断了几秒。应用没有本地保存,提交按钮一直在转圈,出隧道之后页面刷新了——四十分钟的修改全没了。用户在应用商店留了条一星差评,就两个字:垃圾。开发者后来复盘,这是一个小时就能修掉的问题:先写本地,再同步。
第二个是仓库盘点场景。客户用手持 PDA 在仓库里做盘点,仓库深处的 Wi-Fi 信号本来就差,中午断了半小时。这半小时里扫进去的两百多条盘点记录全部躺在内存里,应用一被系统杀掉,数据直接蒸发。下午重新盘点,人力成本翻倍,客户的 IT 负责人原话是:"你们这个系统,连 Excel 都不如——至少 Excel 不会把我填的东西吃了。"
第三个发生在海外。某独立开发者的电商小工具,目标用户在东南亚,弱网是常态。用户下单时转圈超过 30 秒,大多数人直接放弃,转化率比同类产品低了整整四成。开发者把问题归结为"服务器太慢",加钱升级了服务器,转化率纹丝不动——真正的瓶颈在客户端:下单请求在弱网下重试了三次,每次都从头开始,用户等了三倍的时间。
这三个场景有一个共同点:开发者假设网络永远可用,而现实是网络随时会断。地铁、电梯、高铁隧道、地下车库、偏远仓库、跨国弱网——你的用户每天都在这些地方打开你的应用。
我的观点很直接:离线不是加分项,是必答题。至少在 2026 年的今天,一个连地铁里都打不开的应用,用户不会给你第二次机会。好消息是,离线优先(offline-first)不需要你重写整个架构,它是一组可以逐步叠加的技术:本地存储、缓存策略、写操作队列、冲突解决。每一层都有明确的投入产出比,这篇文章就把这四层讲透。
离线能力四档:先给你的项目定个级
在写代码之前,先给你的项目定个级。离线能力分四档,每档一句话判定标准:
- L0 · 无离线能力:断网即白屏,刷新即丢数据。判定标准:打开 Chrome DevTools,把 Network 切到 Offline,应用直接不可用。AI 默认生成的项目,十个有九个停在这一档。
- L1 · 只读缓存:断网能看之前加载过的内容,但不能写。判定标准:离线状态下,历史页面、历史数据可浏览,新操作全部被禁用或报错。适用于内容消费类产品:博客、文档站、资讯、课程。
- L2 · 离线可写 + 队列同步:断网能照常写,联网后自动同步。判定标准:离线创建的笔记、订单、表单,恢复网络后一个不少地出现在服务端,且用户不需要手动点"同步"按钮。笔记、待办、表单、盘点这类工具,至少要做到这一档。
- L3 · 冲突自动合并:多设备、多人同时改同一份数据,系统能自动合并或优雅地提示。判定标准:手机和电脑同时改了同一篇笔记,同步后两边的修改都还在,没有静默丢失。协同编辑、团队工具才需要这一档,代价也最高。
决策建议很简单:内容消费类做到 L1 就够了;凡是让用户"生产内容"的工具(笔记、待办、表单、订单),至少 L2。L3 不要一上来就做——协同冲突的复杂度是指数级的,先把 L2 做扎实。多数 vibe 项目的真实水平是 L0,连 L1 都没做到,这就是机会:把离线做到 L2,你的产品体验已经超过了 90% 的同类 AI 生成应用。
本地存储选型:别再把所有东西塞 localStorage
离线优先的第一步,是把数据放在用户设备上。前端有三个主流选择,选错的代价很大:
- localStorage:只能放 token 和小配置。5MB 上限,读写是同步的——主线程阻塞警告:存个几百 KB 的 JSON,页面就会肉眼可见地卡。更重要的是它是字符串键值对,查一条数据要全量读出来再过滤,数据量一大就崩。记住一句话:localStorage 是放钥匙的抽屉,不是放家具的仓库。
- IndexedDB:浏览器内置的真正数据库,容量大(通常几百 MB 到几 GB)、异步不阻塞、支持索引和事务。缺点是原生 API 是回调地狱,写起来像在考古。
- Dexie.js:IndexedDB 的 Promise 封装,API 干净得像在写 MongoDB 查询。这是我的默认推荐:凡是离线要存业务数据,直接上 Dexie,不要手写 IndexedDB,也不要用 localStorage 硬扛。
下面是 Dexie 的最小可用代码,建表加读写,复制过去就能跑:
import Dexie from 'dexie';

// 1. 建库建表:notes 是业务表,outbox 是写操作队列表(后面会用到)
export const db = new Dexie('vibe-app');
db.version(1).stores({
  notes: '++id, updatedAt',          // ++id 自增主键,updatedAt 建索引方便按时间查
  outbox: '++id, createdAt, status', // 离线写操作队列
});

// 2. 写:永远先写本地,UI 立刻响应,不等网络
export async function saveNoteLocal(note) {
  const id = await db.notes.put({
    ...note,
    updatedAt: Date.now(),
    dirty: true, // 脏标记:还没同步到服务端
  });
  return id;
}

// 3. 读:离线时直接读本地,用户无感知
export async function getNotesLocal() {
  return db.notes.orderBy('updatedAt').reverse().toArray();
}
注意 dirty: true 这个字段——它是整个同步体系的基石。本地数据分两种:已经和服务端一致的(干净),和只在本地改过、还没同步的(脏)。同步程序只需要关心脏数据,不用每次全量比对。这个字段现在看起来不起眼,后面写同步逻辑时会救你一命。
还有一条铁律:敏感数据不要明文存 IndexedDB。IndexedDB 是明文存储,同一设备上的任何脚本(包括 XSS 注入的)都能读。token 放内存或 httpOnly cookie,业务数据里的敏感字段要么不存本地,要么加密后再存。离线优先不等于安全降级。
Service Worker 缓存策略:三张牌怎么打
Service Worker(SW)是浏览器的"离线网关":所有网络请求先经过它,它决定是从缓存拿还是走网络。策略选错,离线体验直接翻车。下面是决策表,每种策略一句话讲清什么时候用、什么时候别用:
| 策略 | 适用资源 | 什么时候用 | 什么时候别用 |
|---|---|---|---|
| Cache First 缓存优先 | JS / CSS / 字体 / 图片等静态资源 | 文件名带 hash、内容不变的资源。先读缓存,命中直接返回,离线秒开。 | HTML 入口文件和 API 响应。缓存了旧 HTML,用户永远看不到新版本。 |
| Network First 网络优先 | API 读请求 | 数据实时性要求高的接口。先走网络,失败了再兜底读缓存,保证不断网可看、不断网最新。 | 大文件下载和静态资源。每次都走网络,离线体验和加载速度都打折。 |
| Stale-While-Revalidate 过期即用、后台更新 | 列表页、头像、非关键数据 | 允许"先看旧的、后台悄悄更新"的场景。离线有内容,在线永远最新,用户体验最顺滑。 | 价格、库存、余额这类强一致数据。用户看到旧价格下单,纠纷算谁的? |
关于 Service Worker,我只有一个建议:别手写,用 Workbox。Google 出的 Workbox 把上面三种策略封装成了一行配置,手写 SW 你要自己处理缓存版本清理、请求拦截边界、iOS 兼容坑——这些坑 Workbox 都替你踩过了。vibe coding 的原则是"把确定性的脏活交给成熟的库",SW 就是典型。
import { registerRoute } from 'workbox-routing';
import { CacheFirst, NetworkFirst, StaleWhileRevalidate } from 'workbox-strategies';

// 静态资源:缓存优先
registerRoute(
  ({ request }) => request.destination === 'script' || request.destination === 'style',
  new CacheFirst({ cacheName: 'static-v1' })
);
// API 读:网络优先,断网兜底缓存
registerRoute(
  ({ url }) => url.pathname.startsWith('/api/'),
  new NetworkFirst({ cacheName: 'api-v1', networkTimeoutSeconds: 3 })
);
注意 networkTimeoutSeconds: 3:网络优先不等于无限等网络,3 秒没回来就读缓存——弱网下这个超时是体验和实时性的平衡点,写死等网络就是开篇第三个翻车场景的复刻。
写操作队列:outbox 模式,没有幂等键的重试就是制造脏数据
读缓存解决的是"离线能看",写操作队列解决的是"离线能写"。这是 L2 的核心,也是整篇文章技术含量最高的部分。
模式叫 outbox(发件箱):用户在离线时的每一次写操作,不直接调 API,而是先写进本地一张队列表;网络恢复后,同步程序按顺序把队列里的操作重放(replay)到服务端。状态机如下:
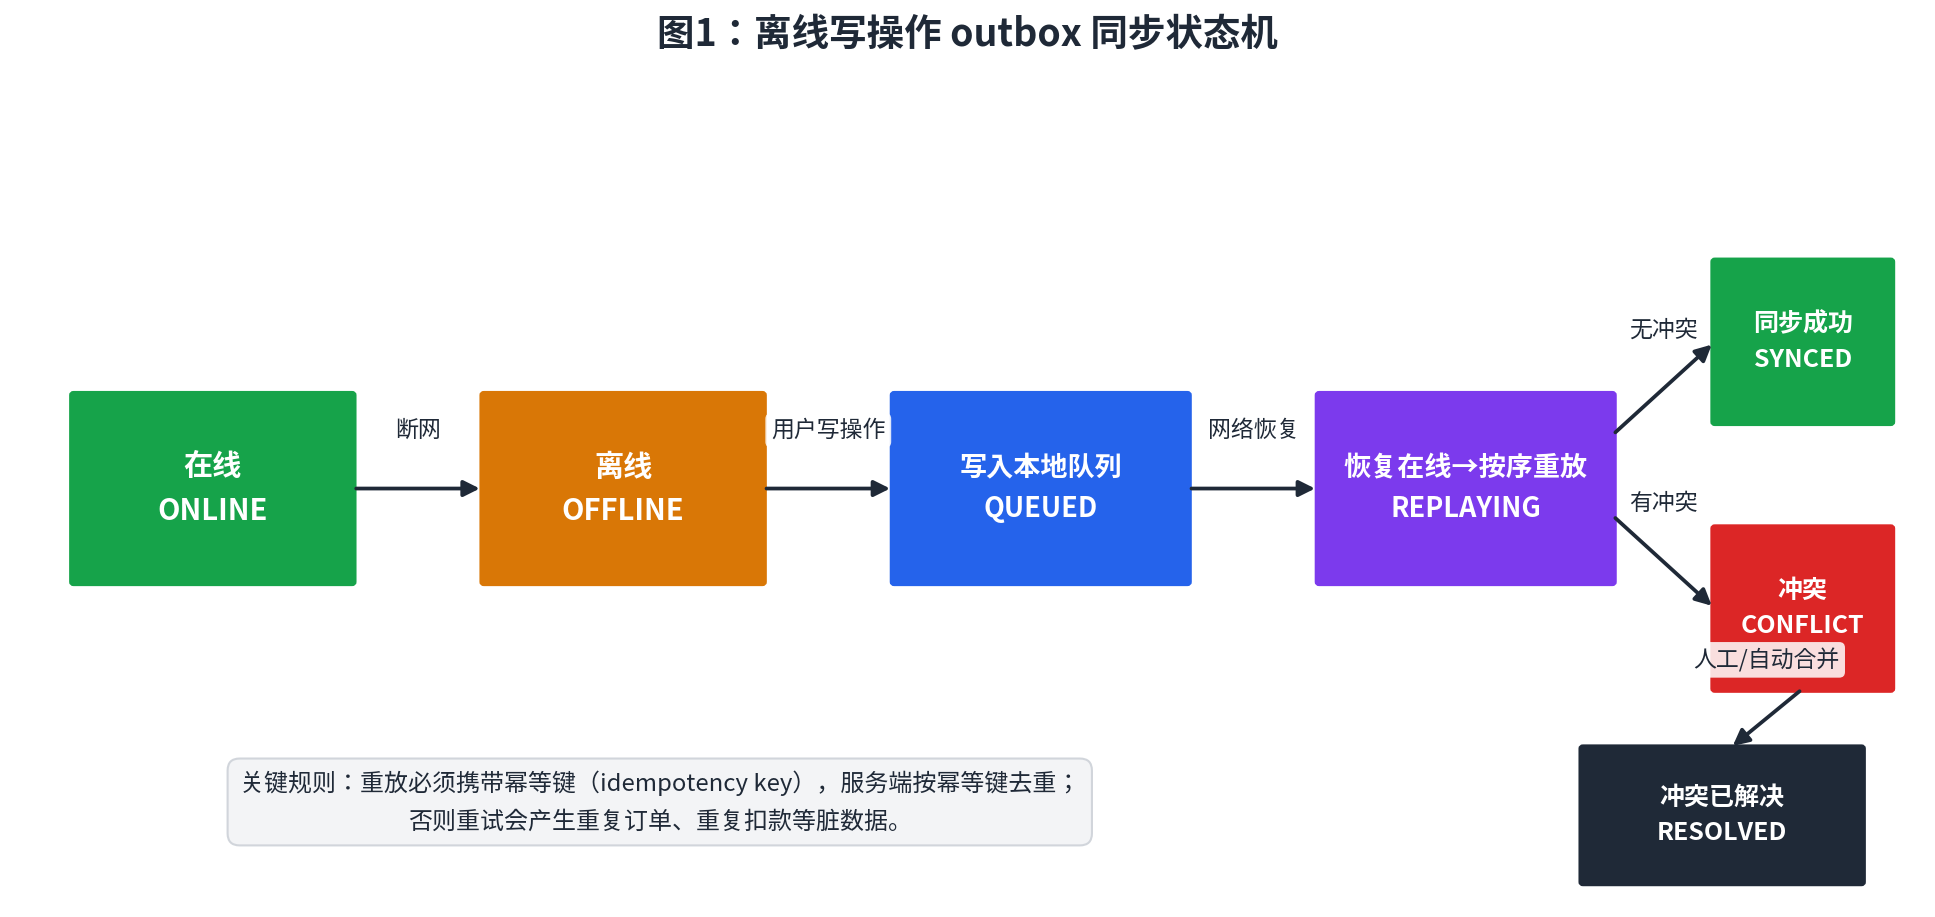 图1:outbox 同步状态机。在线→离线→写入本地队列→恢复在线→按序重放→成功或进入冲突处理。核心规则:重放必须携带幂等键,否则重试会制造脏数据。
outbox 表结构设计(Dexie 建表时一起建好):
db.version(1).stores({
  // 出队顺序按 createdAt,status 区分待同步/同步中/失败
  outbox: '++id, createdAt, status',
});

// 每条队列记录长这样
{
  id: 12,
  op: 'create-order',            // 操作类型:服务端按类型路由
  payload: { sku: 'A001', qty: 2 },
  idempotencyKey: 'op_9f3c…',    // 幂等键:客户端生成,全局唯一
  createdAt: 1728871234567,
  status: 'pending',             // pending | syncing | failed
  retryCount: 0,
}
同步函数伪代码。注意三个细节:按序重放、失败重试带退避、成功后清掉本地脏标记:
async function syncOutbox() {
  if (!navigator.onLine) return;
  const pending = await db.outbox
    .where('status').equals('pending')
    .sortBy('createdAt'); // 按序重放:顺序就是用户操作的顺序

  for (const op of pending) {
    try {
      op.status = 'syncing';
      await db.outbox.put(op);
      // 关键:每次都带上同一个 idempotencyKey,服务端按 key 去重
      await fetch('/api/' + op.op, {
        method: 'POST',
        headers: { 'Idempotency-Key': op.idempotencyKey },
        body: JSON.stringify(op.payload),
      });
      await db.outbox.delete(op.id); // 成功才删,失败留着下次重试
    } catch (e) {
      op.status = 'failed';
      op.retryCount++;
      await db.outbox.put(op);
      break; // 一条失败就停,保证顺序不乱;下次网络恢复继续
    }
  }
}
// 网络恢复 + 定时兜底,双保险触发同步
window.addEventListener('online', syncOutbox);
setInterval(syncOutbox, 30_000);这里我要把观点说到最狠:没有幂等键的重试,就是在制造脏数据。想想看:用户离线时下了个订单,重放时网络抖了一下,客户端没收到响应,以为失败了,下次又重发一次——服务端如果没有幂等键去重,用户会被扣两次款、发两次货。幂等键的规则很简单:客户端为每个操作生成唯一 key(比如 crypto.randomUUID()),服务端用 key 做去重,同样的 key 第二次来直接返回第一次的结果。实现成本是半天,省掉的是一次 P0 事故。
服务端配合也很简单:给写接口加一个 Idempotency-Key 请求头,建一张 idempotency_keys(key, response, created_at) 表,key 唯一索引。请求进来先查表,key 存在直接返回存过的响应,不存在才执行业务逻辑并把结果存下来。Redis 也行,数据库也行,别纠结选型,先有再优。
冲突解决三岔口:按场景选,别一上来就上 CRDT
做到 L2 之后,下一个问题是:如果用户在手机和电脑上同时改了同一篇笔记,同步时以谁为准?这就是冲突。三个策略,按场景选:
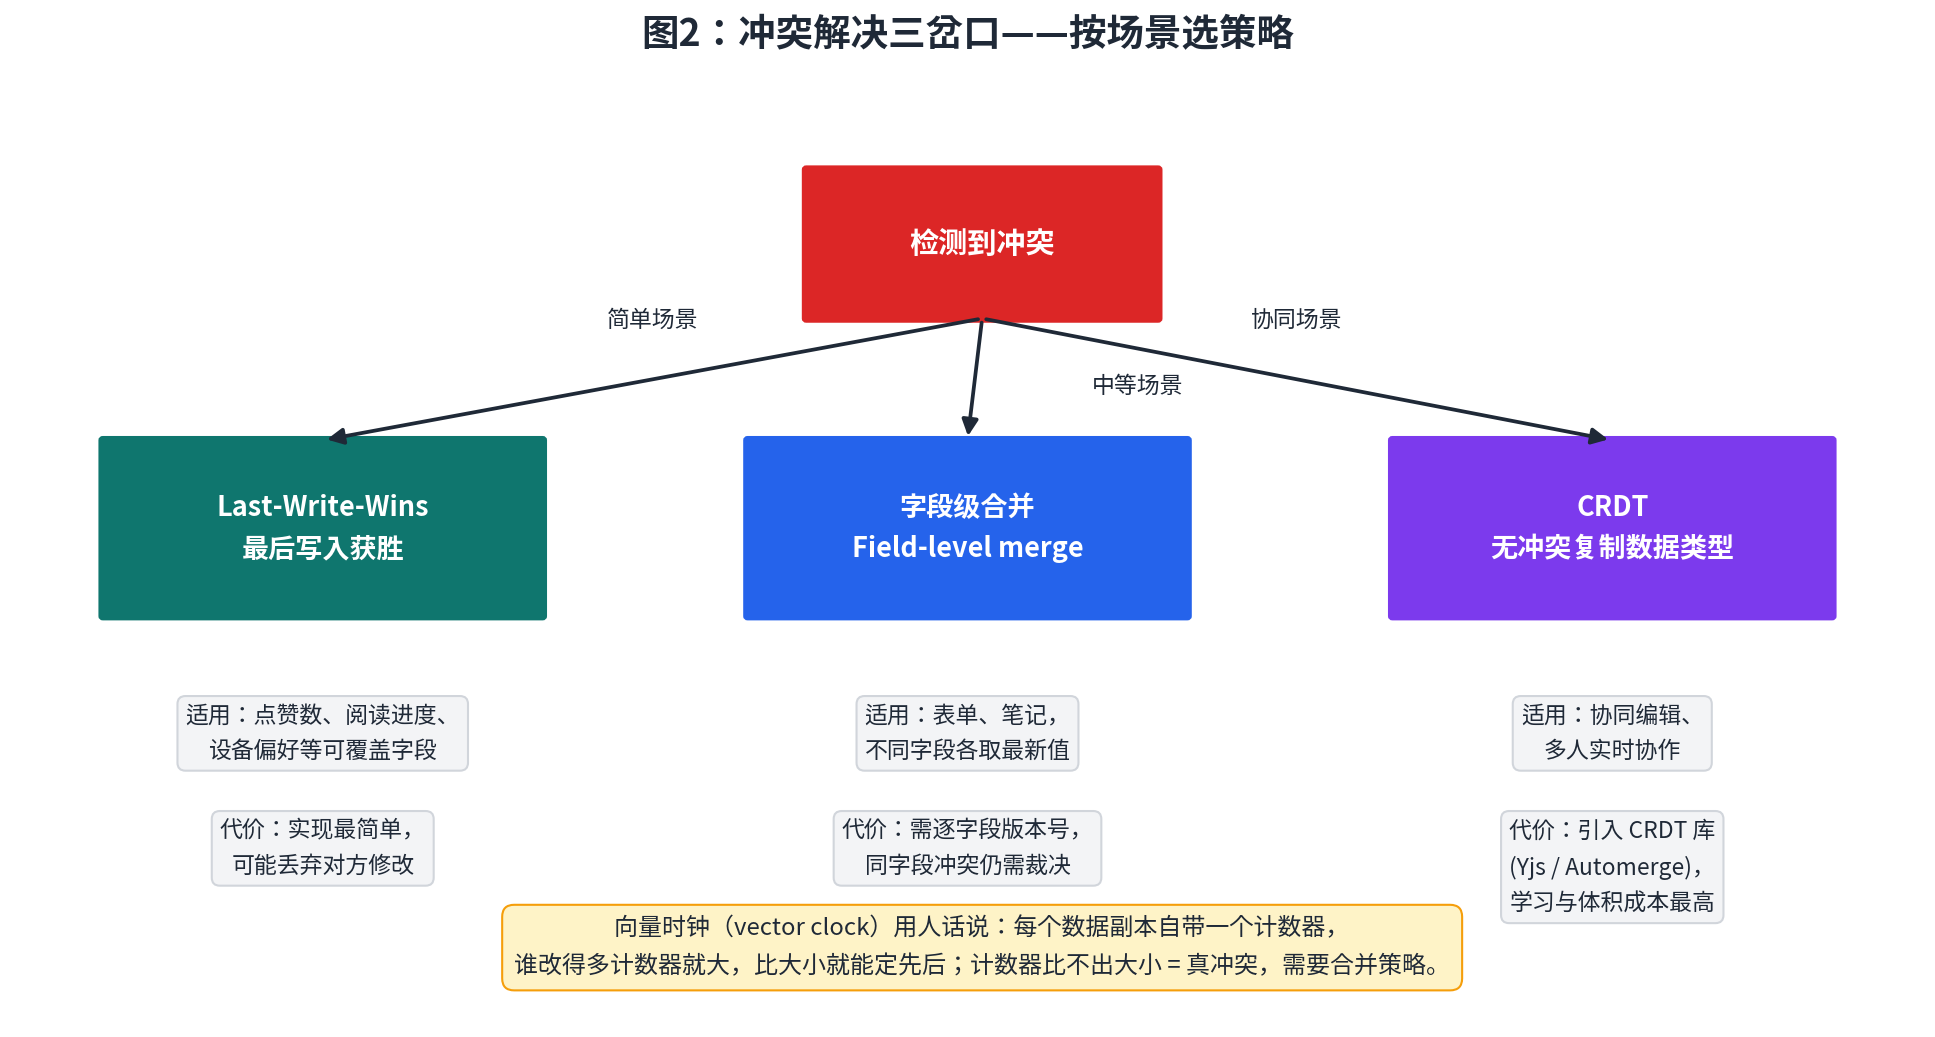 图2:冲突解决三岔口。检测到冲突后按场景分流:简单场景用 last-write-wins,中等场景用字段级合并,协同编辑才上 CRDT。每种策略都标注了适用条件与代价。
- Last-Write-Wins(LWW,最后写入获胜):谁的时间戳新听谁的。简单场景完全够用:点赞数、阅读进度、设备偏好设置——这些字段被覆盖了用户根本无感。代价是可能丢弃对方的修改,所以只用在"丢了也无所谓"的字段上。
- 字段级合并:不整条记录二选一,而是逐字段各取最新值。手机改了标题、电脑改了正文,合并后两个修改都保留。需要每个字段带版本号或更新时间,代价是中等。表单、笔记这类"不同部位各改各"的场景,这是性价比之王。
- CRDT(无冲突复制数据类型):数学上保证任何顺序合并结果一致,协同编辑的终极答案。Yjs、Automerge 都是成熟库。但代价最高:引入库、学习曲线、包体积,一个人维护的小项目,上 CRDT 之前先问自己三遍——我的用户真的需要 Google Docs 级别的实时协同吗?大多数 vibe 项目的答案是"不需要"。
向量时钟(vector clock)用人话讲一遍:每个数据副本自带一个计数器,谁改得多计数器就大;同步时比大小,大的赢;计数器比不出大小,说明两边各改各的,这就是真冲突,这时候才需要上面的合并策略。你不需要手写向量时钟,理解这个直觉就够了——"比不出大小 = 真冲突"。
最后是 UI。冲突发生了,用户界面怎么提示才不吓人?反面教材:"检测到数据冲突!版本向量不可比!"——用户看到这种文案只会想卸载。正面写法是说人话、给选择:"你在另一台设备上也改了这篇笔记,保留哪一版?"配两个按钮"保留这一版 / 看看另一版"。把技术细节藏起来,把选择权还给用户。大多数冲突用户自己一眼就能裁决,别替他做决定。
上线 checklist:发布前必须亲手测的四件事
离线功能最怕"我以为测过了"。下面四项,每一项都要亲手点一遍再上线:
- Chrome DevTools Network Offline 模拟:把网络切到 Offline,完整走一遍核心流程——浏览、创建、编辑、提交。断网状态下有任何一步白屏或报错,打回重做。这是最基础的 L1 验证,五分钟就能做完,没有借口跳过。
- 慢网 3G 测试:DevTools 里切到 Slow 3G,看弱网下的表现。重点看两点:API 请求有没有超时兜底(前面 Workbox 的
networkTimeoutSeconds: 3就是干这个的),以及提交按钮在请求 pending 时有没有禁用——用户连点三次提交按钮,outbox 里躺着三条重复操作,幂等键能兜底,但 UI 层先防住更体面。 - 杀进程恢复测试:离线写几条数据,然后直接杀掉应用进程(手机上滑掉,桌面端关标签页),重新打开,看数据还在不在、队列有没有丢。这是检验"写操作真的落盘了"的唯一办法。凡是还放在内存变量里没写进 IndexedDB 的队列,这一步全军覆没。
- 队列积压上限与降级:断网三天,outbox 里攒了 500 条操作,恢复网络时怎么办?我的建议:队列超过 100 条未同步,就明确提示用户——顶部给一条温和的横幅:"有 132 项更改等待同步,联网后自动上传",而不是静默地在后台吭哧吭哧跑。同时要做降级:图片、附件这种大体积操作排后面,先同步文字这种小体积高价值的;重放失败超过 5 次的操作,标记出来让用户手动处理,别无限重试耗电。
反模式:这四条,每条都是真实踩过的坑
- 把 JWT 放 localStorage 还谈离线安全:localStorage 里的 token,任何注入的脚本都能读。离线优先意味着你的应用在各种不可控网络环境下运行,中间人攻击面更大,token 更应该放在 httpOnly cookie 或内存里。安全和离线是乘法关系,一边是零,整体就是零。
- 无上限缓存把用户手机撑爆:Cache First 一时爽,缓存版本不清、图片不设上限,用户手机存储莫名其妙少了 2GB。Workbox 的
ExpirationPlugin是标配:给每个缓存设 maxEntries 和 maxAgeSeconds,超了自动淘汰。缓存是借来的空间,不是买下来的。 - 同步失败静默丢弃:最恶劣的一种。为了"体验顺滑",同步失败了不告诉用户,直接把队列清掉——用户以为发出去了,对方永远没收到。记住:宁可丑陋地报错,也不要优雅地丢数据。失败的操作必须留在队列里、标红、告诉用户。
- 用时间戳做唯一冲突依据:两个设备的时钟可能差好几分钟,LWW 只看时间戳,时钟快的设备永远赢。正确做法是时间戳 + 设备 ID + 计数器组合裁决,或者直接用向量时钟的思路。单机思维是分布式系统的头号杀手。
收尾:把"网络会断"写进架构第一天
离线优先不是"多写很多代码"。数一数这篇文章让你加的东西:Dexie 建两张表、Workbox 三行路由、outbox 队列表加同步函数、写接口加幂等键——一个熟练的开发者,两天能搭完骨架。真正的成本不在代码量,而在假设的切换:从"网络永远可用"切换到"网络随时会断"。
这个假设一旦写进架构第一天,后面所有的技术决策都会自动走对:状态管理天然要分本地和远端,写操作天然要进队列,UI 天然要处理 pending 状态。反过来,如果架构第一天假设网络永远可用,半年后再补离线能力,等于把地基掀了重打——那时候你补的不是功能,是架构债。
所以我的最终建议只有一句话:下次让 AI 给你生成项目骨架时,在提示词里加上一句"假设网络随时会断,离线可写、联网自动同步"。AI 会自己把 outbox、缓存策略这些东西搭进去——它不是不会写,只是你没告诉它这个假设。而你,至少在这篇文章之后,不会再有借口说"我没想到用户会在地铁里打开我的应用"。
评论 (0)
相关文章
AI 写代码快,但默认不写安全代码:本地跑通不等于线上安全。这篇实战指南带你补上 vibe 项目的 Web 安全基线——CSP 安全头、CSRF Token、XSS 防护、SQL 参数化、Cookie 三件套、依赖供应链门禁,外加一份可直接复制的上线前 10 项验收清单。
AI 帮你 deploy 到 xxx.vercel.app 只是借住。这篇实战指南带你走完买域名、DNS 解析、Cloudflare 上线链路、HTTPS 落地、邮箱三件套全链路——域名是你唯一真正拥有的资产。
AI 写的代码在单用户世界里完美运行,上线第一天就可能被 100 个并发打崩。这篇指南教你 15 分钟跑通第一条 k6 脚本:从真实用户行为反推压测场景,读懂 p95/p99 与饱和信号,用三板斧定位 DB、连接池与第三方 API 瓶颈,再把压测数字换算成能撑多少付费用户,最后让压测进 CI 自动守门。