上线前先压一下:vibe 团队的 k6 压测与容量规划实战
AI 写的代码在单用户世界里完美运行,上线第一天就可能被 100 个并发打崩。这篇指南教你 15 分钟跑通第一条 k6 脚本:从真实用户行为反推压测场景,读懂 p95/p99 与饱和信号,用三板斧定位 DB、连接池与第三方 API 瓶颈,再把压测数字换算成能撑多少付费用户,最后让压测进 CI 自动守门。
站内 10 月那篇 DHH Campfire AI 重写版压测送达率仅 1% 的资讯,应该让每个 vibe coder 后背一凉:如果连 DHH 的团队都会在压测里翻车,指望"本地跑通 = 线上撑住"的我们,凭什么?
先划一条界:《性能优化实战》讲的是"从能跑到快"的优化手段,这篇讲的是上线前"验证能撑多少人"的方法论。优化是开药方,压测是体检——这篇教你做体检。
这篇默认你已经有一个能跑的 vibe 项目、一个 staging 环境,和 15 分钟的空闲。不需要压测经验,不需要运维背景——k6 脚本复制粘贴就能跑,指标解读看完第四节就会。唯一的前置要求是诚实:压测数字不好看的时候,别改阈值,改代码。
为什么 vibe 项目最需要压测:AI 代码的三大并发放大器
AI 写代码有个结构性盲区:它只在"单用户世界"里验证。本地跑通、测试通过、demo 丝滑——这些都是 1 个并发下的结论。而生产环境的问题从来不是"功能对不对",而是"100 个人同时点会发生什么"。AI 生成的代码里藏着三个并发放大器,平时隐身,流量一到就指数级放大:
放大器一:N+1 查询。AI 用 ORM 写列表页,几乎默认懒加载:先查 50 条订单,再对每条订单查一次用户信息。本地 51 次查询跑下来 30 毫秒,你觉得没问题;上线后 100 个并发,就是每秒 5100 次查询——数据库连接直接被打满,p99 从 100 毫秒飙到 10 秒。这不是"慢",这是"在某个并发数上突然死亡",而 AI 永远不会提醒你那条隐式的循环查询。
放大器二:缺失的连接池。AI 很少主动给你配连接池。Serverless 函数每次请求新建数据库连接、请求结束再断开;Postgres 默认 max_connections = 100,第 101 个并发请求开始排队,第 200 个直接报错。症状极具迷惑性:50 并发一切正常,120 并发延迟断崖——你以为是代码慢了,其实是连接在排队。AI 不写连接池不是因为它不懂,而是因为"本地 1 并发"根本测不出区别。
放大器三:没有超时的外部 API。你的接口里调了一次大模型 API、一次支付、一次地图服务,AI 生成的代码经常不设 timeout。对方慢 3 秒,你的一个 worker 就被占用 3 秒;并发一上来,worker 池被外部依赖活活拖死。更扎心的是:你在压测别人的 SLA,还在为别人的慢付账单——按调用量计费的 AI API,一次压测可能烧掉你一周的预算。
一人团队没有 QA,压测是发版前唯一客观的质量门。别指望流量"慢慢涨"给你留优化时间:Product Hunt 上榜、一条 X 帖子爆了,流量都是从 0 到 100 的阶跃。上线前花 15 分钟压一下,是你能买到的最便宜的保险。
为什么偏偏是 AI 写的代码最容易中招?因为大模型的训练数据里,绝大多数代码示例都是"处理一个请求"的写法——教程、StackOverflow 答案、开源 demo,没有一个会告诉你"这段代码在 200 并发下会怎样"。AI 只是在复现它见过最多的模式,而"考虑并发"恰好是人类工程师靠线上事故换来的经验,不是靠看文档学会的。你让 AI 写,它就给你"单用户世界"的最优解;并发是事后才显现的维度,AI 的验证回路里根本没有这一环。
还有一个 vibe 团队特有的坏习惯:demo 驱动开发。AI 10 分钟给你搭出完整功能,你在浏览器里点两下,"能用",直接部署。这种"写代码→肉眼验证→上线"的回路里,没有任何一个环节会问"100 个人同时点呢"。传统团队至少还有测试和 code review 两道关,vibe 团队把这两道关都外包给了 AI 的自信——而 AI 的自信是最不值钱的东西。压测就是你亲手加回去的那道关,客观、不讲情面、15 分钟出结果。
15 分钟跑通第一条 k6 脚本
为什么是 k6?三个理由:单二进制文件,装完即用;用 JavaScript 写脚本,vibe coder 零学习成本;阈值(thresholds)断言内置,跑完直接告诉你"过没过",而不是丢给你一堆图表自己悟。JMeter 太笨重,Locust 还要自己搭 Python 环境——第一次压测,摩擦力越小越好。
三步走。第一步安装:brew install k6,或者 docker run --rm -i grafana/k6 run - <script.js。动手之前先做 3 分钟准备,免得第一次运行测了个寂寞:staging 必须是最新部署的代码;确认 staging 的数据库里有量级真实的数据(见第三节);找运维(如果就是你自己)确认 staging 的机器规格和生产一致——在 2 核的 staging 上压出"没问题",上线到 8 核生产当然没问题,但反过来在 8 核 staging 上压的数字,不能直接套用到 2 核的生产。
第二步,把下面这段存成 load.js——它是能直接运行的:
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  // 爬坡:30 秒加到 20 个虚拟用户,保持 1 分钟,再 30 秒降下来
  stages: [
    { duration: '30s', target: 20 },
    { duration: '1m', target: 20 },
    { duration: '30s', target: 0 },
  ],
  // 及格线:p95 延迟 < 500ms,失败率 < 1%,不过就判红
  thresholds: {
    http_req_duration: ['p(95)<500'],
    http_req_failed: ['rate<0.01'],
  },
};

export default function () {
  const res = http.get(`${__ENV.BASE_URL}/api/health`);
  check(res, {
    'status is 200': (r) => r.status === 200,
    'body is not empty': (r) => r.body.length > 0,
  });
  sleep(1); // 模拟用户思考时间,别去掉
}第三步运行:BASE_URL=https://staging.yourapp.com k6 run load.js。几个关键点:stages 是爬坡——永远别一上来就满压,先热身再看稳态;thresholds 是考试及格线,没有阈值的压测只是表演;sleep(1) 模拟真实用户的思考间隔,去掉它你测的就不是用户行为,是 DDoS。
跑完看 summary,第一次只需要看懂五行:http_reqs 是总请求数,http_req_duration 下面有 avg/med/p(90)/p(95)——直接看 p(95) 对没对上你的阈值;http_req_failed 是失败率;vus_max 确认虚拟用户数确实爬上去了;checks 看断言通过率。如果 thresholds 那一行是红的 ✗,k6 进程退出码非零——这正是 CI 能拦下 PR 的原理,后面第七节会用上。
选型上多说一句:k6 不是唯一选择,但它是 vibe 团队摩擦力最小的选择。JMeter 功能全但 GUI 笨重,脚本是 XML,版本管理痛苦;Locust 要自己搭 Python 环境写 locustfile,分布式还要配 master/worker;k6 一个二进制、JS 脚本、阈值内置,Grafana 全家桶原生支持。你的目标不是成为压测专家,是 15 分钟内拿到第一组数字——先跑起来,再谈高级。
第一次跑,大概率直接飘红。恭喜——这是压测在帮你省钱,而不是上线后用户帮你发现。
脚本建议按"三件套"组织,别全塞在一个文件里:smoke.js(10 VUs、2 分钟,给 CI 的冒烟)、load.js(按预期峰值流量跑 10–15 分钟,上线前的体检)、spike.js(0 到 500 并发 30 秒内加上去,模拟上榜尖峰)。三个文件共享同一份场景函数,阈值各不相同——冒烟的阈值宽、全量的阈值严。vibe 团队最容易犯的错是"一个脚本打天下",结果 CI 跑 15 分钟没人愿意等,最后 CI 里的压测被默默删掉。
铁律先立好:k6 只打 staging,永远不对准生产库。拓扑应该是下面这样,四个观测点一个都不能少:
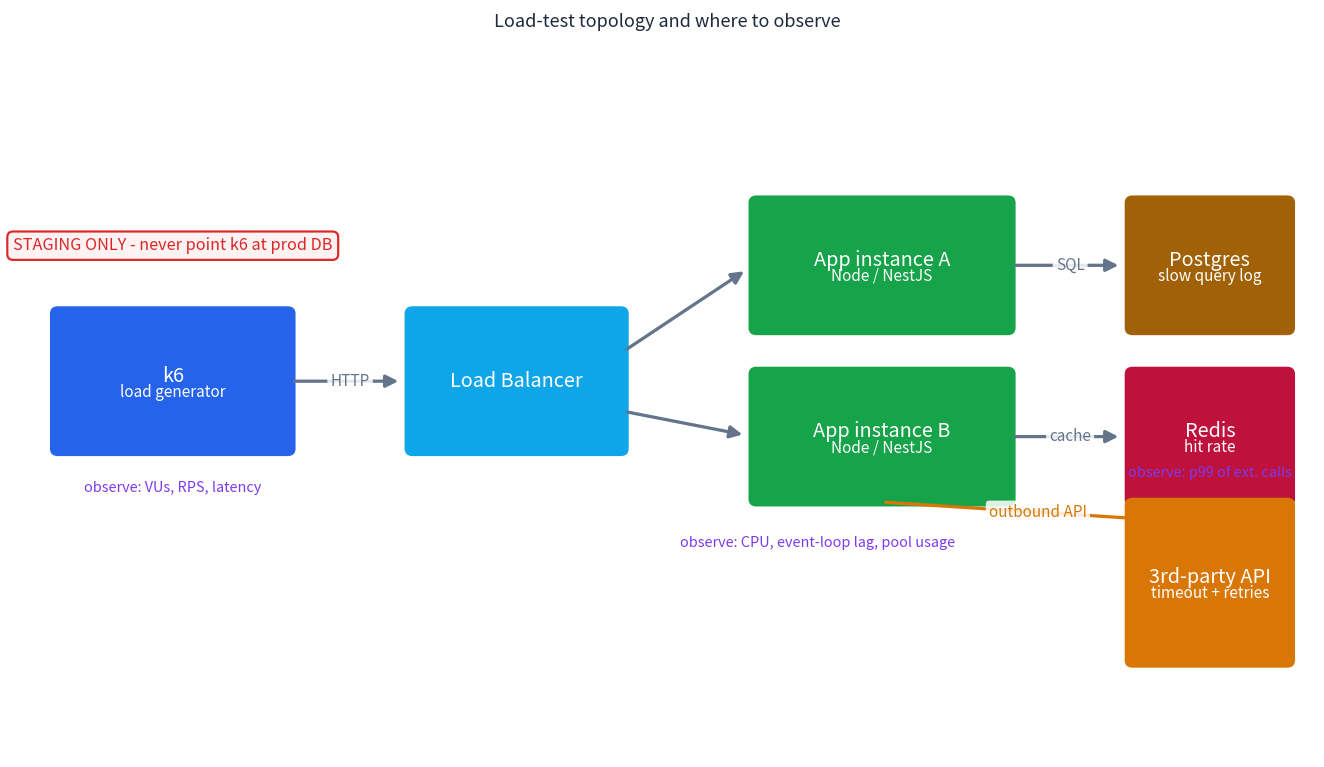 压测拓扑:k6 只打 staging 环境。四个观测点——k6 侧看 VUs/RPS/延迟;应用侧看 CPU、事件循环延迟、连接池占用;DB 看慢查询日志;第三方 API 看 p99 与超时。只看 k6 的数字、不看服务端指标,等于闭眼开车。
压测场景设计:别压首页,压收钱的路
新手压测最常见的姿势:把虚拟用户平均分配到所有接口,每个接口压一遍,出一份"全绿"报告。这是自欺欺人——真实流量从来不是均匀的,你的首页可能占 70%,支付接口只占 2%,但支付挂了才是 P0。
正确姿势是从真实用户行为反推压测模型。列出你的核心路径:注册 → 登录 → 浏览列表 → 下单支付。去看生产(或内测)的访问日志,按真实比例分配权重。没有生产日志?用内测数据估:让 5 个朋友各用 10 分钟,Nginx/网关的 access log 里 awk '{print $7}' | sort | uniq -c | sort -rn | head -20 一跑,top 接口和比例就出来了。权重不需要精确到小数点,"列表页 70%、详情 20%、下单 10%"这种量级对了就行——压测模型是地图,不是卫星照片,方向对了比精度重要。k6 的 scenarios 就是干这个的:
export const options = {
  scenarios: {
    browse: {       // 70% 流量:浏览列表
      executor: 'ramping-vus',
      exec: 'browseFlow',
      stages: [{ duration: '2m', target: 70 }],
    },
    checkout: {     // 20% 流量:下单(写操作,必须测)
      executor: 'ramping-vus',
      exec: 'checkoutFlow',
      stages: [{ duration: '2m', target: 20 }],
    },
  },
};

export function browseFlow() {
  http.get(`${__ENV.BASE_URL}/api/products`);
  sleep(2);
}

export function checkoutFlow() {
  const login = http.post(`${__ENV.BASE_URL}/api/login`, JSON.stringify({
    email: `loadtest-${__VU}@example.com`, password: 'test1234',
  }));
  const token = login.json('token');
  http.post(`${__ENV.BASE_URL}/api/orders`, JSON.stringify({ sku: 'SKU-001' }),
    { headers: { Authorization: `Bearer ${token}` } });
  sleep(3);
}
四个设计判断,个个都是坑里爬出来的:
- 写路径必须测。读便宜、写贵。只压 GET 接口等于没压——锁、事务、唯一索引冲突全在写路径里。staging 的数据要能一键重置,别让测试订单污染下一次压测。
- 别所有虚拟用户共用一个 token。同一个账号登录 100 次,限流器和缓存会给你一份漂亮的假数据。准备一池测试账号,用
__VU编号区分。 - 压登录,别只压首页。首页往往是静态缓存,压它测的是 CDN。登录、搜索、下单这些走数据库和业务逻辑的,才是你的真实成本。
- 思考时间是场景的一部分。真实用户点一下、看两秒;去掉
sleep的压测,RPS 虚高三倍,结论全是错的,还显得你很懂——最危险的那种错。
场景设计之前,先分清四种压测在测什么,别拿着锤子当尺子:负载测试(load)是"预期流量下稳不稳",这是上线前的必考项;压力测试(stress)是"往死里加压,看哪里先断、天花板在哪";尖峰测试(spike)是"0 到 500 并发瞬间加上来",模拟的就是 Product Hunt 上榜那一刻,专治"爬坡没问题、一上量就崩"; soak 测试是"恒定压力跑几小时",专抓内存泄漏和连接泄漏。一人团队时间有限,记住这个优先级:上线前必做负载测试,有余力加一次尖峰测试,soak 扔给 CI 定时跑。
还有一个被严重低估的输入:staging 的数据。用 AI 生成的 20 条假数据压测,查出来全是"性能优秀"——因为索引和全表扫描在 20 行数据下没有区别。staging 的数据量级至少要接近生产:用户表几十万行、订单表几百万行,不需要真实数据,但需要真实的量级和分布。否则你压的是一个不存在的系统,结论比不压更有害——它给了你虚假的安全感。
读懂指标:p95、错误率、饱和信号与"假健康"
k6 跑完会吐一堆数字,新手只看两个:"Requests/sec" 和 "Avg"。先说结论:平均延迟是压测里最没用的指标。
p50、p95、p99 说的是分布:p95 = 500ms 意味着 95% 的请求比 500ms 快,还有 5% 更慢。为什么看 p95 不看平均?因为平均数会撒谎:100 个请求里 95 个 100ms、5 个 8000ms,平均是 495ms——"看起来还行",但那 5% 往往是付费意愿最强的重度用户,他们正在等 8 秒然后流失。定阈值只定 p95/p99,不给定平均。
错误率(http_req_failed)是第二根红线。起步阈值 rate<0.01,上线前要压到 rate<0.001。注意:错误率要在"目标 RPS"下看——20 并发 0 错误、200 并发 5% 错误,说明天花板在中间某个位置,你的任务就是找到它。
SLO(阈值里的那个数字)从哪来?从用户的忍耐度倒推,不是拍脑袋:API 接口 p95 500ms、页面首屏 2 秒、支付链路 p99 3 秒——这是 web 产品的常识线。定完写进 thresholds,超了就是 bug,和"按钮点不动"同级。最忌讳的是"先压测、看结果、再定阈值"——那叫用结果定义及格线,永远全绿,永远没用。阈值必须在压测之前定,定完不许因为"差一点"就放宽;真觉得阈值不合理,走变更流程改,而不是在跑红的那天晚上偷偷改数字。
饱和信号长这样:RPS 不再随虚拟用户增加而上涨,延迟曲线开始指数爬升。背后的直觉是利特尔法则:系统内同时处理的请求数 = RPS × 平均耗时。耗时一涨,堆积的请求越来越多,延迟进一步涨——雪崩就是这么来的。看到"吞吐见顶 + 延迟起飞"的组合,就是你的容量天花板,再往上压只是在测量崩溃的样子。
举个具体的手感:50 个虚拟用户时 RPS 180、p95 300ms;加到 100 个虚拟用户,RPS 还是 185,p95 却飙到 2.1 秒——天花板就是 180 RPS,多加的 50 个用户只是在排队。然后回头去看服务端:这时候 CPU 打满了就是算力瓶颈,CPU 空闲但延迟照样飞,就是锁、连接池或外部依赖在排队。RPS 见顶的位置,和"哪里排队"结合起来看,瓶颈自然现形,下一节的三板斧就是顺着这个思路来的。
最阴险的是"假健康"——数字全绿,系统其实没被测到。三种经典造假:
- 200 但 body 是空的。AI 代码爱吞异常:catch 里
return res.json({}),状态码 200,数据是空的。所以check必须断言 body 内容,不只断言 status。压测断言写得不狠,等于没测。 - 全命中缓存。压了 2 分钟,Redis 命中率 99%,源站表示"你们在压谁?"。看缓存命中率指标;要么关缓存测最坏情况,要么按真实命中率预热——二选一,别混着来。
- staging 的库是空的。100 行的表全走内存,查询计划跟生产 1000 万行的表完全是两回事。staging 的数据量级要接近生产,至少让索引和全表扫描的分野真实。
一句话判断:p95 超了 SLO,先别急着优化,先确认压测本身没作弊。优化一个假问题,比不优化更贵。
附 k6 核心指标速查,跑完 summary 对着看:http_req_duration(各分位延迟,看 p95/p99)、http_req_failed(失败率)、http_reqs(总请求数,除以时长就是实际 RPS)、vus/vus_max(虚拟用户数,确认爬坡真的上去了)、iteration_duration(单次迭代耗时,含 sleep)、checks(断言通过率)、data_received(带宽,RPS 上不去时看看是不是网卡先满了)。自定义指标也不难:import { Trend } from 'k6/metrics',给关键业务接口(如下单)单独记一个 Trend,它的 p95 才是老板该看的数字。
瓶颈定位三板斧
数字红了之后别慌,定位瓶颈是个闭环流程:压测给数字 → 定位找瓶颈 → 一次只改一处 → 用同一套脚本回归验证 → 不绿就再来一轮。这个环要转起来,而不是"感觉慢了,加台机器":
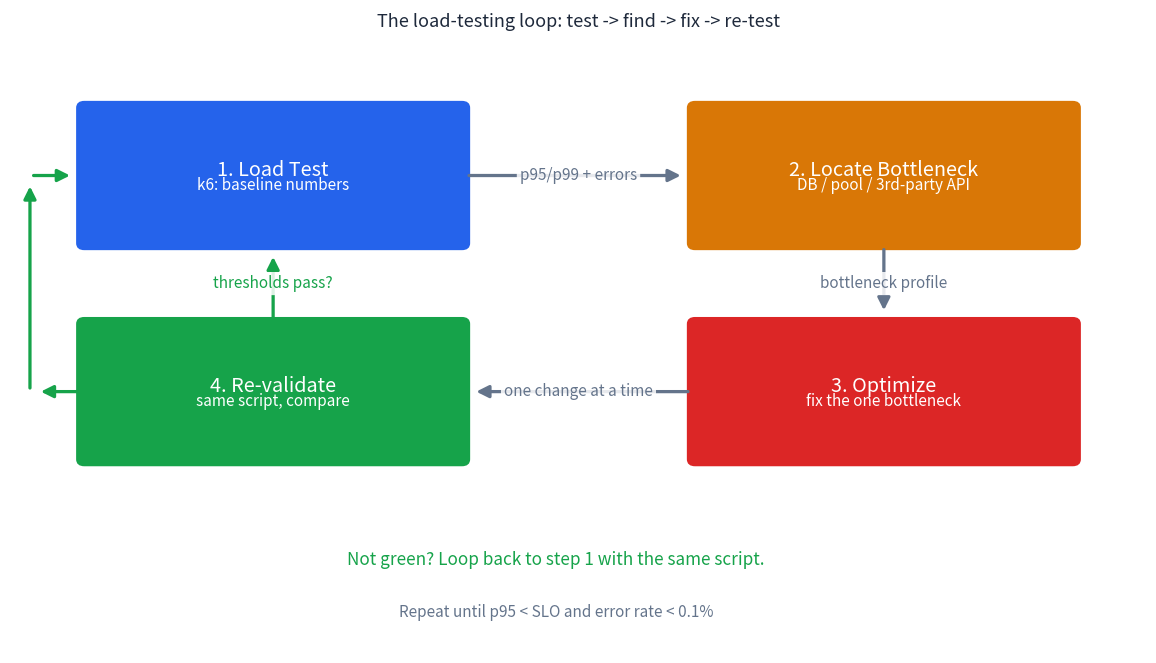 压测闭环:同一套脚本是"尺子",每次回归都用它量。一次只改一处——同时改三处,p95 降了你都不知道是谁的功劳,下次复发没法复现。
板斧一:查 DB。先看慢查询日志(Postgres 开 pg_stat_statements,按总耗时排序)。N+1 有非常鲜明的指纹:同一个 SQL 在一次请求里出现几十次,只是参数不同。修法就两招:join 预加载,或者 dataloader 批量合并。判断顺序:DB CPU 先满 → 先优化 SQL;DB CPU 很空闲但应用慢 → 瓶颈不在 DB,往下看。
动手查的时候别只看"单次最慢",要看"总耗时 = 平均耗时 × 调用次数":一条 5ms 的查询被调用 2 万次,比一条 800ms 只跑 3 次的查询贵得多。pg_stat_statements 按 total_exec_time 排序,排第一的通常就是你要修的。对 AI 生成的 Prisma/Drizzle 代码,重点 grep 循环里的 findUnique/findFirst——十个 N+1 里有九个长这样。修完用 EXPLAIN ANALYZE 确认执行计划真的走了索引,而不是从"全表扫描 50 次"变成"全表扫描 1 次"。
板斧二:查连接池。症状:并发一过某个数延迟断崖式上涨,DB CPU 却不高——连接在排队,不在干活。去看应用侧连接池的等待队列长度。修法:配连接池,大小有个用了几十年的老公式——连接数 ≈ CPU 核数 × 2 + 有效磁盘数,够一人团队用;Serverless 架构直接上 PgBouncer 或带连接池的数据库代理。AI 代码最常见的写法是每个请求 new Client(),先 grep 你的代码库有没有这句。
Serverless 是重灾区,单独说一句:Vercel/Netlify 的函数每次调用都可能新建连接,Neon、Supabase 这类 serverless Postgres 都提供了 pooled 连接串(通常端口 6543,走 PgBouncer)——AI 生成的代码里十有八九用的是直连串。改法就是换一根连接串,5 分钟的事,但没人压测的话,你要在上线后掉线的那一刻才知道。用 pg_stat_activity 数一下压测时的实际连接数,如果它跟着并发数一起涨,说明根本没有池在起作用。
板斧三:查第三方 API。给每个外部调用加 timeout(连接 3 秒、读取 10 秒起步),加熔断器;压测时把外部依赖 mock 掉——否则你是在给别人的 API 做压测,账单还可能算你的。修法三件套:超时、带退避的重试、降级(缓存兜底,宁可给旧数据也不让整条链路 hang 死)。
三板斧的排查顺序也有讲究,别乱挥:先看错误率——有 5xx 就先看日志堆栈,那是明示的 bug;错误率正常但 p99 难看,就去看 p99 的请求都慢在哪一段(是 DB、是外部 API、还是排队),用分布式 tracing 或简单的分段打点拆开;如果延迟是"齐涨"(p50/p95/p99 一起涨),多半是某种全局资源见顶——连接池、CPU、带宽;如果只有尾部涨(p50 好好的,p99 飞了),多半是锁竞争、GC 停顿或某个慢依赖。AI 生成的代码里,这四种我全见过,而"齐涨还是尾涨"这个二分法,能帮你 5 分钟内把排查范围砍掉一半。
看一个示意案例:某个列表接口,修掉 N+1(50 次查询合并成 2 次)并把连接池从"没有"配到 20,前后用同一套 k6 脚本量的结果——
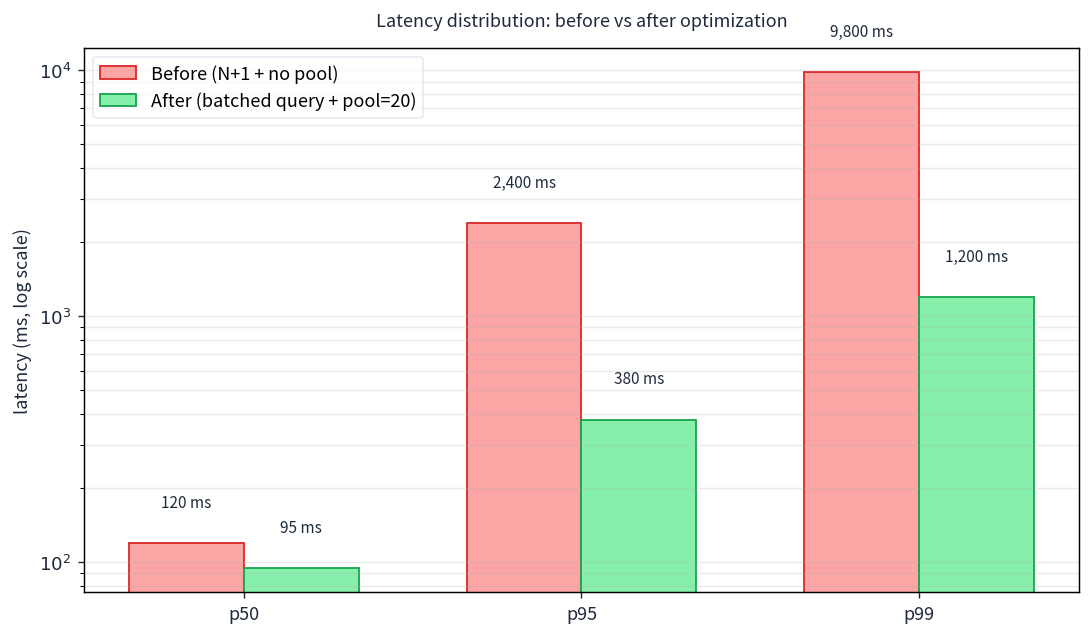 优化前后延迟分布对比(示意数据):p50 只降了 25ms,p95 降了 6 倍,p99 降了 8 倍。尾部延迟才是 N+1 和连接池问题的主战场——只看平均值,你会错过真正的优化收益。
容量规划:从压测数字算出能撑多少付费用户
压测的终极问题不是"p95 多少",而是"老板问'我们能撑多少用户'时,你能不能给个数字"。能,而且公式不复杂。
核心公式就一行:
并发用户数 = 可持续 RPS ÷ 单个用户每秒请求数
其中"可持续 RPS"指压测中 p95 < SLO 且错误率 < 0.1% 时的最大 RPS。走一个完整例子(数字是示意,方法可直接套用):
- 压测结论:120 RPS 时 p95 = 420ms(SLO 是 500ms),错误率 0.05% → 可持续 RPS = 120。
- 用户行为:活跃用户平均每 8 秒发 1 个请求 → 单用户 0.125 rps。
- 并发用户:120 ÷ 0.125 = 960 个同时在线的活跃用户。
- 水位线:永远留 40% 余量应对发布、抖动和爬虫 → 960 × 0.6 = 576。
- 峰值在线率:SaaS 产品通常 15–25% 的注册用户同时在线,取 20% → 可支撑注册用户 2880。
- 付费转化:按 10% 付费率 → 约 288 个付费用户。
合起来:付费用户 ≈ 可持续 RPS × 0.6 ÷ 单用户 rps ÷ 峰值在线率 × 付费率。每个参数都是假设,但假设写在纸面上就可以被挑战、被修正——这比"应该能撑几千人吧"的拍脑袋强一个数量级。
这份容量规划的输出物,建议就是一页纸,贴在你的发布 checklist 里:可持续 RPS 是多少、在什么 SLO 下测的、五个假设参数各取了什么值、结论是撑多少付费用户。下次优化完、加完机器、上了缓存,重跑一遍压测,把这页纸更新——容量规划不是一次性算命,是每次发版前 5 分钟的例行动作。数字会过时,但"每次都知道自己能撑多少人"的习惯不会。
算出来不够怎么办?三个杠杆,按性价比排序:
- 提 RPS(修瓶颈)。先看第五节的三板斧。多数 vibe 项目的第一轮优化就能把 RPS 翻 3–5 倍——N+1 修掉、连接池配上,120 RPS 变 500 RPS 是常见剧情。先修代码,再谈加机器。
- 降单用户请求数。列表接口一次返回 50 条改成 20 条、轮询改成 SSE/长连接、静态资源甩给 CDN。用户每 8 秒 1 个请求降到每 12 秒 1 个,容量直接涨 50%,而你一行后端代码都不用改。
- 接受现实(限流)。短期撑不住就先限流排队:网关层按用户限流,超了返回 429 + 友好的"稍后再试"。排队总比崩了好——崩了是所有人一起 500,限流是 5% 的人多等 30 秒。把限流阈值设在压测天花板的 80%,这是用数字换来的体面。
容量规划不是算命,数字会错,但"120 RPS 撑 300 付费用户"这个量级的判断,能决定你是该加机器还是先优化——这就是压测的商业价值:把"我觉得"变成"我测过"。
压测进 CI:让每次发版自动"考试"
压测最大的敌人是"想起来才压"。进 CI 的核心就一条:阈值不过,构建变红。分两层:
冒烟层(每个 PR 都跑):10 个虚拟用户跑 2 分钟,只求"没退化"。GitHub Actions 里用官方 action,一段 yaml 搞定。第一次接入别贪多:阈值就设两条——p(95)<800 和 rate<0.01,比你的目标 SLO 放宽一档。冒烟测试的任务是"抓退化",不是"证明达标":上周 p95 300ms 的接口这周变成 900ms,CI 变红拦下 PR,这就值了。阈值太严会导致 PR 天天红、大家开始无视 CI——宽进、再慢慢收紧。
- name: Smoke load test
  uses: grafana/k6-action@v0
  with:
    filename: smoke.js
    flags: --env BASE_URL=${{ secrets.STAGING_URL }}
  # thresholds 在 smoke.js 里定义,不过则这一步失败,PR 合并被拦下
全量层(定时 + 大版本):每周对 staging 跑一次 30 分钟的 soak 测试——soak 测的不是性能,是内存泄漏:RPS 恒定跑 30 分钟,如果延迟缓慢爬坡、内存只涨不跌,就是泄漏,AI 生成的全局缓存和未清理的定时器是重灾区。
两个判断:第一,阈值要进版本库,和代码一起被 review——"p95 < 500ms" 是产品需求,不是运维私货。第二,冒烟压测的 staging 必须是"每次部署自动更新"的,否则你压的是上周的代码,红了绿了都没意义。
跑起来的数字别只留在 CI 日志里。k6 可以把指标吐到 Grafana(k6 run --out prometheus 或 Grafana Cloud k6),阈值一破直接往 Slack 发告警——你会得到一条随时间变化的性能基线。三个月后回头看,你会发现这条基线比任何"感觉变慢了"的体感都诚实:某次发版 p95 从 300ms 爬到 450ms,基线图上一目了然,而没有基线的话,你要到用户投诉才知道。一人团队最缺的就是这种"不依赖记忆"的客观记录。
压测反模式:六个坑,一个都别踩
- 压生产。"staging 和生产配置一样,压生产更真实"——真实,但一次误操作就是 P0。staging 数据量接近生产、配置看齐生产,压 staging;生产只做金丝雀发布后的小流量观察,不做压测。两者的分工别混。
- 忽略预热。JIT 编译、连接池建连、缓存冷启动——前 1–2 分钟的数据直接丢掉。k6 的 stages 里单独留一段 warmup 爬坡,分析时掐头去尾。冷启动的数字不是性能,是"刚睡醒"的样子。
- 只看平均延迟。见第四节。平均 200ms 和"5% 用户等 8 秒"可以同时成立,而后者才是决定口碑的数字。
- 压测机先跪了。笔记本 CPU 跑满 90%,你测的是自己电脑的瓶颈。盯着 k6 进程的 CPU,超过 70% 就加压测机或分布式跑——k6 单机的瓶颈比你想象的来得早,压出"天花板"之前先确认天花板不在你这边。
- 缓存失真。要么关缓存测最坏情况,要么按真实命中率预热。二选一,别混着来,更别"不小心"全命中了还拿着报告说全绿——那份报告唯一的读者是你自己,骗它干什么。
- 一次改三处。优化完 p95 降了,却不知道是谁的功劳——下次复发时没法复现,等于白干。闭环图的"一次只改一处"不是洁癖,是为了让每次回归都有意义:每一次变绿,你都知道是为什么绿。
回到开头那条界:《性能优化实战》教你把项目从能跑变快,这篇教你证明它撑得住。优化是开药方,压测是体检报告——先体检,再吃药,最后复查。下次发版前,花 15 分钟跑一遍脚本,这是 vibe 团队最便宜的一道保险:崩溃发生在上线当天凌晨三点的代价,永远比 staging 里的一次飘红贵得多。
评论 (0)
相关文章
AI 帮你 deploy 到 xxx.vercel.app 只是借住。这篇实战指南带你走完买域名、DNS 解析、Cloudflare 上线链路、HTTPS 落地、邮箱三件套全链路——域名是你唯一真正拥有的资产。
AI 写代码快,但默认不写安全代码:本地跑通不等于线上安全。这篇实战指南带你补上 vibe 项目的 Web 安全基线——CSP 安全头、CSRF Token、XSS 防护、SQL 参数化、Cookie 三件套、依赖供应链门禁,外加一份可直接复制的上线前 10 项验收清单。
语音 demo 好做,能上线的语音功能是链路工程。这篇指南讲透:三种形态(STT/TTS/实时对话)对号入座、400ms 延迟预算在采集→STT→LLM→TTS→播放全链路的拆分、Whisper 系与流式 STT 取舍、TTS 音质/延迟/成本不可能三角、打断与轮次状态机、浏览器端五个坑、成本建模与防刷,以及 10 项上线验收清单。