让你的产品开口说话:vibe 项目的语音功能接入实战
语音 demo 好做,能上线的语音功能是链路工程。这篇指南讲透:三种形态(STT/TTS/实时对话)对号入座、400ms 延迟预算在采集→STT→LLM→TTS→播放全链路的拆分、Whisper 系与流式 STT 取舍、TTS 音质/延迟/成本不可能三角、打断与轮次状态机、浏览器端五个坑、成本建模与防刷,以及 10 项上线验收清单。
先划一条界:站内那篇《消息原生应用设计》讲的是文本对话的产品形态——气泡、已读回执、正在输入怎么设计;这篇讲的是音频链路工程——声音从麦克风进去、从扬声器出来,中间每一毫秒花在哪里。同样是"对话",一个是界面问题,一个是工程问题,解法完全不通用。
2026 年是语音 Agent 爆发的一年:Sesame 的语音助手 10 月刚做了大更新(站内资讯),Tavus 的实时视频交互甚至让近半数测试者没认出对面是 AI(站内资讯)。vibe coder 们纷纷想给自己的产品"开口说话",但卡住的地方几乎从来不是模型能力,而是工程细节:AI 生成的语音 demo 清一色是"录完整段再调 API",真实产品要过的,是另一套关。
这篇指南把语音接入拆成 8 个实战问题:三种形态先对号入座、400ms 延迟预算怎么拆、STT/TTS 怎么选、实时对话的打断怎么做、浏览器端五个坑、成本账怎么算、上线前怎么验收。目标只有一个:让你第一次就接对,不返工。
一、三种形态:先对号入座,再谈选型
"给产品加语音"这句话,至少有三种完全不同的意思,工程难度差一个数量级。动工之前先回答:你的产品到底要哪一种?
- 转写(STT):音频进、文字出。会议纪要、语音搜索、字幕生成、语音输入框。用户不期待"对话",只期待"听得准"。
- 合成(TTS):文字进、音频出。播报、朗读、语音通知、有声内容。用户不期待"交互",只期待"好听、及时"。
- 实时对话:双向、可打断。语音助手、AI 电话客服、口语陪练。用户期待的是"像跟人说话一样",这是地狱难度。
先说最重要的判断:90% 的 vibe 项目其实只需要前两种。实时对话是核武器,只有当"打断"是核心交互时才值得——它的工程量和成本是串行方案的 5–10 倍。先问自己一个问题:用户真的需要打断 AI 吗?还是"说完一段、等 AI 回一段"就够了?如果是后者,用"语音消息"形态(STT → LLM → TTS 串行)体验完全够用,成本和复杂度都低一个量级。很多团队一上来就奔着"实时对话"去,做完才发现用户的使用方式根本就是留言式的。
举几个对号入座的实例,帮你建立直觉:笔记 App 里的"语音输入"→ 转写,用 Whisper 批量就行;播客剪辑工具的"生成字幕"→ 转写,离线跑更快更便宜;App 里的"语音播报通知"→ 合成,预合成缓存;AI 英语口语陪练 → 这才是实时对话,因为学生一定会打断老师。判断标准很简单:把"用户会不会打断"换成"用户打断了,产品会不会显得很蠢"——如果会,才是实时对话。
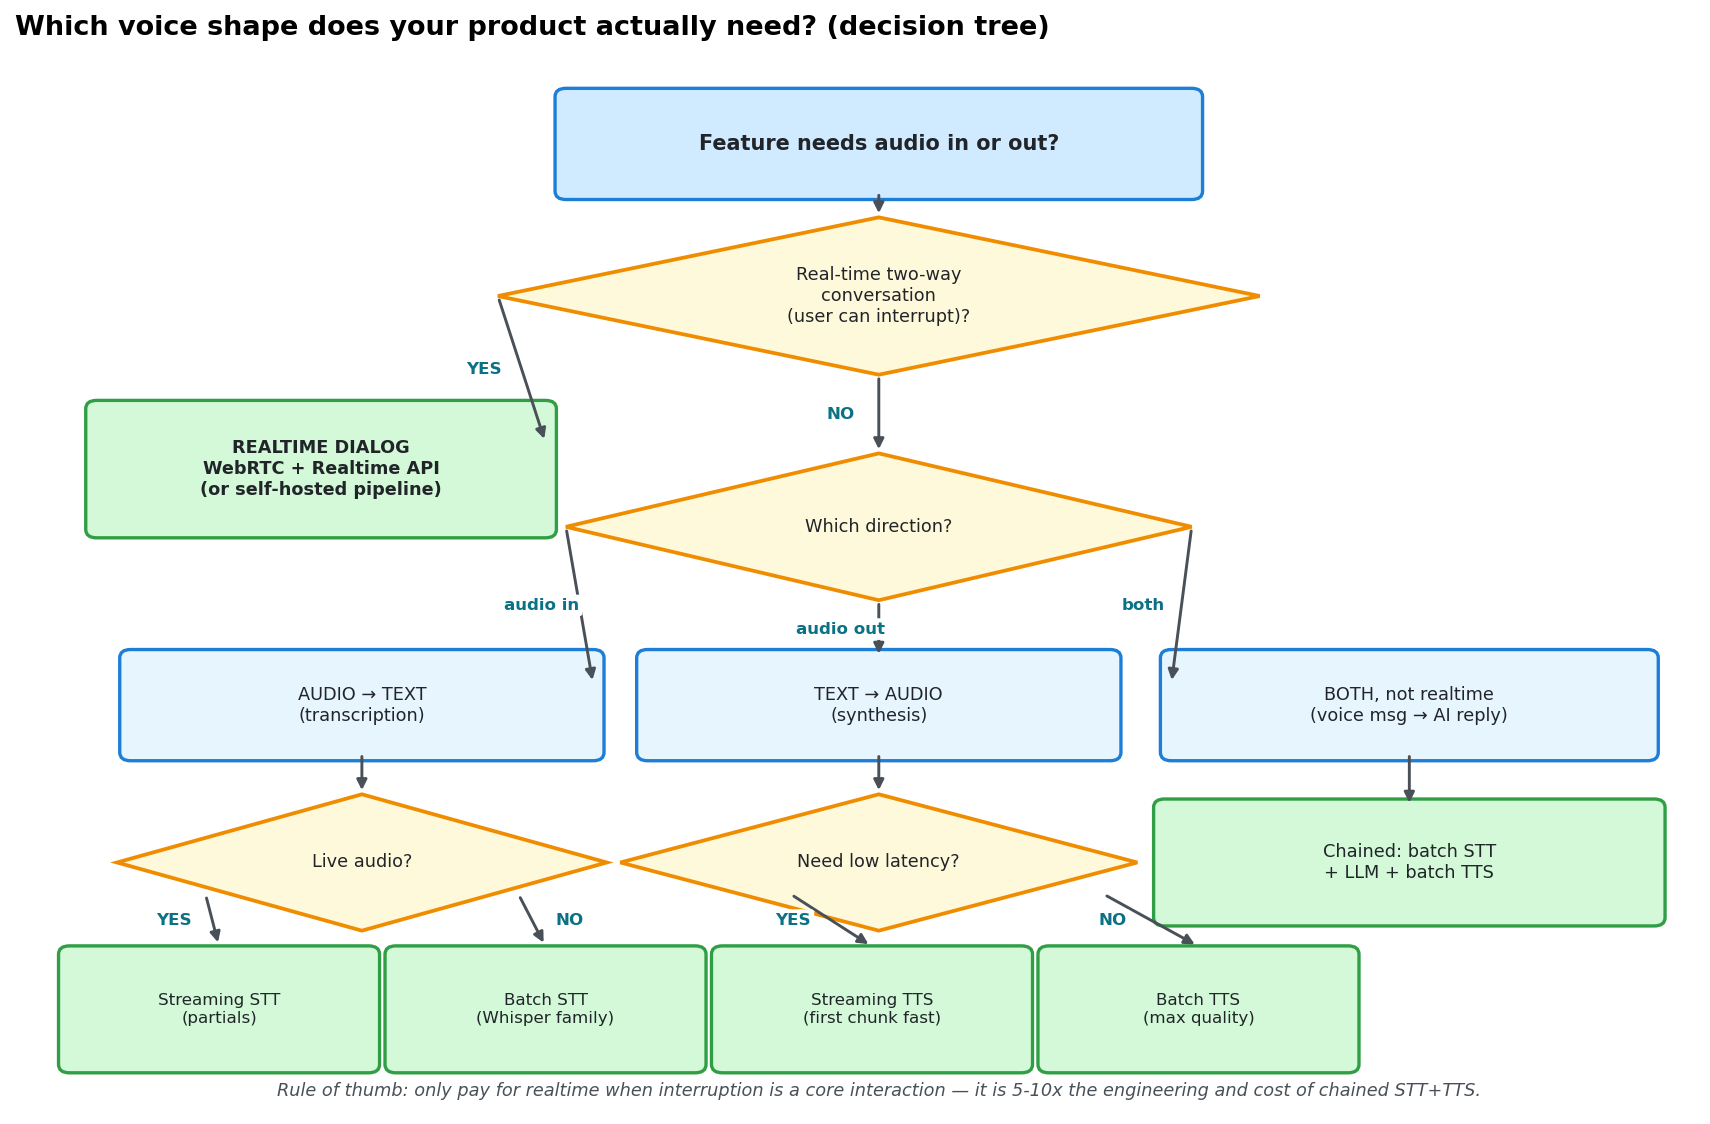 决策树:只有"需要实时双向、用户可打断"才走实时对话;其他一律先用更便宜的形态。经验法则——为打断付费之前,先确认打断真的是核心交互。
二、400ms 生死线:延迟预算的全链路拆解
人对对话延迟的容忍是硬性的:电话里超过 400ms 的停顿,对方就会觉得"卡"、开始"喂?喂?"。语音产品的延迟预算,起点不是"用户点下按钮",而是"用户说完最后一个字",终点是"听到 AI 的第一个字"。量错了尺子,后面全错。
为什么 AI 生成的语音 demo 总是"能用但没法上线"?看它的链路:等用户说完整段 → 调 STT 整段识别(约 1.8s)→ 等 LLM 生成完整回复(约 1.2s)→ TTS 合成完整音频(约 1.5s)→ 播放。加起来约 4.6 秒。demo 时你觉得"还行",是因为你在演示,心里有预期;真实用户在第 2 秒就开始怀疑人生,第 4 秒已经关掉了。
流式是唯一的解法,而且关键洞察是:各阶段在时间上是重叠的,不是串行的。STT 在用户说话时就已经在出 partial(中间结果);VAD 确认话轮结束约 100ms;LLM 首 token 约 150ms;TTS 首个音频块约 100ms;播放缓冲约 30ms;采集开销约 20ms。注意"用户说完→听到回复"这段只包含后半程——STT 的大头工作在用户说话时就做完了,所以端到端可以压到 400ms 左右。
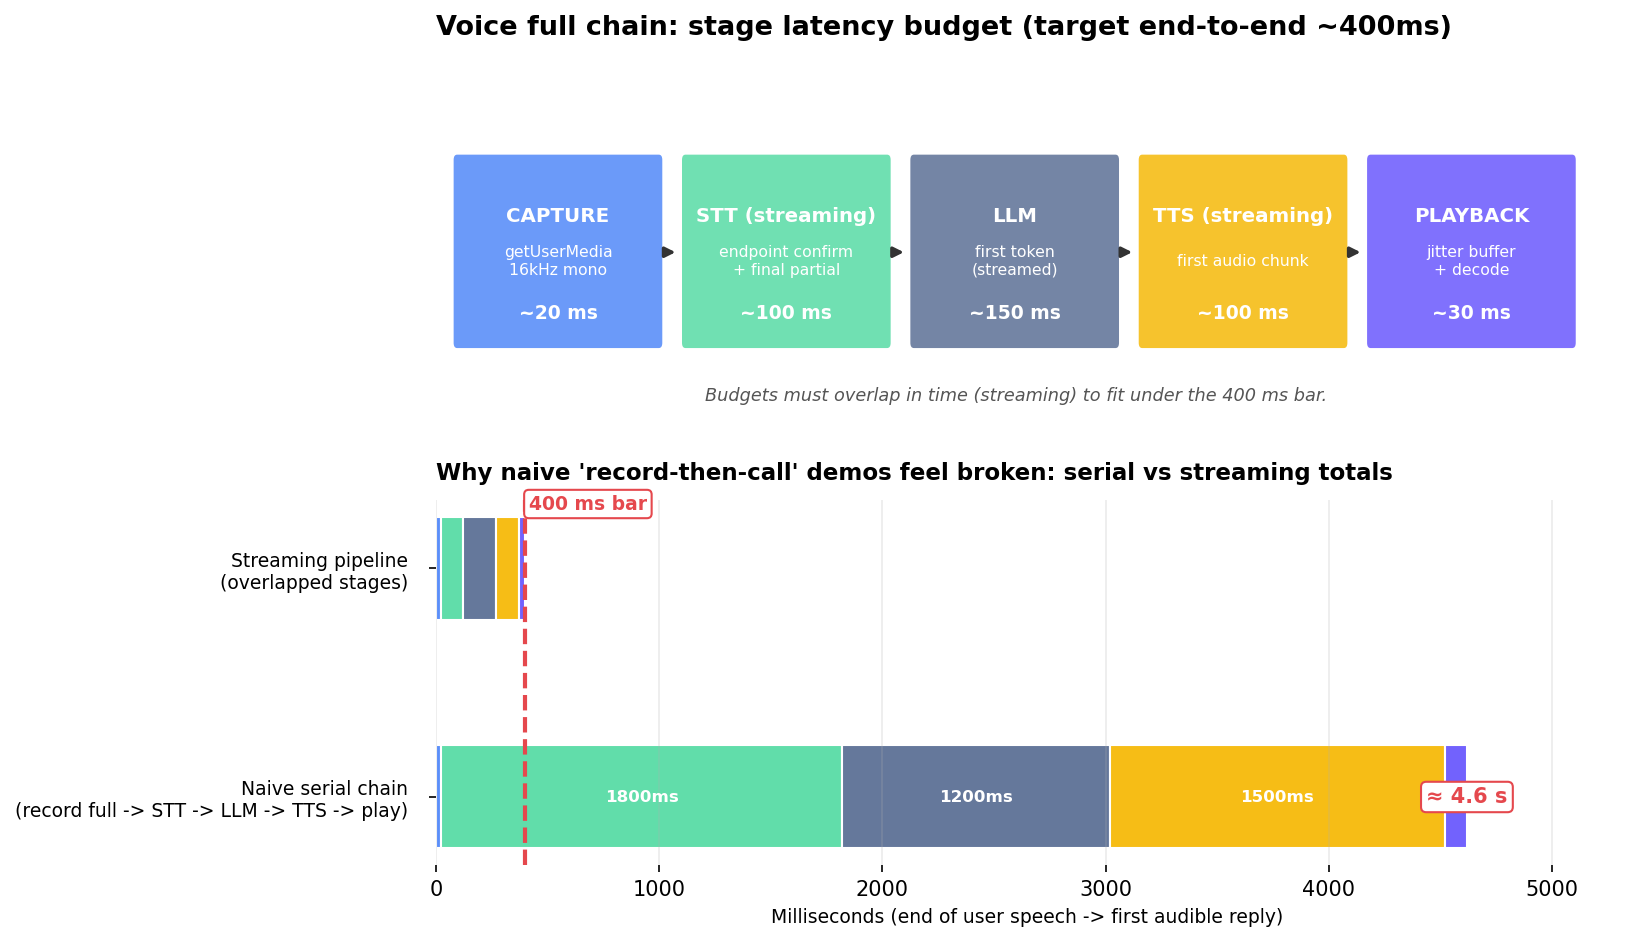 上:各阶段延迟预算(合计约 400ms);下:串行 demo(约 4.6s)vs 流式链路(约 400ms)与 400ms 生死线的对比。十个延迟超标的语音 demo,九个是串行链路的问题,不是模型慢。
两个实战判断:第一,优化延迟时先查链路再调模型——把串行改成流式,一次性能砍掉 80% 的延迟;反过来,链路是串行的,换什么模型都救不回来。第二,首字延迟和完整回复延迟是两个指标,用户感知只认前者。AI 开口越快,用户越觉得"聪明",哪怕后半句慢一点也无所谓。所以所有优化都应该指向"让第一个字早点出来":LLM 用流式输出、TTS 用首包延迟最低的模式、播放端不要等缓冲满。
三、STT 选型:Whisper 系 vs 流式识别
这是选型里最容易"选错但很久才发现"的一组,因为两者在 demo 里听起来差不多。
Whisper 系(离线/批量转写):优点是准——多语言、口音容忍都好;便宜,API 约 $0.006/分钟;还能自部署(faster-whisper 本地跑,隐私敏感场景的救星)。缺点是致命的:非流式,必须等整段音频,实时对话里用它等于给自己加 1–2 秒延迟。适合会议纪要、音视频字幕、语音消息转文字——也就是所有"不赶时间"的场景。
流式 STT(如 Deepgram、AssemblyAI、Azure Speech 一类):边说边出字,延迟低。代价是按分钟计费比 Whisper 贵一个量级,而且 partial 会"变脸"——前面的字可能被后面的音频修正。
四个实战判断:
- partial 的"变脸"是最被低估的坑。前端如果直接把 partial 拼成最终文本,用户会看到字在"抽搐"。正确做法:partial 只做展示(灰色、斜体都行),final 结果到了才落库、才进 LLM。
- 别指望 partial 有标点。Whisper 的标点是后处理加的,实时场景下 partial 基本没有标点。需要断句就自己按静音时长切,别等模型。
- 说话人分离(diarization)通常是另一个计费项。会议纪要场景别默认它免费,选型时把这项单独问清楚。
- 中文场景拿真实录音实测。拿目标用户的真实录音——地铁里、带口音的、有背景音乐的——测一轮,别拿标准普通话的 demo 录音自我感动。口音和噪声下的准确率差距,能差出 20 个百分点。
- 自部署 vs API,看并发和隐私。faster-whisper 在一张消费级 GPU 上能跑多路实时转写,量大了比 API 便宜一个数量级;但并发一高,GPU 调度和显存就是新的运维工作。判断线很清晰:日转写量超过几千分钟、或音频含隐私数据(如医疗、访谈),值得自部署;否则先用 API,把精力留给链路。
四、TTS 选型:音质、延迟、成本的不可能三角
TTS 的三个角:音质(自然度、情感、声音克隆)、延迟(首个音频块出来要多久)、成本(按字符计费,约 $15/百万字符量级)。三者最多取其二,实时对话场景下,排序应该是:延迟 > 成本 > 音质。
为什么延迟排第一?语音对话里,一个 200ms 开口的"够用"声音,体验碾压 2 秒后开口的"完美"声音。延迟是 0 和 1 的问题——超过生死线用户就流失了;音质是 80 分和 95 分的问题——用户听得出来差别,但不会为此关掉产品。所以实时场景下,流式 TTS 是必选项,选型时看"首个音频块延迟"这个指标,不看"整段合成时长"。
三个省钱的实战判断:
- 高频短句预合成+缓存,是 ROI 最高的一招。"好的"、"请稍等"、"我没听清,能再说一遍吗"这类固定话术,第一次合成后缓存,后续零延迟、零成本。一个成熟的语音助手,30% 以上的播放可以走缓存。
- 声音克隆有合规红线。克隆真人声音(尤其是用户自己的)要有明确的授权链路;vibe 项目最容易踩的是"拿网红声音做默认音色"——别碰,法务风险远大于那点新鲜感。
- 中英文混读单独测。很多 TTS 中文很顺,一遇到英文单词就变调;你的用户一定会中英混说,选型测试集里必须有混读用例。
还有一个藏得很深的工程点:流式 TTS 要吃"按句切分"的文本,但 LLM 输出的是 token 流。你必须在中间加一层句子缓冲——攒够一句(遇到句号/问号/换行)就扔给 TTS,不要等整段生成完。这一层没做,前面所有的首包优化都白费。顺带把文本预处理也放在这一层:数字转中文读法("2026"→"二零二六")、英文缩写展开("API"→"A P I"逐字母)、URL 和 emoji 直接过滤——TTS 遇到 emoji 会念出"微笑表情",别问我怎么知道的。
五、Realtime 对话:打断、轮次状态机与"别抢话"
实时对话的灵魂是打断。没有打断的"实时对话",就是延迟低一点的语音消息,不值得 5–10 倍的成本。
核心机制是三件套:
- VAD(语音活动检测):决定"用户什么时候开始/结束说话"。浏览器端可以用简单的能量阈值顶一顶,生产环境建议用模型 VAD(如 Silero 一类)。关键参数是静音判定阈值,建议 500–800ms——太短会把用户思考的停顿当成"说完了"(AI 开始抢话),太长会让对话拖沓。这个参数没有银弹,只能拿真实用户录音调。
- 回声消除:决定"AI 会不会被自己打断"。AI 说话时,麦克风会收到扬声器的声音。除了开浏览器的 echoCancellation,更重要的是用播放状态给 VAD 做门控——AI 播放期间,把 VAD 触发阈值调高或直接忽略。否则 AI 会被自己的声音"打断",进入无限自激:这是最滑稽、也最常见的翻车现场。
- 轮次状态机:turn = USER / AI / IDLE。规则只有两条,一条都不能多:VAD 决定轮次何时结束,状态机决定轮次归谁。打断不是"暂停",而是"取消 AI 的合成与播放 + 把轮次交给用户"。
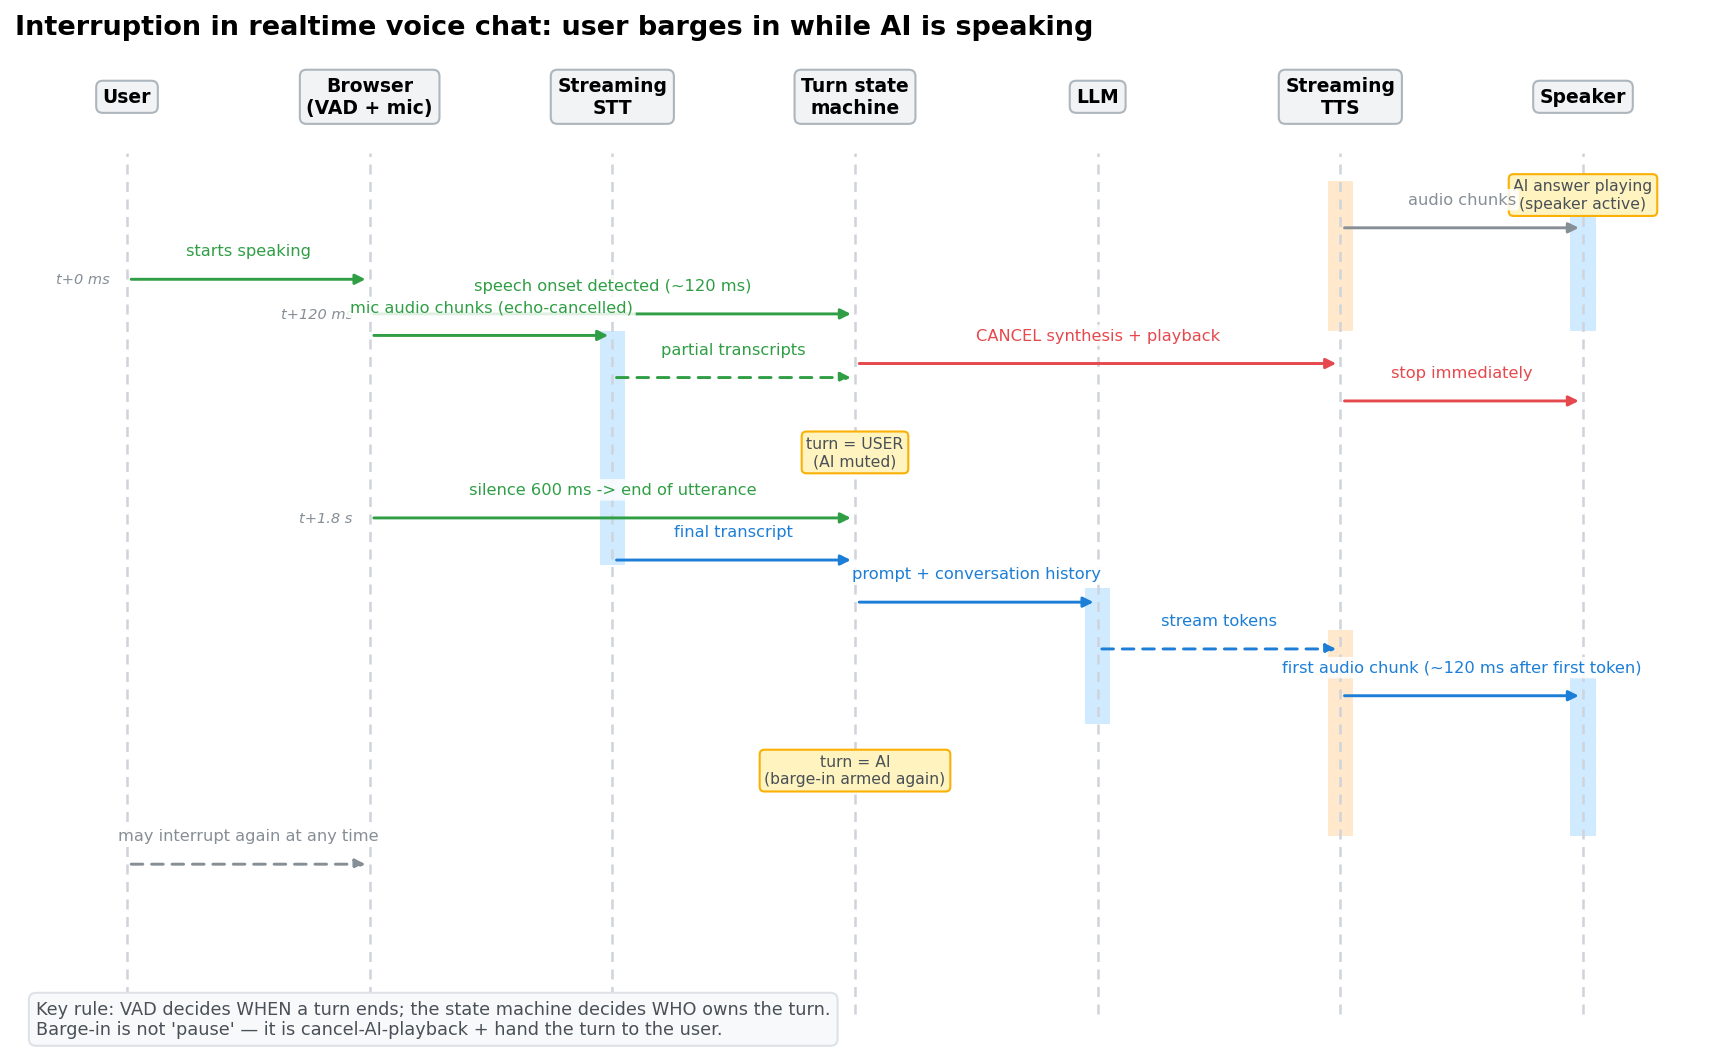 打断时序:VAD 约 120ms 检出用户开口 → 状态机取消 AI 合成与播放、轮次切给用户 → 静音 600ms 确认话轮结束 → LLM 流式生成 → TTS 首个音频块约 120ms 后发出。记住:打断 = 取消 AI 播放 + 交权,不是暂停。
最后是"别抢话"——这是 vibe 项目里 AI 最招人烦的毛病,有两个具体做法:AI 回复完不要立刻进入"等待打断"状态,留 300–500ms 的话轮交接窗口;用户刚说完也别立刻开麦判定,给 VAD 的静音阈值留足时间。人类对话有 200ms 左右的自然交接间隙,对着干就会显得 AI 很"冲"。一个让人舒服的语音助手,秘诀不在模型,在这些"慢半拍"的细节。
还有一个打断后的上下文坑:AI 被打断时没说完的那半句,用户到底听到了多少?TTS 是按块播放的,被打断时最后一块可能只播了一半。如果你把"完整回复文本"原样塞进对话历史,下一轮 AI 会默认用户听完了全文——然后说出自相矛盾的话。正确做法:记录实际播放出去的文本(精确到块),只把"用户实际听到的部分"写进历史。这是实时对话和文本对话最大的不同:文本消息要么发出要么没发出,语音是"发出了一半"。
六、浏览器端五坑
语音功能九成的线上事故不在服务端,在浏览器。这五个坑,AI 生成的代码一个都不会帮你填:
坑一:自动播放策略。Chrome/Safari 禁止未经用户手势的音频播放。语音产品的"开始对话"按钮,真正的职责是"解锁 AudioContext"。AI 先说话的场景(外呼、迎宾语),第一句必须在用户点击之后才能播放。坑中之坑:iOS 上 AudioContext 即使 resume 了也可能被系统再次挂起,要有兜底重试逻辑,别假设一次解锁终身有效。
坑二:麦克风权限。必须 HTTPS(localhost 除外);权限被拒后没有第二次弹窗机会,要引导用户去浏览器设置里手动开,并给一个"检测麦克风"的自检页。vibe 项目常犯的错:页面加载时就弹权限申请,用户一脸懵点拒绝,整个功能永久残废。正确做法:在用户明确点击"开始说话"时再申请——意图明确时,通过率高得多。
坑三:回声。见第五节。补充两条:戴耳机能解决 90% 的回声问题,但你不能要求用户戴耳机;工程上在 getUserMedia 约束里开 echoCancellation、noiseSuppression、autoGainControl,并且 AI 语音播放的前 200ms 麦克风数据直接丢弃(扬声器启动瞬态最容易穿帮)。
坑四:采样率。浏览器给的通常是 48kHz,STT 模型要的是 16kHz 单声道。重采样别用主线程的 ScriptProcessor(已废弃还卡 UI),用 AudioWorklet 在独立线程做。记住:16kHz mono 是 STT 的标准输入,把 48kHz 立体声传上去只是浪费带宽和钱,准确率不会更高。
坑五:移动端后台。iOS Safari 切后台或锁屏,音频采集会被系统掐掉;Android 相对宽容。做"边走边聊"场景要有预期管理:页面可见性变化时给用户明确提示("已暂停,点击继续"),而不是 silently 断连,让用户对着空气说三分钟。
七、成本账:按分钟还是按字符,以及防刷
先认清三种计费模式:STT 按音频分钟(Whisper 约 $0.006/分钟,流式贵一个量级)、TTS 按字符(约 $15/百万字符量级,中文按字算更要当心)、Realtime API 按分钟+按 token 双重计费,最贵。建模公式就一行:月成本 = 日活 × 人均语音分钟 × 单价 × 30。
算一笔让你清醒的账:1000 日活、人均每天 3 分钟、用流式 STT(约 $0.02/分钟量级)+ TTS,一个月就是 1000 × 3 × 0.02 × 30 = $1800,这还没算 LLM 的 token 钱。这就是为什么"先对号入座"排在第一——选错形态,成本差一个数量级;同样 1000 日活,语音消息形态可能只要十分之一。
语音接口是烧钱重灾区,防刷要做在前面:
- 所有语音接口走服务端鉴权,前端只拿短期 token。浏览器里裸奔的 API key,等于把钱包放在大街上——有人扫到就能拿你的 key 批量转写。
- 按用户限流:每人每天语音分钟数上限,新用户更严。正常用户一天说不了 30 分钟,超了的先拦再看。
- 异常告警:单用户/单 IP 用量突增(比如 10 分钟用了 2 小时)直接熔断+告警,别等月底账单。
- 单次录音时长上限:60–120 秒封顶,防止有人拿你的接口当免费网盘/转写服务。
- TTS 文本长度上限 + 敏感词过滤:别让人用你的音色批量生成内容,烧的是你的钱,担的是你的责。
- 灰度 + 日预算熔断:新语音功能先给 5% 用户,设一个日预算上限,超了自动降级为文本模式并告警。语音的成本曲线是线性的、没有缓存救你(除了预合成那 30%),上线第一周就跑满量,等于裸奔。
八、验收清单:10 项,真实网络下跑
语音功能不要在办公室 Wi-Fi 下验收。拿着手机,按这 10 项跑一遍:
- 地铁里打一通:背景噪声下 VAD 不误触发、不吞字。
- 电梯里打一通:弱网/断网重连后,轮次状态机不卡死,能自己恢复。
- 连续打断 5 次:每次 AI 都在 300ms 内闭嘴,没有"余音"拖尾。
- 中英混说一轮:STT 不乱切语言,TTS 不变调。
- 3 分钟长独白:partial 不抽搐,final 完整落库,标点基本可用。
- iOS Safari 全流程:权限申请、播放解锁、切后台再回来。
- 权限拒绝路径:给得出看得懂的引导,而不是白屏或无限 loading。
- 成本冒烟:10 个测试用户跑一天,对一下账单和你的成本模型差多少,差 2 倍以上说明模型错了。
- 20 人同时说话:服务端不断流、不串话,多租户的音频流严格隔离。
- 回归用例:录一段"AI 被自己的声音打断"的音频,以后每次改 VAD 参数都跑一遍——回声自激是最容易复发的 bug。
最后总结一句:语音功能是"链路工程",不是"模型工程"。模型决定下限(听得准不准、说得好不好听),链路决定上限(像不像在跟人说话)。vibe coder 的优势是搭得快,劣势是链路意识弱——这篇指南的 8 节,本质上就是在补这一课:先对号入座,再算延迟预算,然后才是选型、打断、浏览器坑、成本账。按这个顺序走,第一次就能接对。
评论 (0)
相关文章
AI 写"实时"最爱 setInterval 轮询:账单爆炸、延迟、过期数据三宗罪。这篇指南给 vibe 项目的实时实战:轮询 / SSE / WebSocket / WebRTC 四选一决策表、频道鉴权、断线重连与断点续传、Presence、多实例 pub/sub 扩展,以及连接数成本模型和 8 项上线验收。附 Supabase / PartyKit / 自建 WebSocket 接入代码。
AI 帮你 deploy 到 xxx.vercel.app 只是借住。这篇实战指南带你走完买域名、DNS 解析、Cloudflare 上线链路、HTTPS 落地、邮箱三件套全链路——域名是你唯一真正拥有的资产。
AI 写代码快,但默认不写安全代码:本地跑通不等于线上安全。这篇实战指南带你补上 vibe 项目的 Web 安全基线——CSP 安全头、CSRF Token、XSS 防护、SQL 参数化、Cookie 三件套、依赖供应链门禁,外加一份可直接复制的上线前 10 项验收清单。