别再 setInterval 轮询了:vibe 项目的实时功能实战
AI 写"实时"最爱 setInterval 轮询:账单爆炸、延迟、过期数据三宗罪。这篇指南给 vibe 项目的实时实战:轮询 / SSE / WebSocket / WebRTC 四选一决策表、频道鉴权、断线重连与断点续传、Presence、多实例 pub/sub 扩展,以及连接数成本模型和 8 项上线验收。附 Supabase / PartyKit / 自建 WebSocket 接入代码。
你的 AI 编程助手刚给你写完一个"实时通知"功能。你点开看了:能跑,消息三秒后出现在页面上。你很满意,部署上线。一周后账单来了,数据库连接池在高峰期被打满,用户群里有人在问"为什么我看到的数字是三分钟前的"。这不是你运气不好——这是 AI 写实时代码的标准结局。
这篇指南讲 vibe 项目的实时功能怎么做才不翻车:为什么 AI 总给你写 setInterval 轮询,轮询 / SSE / WebSocket / WebRTC 到底怎么选,频道鉴权、断线重连、Presence、多实例扩展怎么做,以及上线前那份 checklist。目标只有一个:你的实时功能在地铁里断网重连之后,还能自己把丢的消息补回来。
多说一句这篇指南的立场:不教你"WebSocket 协议怎么写"——那是文档的事。这篇讲的是 AI 不会告诉你的判断:什么时候轮询其实够用,什么时候必须上 WebSocket;鉴权卡在哪一层;重连的坑在哪;多实例那天怎么不重构。每一节都有"一人团队的判断",拿走即用。读完这篇,你会知道 AI 交出来的实时代码该怎么审、怎么改、怎么上线。
一、AI 为什么写不好实时代码:轮询三宗罪
先说一个观察:你让 AI 写"实时"功能,它十有八九给你 setInterval(() => fetch('/api/updates'), 3000)。不是它偷懒——训练语料里轮询的示例最多、无状态、一次就能跑通,这是大模型的"最小惊讶路径"。但"看起来能跑"是 vibe coding 里最贵的幻觉,轮询有三宗罪,每一宗都在生产环境里收税。
第一宗罪:账单。轮询把"实时"翻译成了"请求数 = 用户数 × 在线时长 / 间隔"。算一笔账:1 万日活,每人每天在线 10 分钟,每 3 秒轮询一次——每人每天 200 次请求,一天就是 200 万次。每次请求都要建连接、跑鉴权、查数据库,你的连接池和按量计费的后端服务会先替你感受到"实时"。更狠的是,90% 的轮询返回的是"无更新",你花钱买的全是空转。
第二宗罪:延迟。轮询的数据天然过期一个轮询间隔。你把间隔从 5 秒缩到 1 秒,延迟是下来了,账单直接翻 5 倍。这是轮询的不可能三角:延迟、成本、实时性三者最多取其一。协作编辑、游戏对战这种场景,1 秒的延迟就是"对方已经走了你才看到",产品直接不可用。
第三宗罪:过期数据。轮询给你的永远是"上一次请求时刻"的世界。两个人同时改同一条数据、聊天里的"对方正在输入"、直播的在线人数——轮询看到的都是过去式。用户不会跟你说"你的架构有问题",他只会觉得"这产品好卡、好假"。
一句话判断:轮询不是"简单方案",它是"把复杂度转移到账单和用户体验上"的方案。它只配出现在两个地方:原型验证阶段,以及正式方案的降级兜底。除此之外,看到 AI 给你写 setInterval 做实时,先问一句"有没有更好的"。
给你一个真实量级的体感:某 vibe 做的直播答题,5000 人同时在线,每 2 秒轮询一次排行榜——每秒 2500 次请求,每次请求跑一次聚合查询。上线 20 分钟,连接池告警先响,接着是账单告警。改成 WebSocket 推送后,同样 5000 人,服务端只在有新答题时广播一次,每秒不到 10 次写操作。同样的"实时",成本差了两个数量级。这就是为什么选型必须在写代码之前,而不是账单之后。
还有一个隐性成本:轮询让你的"实时"永远带着"上一拍"的延迟。在 AI 对话场景里,用户发完问题,轮询要等下一个 3 秒 tick 才开始拉流式输出——体感上就是"点了发送,卡了 3 秒才有反应"。这种延迟不是网络问题,是架构问题,加钱也买不回来。
最后,送你一份"AI 实时代码审查清单"——拿到 AI 生成的实时代码,先查这 5 处,每处都是一个翻车现场:
- 有没有鉴权?搜一下握手代码里有没有验 token,没有就是裸奔。
- 断线了怎么办?搜 onclose / reconnect,没有就是"偶尔在线"。
- 消息有 id 吗?没有单调递增 id,断点续传和去重都无从谈起。
- 心跳在哪?没有 ping/pong,三个月后你就是僵尸连接农场主。
- 压测过吗?问 AI"2000 并发下内存多少",它答不上来——因为它没跑过。
5 处全绿,代码才能用;有一处红,返工重写。把这份清单贴进你的 code review 模板,让 AI 自己先对着查一遍,再交给你看。
二、四选一决策表:轮询 / SSE / WebSocket / WebRTC
实时方案说到底就四个,选错的代价是重写。先给结论:90% 的 vibe 项目,答案在 SSE 和 WebSocket 之间二选一;轮询只配做降级;WebRTC 别碰,除非你在做音视频。
| 方案 | 典型延迟 | 方向 | 成本 | 复杂度 | 生死线(一句话) |
|---|---|---|---|---|---|
| 轮询 Polling | 秒级(=轮询间隔) | 客户端拉 | 中(请求空转烧钱) | 最低 | 数据晚 5 秒没人死,且读多写少、并发几百以内 |
| SSE | 100–500ms | 服务端→客户端单向 | 低(HTTP 长连接) | 低 | 只需要服务端往客户端推,不需要客户端上行 |
| WebSocket | 50–200ms | 全双工 | 中(连接常驻内存) | 中 | 双向低延迟交互:协作、聊天、游戏、AI 对话 |
| WebRTC | <100ms(P2P) | 点对点 | 高(信令+TURN+调试) | 最高 | 音视频通话、点对点大文件,且房间规模小 |
轮询的出局条件(满足一条就别用):写入频繁(每次轮询都可能查到新数据)、并发上千(乘数效应先打穿你的数据库)、延迟敏感(超过 1 秒不可接受)。三条占一条,轮询就是慢性自杀。
SSE 是 2026 年最被低估的选项。AI 流式输出——大模型一个 token 一个 token 往外吐——标准答案就是 SSE(EventSource):简单、浏览器原生支持断线重连(Last-Event-ID)、走 HTTP/2 多路复用。但有两个坑:Nginx / CDN 默认会缓冲响应体,记得关 proxy_buffering 并设置 X-Accel-Buffering: no;它是单向的,客户端上行还是要走普通 HTTP 请求。
SSE 的 Nginx 配置三行,缺一行就抽风:
proxy_buffering off;
proxy_cache off;
# X-Accel-Buffering: no;  # 响应头,由应用返回
症状对照:本地好好的、一上生产 SSE 变"攒一波再吐"——99% 是某一层代理在缓冲。Cloudflare 用户注意:它的 CDN 对 SSE 友好,但别指望它替你做鉴权。
WebSocket 是双向低延迟的唯一通用答案,代价是连接常驻内存、需要自己管心跳、多实例要引入 pub/sub(第六节细讲)。一条纪律:别在 WebSocket 上跑 HTTP 能做的事——文件上传、大查询走 HTTP,WebSocket 只跑真正的实时消息。见过太多人把 WS 当万能管道,最后连接里 90% 是本可以用 REST 的流量。
WebRTC 别碰。除非你的产品就是音视频通话。P2P 听起来很美,但信令服务器、NAT 打洞、TURN 中继一个都少不了;房间超过 4 个人,P2P 的 mesh 连接数是 O(n²),该上 SFU 了——那已经是另一个专业。vibe 项目 99% 不需要 WebRTC,需要的那 1% 也不该自己写,去用现成的音视频 PaaS。
怎么把这张决策表喂给 AI?别问它"你觉得用哪个好",直接给约束:"5000 日活,客服聊天双向实时,延迟要求 500ms 内,团队 1 人,无运维——按决策表选型并给出接入代码"。约束越具体,AI 越不容易给你套轮询模板。记住:选型是你的判断,不是 AI 的。
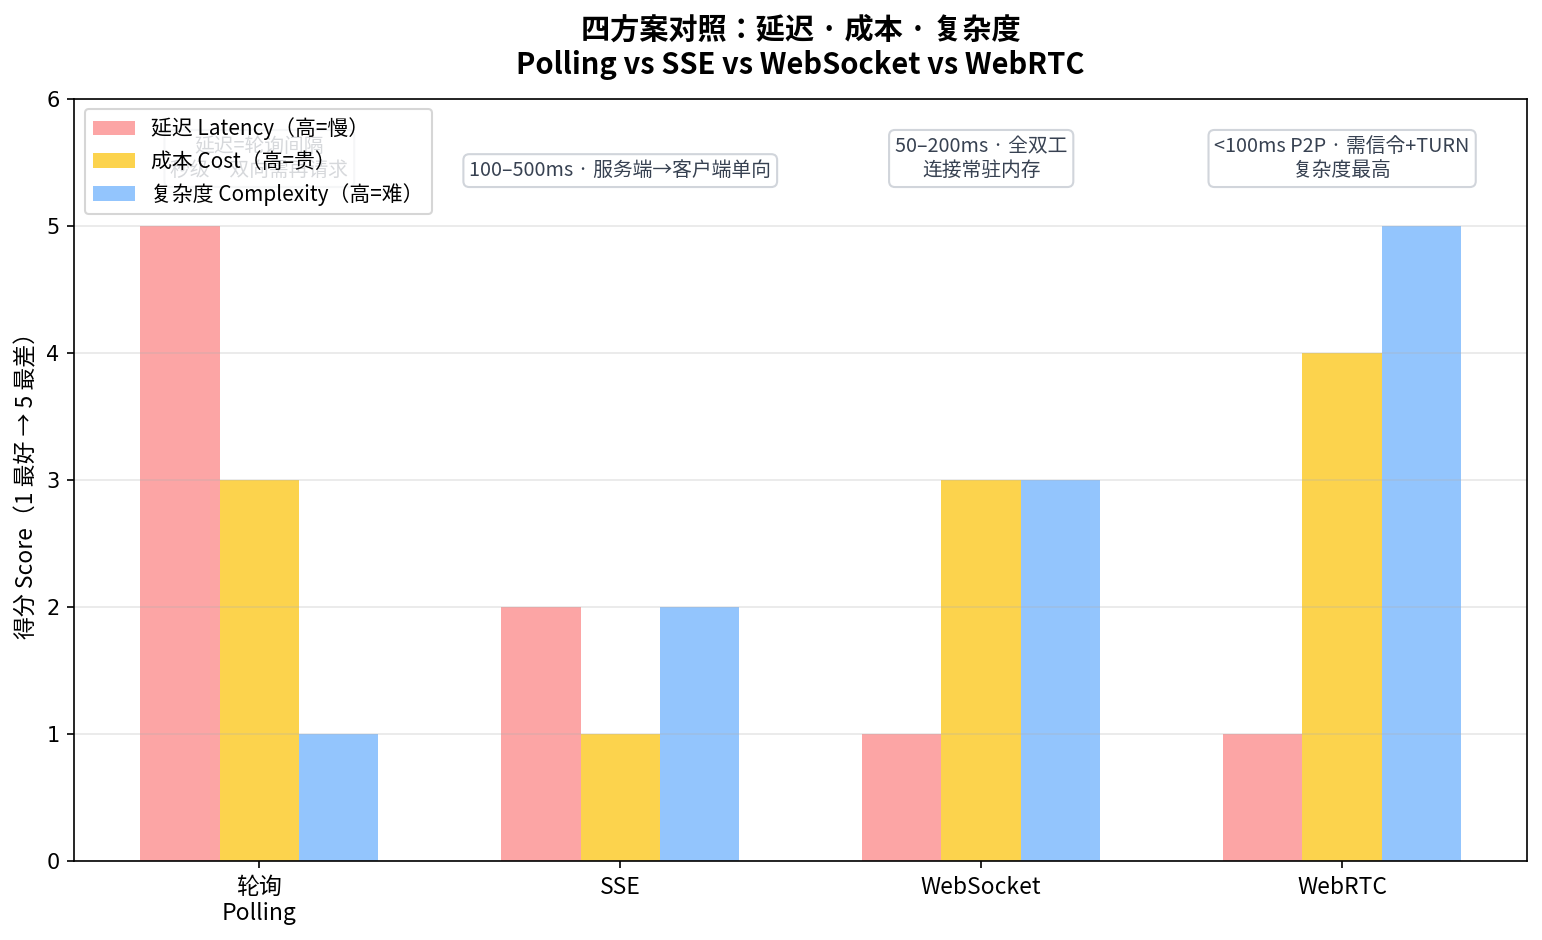 图:四方案对照。延迟 / 成本 / 复杂度得分 1 最好、5 最差。轮询的延迟得分拉满是因为延迟恒等于轮询间隔;WebRTC 的复杂度拉满是因为信令、NAT 打洞、TURN 中继一个都少不了。选型时先看生死线:只需要服务端推送选 SSE,双向低延迟选 WebSocket。
三、频道鉴权:别让陌生人订阅别人的房间
实时系统的安全边界不在"能不能连上",而在"能订阅哪个频道"。连接是便宜的,频道是值钱的。AI 生成的代码最常见的反模式:客户端传 userId 和 roomId,服务端点点头就让订阅了——频道名还是自增的 room-1、room-2,枚举一下就能偷听所有房间。
正确的链路是三段式:服务端签发 → 握手校验 → 订阅二次校验。
- 服务端签发短期签名 token。用 HMAC 把
userId.频道名.过期时间签起来,secret 只留在服务端。token 有效期 5–10 分钟,够完成握手就行,长连接不需要长 token。 - 握手阶段验签。WebSocket 握手时从 query 参数或
Sec-WebSocket-Protocol取 token,验签失败直接close(4401),连订阅的机会都不给。 - 订阅时二次校验频道权限。token 里声明的频道必须和实际订阅的频道一致;用户只能订阅自己有权限的房间(查一次 membership 表)。频道名用不可枚举的
room_<uuid>,别用自增 id。
Supabase Realtime 接入要点:它的频道授权走两条路——postgres_changes 靠 RLS policy(没配 RLS 等于裸奔,记得给表开 enable row level security),broadcast / presence 用私有频道 + 服务端签发逻辑。实战里最常见的错:表开了 RLS 但 policy 没覆盖 realtime 用的角色,开发环境一切正常(因为用的是 service_role),上线用 anon key 全是空数据——先查 policy,再怀疑人生。
Supabase RLS policy 示例(postgres_changes 想收到行,必须配):
alter table messages enable row level security;
create policy "room members can read"
  on messages for select
  using (
    room_id in (select room_id from memberships where user_id = auth.uid())
  );
记住:policy 是配给 realtime 用的角色(authenticated / anon)的,别只拿 service_role 测通就上线。
PartyKit 接入要点:一个 Party 就是一个房间。onConnect 里验 token(HMAC 逻辑同上,secret 放 party.env),验不过直接 connection.close()。房间内广播用 party.broadcast(),点对点用 connection.send()。它的鉴权完全交给你自己写,别指望框架兜底。
自建 WebSocket 接入要点:看第四节代码里的 verifyToken——握手验签加 timingSafeEqual 防时序攻击,一共 10 行,但 AI 永远不会主动给你写。顺手把 token 刷新做成"每次重连重新签发",别让客户端拿着一个 24 小时有效的 token 到处晃。
服务端签发 token(Node 示例,10 行):
function signChannelToken(userId, channel) {
  const exp = Math.floor(Date.now() / 1000) + 600 // 10 分钟有效
  const sig = crypto.createHmac('sha256', process.env.CHANNEL_SECRET)
    .update(`${userId}.${channel}.${exp}`).digest('hex')
  return `${userId}.${exp}.${sig}`
}
// 登录成功后,按用户可进的房间逐个签发,前端建连时取用频道设计本身也是一门学问:频道粒度越细,鉴权越简单。按"房间"开频道(room_<uuid>),别按"功能"开全局频道(global_notifications)——全局频道意味着每条消息都要过一遍"这个订阅者能不能看"的过滤,复杂度从 O(1) 变成 O(n)。需要跨房间的系统通知?那是另一套单向推送,走 SSE 或推送服务,别塞进房间频道里。
四、断线重连与状态恢复:心跳、退避、断点续传
先立一个标准:没有重连策略的"实时",只是"偶尔在线"。地铁、电梯、WiFi 切换——断网是常态不是异常。用户能接受"断了一下",不能接受"断了一下之后消息丢了"。重连三件套,缺一不可:
1. 心跳。客户端每 25–30 秒发 ping,服务端回 pong;服务端连续两次没收到 pong 就判定死亡、剔除连接。没有心跳的连接池,三个月后就是一池僵尸连接——还占着内存,还占着你的连接数账单。WebSocket 协议自带 ping/pong 帧,别自己发明心跳消息格式。
心跳间隔为什么是 25–30 秒而不是 60 秒?因为 NAT 网关和云 LB 的空闲超时大多在 60 秒左右,移动网络下更短。30 秒 ping 一次,留足余量。App 进后台时记得主动降级:后台的 WebSocket 连接很快会被系统杀掉,别让它在后台空转耗电——进后台记 last_msg_id 并断开,回前台重连补发,这才是移动端的正确姿势。
2. 指数退避 + 抖动。重连间隔 1s → 2s → 4s → 8s……上限 30 秒,每次乘一个 0.5–1 的随机抖动。为什么加抖动?服务端重启那一刻,几千个客户端如果同时重连,就是一次自导自演的 DDoS(惊群效应)。AI 写的重连清一色是"固定 3 秒重试",上线第一天没事,第一次服务端发版就原地爆炸。
3. 断点续传。每条消息带单调递增 id,客户端持久化 last_msg_id(localStorage 就够);重连时带上 since=last_msg_id,服务端返回这之后的消息。服务端要配合:保留一个窗口——Redis Stream 保留最近 500 条,或数据库按时间查。窗口之外的数据,重连时走一次全量拉取兜底。
// 客户端重连器:指数退避 + 抖动 + 断点续传
function connectRealtime({ channel, getToken, onMessage }) {
  let ws, retry = 0, lastId = localStorage.getItem('last_msg_id') || 0
  const MAX_DELAY = 30000
  async function dial() {
    const token = await getToken(channel) // 短期签名,每次重连刷新
    ws = new WebSocket(
      `wss://api.example.com/ws?channel=${channel}&token=${token}&since=${lastId}`
    )
    ws.onopen = () => { retry = 0 }
    ws.onmessage = (e) => {
      const msg = JSON.parse(e.data)
      if (msg.id > lastId) {
        lastId = msg.id
        localStorage.setItem('last_msg_id', lastId)
      }
      onMessage(msg)
    }
    ws.onclose = () => {
      const delay = Math.min(1000 * 2 ** retry++, MAX_DELAY) * (0.5 + Math.random() / 2)
      setTimeout(dial, delay)
    }
  }
  dial()
}
服务端 since 查询(Redis Stream 版,配合第六节代码里的 xadd 落盘):
// 重连时:补发断点之后的消息
const missed = await redis.xrange(`stream:${channel}`, `(${lastId}`, '+')
for (const [, fields] of missed) ws.send(fields.msg)
Supabase 用户注意:它的 SDK 自带重连,但 postgres_changes 在断线期间发生的变更不会补发——重连成功不代表数据追上了。关键业务(订单状态、支付结果)必须自己维护游标:重连后按 updated_at > 断线时间 全量拉一次做对账。把 realtime 当"通知你去拉",而不是"数据本身",能避开 80% 的坑。
补发带来一个新问题:重复。断线瞬间服务端可能已经推送、客户端没收到,重连补发后客户端会收到两条。解法是客户端按 msg.id 去重(Set 缓存最近 1000 个 id),服务端保证 id 单调递增。顺序加去重,两件事做完,"exactly-once 的体感"才算完整——注意是体感,分布式 exactly-once 不存在,别钻牛角尖。
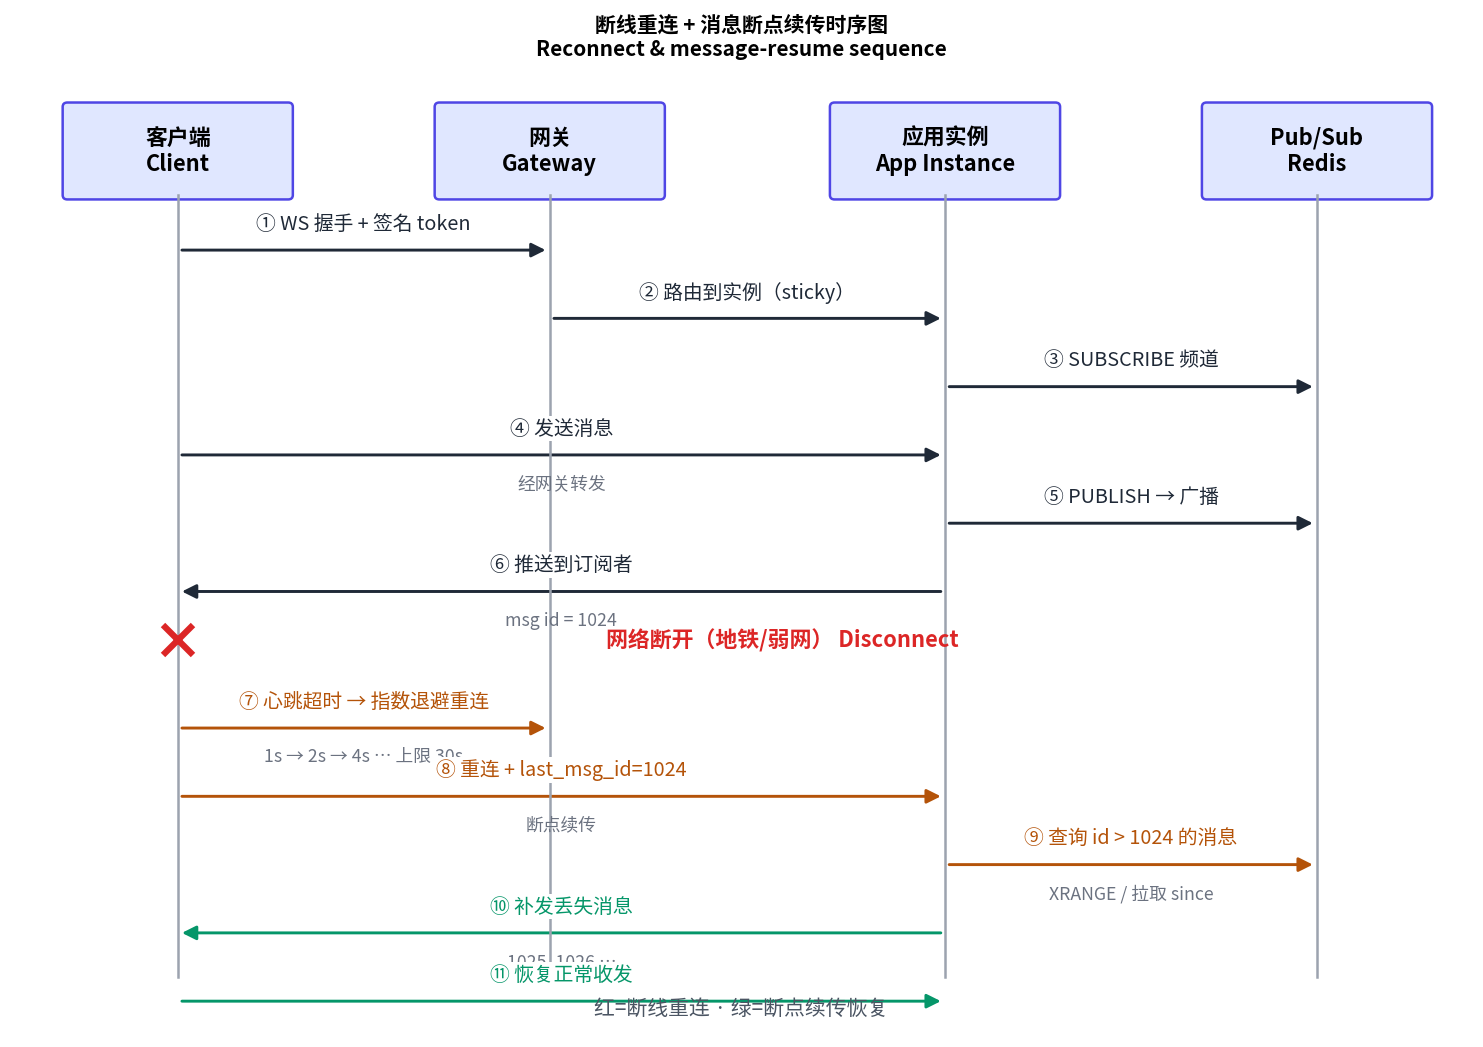 图:断线重连 + 消息断点续传时序。①–⑥ 正常建连与收发;⑦ 心跳超时后指数退避重连(1s→2s→4s…上限 30s,加抖动防惊群);⑧ 重连携带 last_msg_id;⑨ 服务端从 Redis Stream 补查断点后的消息;⑩ 补发;⑪ 恢复正常。记住:重连成功不等于数据追上,补发才是关键。
五、Presence 实战:谁在线、正在输入、光标协同
Presence(在线状态)是实时功能里"看起来简单、做起来全是坑"的代表:谁在线、对方正在输入、协作文档里那几个彩色光标——本质都是"带超时的状态广播"。实现上有三件套:
- 心跳续租。客户端每 10 秒上报一次"我还在",服务端给这条状态 30 秒 TTL。TTL 过期即下线,不需要"优雅断开"——移动端杀进程从来不跟你打招呼。
- 只广播 diff。状态没变就别广播。在线列表 100 人,每人每 10 秒广播一次全量,就是 10 QPS 的垃圾流量。Presence 消息只发变化的部分。
- 节流铁律。"正在输入" throttle 2 秒(用户停 2 秒才算输完),光标位置 100ms 节流。反模式:每个 keystroke 发一条 presence——你的频道会变成打字机噪声,账单和延迟一起爆炸。
"正在输入"还有个 UX 细节:收到 typing 状态后,如果 5 秒内没收到新消息,自动把状态清掉——否则对方打了一半字去接电话,你这边"正在输入…"能挂一整天。Presence 的每一条状态都要有"过期"的语义,这是它和普通消息最大的区别。
Supabase Presence 接入要点(四行核心):
const channel = supabase.channel('room:' + roomId, {
  config: { presence: { key: userId } }
})
channel
  .on('presence', { event: 'sync' }, () => {
    const online = channel.presenceState() // { userId: [{status, cursor}] }
    renderAvatars(online)
  })
  .subscribe(async (s) => {
    if (s === 'SUBSCRIBED') await channel.track({ status: 'online' })
  })
// 正在输入:throttle 2 秒后 channel.track({ status: 'typing' })
自建 Presence 要点(Redis 版,20 行搞定):
// 上报:presence:{room} 是 hash,field=userId,TTL 30 秒
await redis.hset(`presence:${room}`, userId,
  JSON.stringify({ status: 'typing', cursor: { x, y } }))
await redis.expire(`presence:${room}`, 30)
// 读取:hgetall 即全房在线列表;TTL 到期自动下线,无需清理任务
// 变更广播:上报后 publish(`presence:${room}`, userId) 通知各实例推 diff
一个判断:Presence 数据永远不要落库。它是瞬时状态,落库就是给自己找一致性麻烦——"数据库说他在线,但他手机已经没电了"这种灵异事件,根源都是把瞬时状态当成了持久事实。Redis TTL 是 presence 的天然归宿。
光标协同再往前一步就是协同编辑(OT / CRDT),那是另一个深度的题目,一句话划界:Presence 只同步"光标在哪",不同步"文档内容"——内容同步用 Yjs / Automerge 这类 CRDT 库,别自己发明合并算法。房间人数也有上限判断:presence 广播是 O(n²) 的(n 个人每人广播给 n-1 人),50 人以下随便玩;500 人的直播间,"谁在线"就别做全量 presence,改成"在线人数 + 抽样头像"。
六、从单机到多实例:pub/sub 横向扩展与粘性会话取舍
单机阶段,实时系统简单得不像话:一个 Map<频道, Set<连接>>,收到消息遍历推送,几千并发毫无压力。分水岭是第二个实例上线那一刻:用户 A 连在实例 1,用户 B 连在实例 2,A 发的消息 B 永远收不到——因为广播只发生在实例 1 的内存里。
解法是引入 pub/sub(架构见下图):实例只管"本机连接",跨实例的消息走 Redis(或 NATS)广播总线。发布流程变成四步:客户端发布 → 本实例写入 pub/sub → 所有实例收到 → 各实例推送给自己的本机订阅者。实例本身变成无状态的,挂掉一个只影响它上面的连接(客户端重连到别的实例即可)。
import { WebSocketServer } from 'ws'
import Redis from 'ioredis'
import crypto from 'node:crypto'

const SECRET = process.env.CHANNEL_SECRET
const pub = new Redis(process.env.REDIS_URL)
const sub = new Redis(process.env.REDIS_URL)
const wss = new WebSocketServer({ port: 8080 })
const rooms = new Map() // 频道 -> 本机连接集合(只存本机!)

// 握手鉴权:token = HMAC(userId.频道.过期时间)
function verifyToken(token, channel) {
  const [userId, exp, sig] = token.split('.')
  if (Date.now() > Number(exp) * 1000) return null
  const expect = crypto.createHmac('sha256', SECRET)
    .update(`${userId}.${channel}.${exp}`).digest('hex')
  if (!crypto.timingSafeEqual(Buffer.from(sig), Buffer.from(expect))) return null
  return userId
}

wss.on('connection', (ws, req) => {
  const q = new URL(req.url, 'http://x').searchParams
  const channel = q.get('channel')
  const userId = verifyToken(q.get('token'), channel)
  if (!userId) return ws.close(4401, 'unauthorized')
  ws.channel = channel
  if (!rooms.has(channel)) { rooms.set(channel, new Set()); sub.subscribe(channel) }
  rooms.get(channel).add(ws)
  ws.isAlive = true
  ws.on('pong', () => { ws.isAlive = true })
  ws.on('message', (raw) => {
    const msg = JSON.stringify({ id: Date.now(), from: userId, body: String(raw) })
    pub.publish(channel, msg)                                             // 跨实例广播
    pub.xadd(`stream:${channel}`, 'MAXLEN', '~', 500, '*', 'msg', msg)    // 断点续传
  })
  ws.on('close', () => rooms.get(channel)?.delete(ws))
})

// 心跳:30 秒扫一轮,剔除僵尸连接
setInterval(() => {
  wss.clients.forEach((ws) => {
    if (!ws.isAlive) return ws.terminate()
    ws.isAlive = false; ws.ping()
  })
}, 30000)

// pub/sub 到达 → 只推本机订阅者
sub.on('message', (channel, msg) => {
  rooms.get(channel)?.forEach((ws) => {
    if (ws.readyState === 1) ws.send(msg)
  })
})
粘性会话(sticky session)的取舍:让负载均衡把同一客户端始终路由到同一实例,重连恢复更简单(last_msg_id 的内存游标还在)。代价是扩缩容时连接迁移疼、实例挂了它上面的连接全断。一人团队的判断:选无状态实例 + Redis,别碰 sticky——除非你有专职运维。无状态加外部 pub/sub 是云原生时代的默认答案,sticky 是上个时代的遗产。
托管服务的价值就在这里:Supabase Realtime、PartyKit、Pusher 把"多实例广播、全球边缘、连接管理"打包卖给你,你付的是连接数和消息数的钱,省的是半个运维。日活 1 万以下,直接用托管;连接数上来之后,再按第七节的模型算自建账。
Redis 还是 NATS?一人团队无脑选 Redis:你已经有它了(缓存、session、presence 全在上面),pub/sub 只是顺手。NATS 的 JetStream 在"消息必须持久化、可回放"时更强,但那是日活十万量级才需要操心的事。另外注意:发布端也要鉴权——pub.publish 之前校验发送者确实在这个频道里,否则任何人连上 WebSocket 就能往任意频道灌垃圾消息,pub/sub 成了放大器。
还有一个新手常问的:pub/sub 本身会不会成为单点?会。Redis 挂了,所有跨实例广播都停。所以 Redis 要做高可用(主从加哨兵,或直接用云托管版),它的 SLA 就是你的实时 SLA。别在 Redis 上省钱——它挂的时候,你的"实时"会退化成"所有人只能看到自己实例里的消息",这种半残状态比全挂更难排查。
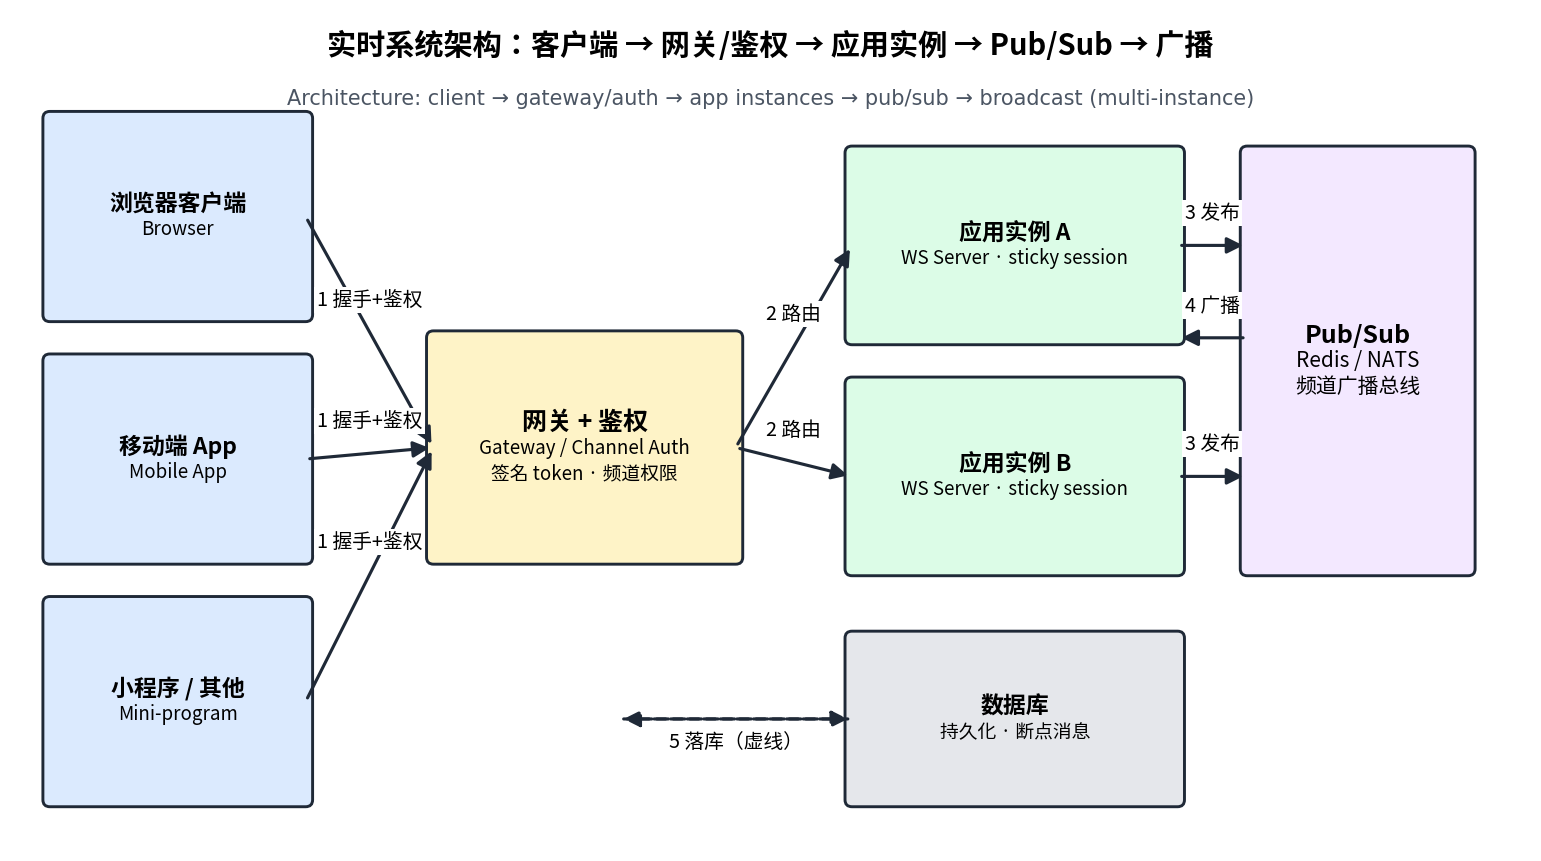 图:实时系统多实例架构。客户端经网关鉴权后连到应用实例;实例只维护本机连接表,跨实例消息经 Redis Pub/Sub 广播;断点消息落 Redis Stream 供重连续传。单机阶段可以砍掉右半部分,但从第一天起就把"发布到总线"和"推送本机连接"写成两个函数——第二个实例上线那天,你会感谢自己。
七、上线清单:连接数成本模型 + 8 项验收
实时功能上线前,先算账。先说一个反直觉的结论:实时功能最贵的部分往往不是服务器,而是"连接数"这个计费维度本身。传统 HTTP 按请求量计费,闲时不花钱;实时连接是 7×24 小时占着的——1000 个半夜不说话的挂机连接,和 1000 个正在聊天的连接,在托管账单上是一个价。设计产品时就要想:哪些连接真的需要实时?挂机用户能不能降级成 SSE 或干脆断开?
连接数成本模型分两种:
托管服务版(Supabase Realtime / Pusher / Ably 这类按量计费):
月成本 ≈ 峰值并发连接数 × 单连接单价 + 月消息量 × 单消息单价
注意是峰值不是平均——营销推送、直播开播那一小时的并发,决定了你的账单档位。先压测出峰值,再选档位,别反过来。
自建版:
单实例连接上限 ≈ 可用内存 / 每连接内存占用(以实测为准,经验值 1–5 万/实例)月成本 = 所需实例数 × 实例单价 + Redis 费用
每连接内存占用自己压出来:空连接和带订阅、带 presence 的连接能差一个数量级。别用网上的数字,那是别人的业务。
一个判断:日活 1 万以下,优先托管或单实例自建,别提前做多实例。实时系统的复杂度 80% 来自"多实例 + 鉴权 + 重连",单实例阶段你只需要写对,另外 20% 是压测。过早引入 Redis 集群、全球边缘,是 vibe 项目最常见的"简历驱动架构"。
上线 8 项验收(一项不过,不许上线):
- 弱网测试。Chrome DevTools 限速 + 手机飞行模式开关 10 次,消息零丢失、顺序不错乱。
- 断线重连。kill 掉连接,30 秒内自动恢复,
last_msg_id续传无丢失、无重复(重复要有去重)。 - 连接风暴。重启服务端,N 个客户端同时重连——退避抖动生效,网关 CPU 不打满。
- 僵尸清理。
kill -9客户端进程,60 秒内服务端剔除连接,监控上的连接数曲线回落。 - 越权订阅。拿 A 用户的 token 订阅 B 的房间,必须被拒绝;枚举
room-1到room-100必须全灭。 - 峰值压测。压到 2 倍预期峰值连接数,p99 推送延迟达标,内存增长收敛(无泄漏)。
- 监控告警。连接数、消息 p99 延迟、心跳超时率三个指标进告警,阈值先按压测数据设。
- 降级开关。一键切回 SSE / 轮询的逃生通道,演练一次——真出事那天,你没时间现写降级。
压测实时系统,k6 的 ws 模块 20 行就能跑:
import ws from 'k6/ws'
export default function () {
  ws.connect('wss://api.example.com/ws?channel=test&token=__TOKEN__', {}, (socket) => {
    socket.on('message', () => {})
    socket.setInterval(() => socket.ping(), 25000)
  })
}
// k6 run --vus 2000 --duration 5m script.js:先看 2000 并发下内存和 p99 延迟
监控阈值起步建议:连接数告警线 = 压测上限的 70%;消息 p99 延迟告警 = 500ms;心跳超时率告警 = 1%。这三个数先按压测结果设,跑两周再调——没有压测数据的告警阈值都是拍脑袋。
降级开关怎么做?一个 feature flag(realtime.enabled),前端建连失败超过阈值、或手动拨开关,就切到 SSE / 轮询兜底。关键细节:降级状态要打点上报,否则你永远不知道"昨晚有一半用户在用轮询"。逃生通道的价值不在"能用",在"出事时 10 秒内生效"。
快问快答:实时功能的五个灵魂拷问
1. "我用 Supabase / Firebase,还要管这些吗?"
托管替你管了多实例广播和连接管理,但鉴权、重连补发、presence 节流还是你的。托管不是免死金牌,是把 80% 的运维换成 20% 的业务逻辑——剩下那 20% 才是决定体验的部分。
2. "HTTP/2、HTTP/3 时代,SSE 是不是过时了?"
没有。SSE 在 HTTP/2 下多路复用反而更香。WebTransport 是未来,但 2026 年它的代理穿透和浏览器覆盖还不够稳,vibe 项目别当小白鼠。等它成为"无脑默认"再换不迟。
3. "消息顺序怎么保证?"
单频道内:服务端单调递增 id,客户端按 id 排序加去重。跨频道不保证——如果你的业务需要全局顺序,说明频道切分错了,先回去看第三节。
4. "移动端 App 进后台怎么办?"
后台的连接注定会死,别挣扎。正确姿势:进后台主动断开并记 last_msg_id,回前台重连补发;重要消息走推送通知(APNs / FCM)兜底。实时连接只在前台存在,这是设计约束,不是 bug。
5. "AI 对话的流式输出,用 WebSocket 还是 SSE?"
SSE。单向、浏览器原生重连、和大模型的 token 流天然同构。除非你的对话需要客户端实时上行(比如语音打断),否则别上 WebSocket——杀鸡不用牛刀,牛刀还要你自己磨。
最后回到开篇那个账单。如果你按这篇指南做:选型时先看生死线而不是看 AI 给了什么,鉴权卡在频道而不是连接,重连带着断点 id,presence 只广播 diff,多实例那天 pub/sub 已经就位——那么你的实时功能在地铁里断网之后,会自己把丢的消息补回来。这才是"实时"两个字该有的样子:不是"快",是"断了也能回来"。
评论 (0)
相关文章
语音 demo 好做,能上线的语音功能是链路工程。这篇指南讲透:三种形态(STT/TTS/实时对话)对号入座、400ms 延迟预算在采集→STT→LLM→TTS→播放全链路的拆分、Whisper 系与流式 STT 取舍、TTS 音质/延迟/成本不可能三角、打断与轮次状态机、浏览器端五个坑、成本建模与防刷,以及 10 项上线验收清单。
AI 帮你 deploy 到 xxx.vercel.app 只是借住。这篇实战指南带你走完买域名、DNS 解析、Cloudflare 上线链路、HTTPS 落地、邮箱三件套全链路——域名是你唯一真正拥有的资产。
AI 写代码快,但默认不写安全代码:本地跑通不等于线上安全。这篇实战指南带你补上 vibe 项目的 Web 安全基线——CSP 安全头、CSRF Token、XSS 防护、SQL 参数化、Cookie 三件套、依赖供应链门禁,外加一份可直接复制的上线前 10 项验收清单。