coding agent 背后的沙箱生意:Modal 拿下 7.5 亿美元,Sandboxes 年化收入冲上 3 亿
Modal 7.5 亿美元 D 轮、估值 157.5 亿(CEO 博客 10-14):年化收入破 10 亿,但最值得细看的是 Sandboxes——运行大模型生成代码的隔离环境——单品年化 3 亿美元。"大模型现在会写代码了,而这些代码得有个地方跑,还得隔离开。"
10 月 14 日,AI 基础设施公司 Modal 的 CEO Erik Bernhardsson 在官方博客上宣布:公司完成 7.5 亿美元 D 轮融资,投后估值 157.5 亿美元,Accel 领投,Kleiner Perkins 新加入。距离 5 月的 C 轮只过去了 5 个月,估值据 TechTimes 报道约为 C 轮的 3.4 倍,年化收入 run rate 突破 10 亿美元,用量翻 3 倍、同比增长 15 倍。
但这条新闻里最值得 vibe coder 细看的不是融资数字,而是一个产品数字:Sandboxes——让开发者运行大模型生成的代码的隔离环境——单品年化 run rate 达到了 3 亿美元。CEO 原文写道,Sandboxes 2023 年上线时只是注意到"人们开始用 LLM 生成代码",三年后它成了一个 3 亿美元的生意,累计启动了近 30 亿个沙箱,能撑到百万级并发。
"LLMs write code now! And it has to run somewhere, isolated from everything else."(大模型现在会写代码了,而这些代码得有个地方跑,还得跟其他东西隔离开。)CEO 这句话,基本就是给 coding agent 时代的基础设施判了个定义。
沙箱为什么是 agent 时代的"水电煤"
想想一个 coding agent 的完整工作流:读需求 → 写代码 → 运行 → 看报错 → 改代码 → 再运行。这个循环里,"运行"是最容易被低估的一环。你不能让 agent 在你自己的服务器上直接执行它刚写出来的、没人看过的代码——LSCBench 上周刚告诉我们,那些代码里大概率藏着漏洞(参见本轮另篇《能跑≠安全:LSCBench 实测》)。隔离执行不是可选项,是 agent 落地的硬门槛。
Modal 的 Sandboxes 解决的正是这个问题:一个按需启动的隔离容器,agent 把生成的代码丢进去跑,跑完即焚。CEO 在博客里点名的用例很有意思:background agents(后台 agent)、reinforcement learning(强化学习)、vibecoding platforms(vibe coding 平台)——vibe coding 平台被官方列为沙箱的核心用例之一。你在 Lovable、v0、Bolt 上每点一次"生成",背后大概率就是这样一个沙箱在转。
而 3 亿美元这个数字说明的,是这个环节已经从"成本中心"变成了"利润中心"。近 30 亿次沙箱启动、百万级并发——这不是实验流量,是生产流量。Agent37 之前把 agent 沙箱成本打到每月 0.37 美元(见本站此前报道),讲的是"把沙箱做便宜";Modal 讲的是"沙箱本身值 3 亿美元"。一便宜一贵,拼出的是同一张图:隔离执行正在成为 agent 经济里独立的一层。
从"好玩"到"值钱":agent 经济的拐点证据
把 Modal 的几个数字摆在一起看,agent 经济的成熟度一目了然:
- 客户名单全是 agent 重度用户:Cognition(Devin 母公司)、Ramp、Linear、Hebbia 在用它跑 background agents;DoorDash 的 AI 平台团队用它把实验推向生产;Runway 在全球各区域生成视频;Physical Intelligence、1X 在训练机器人。TypeSafe AI 的 Jev 上线三天就在 Modal 上跑了 1 万亿个 token——"最快增长的产品之一",CEO 原话。
- 自研到底的栈:文件系统、容器运行时、调度器、网络全自研,容量池横跨 20+ 云厂商。Sandboxes 能做到"每秒启动数万个容器",靠的是自研调度器把请求并行打散到多台服务器。这种投入只有一种解释:他们确信这个需求不是一阵风。
- 路线图向上游走:多节点训练(一个装饰器就拿到 RDMA 全互联集群)、RL 与 post-training 产品线、Modal Servers 做 HTTP serving、LLM 推理的 Endpoint Candidates。Modal 在从"跑代码的地方"变成"训模型+跑 agent 的地方",吃的是整个 AI 应用的基础设施预算。
对比一下时间线:5 个月前 C 轮时估值 46.5 亿美元,现在 157.5 亿。5 个月 3.4 倍,这种斜率在软件史上只出现在平台级机会出现的时候——云计算早期、移动互联网早期。Bernhardsson 自己在博客里把这次类比说得很直白:web、云、大数据、移动之后,AI 是下一次"需要全新基础设施"的范式转移,而上一次范式转移里诞生的是 Docker、Kubernetes、Terraform。
数字的另一面:run rate 不是收入,沙箱也不是只有"快"
冷静一下。CEO 博客里所有的钱数都是 run rate(年化收入),不是已经装进口袋的收入——即按当前增速外推一年的数字。DevCuration 在报道里专门提醒了这一点:它描述的是业务的"当前配速",不是全年已实现的营收。15 倍同比增长里,有多少是 AI 热潮的 beta,有多少是留存下来的真需求,要到明年此时才见分晓。157.5 亿美元的估值,买的是"这个配速能维持"的预期。
另一个值得细看的是沙箱的安全设计,这恰恰是 agent 时代最被低估的细节。据 SiliconANGLE 对 Modal 官方口径的整理,Sandboxes 有两个不寻常的设计:
- Secret Injection(密钥注入):agent 需要登录外部应用时,沙箱可以把登录凭证"递"给 agent 使用,但 agent 本身看不到凭证明文。防的是"rogue agent"(失控 agent)顺手把你的 API key 抄走——当 agent 开始替你操作真实账户,这不再是被害妄想,而是必修课。
- Sidecar 幻觉过滤:跑 agent 的沙箱旁边可以挂一个"边车"容器,跑辅助软件(比如检测过滤幻觉的工具),而且边车和主容器跑在同一台物理机上以降低延迟。把"不可靠的生成"和"可靠的校验"放在同一个隔离单元里,是个很 agent-native 的架构直觉。
这两点连起来看,Modal 卖的不只是"便宜的隔离算力",而是"默认安全的 agent 执行环境"。这和 LSCBench 的结论形成了闭环:agent 生成的代码默认不安全(双过率最高 25.1%),所以执行环境必须默认隔离、默认脱敏、默认可审计。沙箱生意的 3 亿美元里,有相当一部分是"安全税"——而这笔税,恰恰是 vibe coder 最愿意交、也最应该交的一笔。
对独立开发者的三点启示
157 亿美元的估值离独立开发者很远,但 Sandboxes 的 3 亿美元离你很近——因为你的下一个 vibe 项目,很可能也要回答"agent 生成的代码在哪跑"。
第一,别自己造沙箱,除非这是你的主业。Modal 自研文件系统+容器运行时+调度器+网络,横跨 20+ 云,200 多人的团队(纽约、旧金山、斯德哥尔摩三地)——这是重资产。对独立开发者,结论是反过来的:隔离执行已经商品化,直接用 Modal Sandboxes、E2B 这类服务,按调用付费。Agent37 能把成本打到每月 0.37 美元,恰恰是因为站在这些商品化设施上。你的精力应该放在 agent 的行为上,而不是它的跑道上。
第二,"vibecoding platforms"是官方认证的用例,意味着竞争也在沙箱层。CEO 亲口把 vibe coding 平台列为 Sandboxes 的核心用例,说明各家 AI 建站/应用工具的后端,很可能跑在同一类基础设施上。差异化不在"能不能跑",而在"跑完之后"——prompt 编排、状态管理、部署链路。这对正在 vibe coding 赛道创业的人是好消息也是坏消息:起跑线被拉平了,终点线还得自己画。
第三,关注"执行"这个环节的定价权转移。以前云厂商按"算力+时长"收钱;agent 时代,计费单位正在变成"沙箱启动次数""agent 运行步数"。Zenzap 拿到 4400 万美元融资(见本站此前报道)讲的是 agent 进协作,Modal 讲的是 agent 跑起来要交"过路费"。当你给自己的 agent 产品定价时,沙箱成本是必须单列的一行——它不再是可忽略的零头,而是像 Modal 证明的那样,3 亿美元量级的一行。
一句话观点:每一波软件范式转移都会诞生新的基础设施层,上一波是 Docker/K8s/Terraform,这一波是"让 agent 的代码有地方安全地跑"。Modal 的 157 亿美元估值里,有 30 亿是"隔离执行"这四个字撑起来的——当你的 vibe 项目还在为"在哪跑 agent 代码"纠结时,答案已经是一个 3 亿美元的市场了。下一个 5 个月,Modal 的用量会不会再翻 3 倍没人知道;但可以确定的是,每多一个 vibe coding 平台上线,沙箱的计费表上就多一行。
一手来源:Modal CEO Erik Bernhardsson 官方博客《Modal crosses $1B in Annualized Run Rate and raises $750M Series D》(modal.com/blog,Published 2026-10-14);交叉核实 Oossa(2026-10-14)、Futurum Group(2026-10-15)、SiliconANGLE(2026-10-14)。本文数字除特别注明外均出自 CEO 博客原文(一手)。
评论 (0)
原始来源
相关文章
OpenAI 官方客户故事(2026-10-14,第三方交叉核实,官网页无日期戳)介绍 Third Moment Research:一次跑 10,000 个 agent,单会话 36~48 小时自主研究,靠 Codex + GPT-6 Astra/Sol/6.1 Sol 的三层 harness 保证不跑偏。回测案例:缓存优化 + 内存打包让一年期美股订单级回测从约 3 小时降到 3~5 分钟。联合创始人 Jeffrey Yan 说 GPT-6.1 Sol 是团队用得最多的模型,token 效率最高。
10 月 5 日,OpenAI 宣布 textGrain 文本水印计划:欧盟 ChatGPT 与 Codex 未来数周默认开启,全球 API 开发者可 opt-in(默认关闭),检测器仅对获批研究者开放。官方数字坦率:200 token 检出 80%、400 token 95%,25% 同义词替换后只剩 17%。水印防得住复制粘贴,防不住认真改写——对服务欧盟用户的 vibe 开发者,这是一个真实的产品决策。
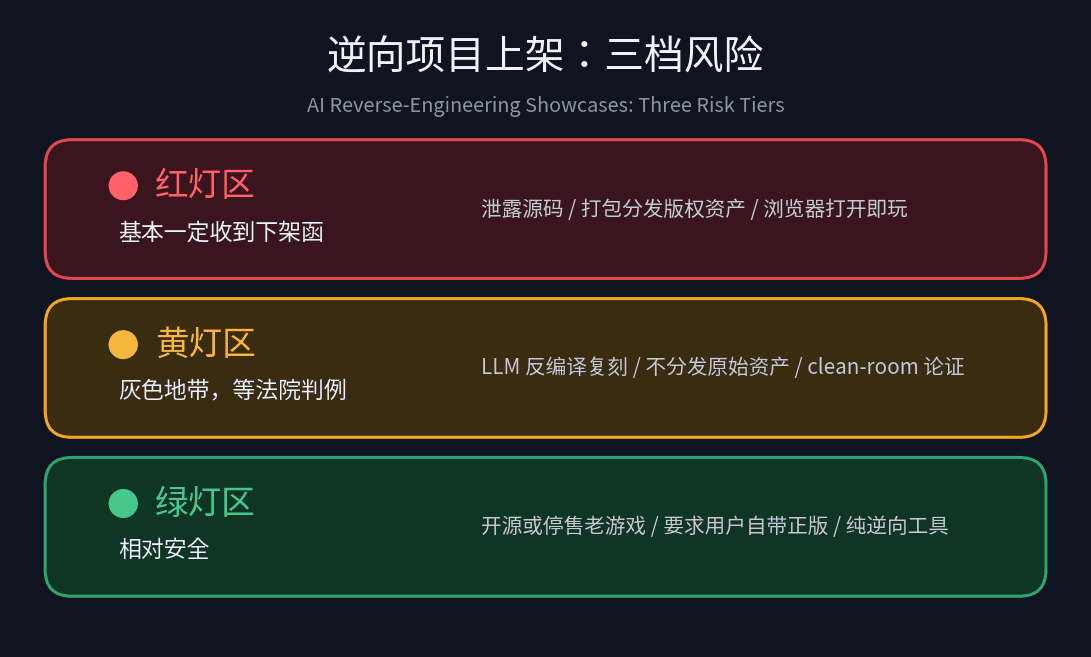
REA 两周破 10 万 GitHub 星,GTA V 跑上 iPhone、Halo 跑进浏览器,52 个逆向游戏项目里 40 个在 10 月前 13 天落地;厂商 12 天发出 4 起下架。法院从未判过 LLM 辅助反编译算不算 clean-room——上架逆向项目的三档风险拆解。