NVIDIA 再开源 120B 多模态 agent 模型 Super VL:文档图片视频一锅端,为“常开企业 agent”而生
NVIDIA 于 10 月 15 日发布 Nemotron 3.5 Super VL:120B 总参数 / 12B 激活的 MoE 多模态模型,文本图像文档视频统一推理,单 GPU agentic 任务吞吐号称达同级开放模型 5 倍(厂商说法)。Artificial Analysis 给出 Intelligence Index 26.5,美国开放权重第一,且 NVFP4 量化近乎无损——一块 H200 就能跑。OpenMDW-1.1 可商用。
先划一条线,避免混淆:两天前站内已经发过 Nemotron 3.5 家族的 Bolt 篇(74B 参数、24GB 显存,主打个人本地部署的那款),这篇不复述 Bolt 的任何参数——本轮的主角是 10 月 15 日(美国西部时间)NVIDIA 同一批放出的另一位家族成员:Super VL。Bolt 是"带进家里的开放模型",Super VL 是"带进数据中心的开放模型",一个家族、两条部署路线,这篇文章只讲后者。
NVIDIA 这次给 Super VL 的定位说得很直白:给"常开的企业 agent"(always-on enterprise agents)用的多模态推理底座。翻译成人话就是:让企业里那些需要长时间挂着干活的智能体——处理供应商单据、读财务报表、查安全告警——能在一个模型里同时看懂文字、图表、文档和视频,而不是今天拼一个文本模型、明天再搭一个视觉模型。
120B 总参数、12B 激活:身材是"够用且好跑"
Super VL 是混合专家(MoE)架构:总参数 120B,每个 token 实际只激活 12B。细账是:含视觉编码器、投影器和多 token 预测模块在内,全量大约 124.453B 参数,每层铺了 512 个路由专家——但每次推理只唤醒其中的 12B。这种"大储备、低激活"的设计,决定了它的成本账跟 12B 量级模型接近,而知识容量是按 120B 规模装的。
上下文窗口 100 万 token。注意这个数字有个限定:托管端点(比如 OpenRouter 上的公开 API)的上限是 262K,100 万是本地部署时的能力天花板。1M 上下文在实战里的含义是:几百页的 PDF、多页财报、两小时的会议录像文字版,可以一次性喂进去做跨文档推理,而不用自己写切片、召回、合并那套工程。
输入侧覆盖文本、图像、文档和视频,输出是文本。视频输入有个硬限制:只认 MP4、单条最长 2 分钟——这个细节是 HF 模型卡里写的,不是营销页上的,意味着它做的是"看懂监控回放、产品演示、会议片段"这种短视频理解,而不是长视频分析。推理模式可以通过聊天模板里的 enable_thinking 开关来开和关:简单任务关掉推理省 token,复杂 agent 任务再打开。
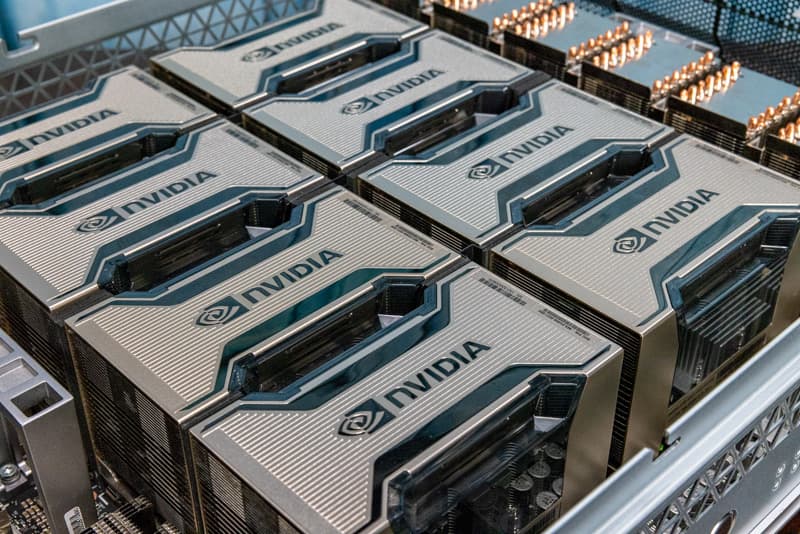
部署门槛可能是这篇新闻里最值得 enterprise 读者划线的部分。NVFP4 量化版(4-bit 权重 + 激活,Blackwell 架构上)可以在一台 DGX Spark、一块 H200、两块 H100 或一块 GB200 上跑起来;而 BF16 全精度版需要 4×H100 或 2×GB200。两个版本的差距有多大?第三方评测给了一个很硬的数字,后面细讲。
"一锅端"到底端掉了什么:告别"文本+视觉"两件套
NVIDIA 官方技术博客把这个设计的动机写得很具体:过去做文档智能体,团队往往要部署一个文本模型处理逻辑,再搭一个视觉语言模型处理图表和版面,然后在两个模型之间传上下文——传一次,信息就损一次。Super VL 把推理、指令遵循、工具调用和文本/图像/文档/视频理解装进同一个模型,一次前向就把"看懂图表"和"基于图表推理"做完。
举个博客里的例子:同一个模型既能解读一张图表,又能把它跟文档另一页的表格关联起来,再出一份总结。这听起来理所当然,但在 MoE 架构里,文本专家和视觉专家能不能在同一个推理链条里协作,决定了这种"跨模态跳读"是真能力还是演示效果。NVIDIA 在 CharXiv(图表推理基准)上给出的数字是 80.8%,对比自家的 Nemotron 3 Nano Omni 是 63%;如果允许模型用 Python 做代码辅助解释,分数到 84%。这是厂商自己报的数字,独立复核还没有,但至少说明这条路线是它重点押注的方向。
 NVIDIA GPU 服务器示意图:为企业常开 agent 而生的 120B 多模态模型 Super VL 可跑在单张 H200 上
第三方成绩单:Artificial Analysis 26.5,美国开放权重第一
第三方评测机构 Artificial Analysis 在 10 月 15 日当天就跟进了 Super VL 的评测,结论有几个值得单独拿出来:
第一,Intelligence Index 26.5,是目前美国开放权重模型里的最高分,压过了 Thinking Machines 的 Inkling Small(25.7)和自家上一代旗舰 Nemotron 3 Ultra(23)。横向看,美国开放权重整体仍落后于阿联酋的 K2 Horizon(31)和中国的 MiMo-V2.6-Pro(46),但至少在美国阵营里,NVIDIA 这次把榜首从自家 Ultra 手里接了过来。顺带一提,它比前代 Nemotron 3 Super(13 分)翻了一倍,而每个任务的输出 token 反而少了约 60%——效率涨得比智商还快。
第二,速度。AA 测到 Super VL 在 10 万 token 提示词下输出速度约 630 token/s,是该榜单上 20 分以上模型里最快的;大约是 Inkling Small 的 5 倍、Nemotron 3 Ultra 的 2.7 倍,首 token 延迟 1.8 秒。NVIDIA 官方博客里"单 GPU agentic 任务吞吐达同级开放模型 5 倍"的说法(必须标注:这是厂商宣称),第三方数据至少在速度维度上给出了一个量级吻合的佐证。
第三,NVFP4 量化近乎无损。NVFP4 版在 Intelligence Index 上只比 BF16 全精度版低不到 0.1 分,没有任何子项掉超过 2.6 分。这意味着"一块 H200 就能跑"的版本,几乎没为压缩付出代价——这对企业部署是决定性信息:你不需要在精度和硬件成本之间做痛苦选择。
第四,一个耐人寻味的细节:在 Hermes Bench(63.44%)和 LangChain 行为评测(87.05%)上,Super VL 都超过了参数量大它数倍的自家旗舰 Nemotron 3 Ultra(56.33% / 84.3%)。"五分之一参数量、agent 任务精度反而更高",这正是 NVIDIA 想讲的故事:agent 时代的模型选型,参数规模不再是唯一的尺子。
厂商宣称专区:数字很漂亮,先打折看
以下全部来自 NVIDIA 官方口径,是厂商单方说法,没有独立第三方复核,读的时候请自动打折:
落地案例三组。Scale AI 把 Super VL 微调后用在 Skydance 的供应商信用处理流程上,NVIDIA 称推理成本降了 40 倍、延迟降了 5 倍。Ramp 用它把收据图片转成结构化 JSON(商户、日期、支付信息),称吞吐提升 50%、延迟降 10 倍。AI21 和 Alice 把它用在威胁情报和漏洞分析上,称准确率提升 41%(博客原文是 41%,部分转载写成 40%,以官方博客为准)。
这三个案例有个共同点:都是"重文档、重版面、流程固定"的活。供应商信用单、收据、威胁情报报告——输入格式稳定、判断标准可沉淀、出错成本可控,正好是"微调一个小专家模型替代通用大模型"的教科书场景。NVIDIA 选这三个案例不是偶然,它在暗示 Super VL 的目标客户画像:有私有数据、有固定流程、想把大模型账单打下来的中大型企业。
平台伙伴方面,NVIDIA 官方宣发列出的正在集成的平台包括 Atlassian、CrowdStrike、Salesforce、Perplexity,另外还有 Dassault Systèmes、Synopsys 等(同样是厂商说法)。CrowdStrike 的方向是企业网络防御 agent,Salesforce 是政府工作流自动化,Perplexity 则出现在了官方博客的训练数据致谢名单里——高质量数据集来自 Perplexity,帮它改进了中期训练。
部署侧还有两个值得记的数字(厂商口径):NVIDIA Dynamo 的部署方案在 16 块 B200 上、每用户 50 token/s 的交互速率下,能服务 8 倍的用户量,首 token 延迟降 85%;新开源的投机解码技术 LiLiCorr 在 DGX Spark 上比无投机解码快 2.3 倍。这些数字的测试条件都是 NVIDIA 自己定的,看看就好,但至少说明它在"agent 反复调用的推理成本"这个命题上是真下了功夫的——prefix caching、Mamba 状态复用、KV 缓存 NVFP4 化,一整套组合拳。
开放资产:不只是权重,还有整套"造 agent"的工具链
Super VL 的权重协议是 OpenMDW-1.1,允许商用、微调和再分发。获取渠道是 Hugging Face、OpenRouter 和 ModelScope,base、post-trained、NVFP4、BF16 四个版本 checkpoint 都在 HF 上。这次 NVIDIA 放出来的不止权重:训练 recipes、基于 NeMo Gym 的 RL 环境、HF 上 40 个视觉语言数据集,外加 agent 工具调用、金融推理、长上下文、安全对齐等数据集——按官方博客的说法,是"把造专用 agent 的整条工具链都开源了"。
这对中小团队的意义可能比模型本身更大。专用 agent 最大的成本从来不是下载权重,而是"怎么把自家数据变成训练数据、怎么搭 RL 环境验证"。NVIDIA 把 NeMo AutoModel(SFT/LoRA)、NeMo RL、NeMo Gym 一并开源,等于把 Scale AI、Ramp 那套"微调+验证"的方法论也商品化了。当然,方法论开源不等于开箱即用,真要把这套跑起来,团队里至少得有人懂 RL 和 agent 评测。
三条路线一次看清:开放权重正在"按部署场景分层"
这是本篇最想给的观点增量。把最近一个月的开放权重发布连起来看,一幅"分层图"正在成型:
 NVIDIA GPU 服务器示意图:为企业常开 agent 而生的 120B 多模态模型 Super VL 可跑在单张 H200 上
第一层是极致能力:Meta 的 Muse Spark Open,816B 总参数、42B 激活,和苹果联手跑在 Mac Studio 集群上(两台 512GB 统一内存的 M5 Ultra 版,或四台 256GB 组网)——赌的是"旗舰能力必须交到开发者手里",代价是桌面级的夸张硬件投入。(我们 10 月 15 日那篇单独写过)
第二层是企业 agent 实用层:就是今天的 Super VL,120B-A12B,一块 H200 或一台 DGX Spark 就能跑,专为"看文档、调工具、跑长流程"的企业智能体优化。不追求参数最大,追求"单 GPU 吞吐、量化无损、微调友好"这三件事。
第三层是个人本地:同批发布的 Bolt 74B-A9B,2-bit 量化塞进 24GB 显存,RTX 笔记本就能跑;更小的 Bolt E4B 只要 4GB,10 月 23 日到,目标是 Jetson 和桌面 RTX 上的轻量对话 agent。(Bolt 的详细参数见两天前那篇,这里不展开。)
三层加起来,NVIDIA 实际上在回答一个问题:开放权重不应该只有一个"越大越好"的尺子,而应该按"你在哪里跑、跑什么活"分层。Meta 走第一层,NVIDIA 自己同时占了第二层和第三层。这种分层一旦形成,选模型的逻辑就从"谁分最高"变成"我的场景在第几层"——对做技术选型的人来说,这是比任何单个基准分数都重要的变化。
值得一提的是,这也是 NVIDIA 开放策略的一贯延续:从之前的 Nemotron 系列拿 IOI/IMO 金牌级成绩开源(我们之前报道过那条线),到这次把"企业 agent 专用模型+全套训练工具链"一起放出来,它的打法始终是"模型开源换生态,生态回流到自家硬件"。Super VL 跑得最好的硬件,清单里全是 NVIDIA 自己的卡——DGX Spark、H200、H100、GB200。开放权重是真的,商业闭环也是真的,两件事不矛盾。
谁该关注,谁可以先等等
如果你在企业里负责文档智能、财务自动化、安全运营这类"重版面、长流程"的 agent 项目,Super VL 值得放进选型短名单:120B-A12B 的身材、NVFP4 近无损、一块 H200 起跑、OpenMDW-1.1 可商用,这几个条件组合在一起,在当前开放权重市场里没有直接对位竞品。尤其是有私有数据要微调的团队,40 个视觉语言数据集和 NeMo Gym 的 RL 环境能省不少冷启动的力气。
但如果你要的是通用聊天、代码生成主力模型,或者团队里没人能 hold 住微调和 agent 评测,那 Super VL 的"专用"二字就是提醒:它的强项是被 post-train 之后的专用 agent,而不是开箱即用的全能选手。开箱即用的活,还是交给闭源 API 或者更大规模的通用开放模型。
最后一句判断:Super VL 真正的考验不在发布这周,而在未来三个月——有多少 Scale AI、Ramp 这样的案例从"厂商宣称"变成"客户自己站出来讲"。开放权重的战争下半场,拼的不再是基准分数,而是"谁家的微调工具链真能让企业把账算过来"。NVIDIA 这次把工具链一起开源了,等于把赌注从模型本身挪到了生态执行力上。这一步走得对不对,看明年 Q1 的采用数据。
评论 (0)
原始来源
相关文章
10 月 15 日 Anthropic release notes:Opus 5.5 的 fast mode 脱离 research preview,不再需要 beta header,Start/Build/Scale 三档默认有 fast mode 限速,同步登陆 Azure Foundry;Compliance API(Enterprise beta)新增读取成员“Instructions for Claude”与 Cowork“Global instructions”全文的接口。本文的判断增量:速度分层定价正式成为 Anthropic 的产品线、与 OpenAI 形成镜像,以及 Compliance API 与 METR 独立评审、usage policy 硬件条款组成的“治理组合拳”;并给 agent 开发者一份按“每任务成本”重测的实操清单。
10 月 13 日,Ramp 把内部 vibe coding 平台 Glass 做成对外 AI workspace 产品:323 名员工沉淀出 6500+ 次 edits 的可复用 Skills,一位账号经理的 prompt 让需求收集从每月 300 条涨到 20000 条;CEO 自曝 5 月一周烧掉 150 万美元 token 之后,每个项目自带出租车打表式计费,外加按任务选模型的 Ramp Router。
10 月 15 日 Grok Bot 在亚马逊下单被警告拦截,马斯克回应三件套:去别家买更便宜、SpaceX 为买错兜底、随口提议创办亚马逊竞争对手。本文复盘亚马逊从起诉 Perplexity、拦截 Meta Muse 到 robots.txt 封锁的 agent 逐客令时间线,对照 Shopify 同一周的开门策略,并给出给 vibe 开发者的三条合规警示。