Claude Opus 5.5 的 Fast 模式转正:不用再申请,Anthropic 合规 API 还能审计员工提示词
10 月 15 日 Anthropic release notes:Opus 5.5 的 fast mode 脱离 research preview,不再需要 beta header,Start/Build/Scale 三档默认有 fast mode 限速,同步登陆 Azure Foundry;Compliance API(Enterprise beta)新增读取成员“Instructions for Claude”与 Cowork“Global instructions”全文的接口。本文的判断增量:速度分层定价正式成为 Anthropic 的产品线、与 OpenAI 形成镜像,以及 Compliance API 与 METR 独立评审、usage policy 硬件条款组成的“治理组合拳”;并给 agent 开发者一份按“每任务成本”重测的实操清单。
先划一条线,避免和上一篇混淆:cycle48 的 Opus 5.5 发布篇里,fast mode 还只是一个 research preview,需要申请、需要 beta header;本篇是 10 月 15 日 release notes 里的新事件——fast mode for Claude Opus 5.5 正式 GA,同时 Anthropic 还给 Enterprise 组织开了一条能读员工提示词全文的合规接口。两件事看似不相干,读完你会发现它们是同一家公司在同一天打出的两张牌:一张卖速度,一张卖治理。
Fast mode 转正:Opus 5.5 不再需要 beta header
更新的核心就一句话:Claude Opus 5.5 的 fast mode 脱离了 research preview,变成正式功能。从 10 月 15 日起,调用 Opus 5.5 时不再需要传 fast-mode-2026-02-01 这个 beta header,也不再需要单独申请开通。如果你之前的代码里还带着这个 header,不用急着删——官方明确说了,旧 header 继续传也不会报错,完全兼容。Anthropic 在这类"转正"上的一贯做法就是这样:老客户端不强制迁移,新客户端可以直接省略。
第二个实质性变化是限速。Opus 5.5 现在在 Start、Build、Scale 三个 usage tier 都有了默认的 fast mode 限速。翻译成大白话:之前 fast mode 是"申请制",配额要单独批;现在是"开箱制",这三个档位的组织默认就有 fast mode 的速率额度,不用再走申请流程。Evaluation 档位的组织要升级到 Start/Build/Scale 之后才能用。这对把 Opus 5.5 跑在生产环境的团队来说,是实实在在的门槛降低——之前很多人是在等配额,现在配额是默认给的。
但注意,转正的只有 Opus 5.5。Claude Opus 5 和 Claude Opus 4.8 的 fast mode 仍然停留在 research preview,调这两个模型继续走老路:beta header 照传、开通照申请。官方文档的对照表里写得很清楚,三档模型只有 5.5 跨过了这条线。为什么 Anthropic 只转正最新款?合理的推测是推理侧的 capacity 分配——fast mode 本质是"更快的推理配置",需要单独的算力池,优先保证最新模型的供给是商业上最顺的选择。
 手机上的 Claude 应用界面:用户手持 iPhone,屏幕显示 Claude 对话入口
2.5 倍速的价格是 2 倍账单:先算清这笔账
Fast mode 的官方描述是:同样的模型、更快的推理配置,输出 token 速率最高提升 2.5 倍,智能和能力没有任何变化。用量方式是在请求里加 speed: "fast" 参数,返回的 usage.speed 字段会告诉你这次请求到底跑的是 fast 还是 standard——如果配额或容量不够,请求会直接报 429 或 529,而不是静默降级,这点对做重试逻辑的人很重要。
价格这边,文档给的数字很直白:Opus 5.5 的 fast mode 是输入 8 美元、输出 40 美元每百万 token。对比标准速率的 4 美元 / 20 美元,正好是 2 倍乘数。而且这个乘数是"叠加上去"的:prompt caching 的乘数、data residency 的乘数都在 fast mode 定价之上再叠。换句话说,fast mode 不是"加速版定价",而是"标准定价 × 2",其他附加费照收不误。
还有几个实操细节值得单独拎出来。第一,fast 和 standard 之间切换会使 prompt cache 失效——两种速率不共享缓存前缀。如果你精心设计了缓存命中率,贸然全切 fast mode 可能先吃一波缓存失效的亏。第二,fast mode 不支持 Batch API 和 Priority Tier,也不登陆 Claude Platform on AWS(Azure 的 Foundry 这次上了,AWS 这边还没影)。第三,增速集中在输出 token 速率(OTPS),首 token 延迟(TTFT)基本不受影响——你的 agent"开始干活"不会更快,"干活吐字"会更快。
同步登陆 Azure:Foundry 上的 Opus 5.5 也有份
10 月 15 日的第三条目很容易被略过,但对企业用户分量不轻:Opus 5.5 的 fast mode 同步登陆了 Claude in Microsoft Foundry 上由 Azure 托管的部署。Anthropic 这几个月在"多云落地"上明显加速——Bedrock、Google Cloud、Azure Foundry 三线并进,fast mode 这种新能力现在是发布当天就带上 Azure,而不是像以前那样 API 先行、云厂商慢慢跟。对只能走 Azure 合规通道的大企业客户来说,这意味着 fast mode 从第一天起就是可选的,不用在"合规"和"速度"之间二选一。
Compliance API:企业终于能"审计"员工的 Claude 指令
如果说 fast mode 是卖给开发者的,Compliance API 就是卖给合规官的。新接口 GET /v1/compliance/organizations/{org_uuid}/user_preferences 做的事情很具体:返回组织成员在 claude.ai 里存的"Instructions for Claude"全文,以及在 Cowork 里存的"Global instructions"全文。调用需要 Compliance Access Key,外加 read:compliance_user_data 这个 scope。目前是 beta,仅限 Claude Enterprise 组织。
这件事的背景值得展开一点。Compliance API 不是新东西——9 月 24 日的 release notes 里,它刚把 Activity Feed 里的文件名、项目文档名、artifact 标题全部置空(查名字要走合规 key);10 月 8 日它又加上了 unified Claude experience 的聊天记录和 Claude Docs 的 Word 下载。Anthropic 在合规这条线上的节奏是:先收紧默认暴露面,再给企业开"审计员通道"。10 月 15 日这次,是把"成员写给 AI 的长期指令"也纳入了审计范围。
为什么是"指令"而不是聊天记录?因为指令的治理价值被长期低估了。一个员工在"Instructions for Claude"里写的东西,可能是"回复客户时永远用我们公司的报价口径",也可能是"帮我绕过审批流程的措辞"。前者是企业知识资产,后者是合规风险——而在今天之前,企业的合规团队对这两类文本都是盲区。Compliance API 的出现,等于 Anthropic 正式承认:员工定制 AI 行为的文本,本身就是需要被审计的企业数据。
当然,这也是一把双刃剑。员工在 claude.ai 里写的个人指令,被企业批量读取,隐私边界在哪里?Anthropic 的答案是 scope 隔离——read:compliance_user_data 不是默认权限,需要显式授权,而且只对 Enterprise 组织开放。但"能审计"和"该审计到什么程度"之间,永远隔着各国劳动法和各公司内部政策。这个接口给了企业能力,没给标准答案,标准答案得企业自己写进员工手册。
 手机上的 Claude 应用界面:用户手持 iPhone,屏幕显示 Claude 对话入口
同一天的背景板:10 月 14 日的可观测性与 AWS 落子
10 月 15 日的三条目不是孤立的,往前翻一天能看到配套动作。10 月 14 日 Anthropic 上线了 OpenTelemetry export(beta):Claude SDK 在 Python、TypeScript、C#、Go、Java、PHP、Ruby 七个语言里直接打 span,Messages API 的请求和 Managed Agents 的会话都能导出到你自己的可观测性后端。同一天,Claude Managed Agents 的 scheduled deployments 登陆了 Claude Platform on AWS。
这两条在本篇里不展开——它们和 10 月 15 日的主题构成的是"同一周"的拼图:Anthropic 正在同时做三件事,让模型跑得更快(fast mode)、让调用看得更清(OpenTelemetry)、让企业管得更住(Compliance API)。速度、可观测、治理,三条线在同一周各自落子,这不是巧合,是 Anthropic 下半年 API 战略的完整形状。对了,10 月 9 日的 dynamic workflows beta 本篇不碰,站内已经单独发过一篇。
观点:同一天打出的两张牌,其实是一套组合拳
先说第一张牌。Fast mode 转正意味着一件事正式成立:延迟和成本的分层定价,已经是 Anthropic API 的正式产品线,不再是实验功能。从"标准速率一个价"到"标准 / 快速两档价",API 的定价维度多了一个"速度"。这和 OpenAI 那边的 Ultrafast 档位形成了镜像——两家不约而同地发现,"快"本身是可以单独卖钱的(我们之前分析过 GPT-6.1 的 Sol 定价,速度分层是同一个逻辑)。对开发者来说,这意味着选型时要多一个维度:不是"哪个模型",而是"哪个模型 × 哪个速度档"。
再说第二张牌。Compliance API 读指令全文这件事,如果单独看,只是一个企业功能;但如果和这个月的另外两件事放在一起,味道就变了:cycle59 我们写过 METR 成为 Anthropic 的独立评审方(评审放权),以及 2026 版 usage policy 里新增的硬件相关条款(政策收紧)。独立评审解决"模型安不安全"的信任问题,usage policy 解决"能拿去干什么"的边界问题,Compliance API 解决"企业内部怎么管"的执行问题——三块拼在一起,就是 Anthropic 在 10 月打出的"治理组合拳"。Anthropic 显然意识到,企业买单的不只是模型能力,还有"出了事我能不能交代"的治理工具箱。
两张牌合在一起看,还有一个更底层的信号:Anthropic 正在把 API 从"调用模型的接口"升级成"企业级 AI 基础设施"。卖速度是基础设施的性能维度,卖审计是基础设施的合规维度,卖可观测性(OpenTelemetry)是基础设施的运维维度。当一家模型公司开始在同一周补齐这三个维度,它瞄准的就不再是"开发者尝鲜",而是"企业把核心业务跑在上面"。这对所有做 agent 基础设施的创业公司都是个提醒:Anthropic 正在把你们今天收费的很多能力,变成平台默认项。
给 agent 开发者的实操清单
落到具体行动,fast mode GA 之后建议做这几件事。第一,生产环境可以直接用 speed: "fast" 了,但先去 Console 的 Rate limits 页面确认你的 fast mode 额度,别假设"默认有"等于"够用"。第二,读返回的 usage.speed 做监控——你得知道每一笔请求到底跑在哪个档位,否则账单来了对不上。第三,429/529 要有降级策略:SDK 默认会自动重试两次,嫌慢就把 max_retries 设 0 立刻失败,然后不带 speed: "fast" 重发,走标准速率兜底。
第四,也是最重要的:按"每完成一个任务的成本"重新测一遍,而不是只看"每百万 token 的价格"。这里必须说清楚来源性质——公开社区测试曾报告过一个反直觉的结论:在 max effort 这类高强度设置下,模型输出的 token 量会明显膨胀,token 膨胀带来的成本上升可能把降价红利吃掉大半。这是第三方实测的结论,不是 Anthropic 官方口径,测试方法和样本量都未经官方确认;但它指向的方法论是对的:fast mode 改变的是"单位 token 的价格和速度",不改变"完成一个任务要多少 token"。你的 benchmark 指标应该是"修好一个 bug 花多少钱、多少秒",而不是"一百万 token 多少钱"。
第五,检查你的缓存策略。fast 和 standard 不共享 prompt cache,如果你的 agent 严重依赖长上下文缓存,切换速率档之前先测缓存命中率的变化,别让 2.5 倍速被缓存失效抵消。第六,Batch API 和 Priority Tier 的用户注意:fast mode 目前不支持这两条通道,有离线批量任务的继续走标准速率。
最后回到 Compliance API——如果你是在 Enterprise 组织里做 AI 落地的工程师,这条更新值得转给你的合规同事。接口是 beta,scope 要单独申请,但方向已经明确:员工写给 Claude 的指令,正在变成企业可审计的数据资产。提前把"哪些指令允许写、审计日志谁来看"写进内部规范,比等审计找上门再补要从容得多。
一句话总结 10 月 15 日:Anthropic 在同一天告诉了开发者"可以更快了",告诉了合规官"可以管得更细了"。速度和治理,分别是 API 经济的两条增长曲线——而这两条曲线,正在同一家公司的 release notes 里交汇。
评论 (0)
原始来源
相关文章
NVIDIA 于 10 月 15 日发布 Nemotron 3.5 Super VL:120B 总参数 / 12B 激活的 MoE 多模态模型,文本图像文档视频统一推理,单 GPU agentic 任务吞吐号称达同级开放模型 5 倍(厂商说法)。Artificial Analysis 给出 Intelligence Index 26.5,美国开放权重第一,且 NVFP4 量化近乎无损——一块 H200 就能跑。OpenMDW-1.1 可商用。
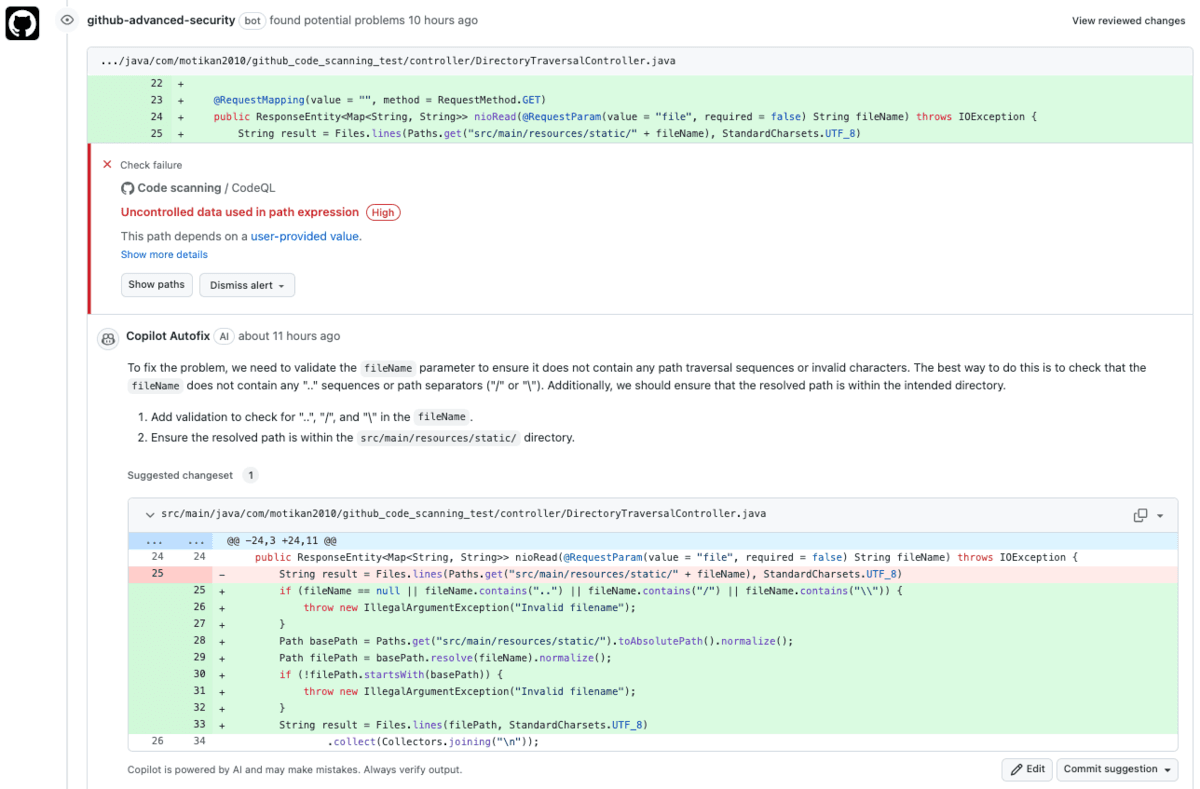
10 月 15 日,GitHub 的 agent 式自动修漏洞 GA:告警指派给 Copilot,跨代码库探索、生成修复、重跑 CodeQL 验证、开 draft PR;免费的 Generate Fix 按钮被 Assign to Copilot 取代,按 AI Credits + Actions 分钟收费,企业账单新增 Advanced Security 产品行。
10 月 13 日,Ramp 把内部 vibe coding 平台 Glass 做成对外 AI workspace 产品:323 名员工沉淀出 6500+ 次 edits 的可复用 Skills,一位账号经理的 prompt 让需求收集从每月 300 条涨到 20000 条;CEO 自曝 5 月一周烧掉 150 万美元 token 之后,每个项目自带出租车打表式计费,外加按任务选模型的 Ramp Router。