Pangram Image 1.0 来了:能标出图中哪块是 AI 生成的,但分数先别全信
Pangram 11 月 4 日推出图片与视频检测模型 Image 1.0 和 Flash 1.0,热力图与低置信度提示是这次发布里最实在的进步。但 99.96% 这类数字全部来自厂商自建测试集,应当先当作待第三方复现的声称来读,而不是已经盖棺定论的事实。
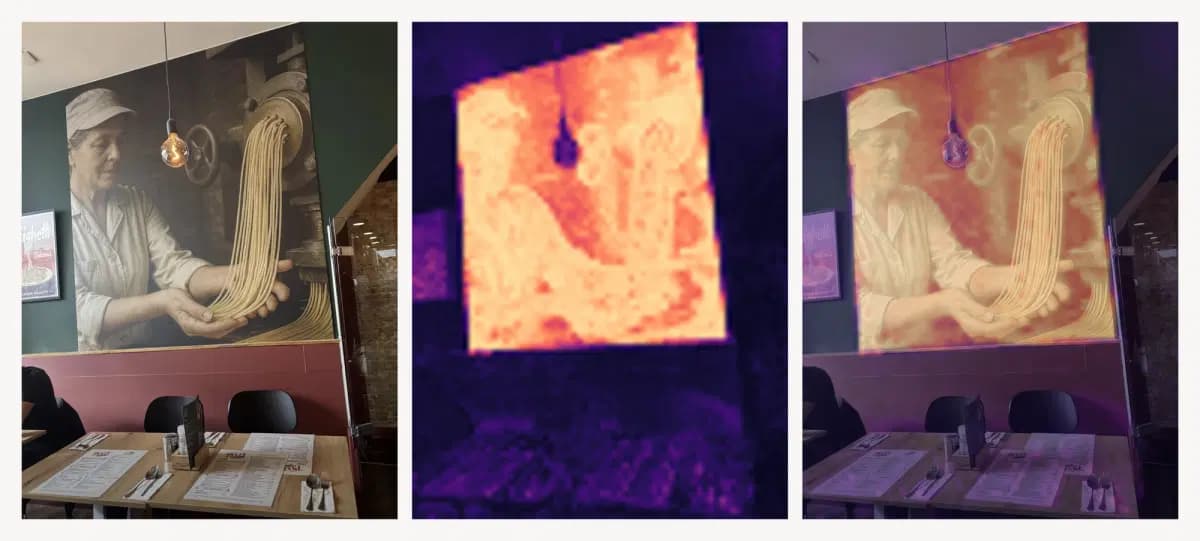
先说判断:检测器的价值不在分数,而在它敢不敢说“我不确定”

Pangram 在 11 月 4 日正式推出了 Pangram Image 1.0 和更轻更快的 Pangram Image Flash 1.0,前者管图片,后者逐帧管视频。加上 Chrome 插件和 API,这家靠文字检测起家的公司,第一次把业务从“这段话是不是 AI 写的”扩到了“这张图、这段视频是不是 AI 生成的”。表面上看这是一次产品线扩张,实际上它碰的是一个更难的问题:当生成式图片和视频已经便宜到人人可用时,普通人凭肉眼几乎分不出来了,而平台、媒体、电商和租房网站每天都要面对真假混在一起的内容。
我的判断先摆出来:这篇发布里最值得看的不是 99.96% 这个数字,而是两处细节,一是热力图,二是低分辨率下的“低置信度提示”。分数很容易刷,细节很难装。一家检测公司愿不愿意在自己的产品里留出“我不确定”的位置,比它敢报多高的准确率更能说明它靠不靠谱。Pangram 这次至少在产品形态上做了这个选择,至于分数本身,所有人都要打个折扣听,因为那都是厂商自己的卷子、自己改的分。
这次到底发了什么
先把事实部分讲清楚。Pangram Image 1.0 是旗舰图片检测模型,官方博客的说法是“在前沿 AI 图片生成器检测上达到业界领先水平”,并新增三样东西:热力图输出,可以标出图片里到底哪一块是 AI 生成的;对编辑、压缩和低分辨率的鲁棒性,也就是图片被社交平台压过、裁过、加过噪之后还能检;以及最低输入尺寸从 512×512 像素降到 256×256 像素,低于 512 像素的结果会附带低置信度提示。Flash 1.0 则是更小更快的模型,专门做视频,逐帧分析,官方称它在视频检测上同样领先。
使用方式也一次铺开了四个口子:网页端直接上传图片和视频、Chrome 插件在刷社交媒体、购物和租房网站时自动标记、API 同时支持图片和视频检测。几个月前 Pangram Image 还只是研究预览版,这次等于从预览转正。覆盖的生成器名单也很长,图片一侧包括 OpenAI 的 GPT Image、谷歌的 Nano Banana、Midjourney、FLUX 和 Grok Imagine,视频一侧包括 Kling、Seedance、Veo 和 Wan 等。也就是说它瞄准的不是某一家生成器,而是整个生成生态。
还有一个背景值得交代:Pangram 是靠文字检测起家的,之前还推出了 Pangram 4 文字模型,号称能识别 AI 辅助写作和所谓“AI 人性化”工具改写过的文本。这次的图文视频检测,等于是把同一套“辨真伪”的生意从文字扩展到了视觉。对这家公司来说,这是顺理成章的一步;对用户来说,意义在于以后可能在同一个地方查文字、图片和视频,而不用在几个工具之间来回倒。
分数怎么读:先看卷子是谁出的
官方博客给出的核心数字是这样的:Pangram 用 12 个前沿图片生成器,对 100 张真实照片做了合成镜像,一共 1200 张合成图,模型在这套自建测试集上的准确率是 99.96%。视频一侧,Flash 1.0 在 DF26 学术基准上得分 98.7%,官方称比次优检测器高出 29 个百分点。另据媒体转述,Pangram 在官方发布帖中还提到图片识别率 99.2%、误报率 0.27%。这几个数字放在一起,第一眼会觉得有点乱,第二眼就明白了:它们来自不同的测试集,衡量的也不是同一件事。
这里必须把话说透。99.96% 那个数字的卷子是 Pangram 自己出的:真实照片是自己选的,合成镜像是自己生成的,提示词也是自己写的,力求“接近原图”。这种自建镜像测试有一个好处,就是能控制变量、排除那种一眼假的生成图滥竽充数;但也有一个绕不开的毛病,就是出题人同时也是考生,测试集的难度分布天然会偏向自己擅长的方向。所以这个数字最多只能理解为“在 Pangram 自己设计的难题上表现很好”,不能直接翻译成“你在网上随便拿一张图,它都有 99.96% 的把握”。
DF26 的情况稍好一些,因为它是一份学术研究里提出的基准,讲的是人眼在分辨真人说话视频时几乎和随机猜差不多,现有检测器也没好到哪去。Flash 1.0 在上面拿到 98.7%,如果这个数字经得起第三方复现,那确实是一个台阶。但同样要提醒一句:学术基准也有自己的分布和时效性,生成器每个月都在换代,今天的基准成绩不自动等于明天的实战成绩。至于 99.2% 和 0.27% 这组数字,媒体转述的口径和博客正文并不完全对得上,本文如实并列两种说法,不替厂商把它们缝合成一个漂亮的数字。
还有一个细节很能说明这家公司的自我认知。据 Engadget 转述,Pangram 曾推迟发布,因为模型一开始会把 iPhone 18 Pro 拍的照片误判为 AI 生成,于是团队拿真机反复测试才放行。这个故事如果是真的,恰恰说明检测这件事最难的不是识别生成器,而是别冤枉真实设备拍出来的真实照片。手机计算摄影本身就在做大量合成和增强,真实与生成的边界正在变模糊,误报的代价不是一句“不好意思”,而是可能毁掉一个摄影师、一家小店或者一条新闻线索的 credibility。
热力图和低置信度提示,为什么比分数重要
回到开头的判断。热力图之所以重要,是因为它把检测从一个二选一的 verdict 变成了一份可以检查的证据。只说“这张图是 AI 的”,用户除了信或者不信,没有第三条路;标出“左上角那块天空、右下角那只手是 AI 的”,用户就可以自己去看、去比对、去找原图、去问拍摄者。一个能被检查的结论,哪怕不完美,也比一个不容置疑的结论健康得多。尤其是在真假混杂的场景里,一张真实照片里嵌了一块 AI 生成内容,恰恰是目前最常见也最难处理的造假方式,整图打分在这里是失效的,定位才有意义。
低置信度提示同理。把最低尺寸降到 256 像素,同时明说低于 512 像素的结果置信度会打折,这等于承认了一个所有检测公司都知道但不一定愿意说的事实:输入越小、信息越少,判断就越不可靠。与其硬撑一个高分,不如把不确定性写在结果旁边。这对普通用户尤其重要,因为他们在社交媒体上看到的图片往往就是被压缩过的小图,如果工具在这种情况下还报出斩钉截铁的结论,误导的概率反而更大。
Chrome 插件的逻辑也值得单独说一句。它的卖点是在你刷信息流、逛购物网站、看租房帖子时自动标记可疑内容。这类场景的共同点是用户本来没有“鉴定”这个动作,决策却在几秒钟内完成:要不要相信这套房子的照片,要不要下单这件商品。插件把检测塞进了决策发生的地点,而不是要求用户先把图片存下来再去另一个网站上传。这个设计方向是对的,但风险也在这里:如果插件的误报率在真实信息流里高于实验室数字,它标记的每一条都可能变成一次小型名誉损害,而用户往往不会点开看热力图,只会记住那个红标。
谁该用,谁不该全信
先说适合的场景。媒体编辑部在核实读者投稿、辟谣团队在追踪一张疯传图片的来源、电商和租房平台在审核商家图片、学校和企业在处理疑似 AI 造假的材料,这些场景里 Pangram 这类工具可以当第一道筛子:先跑一遍,标出可疑区域,再由人工去核实原图、拍摄信息和上下文。它最大的价值是省时间、指方向,而不是一锤定音。
再说不适合全信的场景。任何涉及对个人下判断的场合都不应该只凭检测结果定性,比如指控某人用 AI 伪造证据、认定某位摄影师的作品是生成的、因为一张图就封掉一个账号。检测分数不是法庭证据,热力图也不是鉴定书。厂商自己也在博客里留了口子,低分辨率要加提示、视频要逐帧看,这些限定条件本身就是提醒:工具的结论是有适用范围的,超出范围使用,责任在使用者不在工具。
还有一个现实问题是价格和门槛。据 Engadget 报道,新检测能力面向 Pangram 的订阅用户开放。也就是说普通用户想随手查一张图,可能要先过付费墙。这一点不算缺点,但会影响它的实际覆盖面:最需要辨别能力的人,往往也是最不愿意为一次查询付费的人。如果检测能力只掌握在机构手里,普通用户在信息流里依然只能凭感觉判断,假图的传播优势并不会因此消失。
给 vibe 开发者的一点启示
对做产品的独立开发者来说,Pangram 这次发布还有一层借鉴意义。很多人做 AI 功能时,习惯把模型输出包装成一个干净利落的结论:是或者不是、通过或者不通过。但 Pangram 相对高明的地方在于,它把不确定性做进了产品界面:热力图是“哪里可疑”,低置信度提示是“这次我不太确定”。这种设计不是示弱,而是把判断权的一部分还给用户。对 vibe 项目尤其如此,因为你的用户往往没有专业背景,他们需要的不是一个更武断的 AI,而是一个更诚实的 AI:告诉我你看到了什么、你有多大把握、我接下来该去核实什么。
最后一句话总结。Pangram Image 1.0 和 Flash 1.0 的发布,标志着 AI 检测从文字单点走向图文视频全覆盖,热力图和低置信度提示是这次发布里最实在的进步。但所有准确率数字目前都来自厂商自报和自建测试集,99.96%、98.7%、99.2% 这些数字应当被当作“厂商声称、尚待第三方复现”的成绩单来读,而不是当作已经盖棺定论的事实。检测工具的终点不是替人做判断,而是帮人更好地做判断,这一点 Pangram 至少在产品形态上走对了方向,剩下的要看独立评测和真实信息流里的表现。
和上一代检测工具比,变化到底在哪里
很多人会问,市面上不是早就有很多 AI 检测工具了吗,Pangram 这次有什么不一样。区别主要在三个地方。第一,上一代工具大多只给一个总分,告诉你这张图有百分之多少的概率是 AI 生成的,但不告诉你概率来自哪里。用户拿到分数之后没法追问,也没法验证,只能选择相信或者不相信。热力图改变了这个局面,它把分数拆解到了像素区域,让结论变得可以讨论。第二,上一代工具对输入质量的要求往往藏在小字里,用户传了一张被压缩过的小图,工具照样给出一个很确定的分数,事后才发现这个分数根本站不住脚。Pangram 把低分辨率的限制摆到台面上,并且用提示语明确降级,这是一种产品层面的诚实。第三,视频检测从“抽几帧看看”变成了逐帧分析,这对付那种只在个别帧里动过手脚的视频尤其重要,因为造假者早就学会了只改关键帧、其余帧保持真实,来骗过抽查式的检测。
但也要看到,这些进步并没有解决检测行业最根本的难题,那就是生成器和检测器之间的军备竞赛。生成器每升级一次,检测器就要重新学习一次,而检测器的测试集永远追不上生成器的更新速度。今天在 12 个生成器上测出 99.96%,不代表下个月新出的第 13 个生成器也能测准。厂商在博客里列出的学术基准,某种程度上也是在给自己留后路:学术基准是公开的、可复现的,第三方可以拿同样的卷子再考一次。真正值得期待的,是接下来几个月里有没有独立机构用公开基准和真实信息流数据对 Pangram Image 1.0 做一次复测。如果复测成绩和官方数字差距不大,那这款工具才算真正站住了;如果差距很大,那官方数字就只能当作广告来读。
接下来要盯的三件事
第一件事是误报率在真实场景里的表现。实验室里的 0.27% 误报率听起来很低,但放到每天上亿张图片的信息流里,0.27% 就是一个不小的绝对数字。而且误报不是均匀分布的,它往往集中在某些特定类型的真实照片上,比如计算摄影味道很重的手机照片、经过重度后期的商业摄影、夜景和弱光照片。Pangram 曾经因为 iPhone 照片误报而推迟发布,这说明团队意识到了这个问题,但一次修复不等于一劳永逸,后续的误报案例值得持续观察。
第二件事是视频检测的实际体验。逐帧分析听起来很彻底,但代价是计算量和等待时间。用户上传一段几分钟的视频,要等多久才能拿到结果,结果又是以什么形式呈现的,是整段视频一个分数,还是时间轴上标出哪几秒可疑,这些产品细节官方博客并没有展开讲。对普通用户来说,视频检测的可用性很大程度上取决于这条时间轴做得好不好用。如果只能得到一个总分,那视频检测和图片检测相比并没有本质进步;如果能像热力图一样标出可疑片段,那才是真正的进步。
第三件事是检测结果会不会被平台真正用起来。Chrome 插件的设想很好,但插件的覆盖面取决于用户愿不愿意装、平台愿不愿意接。如果只有 Pangram 自己的用户在用,假图在其他渠道的传播并不会减速。更值得期待的方向是平台方把检测能力接进审核流程,或者媒体机构把它作为核实工具链的一环。检测工具的价值从来不只取决于模型本身,还取决于它在信息传播链条里处在什么位置。处在事后辟谣的位置,只能减少伤害;处在事前审核的位置,才能预防伤害。Pangram 这次同时推了插件和 API,显然是想两头都占,成不成要看后续的合作进展。
评论 (0)
原始来源
相关文章
印度 Sarvam AI 于 11 月 3 日发布决策模型 Prism:不生成长文本,只在给定选项中打分,平均 71.8 分、44 毫秒响应,权重以 Apache 2.0 开源。它的真正卖点不是最聪明,而是校准可靠、顺序稳定,适合塞进自动化链路里做判断层。
腾讯 11 月 4 日正式发布 Hy4 完整版,补上视觉理解和电脑操作两块短板,价格与预览版持平。但完整版权重尚未公开下载,今天的 Hy4 首先是一个托管服务,而非可本地部署的开源模型。
Google 11 月 3 日宣布 Guided Learning 进入搜索试点与 Classroom 全球上线,同时 Gemini、Gemini Notebook、Gemini in Classroom 与搜索在 K-12 学生账号上默认全部关闭、等待管理员明确打开。但搜索与 AI 深度绑定,拒绝 AI 的学校也将失去学生搜索入口。