Recursive 开源 Flint:笔记本能跑的代码模型,而且是“AI 造出来的”
Recursive 发布首个模型 Flint:免费代码模型,普通笔记本可跑,Apache 2.0 开源、Hugging Face 可下载。MoE 架构 40B 总参数、每次推理只激活 2.5B;厂商自测 M4 Pro 上约 131 tokens/秒,约为同机 Gemma 4、Nemotron 3.5 Lightning 的两倍(第三方尚未独立验证)。SWE-Bench Verified 上 50B 以内分组第一(厂商说法),Wired 第三方实测每次都一次做对。最大看点是过程:自动化研究系统 Eureka Machine 参与预训练到推理几乎每一步,不到 4 个月从零做出—“AI 造 AI”第一次有了可下载的公开实验品。
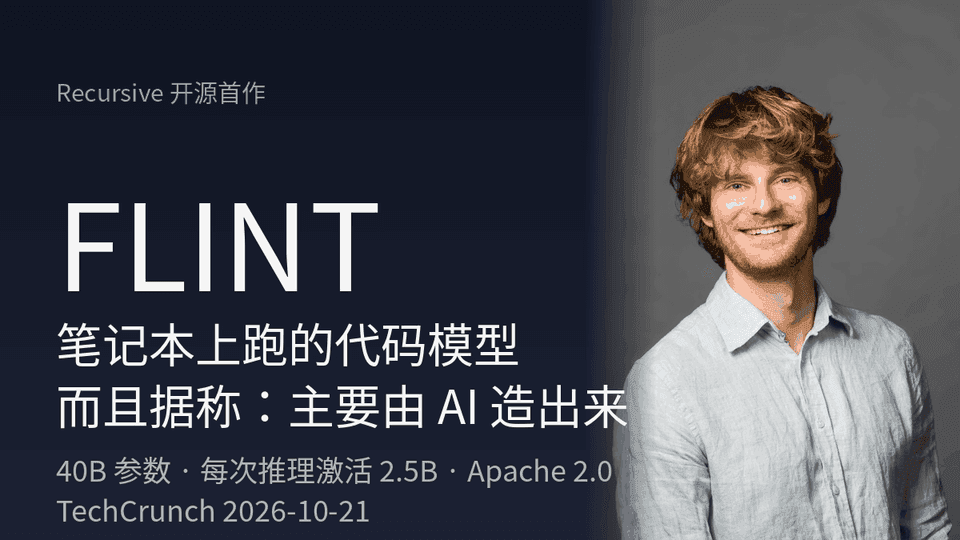
一句话:400 亿参数的模型,干活时只"动用"25 亿——所以笔记本跑得动了
2026 年 10 月 21 日,TechCrunch 报道了 AI 创业公司 Recursive 的首个模型 Flint:一款免费的代码模型,能在普通笔记本上跑,Apache 2.0 协议开源,权重已上架 Hugging Face。它的 headline 数字是:总参数 400 亿(40B),但混合专家(MoE)架构让它每次推理只激活 25 亿(2.5B)参数——大约只动用自身的 6.25%。作为参照,Meta 上周发布的 Muse Spark Open 用了 8160 亿参数,需要至少 1TB 内存。Flint 的策略恰好反过来:不拼大,拼"每次只用一小撮"。这篇报道的日期已由撰稿人于 2026 年 10 月 22 日亲开 TechCrunch 原文二次确认(页面标注 Published: 2026-10-21T20:27:41+00:00,Updated: 2026-10-22T01:02:45+00:00,无变化);Recursive 官方发布的《Introducing Flint》公告页(recursive.com/updates/introducing-recursive-flint)为本文的厂商一手补充源,下文凡"官方说"均出自该公告页,凡"据报道"均出自 TechCrunch。
但 Flint 真正值得读的不是参数表,而是它的出身:Recursive 说,这个模型从预训练、后训练到推理优化,几乎每一步都有自家自动化研究系统"Eureka Machine"的参与,一个小团队不到 4 个月从零把它做出来。换句话说,这是"AI 造 AI"这个争论了多年的想法,第一次交出了一件你可以下载、装进笔记本、离线运行的公开实验品。模型免费,噱头却不免费——本文会把厂商自报的数字和第三方实测分开标清楚,再谈它到底值不值得你装。
数字先行:2.5B / 40B 的 MoE,赌的是"激活参数"这个指标
先把 Flint 的技术画像摆出来,全部来自厂商一手口径。Flint 是混合专家(MoE)模型:40B 总参数,每 token 只激活 2.5B。官方公告里还披露了架构搜索的起点——Eureka Machine 从 35B 总参数 / 3B 激活参数的基线出发,试了多种专家配置和宽度组合,最终定格在 40B / 2.5B,理由是这是"速度和代码能力组合最优"的点。注意这个表述:优化目标函数里,速度和本地硬件吞吐是和基准分数并列的,这和"榜单刷分优先"的训练哲学是两条路。
官方给的性能定位是:在总参数 50B 以内的 MoE 模型里,Flint 在 agentic coding 基准(SWE-Bench Pro v2、Terminal-Bench 2.1、SWE-Bench Verified)上领先;同时能和 25–40B 的稠密模型拼代码分数,速度却快 5 倍以上。后半句的"快 5 倍"锚定的是"分数相近的稠密模型",不是全行业,这个限定词别丢了。
再说说"能在笔记本上跑"到底意味着什么。官方说 Flint 的权重在 Hugging Face 上以 Apache 2.0 协议发布,支持 llama.cpp、Ollama、Unsloth、LM Studio、vLLM、SGLang 等一串本地推理工具;还顺手开源了一个叫 rec 的轻量推理引擎,专门针对 M4 Pro 和 M5 Pro/Max 优化。上下文窗口标称最高 512k token,但官方建议写代码时待在 256k 以内效果最好——这个"标称 vs 建议"的落差很诚实,也值得记下来:长上下文数字好看,实用区间是另一回事。
速度数字:131 tokens/秒,约为同机竞品两倍——但这是厂商自测
速度是 Flint 宣传里最抓眼球的一组数字,必须先把归属说死:以下全部是 Recursive 的厂商自测,第三方尚未独立验证。官方口径:在 MacBook Pro(M4 Pro)上,Flint 生成速度超过 125 tokens/秒(TechCrunch 引述的数字约为 131 tokens/秒);在 64GB 显存的 Nvidia RTX Spark 上,短上下文下超过 150 tokens/秒。作为对比,同一台 M4 Pro 上的 Google Gemma 4 和 Nvidia Nemotron 3.5 Lightning 跑出 58–69 tokens/秒——Flint 宣称达到约两倍。官方还补了一句"在 Apple Silicon 和 RTX Spark 上达到同类模型两倍"。

对这组数字该怎么读?先给结论:方向可信,绝对值打折听。MoE 每 token 只激活 2.5B 参数 + 低比特量化 + 定制 kernel,三者叠加确实会带来显著的吞吐优势——"快不少"这个方向大概率成立。但 131 这个精确数字来自厂商自己的测试 harness(采样参数 temperature 1.0、top-p 0.95、top-k 20,128k token 会话平均,prefill 不计),换到你的 prompt、你的温度、你的上下文长度,结果一定会动。看厂商速度数字的正确姿势是看"量级和倍数关系",不是背"131"这个整数。
还有一个细节值得玩味:官方强调"短上下文下"超 150 tok/s。推理速度随上下文变长是会掉的,厂商主动加了"短上下文"这个定语,反而说明数字是挑过条件的——诚实,但你要知道条件是什么。
准不准:SWE-Bench Verified 上 <500 亿参数第一——同样是厂商说法
准确性这边,归属同样要先说死:以下均为厂商说法。TechCrunch 引述:在 SWE-Bench Verified(测 AI 修真实软件 bug 的基准)上,Flint 超过了其他 500 亿参数以下的模型;在 Recursive 自家"6 项测试平均分"里,只有阿里的 Qwen3.8 27B 排在 Flint 前面。官方公告的表述更细:领先的是"50B 以内 MoE"这个分组,测试集包括 SWE-Bench Pro v2、Terminal-Bench 2.1 和 SWE-Bench Verified,还给了采样细节(agentic 评测 agent 超时最长 5 小时、至少 5 次取平均 pass@1)。
这里有两个解读要点。第一,"50B 以内 MoE 第一"是一个精心选择的分组冠军——分组越细,冠军越多。Flint 真实的对标物是"25–40B 稠密模型"那一档,官方自己也承认"rival"(匹敌)而非"beat"。第二,"自家 6 项测试平均"这种榜单,测试集是厂商自己挑的,Qwen3.8 27B 能排第一恰恰说明这个平均分不是为 Flint 量身定制的——这反而给了一点可信度:一个完全自嗨的榜单通常会把自家模型放在唯一的第一名。
所以真正给 Flint 准确性背书的,其实是第三方那一票:Wired 的 Will Knight 在一台 48GB 内存的 Mac 上实测了 Flint,做了几个小程序——一个 to-do 应用和一个联网搜集资料的研究工具。他的结论是:小代码模型经常出错或比 Claude、Codex 慢,但 Flint"每次都一次做对"(nailed his coding requests every time)。这是目前公开报道里唯一的第三方实测。样本很小(几个小程序、一台机器、一个人),但它验证的是厂商数字验证不了的东西:真实任务里"能不能一次干成"。对独立开发者来说,这个信号比榜单分数实在。
真正的噱头不在模型,在"造模型的过程":Eureka Machine
Flint 的参数和速度,坦白说,在 2026 年的模型发布里都不算颠覆性。真正让这条新闻值得占一个版面的,是 Recursive 讲的"怎么造出来"的故事。公司的自动化研究系统 Eureka Machine,据称参与了 Flint 模型构建栈的几乎每一个环节:数据、优化器、训练配方、基础设施、推理优化。官方的描述是:它自动跑完"提想法—实现—做实验—用结果决定下一步"的完整研究循环,多个方向并行探索,在早期实验的基础上组合有潜力的想法。一个"人和 agent 组成的小团队",不到 4 个月从零做出了 Flint。
具体贡献有三块,官方公告写得相当细,值得展开:第一,架构。前面提过,从 35B/3B 基线搜索到 40B/2.5B 定稿,是 Eureka Machine 跑专家配置搜索跑出来的,不是人拍脑袋定的。第二,量化。这是最有"机器研究员"味道的一段:Eureka 反常识地把输出层(lm_head)也量化到了 4 bit——因为 Flint 每次只激活 2.5B 参数,输出层在每 token 读取的权重里占比很大,不压它不行;为补回精度,它加了一个离线蒸馏阶段,让量化后的模型用 16 位教师模型在"自发现的核心集"上重训。结果:最终的 NVFP4 模型和 16 位版本在基准上只差 0.7 分以内,训练步数还比量化感知训练基线少了一半。TechCrunch 的转述是"低比特训练把体积缩小 71%、质量几乎无损"——两个口径对得上。第三,kernel。Eureka 为低比特投影、MoE 算子、注意力、prompt 处理写了专用 kernel,在 M4/M5 芯片上甚至搞了一个 Metal megakernel,把整个解码前向融合成一个 kernel。
读到这里应该能品出 Recursive 的叙事策略:Flint 本体是"开胃菜",Eureka Machine 才是"主菜"。模型的每一处工程亮点都被用来论证"自动化研究系统真的在干研究员的活"。这套叙事能不能成立,取决于一个公司没回答的问题:Eureka 到底替研究员省了多少时间?TechCrunch 原文明确写了——Recursive 没说。作为参照,OpenAI 上个月说过,到 8 月中旬,自家 AI agent 的产出相当于每 1 个人类研究员工作日对应 3.1 个 agent 工作日。两家都在讲"agent 做研究"的故事,但都没给出"人时到底省了多少"的硬数字。在硬数字出现之前,"AI 造 AI"的进度条该打几折,每个人自己判断。
观点:两条线,恰好都踩中独立开发者的痛点
抛开叙事,Flint 对 vibe coding 读者的价值其实很实在,分两条线。第一条线是离线/隐私/无账单。模型跑在你自己的机器上,代码不出本机——对处理私有仓库、客户代码的人来说,这是云端 API 给不了的;没有按 token 计费的账单,对每天高频调用的独立开发者,这是真金白银。官方原话说得直白:离线工作、数据留在自己电脑上、避开 API 费用。这三件事单独看都不性感,合在一起就是"本地小模型"的全部存在理由。
还有一个容易被低估的点:Apache 2.0 协议。这意味着 Flint 不只是"能下载",而是"能商用、能魔改、能拿去蒸馏"。独立开发者可以把它微调成自己代码风格的专属模型,可以把它塞进离线交付的产品里,可以基于它做二次开发而不必看厂商脸色。在"开源权重"越来越成为营销话术的今天(很多所谓开源模型附带各种商用限制),一个干净的 Apache 2.0 本身就是一种态度。协议选得大方,往往说明公司对"靠模型本体赚钱"没兴趣——Recursive 想卖的从来不是 Flint 这个模型,而是"Eureka Machine 能持续造出 Flint"这件事。
第二条线是"AI 造 AI"第一次有了可下载的公开实验品。recursive self-improvement(递归自我改进)这个想法在行业里争论了很久:AI 造出更好的 AI,更好的 AI 再造出更好的——有人觉得这是通向超级智能的路,有人担心它滑出人类控制。Recursive 的版本目前很克制:TechCrunch 写得很清楚,现在的形态是"由人监督的 AI 研究助理"造出了一个"小到能装进笔记本"的模型;Socher 对 Wired 说的长期目标才是"人类监督、可随时叫停"的完全递归自我改进。Flint 的意义不在于它证明了递归自我改进,而在于它把这场争论从论文和播客里拽出来,变成了一个你可以 ollama pull 的东西。争论可以继续,但现在多了一个实物证据。
我的判断是:Flint 更像一个"宣言式产品"——它的首要任务不是打榜,而是向市场证明"Recursive 这家公司能交付"。6.5 亿美元融资、46.5 亿美元估值(GV、Nvidia、AMD Ventures 在 5 月出隐身时给的),6 月又和 AWS 签了 4.1 亿美元的算力协议,CEO 说那笔交易"与其说是为了招人,不如说是为了堆 agent 数量"(less about headcount and more about agent count)。一家拿了这么多钱、all-in"agent 做研究"的公司,第一件交付物必须是一个"能跑、能下、能用"的东西——Flint 就是。至于它能不能在代码能力上长期立足,那是下一款模型的事。
诚实的一面:厂商没说的,和官方自己承认的短板
先说官方自己承认的短板,写在公告页"Running Flint"章节,值得原文转述:复杂任务请拆成小子任务、给明确指令——"它可能比你习惯的大型闭源代码模型需要更多引导"(it may need more guidance than the larger closed-source coding models you're used to)。TechCrunch 的转述也一样:公司承认 Flint 需要比付费大助手更多的手把手指导,建议把大任务拆小。这是小模型的诚实税:参数少、激活少,意味着"意会"能力弱,你得把任务切得更碎、指令写得更 explicit。Wired 的 Will Knight"每次都一次做对"的前提,也是"几个小程序"这个量级——to-do 应用和资料搜集工具,不是重构十万行祖传代码。
再说厂商没说的。第一,Eureka 到底省了多少研究员时间——没说,"不到 4 个月"听起来很快,但没有基线对比(同样的小团队不用 Eureka 要多久?),这个数字目前只是气氛组。第二,131 tok/s 的测试条件(温度 1.0、top-p 0.95、128k 会话平均)离真实编码场景有多远——温度 1.0 是偏发散的采样,实际写代码你多半用更低的温度,速度数字会动。第三,长期维护:权重开源了,rec 引擎开源了,但 Eureka Machine 本体显然不会开源——"AI 造 AI"的核心资产仍然锁在公司里。你能下载的是实验品,不是实验方法。
把这三条摆出来不是为了挑刺,而是给读者一个校准:Flint 是一个"可以用"的本地代码模型,不是一个"用了就回不去"的革命。它最大的历史价值可能是作为参照系——以后每家讲"AI 造 AI"故事的公司,都要先回答:你的东西能不能像 Flint 一样,被人下载、跑起来、独立验证?
背景速览:Recursive 是谁
Recursive 2026 年 5 月出隐身,一出来就拿了 6.5 亿美元融资、估值 46.5 亿美元,投资方包括 GV、Nvidia 和 AMD Ventures——这个数字在"模型公司"赛道里不算夸张,但在"还没发布任何东西的公司"里算出手阔绰的。CEO 是 Richard Socher,Salesforce 前首席科学家,NLP 圈的老面孔。6 月,公司和 AWS 签了 4.1 亿美元的算力协议,官方当时的表述是"less about headcount and more about agent count"——钱花在算力上,不是 headcount 上。这句话现在回头看,就是 Flint 发布这篇新闻的注脚:一家把"堆 agent"写进算力协议的公司,第一个交出来的模型由 agent 深度参与建造,叙事是自洽的。
需要提醒的是时间线:5 月出隐身,10 月 21 日发布 Flint,中间 5 个月。官方说"从零开始不到 4 个月",和公开时间线基本吻合(有一部分时间花在融资和组队上,很合理)。
给读者的判断:本地小模型"到底能不能干活",怎么验
最后落到实操。如果你被这篇新闻种草,想亲自验一下"本地小模型到底能不能干活",建议按这个顺序来,别一上来就拿它重构生产代码:
1. 先定你的验收标准,再下载。Flint 的官方定位是"日常代码模型"(daily coding model),不是"最强代码模型"。验收任务应该是你每天真实干的事:写个脚本、补个测试、给函数加注释、把一段代码翻译成另一种语言。别用"它能不能过 SWE-Bench"来验收——那是厂商的战场,不是你的。
2. 从小任务开始,呼应官方的诚实建议。官方让你拆小任务、给明确指令,那就照做:一次只让它干一件事,指令写具体。Wired 实测"每次都一次做对"的任务量级(to-do 应用、资料搜集工具)就是很好的起点。
3. 温度别照抄厂商。厂商测速度用 temperature 1.0,你写代码时降到 0.2–0.3,看准确率和速度的实际 trade-off。记住:你复现的永远是"你自己的数字",不是"131"。
4. 算一笔你自己的账。本地跑没有 token 账单,但有电费、风扇噪音和"等它生成"的时间。对比项应该是"你现在为代码补全/对话付的月费",而不是"它和 Claude 谁更强"——这是两个维度的比较,混在一起会得出错误的结论。
5. 关注生态位,不追榜单。Flint 的真正竞品不是 Claude Code 或 Codex,而是 Gemma 4、Nemotron 3.5 Lightning 这些"同机可跑"的小模型。它的战场在"你的笔记本里",不在云端。
一句话收束:Flint 未必是你明天的默认代码模型,但它很可能是"AI 造出来的、能装进笔记本的第一个像样模型"——而"能下载、能跑、能独立验证",恰恰是"AI 造 AI"这个宏大叙事最缺的东西。一个可以下载的宣言,胜过十篇关于未来的论文。先把它装起来,跑一跑,再决定要不要相信 Recursive 的故事——顺序别反了。
评论 (0)
原始来源
相关文章
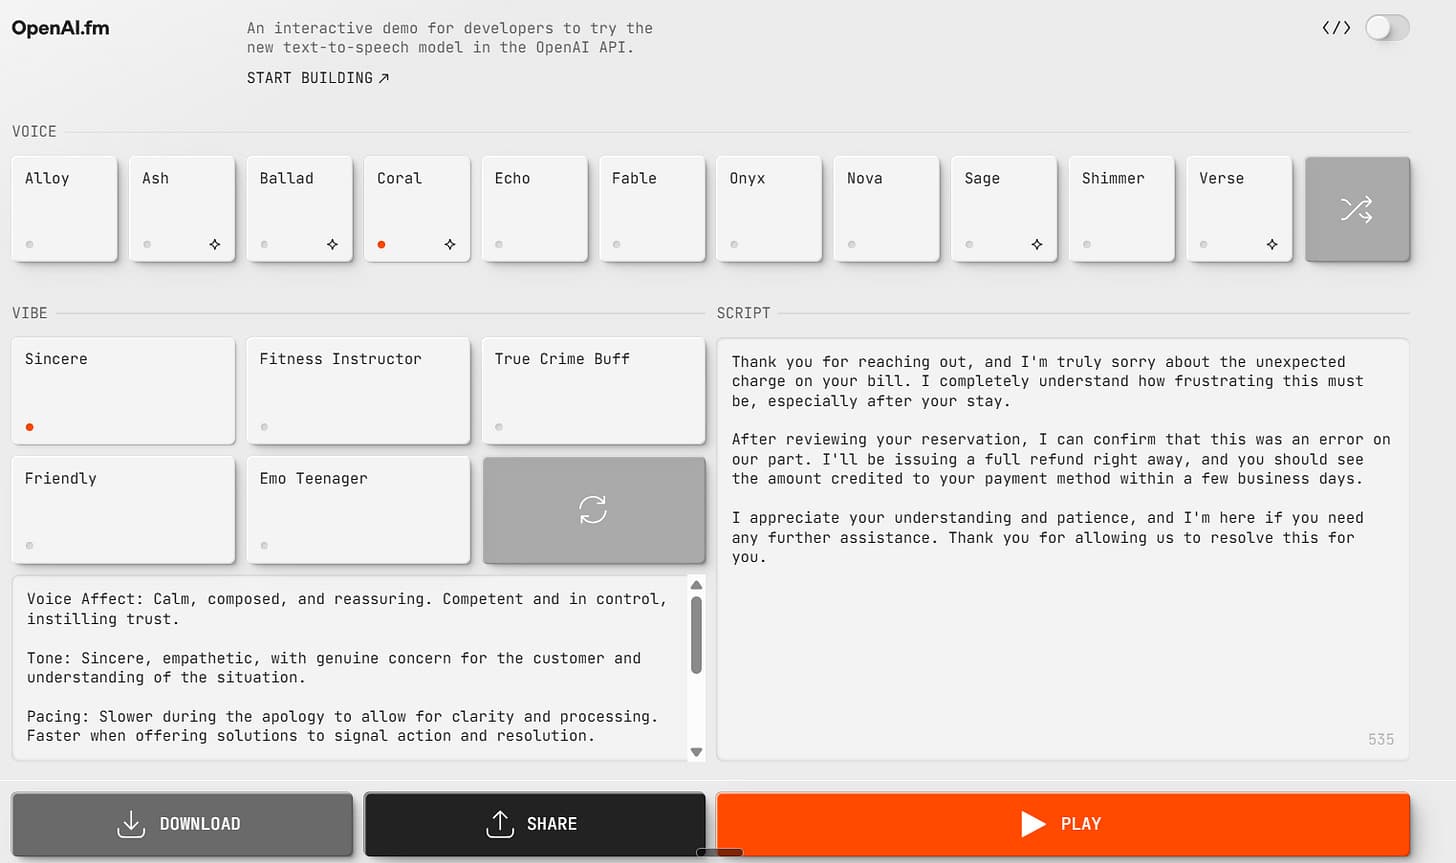
OpenAI 10 月 12–16 日面向开发者的三连更新:10-12 Agents API 支持沙箱预热(创建 environment、等 ready、创建 session 时传 environment_id;预热免费,但未挂载沙箱 5 分钟过期);10-15 GPT-Live 原生集成 Decisions API,可在通话人还没说完时触发结构化决策;10-16 上线 prompt-to-voice——一句话描述生成可复用的 GPT-Live 定制音色,创建免费、通话按正常费率计费,并新增德/法/印地/日/韩 9 个预置声音。边界:提示词生成的音色只能用于 GPT-Live,每组织上限 100 个,且须向用户披露是 AI 声音。
2026 年 10 月 21 日 Anthropic 官宣 Claude Duet 进入研究预览:每天晨间简报、白天每隔几小时检查已连接应用,发送付款签名删除前必须展示原稿等你确认,但证券交易和账户转账即使批准也不做。底层 Claude Opus 5.5,独立云端虚拟机加浏览器,你关机它照样跑。最值得细读的一句:Anthropic 选“几小时查一次”而非实时监控,理由是持续检查会更快烧光 Pro/Max 额度——这是独立开发者做常驻 agent 最真实的成本参照。
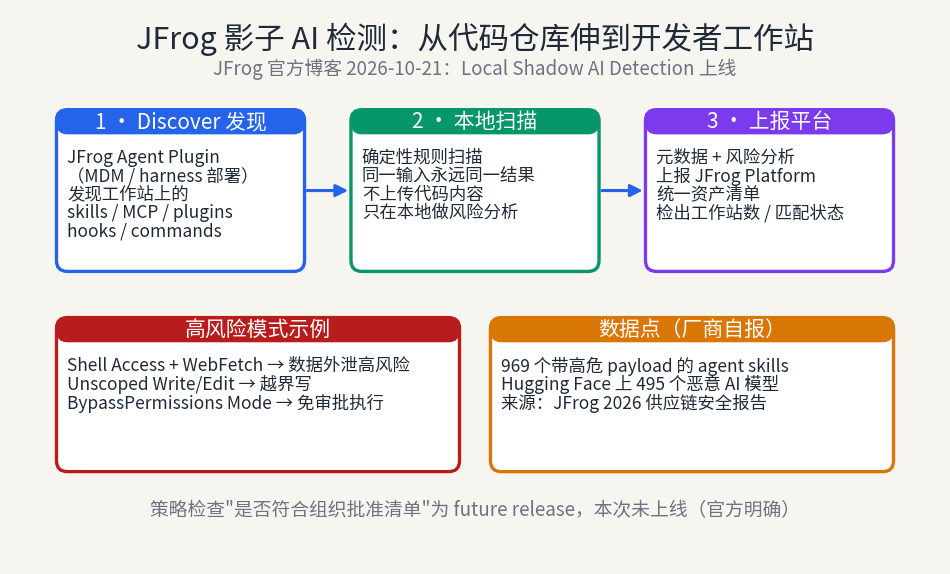
JFrog 把影子 AI 检测从仓库延伸到开发者工作站:Agent Plugin 发现笔记本上的 skills、MCP servers、hooks 等未注册 AI 资产,本地确定性扫描后上报统一清单。但“是否符合批准清单”的策略检查还在 future release——现在看得见,拦不住。个人开发者也该给自己做一份 skill 资产清单。