Simon Willison 一个 prompt 让 Claude 花 3 小时做了款游戏:“保证好玩”这句指令出奇地管用
10 月 14 日,Simon Willison 在 iPhone Claude app 的 chat 模式里给 Claude Opus 5.5 Max 发了一个 prompt;3 小时 7 分钟单次推理后,交出来一款带音乐、动画、成就系统的可玩 cozy 找不同游戏。他的评价:告诉模型“保证好玩”,出奇地管用。
先划一条界:Simon Willison 在 10 月 15 日(第二天)又做了一个双人对战实验——两台手机用麦克风音频传游戏状态的 pong 类游戏。那是另一个事件,本篇不写,只写 10 月 14 日的 "Tree appreciator"。两个实验可以互相印证"单 prompt 做游戏不是运气",但主线是 10-14 这一篇,避免分量稀释。
2026 年 10 月 14 日,Simon Willison 在个人博客发了一篇 "Another game experiment with Claude"。故事很短:他在 iPhone 上打开默认的 Claude app(注意:是 chat 模式,不是 Claude Code),给 Claude Opus 5.5 Max 发了一个 prompt。Claude 想了 3 小时 7 分钟,交出来一款可玩的 cozy 找不同游戏——带音乐、带动画、带成就系统。
Willison 自己对这件事的评价只有一句话,但信息量极大:告诉 Opus 5.5 "make sure it is fun"(保证好玩),"works uncomfortably well"(出奇地管用)——而且他承认,这话说起来 "somewhat embarrassingly given my recent talk"(考虑到我最近刚做过一场技术演讲,有点不好意思)。
为什么这条新闻值得写 4000 字?因为它是 vibe coding 方法论的一次"名人实证"。Willison 不是普通用户——他是 Django 联合创始人、常年研究 LLM 应用的独立开发者,他的一场技术演讲刚讲过"相反/相关"的观点,转头就被自己的实验证明"情绪类指令比技术规格管用"。这种"打脸式实证",比十篇教程都有说服力。
先看 prompt:一个段落,三层意思
prompt 全文引用如下(事实性引用,来自博客原文):
Build a three js game called "Tree appreciator" - it shows you two algorithmically generated trees and the game mechanics is about appreciating the differences between them. Think hard about how to make sure it is both fun and beautiful.拆开看,这个 prompt 有三层:
- 第一层:做什么(what)。"Build a three js game called 'Tree appreciator'"——技术栈(three.js)、名字(Tree appreciator),一句话交代清楚。没有写"用 React 还是 Vue""状态管理怎么做"——这些细节,全部交给模型。
- 第二层:核心机制(mechanics)。"it shows you two algorithmically generated trees and the game mechanics is about appreciating the differences between them"——两棵算法生成的树,玩法是"欣赏它们的不同"。注意他没有说"做一个找不同游戏,得分规则是 X,关卡是 Y"——他只给了"机制的方向",没给"机制的细节"。
- 第三层:质量标准(bar)。"Think hard about how to make sure it is both fun and beautiful"——好好想想,怎么保证它又好玩又好看。这是整段 prompt 的灵魂:没有技术规格,只有一句体验要求。
三层加起来不到 40 个词。没有用户故事、没有验收标准、没有技术约束——按传统软件工程的标准,这份"需求文档"是不合格的。但它恰恰是 vibe coding 时代最有效的 prompt 形状:方向给足,细节放手,标准给到体验层。
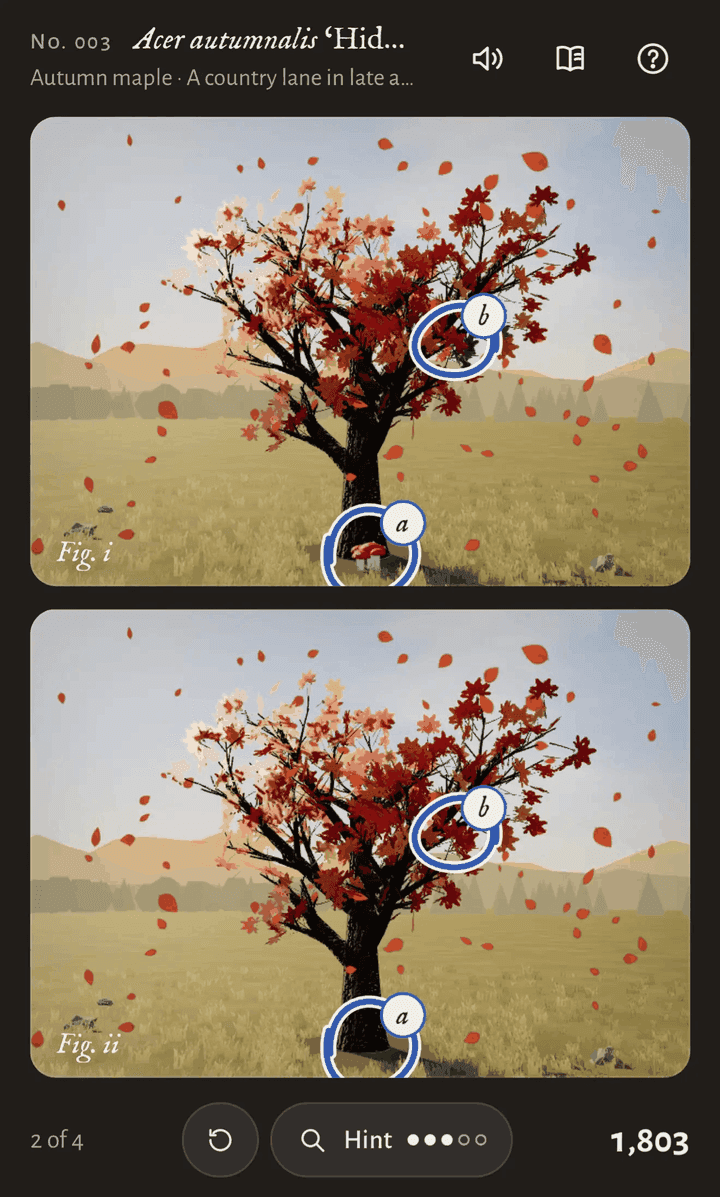
 Willison 博客原图:Tree Appreciator 找不同游戏实机截图,两棵秋枫、已找出的不同用蓝圈标出
"保证好玩"为什么管用:体验指令 vs 技术规格
Willison 的原话值得再读一遍:telling Opus 5.5 "make sure it is fun" works "uncomfortably well"。翻译成大白话:你跟模型说"保证好玩",它真的会往"好玩"的方向使劲,而且效果好到让 Willison 有点不好意思——因为他刚在技术演讲里讲过"相反/相关"的观点(博客没展开演讲内容,但"somewhat embarrassingly"这个自嘲说明,演讲里他大概是不看好这种"玄学指令"的)。
为什么"保证好玩"这种听起来很虚的指令,反而比"实现 A、B、C 三个功能"更管用?想深一层:
- 1. "好玩"是一个高维目标,模型比人更知道怎么拆。人写技术规格,是把"好玩"拆成"得分系统+关卡+音效"再喂给模型;但人拆的维度是有限的(你想到的就那几样)。模型在训练时见过成千上万个"好玩的游戏",它对"好玩"的理解是分布式的——"think hard about fun"等于让模型自己从分布里采样最优解,而不是按人给的低维规格执行。
- 2. 技术规格是"天花板",体验指令是"地板"。你写"实现得分系统",模型就实现一个得分系统——不多不少。但你说"保证好玩",模型会自己决定"要不要得分系统、要不要成就系统、要不要音乐"——成品里出现的音乐、动画、成就系统,没有一个是 prompt 里点名要的,全是模型为了"好玩"自己加的。体验指令给了模型"加戏"的许可。
- 3. "Think hard"是关键修饰语。prompt 里不是只说"make it fun",而是"think hard about how to make sure it is both fun and beautiful"。"Think hard"等于告诉模型:这个问题值得你花推理预算。配合 3 小时 7 分钟的单次推理,模型是真的"想"了很久——体验类目标需要长推理来展开,短平快的回答给不出"好玩"。
对 vibe 开发者:这是一条可以直接用的 prompt 心法。以后做任何"给人用的东西"(小游戏、小工具、landing page),在 prompt 最后加一句体验层的要求:"好好想想怎么让它好玩/好看/好用"。别只写功能清单——功能清单是天花板,体验要求才是让模型超预期的钥匙。Willison 用一场"打脸式实证"替你验证了:这句管用,而且管用到让他不好意思。
工具选择:最不像开发工具的工具
第二个反直觉的点:Willison 没用 Claude Code,用的是 iPhone 上默认 Claude app 的 chat 模式。
Claude Code 是 agent 模式:能读写文件、跑命令、装依赖,是"干活"的工具。iPhone app 的 chat 模式是"聊天"的工具:你说话,它回答,最多给你一段代码或一个文件。按直觉,做游戏这种"工程活"应该用 Claude Code——但 Willison 偏偏用了 chat 模式,而且做出来了。
这个选择说明了一件事:当 prompt 足够好、模型推理足够长的时候,"工具"的形态不重要了。chat 模式没有文件系统、没有终端,但它有 3 小时 7 分钟的推理时间——模型在这段时间里,把游戏的每一行代码、每一个资源、每一个交互都在"脑子里"想清楚了,一次交卷。工具提供的"执行能力"(跑代码、看报错、迭代),被"一次想清楚"部分替代了。
对 vibe 开发者:别再纠结"用哪个工具"了。工具的差异(Claude Code vs chat app vs 网页版),远小于 prompt 的差异和推理时长的差异。Willison 的实验把变量控制得很干净:工具是最弱的(手机 chat),prompt 是精心设计的,推理是最长的(3 小时 7 分钟)——结果是最好的。这个对照实验的结论是:prompt × 推理时长,远大于工具形态。
3 小时 7 分钟:单次长推理的胜利
第三个值得放大的数字:3 小时 7 分钟,单次推理。
注意是"单次":不是"聊了 3 小时、迭代了 20 轮",是 prompt 发出去之后,模型一次想了 3 小时 7 分钟,然后交卷。产出是什么?一款可玩的 cozy 找不同游戏:两棵算法生成的树(呼应 prompt 里的 "algorithmically generated"),找不同的玩法,带音乐、带动画、带成就系统。博客截图显示:关卡名 "No. 003 Acer autumnalis"(第 3 关,秋枫),计分 1,803,Hint 点数机制(用掉提示扣点)。
从截图还能读出更多信息:游戏界面是深色主题,两棵树上下排列(Fig. i / Fig. ii),找出的不同用蓝色圆圈标出(截图里圈出了树干基部的小红蘑菇和树冠右侧的一片绿叶)。"Acer autumnalis"是虚构的枫树拉丁名——模型连"给每一关的树起个植物学名字"这种细节都想到了,还配了英文副标题 "Autumn maple · A country lane in late a…"。成就系统、关卡命名、植物学梗,这些全是模型自己加的"戏",prompt 里一个字没提。
细读截图:一款"cozy 游戏"该有的样子
博客截图值得逐像素解读,因为它是"好玩"这个抽象指令的具象答案:
- 深色主题 + 暖色树叶:深色背景配红、橙、蜜桃色的枫叶,落叶动画飘在空中——"beautiful"那一半的要求,模型用配色和粒子效果回答了。cozy 游戏的视觉公式(暗背景+暖主体+动态粒子)被它无师自通了。
- 双图上下排列(Fig. i / Fig. ii):找不同游戏的经典布局,但模型加了"Fig."这种植物图鉴式的编号——呼应 "Tree appreciator"(赏树)这个名字,找不同被包装成了"植物标本对比",品味在线。
- 蓝色圆圈标出已找到的不同:树干基部的小红蘑菇(Fig. i 有、Fig. ii 无)、树冠右侧的一片绿叶(Fig. i 绿、Fig. ii 红)——不同的设计是"合理且隐蔽"的:蘑菇藏在树根处,叶色差异藏在满树红叶里,难度曲线是"第一眼看不出来、仔细看找得到",这是找不同游戏的核心手感。
- 底部栏:2 of 4、重置按钮、Hint(3 实 2 空的点数)、计分 1,803。完整的游戏循环:进度(2/4)、后悔药(重置)、付费提示(Hint 点数)、正反馈(分数)。一个 3 小时做出来的游戏,游戏循环是闭合的——这是"可玩"和"demo"的分水岭。
- 关卡命名 "No. 003 Acer autumnalis":虚构拉丁学名 + 编号,暗示"这是一个系列,每一关是一种树"。模型的世界观设计:赏树者手冊。成就系统(博客提到)大概率也是这个世界观的一部分。
把这些细节拼起来:模型交付的不只是一个"能跑的找不同",而是一个有世界观、有视觉语言、有完整游戏循环的作品。这就是 "think hard about fun and beautiful" 3 小时的产出——时间花在了"想"上,而不是"写"上。
这说明 Opus 5.5 级模型的"一次想清楚"能力,已经能撑起一个完整的小品:玩法、美术、音乐、成就、文案,一次成型。3 小时 7 分钟听起来很长,但对比一下:人类开发者做这样一款游戏要多久?两三天起步,还不一定有音乐和成就系统。单次长推理的性价比,在"小品级"作品上已经超过了"人类手搓"和"十轮短迭代"。
对 vibe 开发者:以后做小游戏、小工具,先别急着拆步骤、开多轮对话。试试"一个想清楚的长 prompt + 给足推理时间":把方向、机制、体验标准一次讲透,然后让模型慢慢想。十轮迭代的总时长可能更长、总 token 可能更多,效果还不一定更好。长推理不是"慢",是"一次把事想透"。
"算法生成的树":为什么这个细节重要
prompt 里有一个容易被忽略的技术要求:"two algorithmically generated trees"(两棵算法生成的树)。这不是随便写的——它决定了游戏的"可重玩性"。
如果两棵树是模型"画"出来的固定图片,那找不同玩一次就废了:不同点是固定的,背下来就没意思了。但"算法生成"意味着:每次开一局,树都是程序实时生成的,不同点也是随机布的——每一局都是新的一局。Willison 在 prompt 里埋的这六个词(algorithmically generated),是整款游戏"可重玩"的根基。
这个细节对 vibe 开发者是很好的 prompt 范例:关键的技术决策,要写进 prompt;非关键的实现细节,要留给模型。"树怎么生成"是关键决策(决定可重玩性),所以 Willison 点名了;"用什么随机算法、树长什么样"是非关键细节,所以他没写。prompt 的艺术就是区分这两类:点名关键的,放手非关键的。
实操:复制这个实验的四步清单
Willison 的实验是完全可复制的,四步:
- 1. 选一个"小品级"的目标。找不同、记忆翻牌、贪吃蛇变体——规模要小到"一次能想清楚"。别一上来就做 MMORPG,单次长推理有它的规模上限。
- 2. 写三层 prompt:方向 + 机制 + 体验标准。方向(一句话说什么)、机制(核心玩法是什么、不写细节)、体验标准("think hard about fun/beautiful/好用",点名要模型花推理预算)。
- 3. 把关键的技术决策点名写进去。像 "algorithmically generated" 这样,决定作品下限的决策不要留给运气。
- 4. 给足推理时间,一次交卷。别在模型想的时候去催、去打断。3 小时是 Willison 的实测,你的实验可能 1 小时也可能 5 小时——关键是"一次想透",而不是"分十次想"。
做完之后,对照 Willison 的截图自查:有没有世界观(关卡命名)?有没有完整的游戏循环(进度/提示/分数)?有没有模型自己加的"戏"(音乐/成就)?如果三样都有,说明你的 prompt 也触发了"体验指令"的杠杆。
 Willison 博客原图:Tree Appreciator 找不同游戏实机截图,两棵秋枫、已找出的不同用蓝圈标出
判断:vibe coding 方法论的三条实证结论
以下进入判断区,事实和观点分开标。
判断一:体验类指令是 prompt 的"高杠杆"部分。Willison 的实验证明,"make sure it is fun"这种指令的杠杆率极高:一句话,换来音乐+动画+成就系统+植物学命名一整套"加戏"。传统 prompt 教程教人"写清楚需求",Willison 的实证补上了另一半:"写清楚标准"。需求告诉模型"做什么",标准告诉模型"做到什么程度"。以后写 prompt,功能清单和体验标准要各占一半篇幅——甚至体验标准更重要,因为功能清单模型能推出来,标准推不出来。
判断二:"think hard"是 2026 年最重要的 prompt 修饰语之一。注意 Willison 的 prompt 里用的是 "Think hard about how to…",不是 "Make it fun"。前者是"分配推理预算"的指令,后者是"提要求"。2026 年的模型(Opus 5.5 级)已经能理解"这个问题值得多想一会",并真的把推理时间拉长到 3 小时。prompt 里的每一个词都在调参:"think hard"调的是推理深度,"fun and beautiful"调的是优化目标。vibe 开发者写 prompt,应该像调参一样遣词造句——每个词都有它的作用。
判断三:单次长推理正在替代"多轮短迭代",至少在小品级作品上。3 小时 7 分钟一次交卷,产出完整可玩的游戏。这个案例的颠覆性在于:它证明了"迭代"不是必需的。过去 vibe coding 的标准姿势是"小步快跑、多轮对话"——因为模型一次想不清楚,只能靠人肉 review + 多轮修正。但当模型能一次想 3 小时,它就不需要你陪跑了。未来的 vibe coding 可能会分化:小品级作品走"长 prompt + 长推理 + 一次交卷",大工程还是走"多轮迭代 + 人肉 review"。选哪条路线,取决于作品的规模,而不是习惯。
判断四:名人实证的价值在于"可复制性声明"。Willison 的博客最值钱的不是游戏本身(找不同游戏不稀奇),而是他作为"懂行的人"给出的可复制性声明:一个 prompt、手机 chat app、3 小时,你也可以。这和他 10 月 15 日的麦克风 pong 实验连起来(两个实验互相印证"不是运气"),构成了一组"单 prompt 做游戏"的方法论实证。对 vibe 开发者:下次有人质疑"AI 做出来的东西都是玩具",把这两篇博客甩过去——Willison 替你回答了。
还有什么没说
博客没提的:3 小时 7 分钟的推理,烧了多少 token、花了多少钱(Willison 没说,但本站之前发过他的硬预算上限论——他对花钱是很敏感的,这次没提金额,可能说明"在可接受范围内",也可能只是忘了写);游戏的代码有没有开源(博客只给了截图和 prompt,没给 repo 链接);"No. 003"说明至少有 3 关,更高关卡长什么样,博客没展开。
还有一个值得追的问题:Willison 说 "make sure it is fun" works "uncomfortably well",但"uncomfortably"到底指什么?一种读法是"效果好到让我不安"——因为它挑战了他演讲里的观点;另一种读法是"好用到让我觉得自己的方法论被颠覆了"。博客没有展开,但这个"不安"本身就是信号:当最懂 LLM 的人之一,被自己随手写的体验指令"惊"到,说明模型的能力又往前走了一步,走到了连专家都需要更新心智模型的地步。
相关阅读:Simon Willison:给 agent 的开销设硬上限(同作者:上一篇讲"花钱的实证",这篇讲"花时间的实证"——3 小时 7 分钟的推理,本身也是一种花钱);Epic Games Launcher vibe-coded 预览(vibe coding 主题);Google Play 上的个人 vibe-coded 应用(个人 vibe 应用主题)。
一句话总结:Simon Willison 用一个 prompt、iPhone 上的 Claude chat app、3 小时 7 分钟的单次推理,做出来一款带音乐动画成就系统的找不同游戏;"保证好玩"这句体验指令出奇地管用——vibe coding 的 prompt 心法,从此多了一条:需求讲方向,标准讲体验,"think hard"把推理预算拉满。以及别忘了他那个不好意思的自嘲:连最懂模型的人,都会被一句"保证好玩"惊到——这说明,模型的"审美"和"好玩"理解,可能一直被我们低估了。
评论 (0)
原始来源
相关文章
AI 半小时就能交出一个 Cmd+K 面板,但匹配排序、快捷键冲突、输入法闪烁、移动端降级才是它翻车的地方。本文给一人团队一条完整路线:命令注册表数据模型、五步模糊匹配评分管线、带冲突检测的全局快捷键体系、无障碍键盘闭环、移动端入口降级、与权限联动的命令,以及上线前 10 项检查表。
AI 能糊出像文档的页面,但信息架构、版本化、搜索、与代码同步才是文档站能用的关键。本文给一人团队完整路线:README/帮助中心/文档站决策表、亲核过的四家工具对照(Fumadocs/Starlight/Docusaurus/Mintlify)、四块内容加两条读者路径的信息架构、快照式版本化、DocSearch 与本地搜索、OpenAPI 驱动的 API 参考、有帮助吗反馈闭环,以及上线前 10 项检查表。
每个 vibe 项目都有一堆表单,AI 生成的只会堆 required——模糊的文案、异步竞态、重复提交、丢失的草稿才是用户流失的地方。本文给一人团队完整的表单实战:校验三层分工、错误文案改写、防抖防竞态的异步校验、idle/submitting/success/error 提交状态机与防重提交三保险、文件型表单、多步表单草稿、无障碍,以及上线前 12 项检查表。