Vercel 开源 durable-harness:让 Pi、OpenCode、Claude Code、Codex 崩溃后不断线
Vercel 开源 durable-harness,一套适配器加工具集,给 Pi、OpenCode、Codex、Claude Code 等现有 harness 外挂持久化能力:每步先记 intent 再记 outcome,turn 用队列兜底,崩溃后从日志断点续跑,已完成调用永不重跑、token 不重复计费。
AI 编程智能体的军备竞赛,今年上半年还在比"谁写代码更快、上下文窗口更大",现在风向明显变了:比的是谁跑得住、谁崩溃后能自己爬起来、谁不重复烧 token。Vercel 在 10 月 21 日前后(官方博客页未印日期戳,日期为多方交叉核实,下文详述)开源了 durable-harness,一个给现有 coding agent harness(编排器)加持久化能力的小包,意图把"会话崩溃即作废"这个云上 agent 的老大难问题彻底解决掉。
一个包,不动你手里的 harness
durable-harness 的定位很克制:它不是一个新 agent,也不是新框架,而是一套适配器加工具集。按照 Vercel 官方博客的说法,它"extends that durability to any harness"——给现成的 harness 外挂持久化能力,"without changing the harness"(不改动 harness 本身)。
首批覆盖的名单很说明问题:Pi、OpenCode、OpenAI Codex、Claude Code,外加 Vercel 自家的 eve(eve.dev) 和 fx(fx.sh)。这几乎是一份"主流云端 agent 编排层"的点名册。Pi 和 OpenCode 这类开源 harness 一直是独立开发者用来做常驻 agent 的引擎(Vercel 文章里点名的 OpenWork、HanaAgent 就是拿开源 harness 当产品底盘的),而 Claude Code、Codex 本是为本地真 shell 设计的工具,现在也被纳入了统一的持久化方案。
有意思的是这个姿态:Vercel 没有试图再造一个自家的"终极 agent"去跟各家抢用户,而是选择了做水和电——把各家 harness 的"跑得住"问题包办下来。这和 10 月初他们推出的 eve 框架(本身自带 durable execution)是同一套逻辑:平台层收租,越往下越往基础设施走。
原理:每一步先写日志,turn 用队列兜底
机制本身并不玄。官方博客用了一个很形象的 demo 讲清楚:agent 给已有应用加一个 pricing page,读旧页、写新页、开 PR、等 CI。问题是——如果等 CI 的时候函数超时了怎么办?
durable-harness 的做法是:turn 的每一步,调用前先把"意图"(intent)写进 durable log,调用结束再把"结果"(outcome)写进去;turn 本体则由一条 queue message 兜底。函数挂了,队列把这个 turn 交给一个新函数,新函数读日志,从上次完成的地方继续跑,不用人工重启,浏览器断线了 agent 也照常运行,重连后从日志里 catch up。
日志崩溃后会如实记录三种状态:做完了的、正在做的、根本没开始的。这带来了几个直接后果:
- 已完成的调用永不重跑。原话是 "you're never billed twice for a finished model's tokens"(你永远不会为一个已完成模型调用的 token 付两次钱)。对跑长任务的人来说,这是最实在的一条:之前函数一超时,已经烧掉的上下文和 token 全白搭,现在账单至少不会重复收割。
- 工具重放按"安全/永不"两档处理。标记为
replay: 'safe'的工具(查文件、查 CI 状态这类只读操作)崩溃后自动重跑;标记为replay: 'never'的工具(比如发退款)绝不重跑——模型只会被告知"这步可能已经执行过了",由它自己决定要不要去核查后再行动。退款示例是官方给的,很能看出这套设计的严肃性:幂等性不是事后 patch,而是写在工具定义里的第一性约束。 - harness 自带的会话文件也被镜像进日志。Claude Code 的 transcript、Codex 的 rollout、OpenCode 的 event store,都会逐条镜像到 durable log 里,新函数或重建的 Sandbox 可以直接从日志重建它们。这一步其实很关键——它承认了各家 harness 有自己的"记忆格式",不搞统一格式,而是把各家记忆都备份进同一份账本。
工作区三档:virtual、sandbox,各取所需
文件和 shell 往哪放,是云端 agent 的另一个经典坑:共享 serverless 函数主机的文件系统不保证跨调用持久。包里给了三档选择:
virtual():文件树直接存在会话日志里,配一个 bash 兼容的 shell,但碰不到函数自己的文件也碰不到网络。适合短任务、小工作区,不用起整个 sandbox。virtual({ durable: false }):内存里的草稿盘,每 turn 结束就清空,做临时 scratch 用。sandbox():给会话配一个独立的 Vercel Sandbox,/workspace挂载在跨函数、跨 sandbox 都持久的 Drive 上。真正的项目和长任务走这一档。
官方文档有一条硬性规定值得注意:Claude Code 和 Codex 必须走 Sandbox,因为它们是为真 shell 和真文件系统设计的,不适合多租户的共享环境。这意味着想在云上"持久化" Claude Code,会话成本里一定含着一个 Sandbox 的开销——"免费持久化"并不存在。
后端可插拔:两个环境变量切到自建 Postgres
整套机制的底座是 Workflow SDK 的 World 接口——日志、队列兜底、观看流三者合一的抽象。适配器只认这个接口,所以同一个 agent 不改代码就能在不同的 World 之间搬家:
- 在 Vercel 上跑,用 Vercel World;
- 本地开发,用本机文件;
- 自建,用 Postgres、MongoDB、Redis 或 Turso。切到 Postgres 只需要两个环境变量:
WORKFLOW_TARGET_WORLD="@workflow/world-postgres"和WORKFLOW_POSTGRES_URL。
另外还有一个容易被忽略的设计:Documents。待办清单、计划、agent 填的表单这类"属于会话但不属于对话"的状态,被做成类型化 JSON 存进日志,工具通过 io.docs 编辑,每次编辑和工具结果一起提交进日志。官方甚至点明 virtual() 的文件树就是用 document 实现的。换句话说,这个包的"记忆"不止是聊天记录,还包括工作区文件和结构化状态——一条更完整的会话账本。
配套的可观测性是 Vercel 上的 Agent Runs 面板:每个会话的每一次模型调用和工具调用都有 trace,崩溃后恢复的 turn 会出现在同一条 trace 里,能精确看到 turn 在哪停的、在哪续上的。这对调试长任务的"断点续跑"是刚需,否则你都不知道 agent 是真恢复了还是在瞎编。
观点:agent 基础设施正在"云原生化",但先别急着上生产
把这次发布放到更大的图里看,信号很清晰:coding agent 的竞争瓶颈,正在从"模型谁更聪明"转向"基础设施谁更可靠"。年初大家还在比 benchmark 分数,年中开始比 harness 的工程体验,现在连"函数超时了 turn 怎么办"这种分布式系统老问题都摆上了台面——这几乎是云原生演进史的复刻:应用先跑起来,然后发现状态管理是坑,然后出现一层专门管状态的中间件。
durable-harness 就是 agent 世界的这层中间件。它想回答的问题很具体:当 agent 任务动辄跑几分钟到几小时,当函数随时可能被杀、当 redeploy 随时可能发生,"会话"这个概念到底应该住在哪? Vercel 的答案是:住在日志里,不住在进程内存里。
但有两个冷水必须泼。第一,包目前是 0.0.x experimental 状态,MarkTechPost 的报道里明确标了这一点,官方博客也没给任何 benchmark 数据——"崩溃后不断线"的 demo 是可控演示,真实世界里长任务的恢复成功率、日志膨胀后的成本、跨 World 迁移的坑,都还没有公开答案。第二,它对 Vercel 生态的绑定是隐性的:World 接口是开放的,但 Vercel World、Agent Runs 面板、Sandbox 这些配套都在 Vercel 自己的围墙里长得最顺。自建 Postgres 能跑,但体验天花板大概率还是在 Vercel 那一侧。
所以一个务实的判断是:这是一个方向正确、但还没到抄作业时间的发布。对独立开发者和小团队,它最大的价值可能是思路上的——"先写 intent 再调用"这个模式,放到你自己的 agent 工程里今天就能用;对已经在 Vercel 上跑常驻 agent 的人,可以小规模试,但别把生产任务的命押在一个 0.0.x 的包上。
agent 跑得快不快已经不稀奇了,跑得住不住,才是下半场。
demo 里藏的细节:两种恢复方式,一笔账
官方博客的 demo 设计得很直白:同一个 turn、同一个超时、同一根被拔掉的网线,左右两栏对比"没有持久化"和"有 durable-harness"的 agent 各自怎么收场。左边的 agent:状态全在进程内存里,函数一死,工作停摆,等人来手动重启,之前做完的步骤还得重跑一遍;右边的 agent:新函数从日志里读出已完成的结果,turn 从上次完成处续上,浏览器断线期间 agent 照跑,重连后直接 catch up。
这个对比真正想讲的其实是一笔账。云端 agent 的浪费从来不只是"时间",更是 token。一个跑了四十分钟的 turn,在最后一步超时,传统做法是整个 turn 重来——之前所有模型调用烧掉的 token 全作废。现在日志里记着每一步的 outcome,重跑只从断点开始,"已完成调用永不重跑"直接翻译成一句话:云函数越不稳定,这套机制省的钱越多。serverless 的按量计费和 agent 的长任务,本来就是一对矛盾,durable log 就是 Vercel 给这对矛盾开的药方。
还有一个被低估的细节:官方明确说,"不是每个 agent 任务都需要 sandbox"。查数据库、调 API 这类操作可以在函数里直接跑,而且敏感凭证永远不需要进 sandbox。这句话背后是安全模型的分层:读操作和副作用操作走不同的执行面,凭证面和管理面分离。对于想把 agent 接进生产系统的团队,这比"崩溃恢复"本身更重要——持久化解决的是可用性,凭证不进沙箱解决的是合规性。
它不是第一个想"管住状态"的人
MarkTechPost 在报道里拉了一张对比表,把 durable-harness 和市面上几套"持久执行"方案并排比较,值得细看:
| 方案 | 本质 | 后端 | 状态 |
|---|---|---|---|
| durable-harness | 给现有 coding harness 外挂持久化的适配器 | Workflow SDK World(Vercel / 本地文件 / Postgres) | 0.0.x,experimental |
| Temporal + OpenAI Agents SDK | 给 OpenAI Agents SDK 套持久执行外壳 | Temporal server / Temporal Cloud | 2026 年 3 月 GA |
| Inngest AgentKit | TypeScript 多智能体框架 | Inngest 编排引擎 | 未披露 |
| Cloudflare Agents SDK | 基于 Durable Objects 的有状态 agent | Durable Objects、Cloudflare Workflows | MIT 协议 |
这张表暴露了 durable-harness 的差异化:它不造新框架,它给别人的框架当"外挂"。Temporal 那套是重型的、要你把整个工作流搬进它的世界观;Cloudflare 的是绑定自家 Durable Objects 的;而 durable-harness 的策略是"harness 该干嘛干嘛,崩了归我管"。这种"非侵入式"的定位,恰恰是它最有可能被真实采用的原因——开发者不需要重写 agent,只需要套一层适配器。
代价是显而易见的:Temporal 已经 GA 大半年了,Cloudflare 的 Durable Objects 是久经考验的存储原语,而 durable-harness 还在 0.0.x。表格里"无公开 benchmark"这一行,是所有想尝鲜的人都该先看到的。
Vercel 的阳谋:从部署平台到 agent 基础设施
把时间线拉长一点看,这次发布不是孤立事件。10 月 15 日的 Vercel Ship 2026 上,他们刚发布了 Drives(sandbox 关机也不丢的持久文件存储,可被新 sandbox 挂载、fork 做并行探索),同期还有 Daemons 和 Python 支持、eve agent 框架(自带 durable execution)、MCP Events 的 beta。durable-harness 是这条产品线里"最不 Vercel 绑定"的一块——它甚至允许你用两个环境变量就把整个 agent 搬到自建 Postgres 上去。
但别被"可移植"迷惑了。World 接口是开放的没错,可 Agent Runs 的 trace 面板、Vercel Sandbox、Drive 这些配套体验,最好的版本一定长在 Vercel 自己的云上。自建 Postgres 能跑通,但你想要的"崩溃恢复可视化""一键重建 sandbox",天花板在 Vercel 那一侧。这是一种很高明的平台策略:核心协议开源、可移植,体验层收租。Kubernetes 当年也是这么赢的。
更深一层看,Vercel 在赌的是:agent 的"会话"会成为云资源的一种,就像当年的容器和函数一样,会有专门的编排、存储、观测三件套。Workflow SDK 的 World 接口就是他们给"agent 会话"定义的资源抽象——log(日志)、queue(兜底)、stream(观看流)三合一。一旦这个抽象被足够多的 harness 采纳,Vercel 就成了 agent 时代的"状态层"供应商。这个位置的含金量,参考一下当年 S3 之于对象存储。
对开发者的实操建议:分三档看
第一档:自己跑常驻 agent 的独立开发者。如果你已经在用 Pi 或 OpenCode 做 7×24 的 agent(比如自动 triage issue、定时写周报),durable-harness 值得在一个非关键任务上试点。注意两点:一是它 experimental,别把生产任务押上去;二是 Claude Code/Codex 强制走 Sandbox,成本模型先算清楚再动手。
第二档:拿开源 harness 当产品底盘的团队(比如 OpenWork、HanaAgent 这类)。这套适配器对你们是直接利好:不用自己造"崩溃恢复"轮子,harness 升级也不受影响,因为适配器是外挂的。但要评估日志膨胀——每个 turn 的每一步都写 intent+outcome,长任务跑下来日志量不小,World 后端的存储成本要进预算。
第三档:只想写好 agent 逻辑的人。最值得抄走的不是这个包,而是它的设计模式:调用前先记 intent、调用后记 outcome;工具按"可重放/不可重放"声明幂等性;把"可能已执行"而不是"没执行"告诉模型。这三条今天就能用在你自己的 agent 工程里,不依赖任何 Vercel 的服务。
结语:下半场的入场券
回头看今年 agent 基础设施的演进:上半年是模型和 harness 的百团大战,下半年 Vercel、Cloudflare、Temporal 们开始逐层收编——状态层、执行层、观测层各自长出中间件。durable-harness 的出现,标志着"让 agent 跑得住"从各家自研的脏活,变成了一个可以单独购买(甚至开源白嫖)的能力。
这对整个生态是好事:harness 开发者可以回去专心做 prompt、工具和上下文工程这些"智能"层面的事,不用再跟函数超时和网络抖动肉搏。但对尝鲜者也要把丑话说在前面——0.0.x 的 experimental 包,demo 很漂亮,生产很骨感。方向是对的,时机还没到。先看懂它的设计模式,等它长大。
一手来源:Vercel 官方博客《Making every harness durable》(https://vercel.com/blog/making-every-harness-durable)。需要说明的是,该博客页面抓取文本中未露出明确的发布日期戳,"2026 年 10 月 21 日"为多方交叉核实:MarkTechPost 报道页 URL 含 /2026/10/21/、Jeepney News 标注 October 21, 2026、Wisevoter 正文写明 "released the durable-harness package on October 21, 2026"、Vercel 官方 LinkedIn 约三天前发布相关帖子、TLDR AI 2026-10-21 期收录。报道口径一致,故本文采用该日期。
深挖:"永不重复计费"到底省了多少钱?
"you're never billed twice for a finished model's tokens"——官方博客这句话读起来像营销话术,但放在 serverless 计费模型里算一笔账就知道它有多实在。假设一个 agent turn 跑了 30 分钟,期间调用了 40 次模型、累计消耗了价值 2 美元的 token,最后一步因为函数超时挂掉。传统做法:整个 turn 重来,2 美元打水漂,还要再花 2 美元重跑,总成本翻倍。而 durable-harness 的恢复只从断点续跑,之前 40 次调用的 outcome 都在日志里躺着,直接读出来就行,省下来的不是"一点点",而是整个已完成部分的 token 账单。
更重要的是,这个省钱的幅度跟云函数的不稳定性成正比。函数越容易被杀、网络越抖,传统方案的浪费越大,而 durable log 的价值就越高。这几乎是在给 serverless 跑长任务这件事"打补丁":serverless 的设计哲学是函数短平快、无状态,而 agent 的任务天然是长耗时、有状态的,两者从根上就不匹配。durable-harness 没有试图改变 serverless,而是在它上面盖了一层"有状态"的壳——计算层保持无状态、可随意杀,状态层单独持久化。这正是云原生时代处理这类矛盾的标准答案。
不过也要看到硬币的另一面:日志本身不是免费的。每个 turn 的每一步都要写 intent 和 outcome,加上 Claude Code 的 transcript、Codex 的 rollout、OpenCode 的 event store 全量镜像,一个跑几小时的长任务,日志量会膨胀到什么程度?存在 Postgres 里就是实打实的存储和 IO 成本。官方目前没有给出任何关于日志膨胀、恢复延迟、跨 World 迁移开销的数据——省 token 的钱和花日志的钱,到底哪头大,现在没人知道。这是 experimental 阶段最该被追问、却最没答案的问题。
被低估的设计:Documents 与"会话账本"
官方博客里相对低调、但笔者认为最有远见的一节是 Documents。它的定义很简单:一些"属于会话、但不属于对话"的状态——待办清单、计划、agent 正在填的表单——被做成类型化 JSON,住在会话日志里。工具通过 io.docs 修改它,每次修改和工具调用结果一起提交,保证文档状态和工具调用记录永远一致。
为什么说这个设计有远见?因为它回答了一个 agent 工程里人人都遇到、但很少有人系统解决的问题:agent 的"记忆"到底应该包含什么?今天大多数方案的记忆就是聊天记录——把历史消息塞回上下文。但一个真实的 agent 会话里,状态远不止对话:文件树长什么样、待办做到第几项、表单填了一半还是填完了,这些结构化状态丢了,agent 就"失忆"了。Documents 把这些结构化状态也写进同一份日志,等于在说:会话账本不只记"说过什么",还要记"做到哪了"。
更妙的是,连 virtual() 的文件树都是用 document 实现的——文件树本身就是一份存在日志里的类型化文档,每次工具调用的改动随结果一起提交。这意味着"文件系统"在这里被降级成了一个"带版本历史的 JSON",而版本历史天然就是可恢复的。这种"万物皆日志"的思路,是整个包最统一、也最优雅的地方。
当然,优雅不等于免费。Documents 的一致性保证(编辑与工具结果原子提交)听起来很美,但在 Postgres、MongoDB、Redis、Turso 这些不同后端上,一致性语义能不能都兑现?官方说 World 接口抹平了差异,但 0.0.x 的抹平程度,值得打个问号。等社区有人在自建 Postgres 上跑出生产报告,这部分才算真正立住。在那之前,把它当作一份设计蓝图来读,会比当作开箱即用的工具来用,收获更大。
评论 (0)
原始来源
相关文章
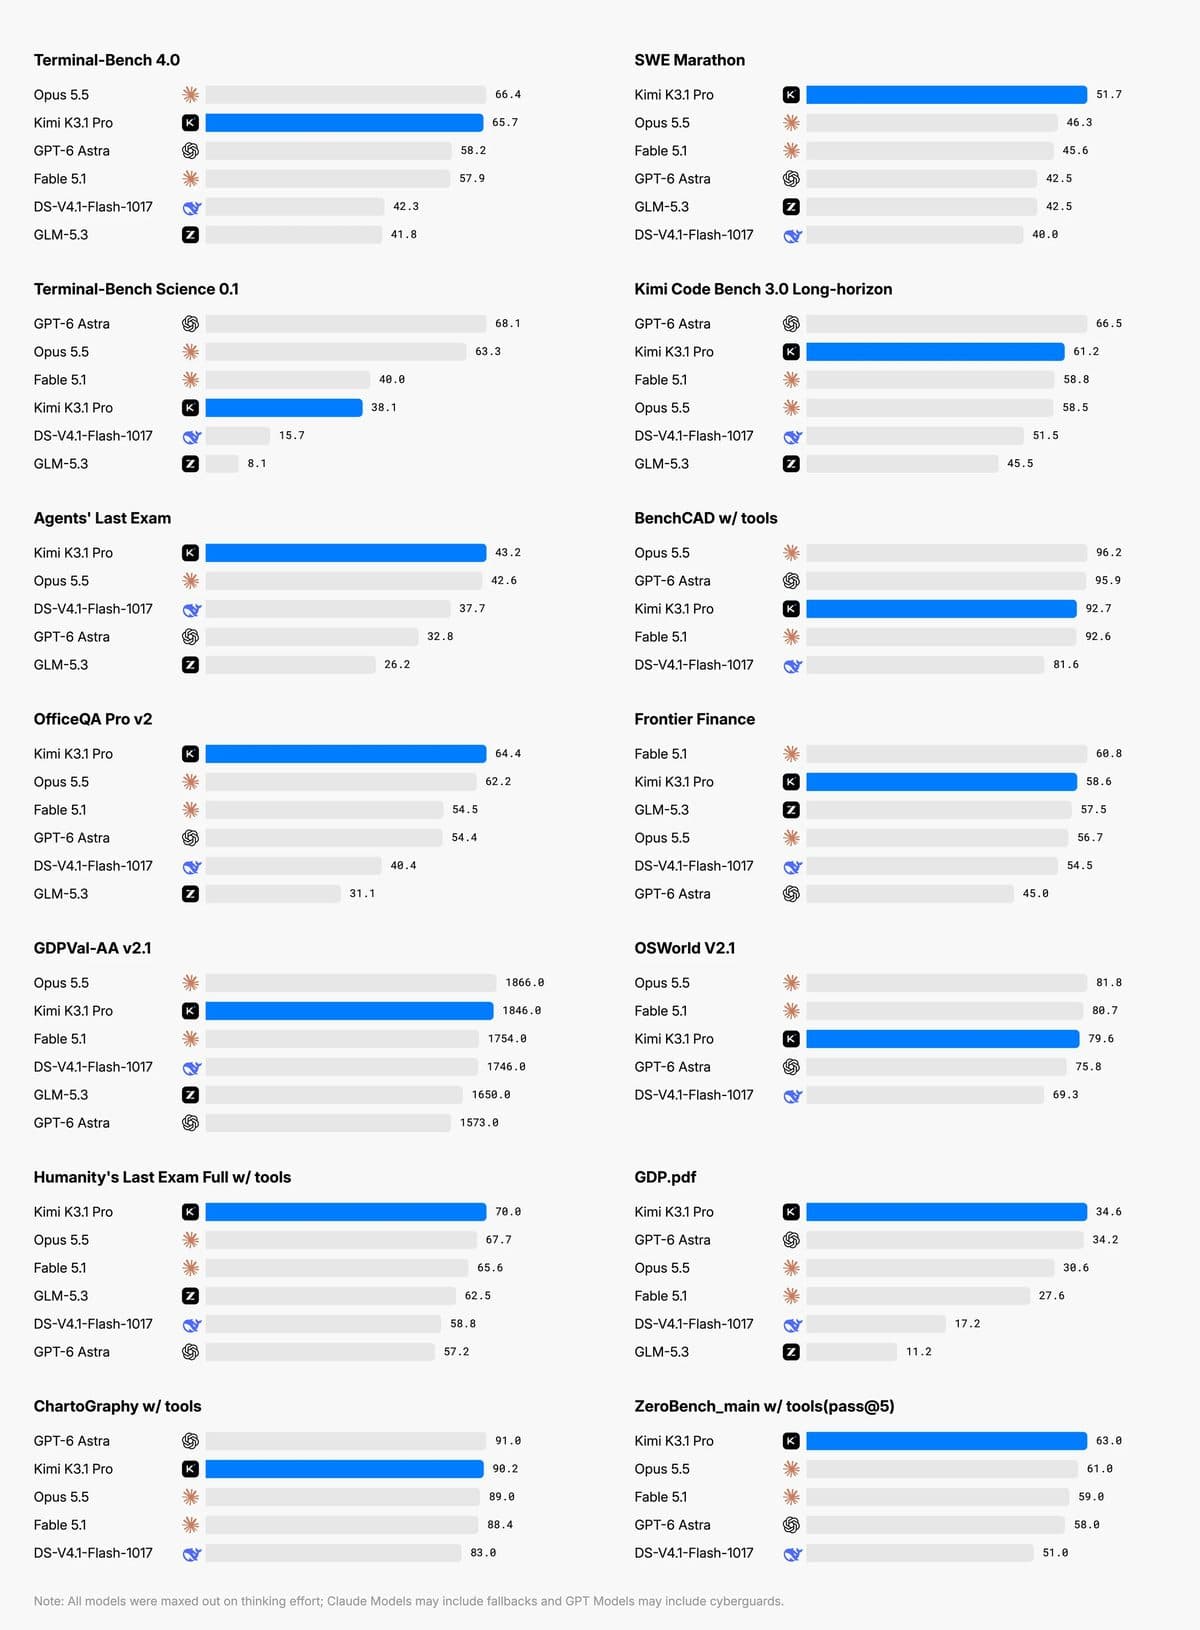
月之暗面发布 Kimi K3.1 Pro:Terminal-Bench 4.0 拿下 65.7%,只比 Claude Opus 5.5 低 0.7 分,API 降价三分之一,完整权重承诺 11 月 4 日前开放。官方还罕见地量化了开源与安全的 trade-off:为安全清洗掉的网络攻防数据,让内部漏洞基准从 90.5% 降到 81.0%。
llm-d 1.0 发布:IBM、Red Hat、Google、NVIDIA、CoreWeave 联手打造的开源分布式推理框架迎来 Day 2 能力——多租户 QoS、零停机升级、会话感知路由。IBM 演示:3000 个 coding agent,每百万 token 约 0.11 美元。本文拆解版本内容、"Kubernetes 时刻"类比,以及 vibe 开发者的自建 vs 调 API 成本账。
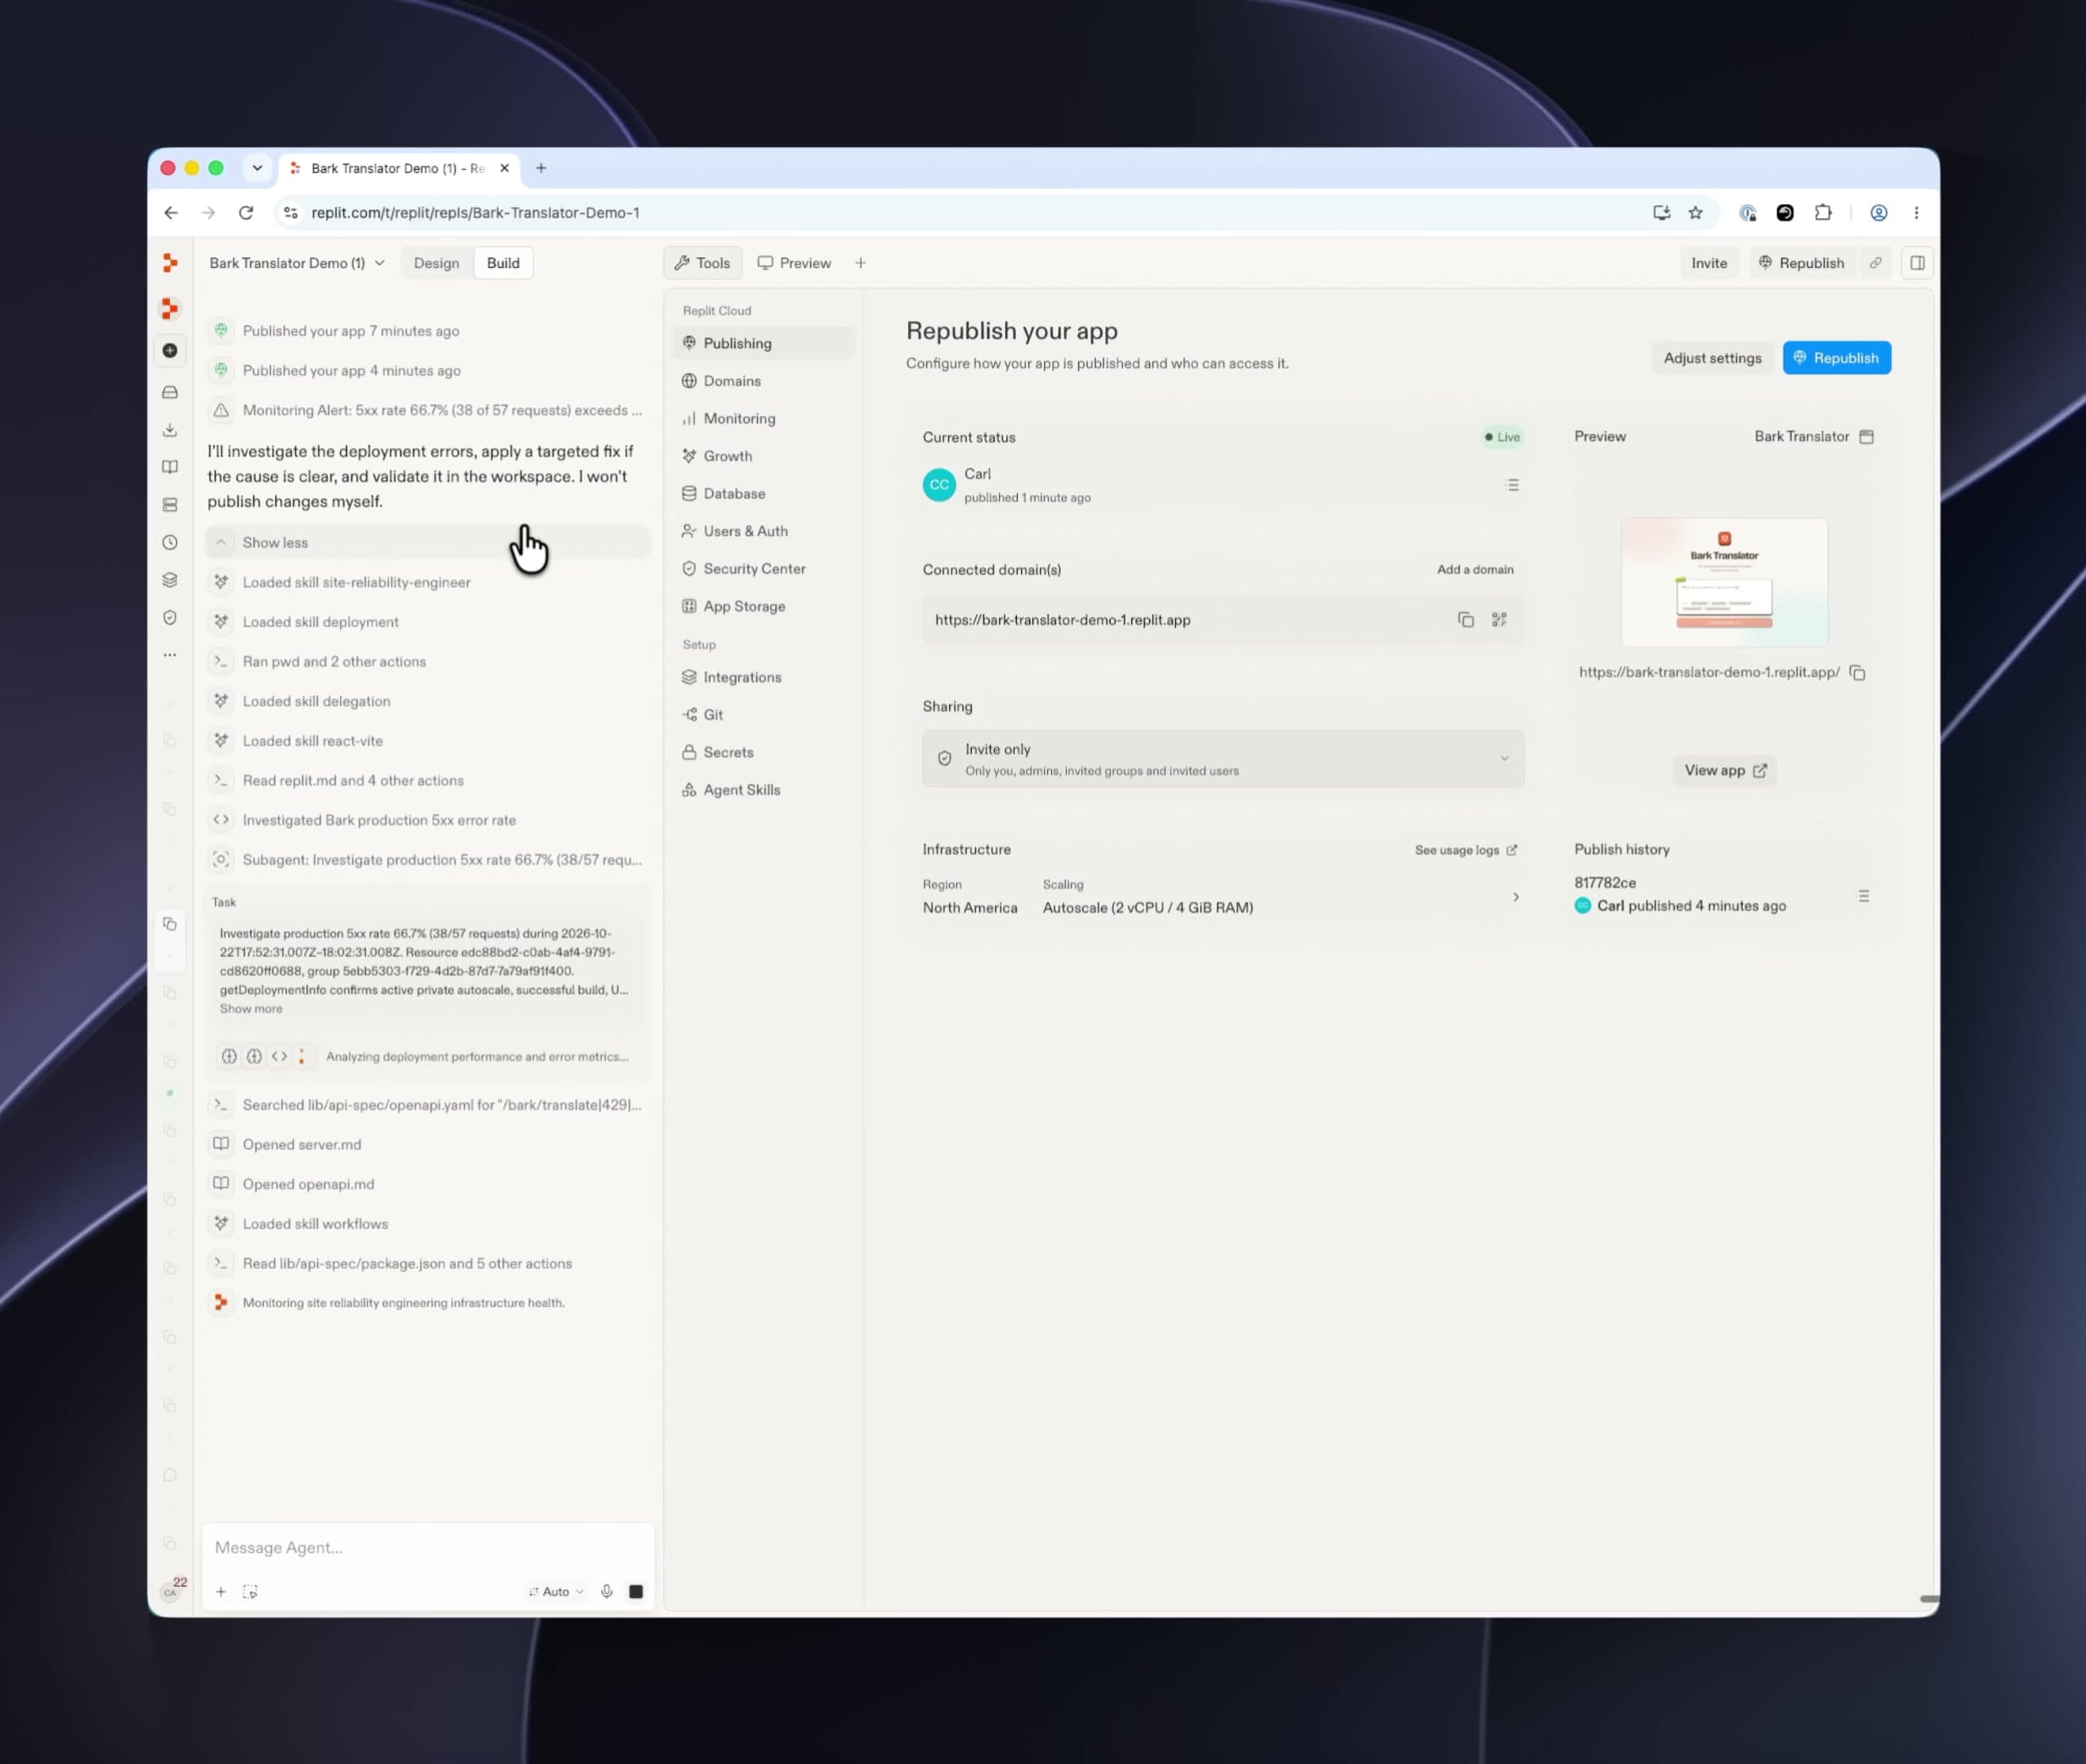
Replit 10 月 22 日发布 Monitoring Agent,给每个人的应用配一个 autonomous on-call engineer:告警一响,自动调查根因、验证修复、发邮件汇报,还能可选直发生产。官方演示用 Bark Translator 应用,5xx 误报(38/57 请求)2 分钟修完、留检查点。三层渐进授权看/修/发,是 vibe coding 从“写代码”到“养代码”的第一步。