Replit 发布 Monitoring Agent:给每个人的应用配一个自主值班工程师
Replit 10 月 22 日发布 Monitoring Agent,给每个人的应用配一个 autonomous on-call engineer:告警一响,自动调查根因、验证修复、发邮件汇报,还能可选直发生产。官方演示用 Bark Translator 应用,5xx 误报(38/57 请求)2 分钟修完、留检查点。三层渐进授权看/修/发,是 vibe coding 从“写代码”到“养代码”的第一步。
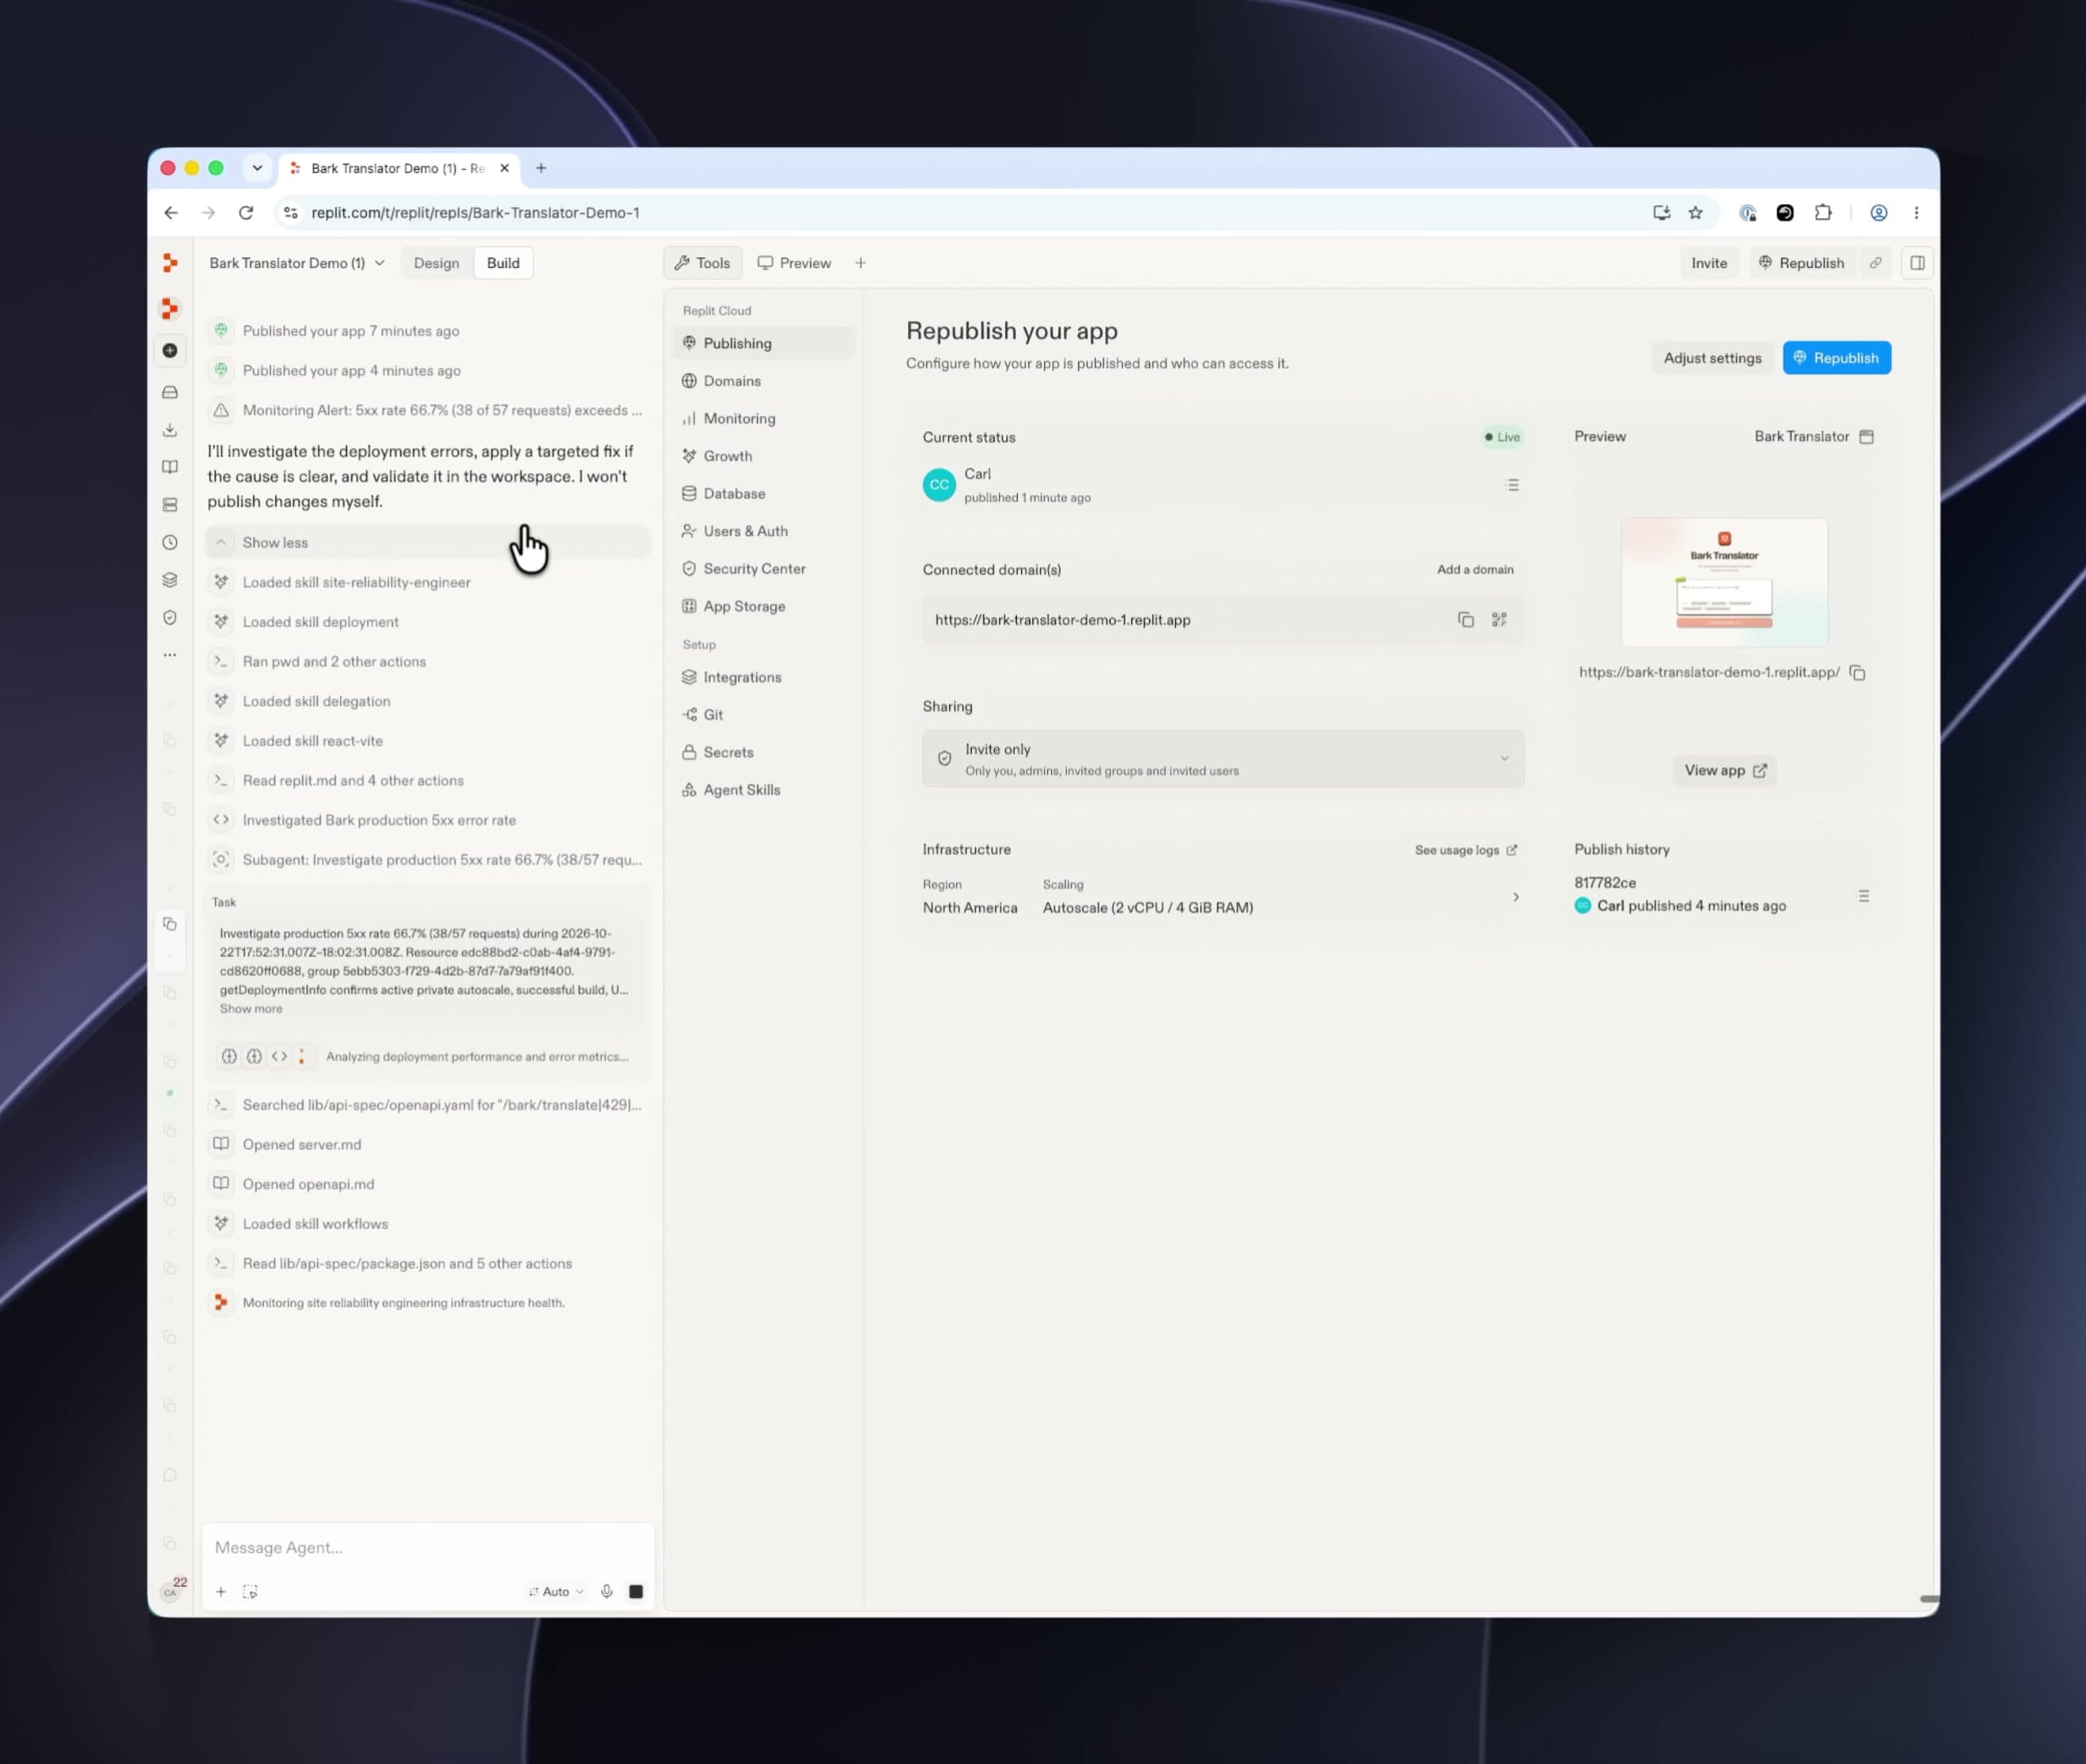
每个把应用发布上线过的人,都收到过那条让人心头一紧的消息。Replit 在 10 月 22 日的官方博客里,把它原样引用了出来:"Doesn't work for me."("在我这儿用不了。")
在大公司,这句话会触发一整套精密机器:on-call 工程师被寻呼机叫醒,查日志、定位、修 bug、发版,用户甚至感知不到中断。而对绝大多数独立开发者和小团队来说,这套机器不存在——写代码的是你,客服是你,半夜被用户消息吵醒、爬起来翻日志的,还是你。更扎心的是,大公司的工程师修完 bug 可以回去睡觉,你修完 bug,第二天还要照常写新功能、回客户消息、想增长——运维挤占的,是你本来就捉襟见肘的创造时间。
10 月 22 日,Replit 发布了 Monitoring Agent,官方给它的定位非常直白:给每个人的应用配一个 autonomous on-call engineer(自主值班工程师)。生产环境出问题时,它能调查告警、定位原因、做出并验证修复、把修复部署到生产环境,然后向你汇报发生了什么、改了什么。
这不是 Replit 在监控上的第一次动作。今年早些时候他们上线了 App Monitoring:生产健康检查 + 应用宕机时发告警。但那套东西只解决了一半问题——它告诉你"坏了",然后没了。下半句"谁来修",一直空着。Monitoring Agent 就是来补下半句的,用 Replit 自己的话说:"closing the loop"(闭环)。
它到底能做什么:看、修、发
官方博客把能力拆成了三层,层层递进:
第一层:看(See)。Agent 能直接读取你应用的生产日志和指标。错误、变慢、部署失败,它自己有上下文去调查,不用你半夜爬起来翻日志。这是 App Monitoring 时代就有的"眼睛",现在交给了 agent。
第二层:修(Fix)。打开 alerting + autofix 后,告警一响,Monitoring Agent 就会被唤醒:调查原因、验证修复方案,然后给你发一封邮件,总结发生了什么、它做了什么。注意这个默认行为——修,但先不发,你收到的是汇报。
第三层:发(Deploy)。如果你再打开 auto-publish,它会把验证过的修复直接部署到生产环境,并汇报改了什么。开不开这个开关,你说了算。
这个三层设计是整件事里最值得品的地方。让 AI 自动改生产代码,本质上是把"合并权限"交出去——这是高风险操作。Replit 没有一上来就"全自动",而是给了渐进式授权:先只看不修(告警),再修但不发(autofix + 邮件汇报),最后修完直接发(auto-publish)。每一层都是一次信任投票,你可以停在任何一层。
官方演示里真实发生的一幕
Replit 在博客里放了一段完整演示,用的测试应用叫 Bark Translator。过程很值得细看,因为它展示的不是"一键修好"的魔法,而是一个 SRE 真实的工作流:

告警内容是 "Monitoring Alert: 5xx rate 66.7% (38 of 57 requests)"——翻译接口的 5xx 错误率飙到三分之二。Agent 被唤醒后的第一句话是:"I'll investigate the deployment errors, apply a targeted fix if the cause is clear, and validate it in the workspace. I won't publish changes myself."(我来调查部署错误,如果原因明确就做针对性修复,并在工作区验证。我不会自己发布变更。)
然后它加载了一串 skill:site-reliability-engineer、deployment、delegation、react-vite、workflows——相当于一个值班工程师把自己的工具箱摊开。调查结论很有意思:根因根本不是代码 bug,而是 bark 路由把"配额拒绝"错误地以 HTTP 500 的形式吐了出来——本来应该是 429(限流),结果被记成了 500(服务器故障),于是监控把正常的限流拒绝当成了生产事故。
修复方案:把那个响应的状态码改成 HTTP 429,更新 API 约定。验证环节跑了回归测试:限流、非法输入、正常翻译、真实上游故障四种场景全部通过。整个过程 2 分钟,留了一个 checkpoint(检查点,可回滚)。

这个案例选得极其聪明。它没有演示"修了一个空指针"这种教科书 bug,而是演示了一个真实生产环境里最常见、也最气人的问题:监控误报、状态码语义错误。能处理这种"不是 bug 的 bug",才说明 agent 真的理解生产系统,而不是在背修复模板。
为什么这事值得单独写一篇:vibe coding 的"下半场"
vibe coding 把"写代码"压缩成了一句 prompt。过去一年,Replit Agent、Cursor、Claude Code 们解决的是"从想法到第一个可用版本"的速度问题。但任何一个真正上线运营过产品的人都知道:写完代码,只是开始。
应用的生命周期里,写代码大概只占前 20%。剩下的 80% 是:盯着它别宕机、用户报 bug 时复现、半夜修 hotfix、依赖升级、证书过期、流量突增、慢查询……这部分工作有个名字,叫运维(operations)。它琐碎、反人性、不能停,而且和"创造"毫无关系——但它是软件成为"产品"的代价。
Monitoring Agent 的意义在于,它第一次把 vibe coding 的自动化边界,从"写代码"推进到了"养代码"。Replit 在博客里把话说得很透,值得原文引用:
"Building an app is only one part of that journey. Keeping it reliable, secure, discoverable, and improving over time has historically required an entire team."
(做出一个应用只是这段旅程的一部分。让它长期可靠、安全、被发现、持续改进,历史上需要一整个团队。)
对一人开发者来说,这句话的含金量在于:你终于可以把"值班"这件事外包出去了。以前的模式是"用户先发现,你后修";现在的模式是"agent 先发现、先修,你睡醒看邮件"。Replit 博客的原话是:"instead of learning about outages from frustrated users, you can wake up and focus on what matters to you"——不用再从愤怒的用户嘴里听说宕机,醒来该干嘛干嘛。
和站内《错误监控与崩溃上报实战》的划界
细心的读者可能记得,站内有一篇指南《错误监控与崩溃上报实战》,讲的是 Sentry 集成。那篇和这篇是什么关系?一句话划界:
那篇是"代码级"的眼睛,这篇是"agent 级"的手。
Sentry 那套是你要亲手埋 SDK、配上报、定分级规则——它告诉你"哪儿坏了、堆栈是什么",但修还是得你来。Monitoring Agent 是另一层:它不止看,还调查、修、验证、部署、汇报,形成完整闭环。两者互补不冲突:Sentry 适合任何技术栈、任何部署位置;Monitoring Agent 目前只服务跑在 Replit 上的应用,但自动化程度深得多。
用一个比喻:Sentry 是体检报告,Monitoring Agent 是值班医生。体检报告人人都需要;值班医生,是 Replit 给自家住户配的。
冷静三问:先别急着开 auto-publish
好话说完,说三句冷静的。这三点决定了你该怎么用它,而不是要不要用它。
第一,自动修复的质量,还没有经过独立验证。官方演示很漂亮,但那是官方挑的案例——根因清晰、修复收敛、验证简单。真实生产环境的事故往往更 messy:根因可能藏在第三方服务里,修复可能牵一发动全身。Agent 修生产代码的真实翻车率、误判率,现在没有任何第三方数据。我的建议:先开 autofix 跑几轮,认真读它发给你的每一封邮件汇报——看它的根因分析靠不靠谱、修复方案保守不保守、有没有"为了修而修"的过度改动。等它连续几次都靠谱,再考虑 auto-publish。
第二,这是平台锁定的能力。Monitoring Agent 只看得到跑在 Replit 上的应用的生产日志和指标。你的应用一旦搬离 Replit,这个"值班工程师"就辞职了。这不是批评——深度集成是它能做到"调查+修复+部署"的前提,Sentry 那种通用方案永远做不到这一步。但你要清楚:你在用平台绑定换自动化深度。
第三,把它放进 Replit 的路线图里看。博客里有一段话很容易被略过:过去六个月,Replit 上线了 black box security scanning(黑盒安全扫描)、growth(增长工具),现在是 production monitoring。Replit 的方向很明确:从"一个 coding agent"进化到"autonomous software teams"(自主软件团队)——能完成现代软件工程团队能做的任何事:构建、维护、安全、增长。Monitoring Agent 不是孤立功能,它是"agent 团队"拼图里的"运维"那一块。理解了这一点,你就知道接下来 likely 会出什么:agent 帮你做安全加固、agent 帮你做增长实验——都在路上了。
值班这件事,到底在消耗什么
可能有人觉得:不就是半夜起来看个日志吗?真正在生产环境值过班的人知道,消耗从来不只是"那半小时"。真正的消耗是持续的后台进程:你不敢把手机调静音,不敢去没信号的地方,甚至不敢深度休假——因为 pager 随时可能响。这种"随时可能被打断"的状态,心理学上叫 anticipatory stress(预期性压力),它吞掉的是整段生活的质量,而不只是处理事故的那几小时。
大公司用"轮班制"来分摊这种消耗:on-call rotation,一人一周,换着来。小团队分摊不起——三个人里总有一个是"永远的 on-call"。一人开发者更惨:rotation 只有一个人,就是全年无休。
所以 Monitoring Agent 真正卖掉的东西,不是"修 bug 的速度",而是把"预期性压力"从人身上卸下来。Replit 博客里那句 "with the peace of mind that your app's uptime is being handled"(带着"应用的可用性有人管着"的安心),瞄准的正是这个。一人开发者第一次拥有了"轮班"的可能性——只不过跟你轮班的不是人,是 agent。
这也是为什么我说它是 vibe coding 的"下半场"。上半场解决的是"从 0 到 1 有多快",下半场解决的是"从 1 到 N 有多省心"。前者是创造的民主化,后者是运维的民主化。而运维,恰恰是把一个"玩具项目"和一个"能收钱的产品"区分开的东西。
和传统 on-call 工具链的本质区别
有人可能会问:这和 PagerDuty + runbook 有什么区别?区别在"闭环的完整度"。
传统 on-call 工具链是:监控发现异常 → 寻呼人 → 人看 runbook(预案文档)→ 人执行修复 → 人验证 → 人发版。工具负责"叫醒你",剩下的全是人。Runbook 自动化走得最远的一派,也不过是把"人执行的步骤"写成脚本——但写脚本、维护脚本的还是人,而且脚本只会处理预见过的情况。
Monitoring Agent 的链条是:监控发现异常 → agent 自己调查 → agent 自己修 → agent 自己验证 →(可选)agent 自己发版 → agent 向你汇报。关键差异在第二步:调查(investigate)这一步,传统工具链里永远是人。日志有上万行,哪个是根因、哪个是噪音,需要的是判断力,不是执行力。Replit 敢把这一步交给 agent,赌的是模型现在的推理能力已经够格做"初级 SRE 的调查工作"。
从演示里能看到这种"调查"的质感:agent 没有停在"5xx 很多"这个表面现象,而是追到了"配额拒绝被错误地标成 500"这一层,还区分了"真正的翻译失败应该保持 502"。这不是模式匹配,这是带着领域知识(HTTP 语义、API 设计)的诊断。值不值你半夜那通电话,就看这种诊断的稳定程度——而这正是需要你用 autofix 阶段的邮件汇报来亲自验证的。
邮件汇报:被低估的设计
三层能力里,最容易被忽略的是第二层的"emails you a summary"(给你发邮件总结)。这封邮件值得单独说,因为它解决的是 AI 运维里最难的问题:信任如何建立。
自动修生产代码,最大的阻力不是技术,是心理——你不知道它干了什么。一个好的汇报应该回答四个问题:发生了什么(what happened)、根因是什么(root cause)、改了什么(what changed)、怎么验证的(validation)。从演示看,Replit 的 agent 汇报正是这个结构:Likely cause / Fix / Validation 三段式,还附了证据(endpoint metrics、request logs)。
这其实是把"事故复盘报告"(postmortem)自动化了。大公司的 SRE 文化里,postmortem 是强制要求的:每次事故都要写 blameless 回顾。Monitoring Agent 等于给每个一人开发者配了一个"写 postmortem 从不偷懒"的 SRE。长期看,这些邮件是你理解自己系统弱点的最好材料——哪个接口老是出问题、哪类修复反复出现,翻几个月邮件就看出来了。
所以我的实操建议里,第二步"先开 autofix、认真读邮件"不是保守,而是用两周时间完成你和 agent 的信任校准。你会从中看出它的能力边界:它擅长哪类问题、哪类问题它会误判。这个校准过程,恰恰是 auto-publish 能不能开的依据。
它改变的是"一人公司"的成本结构
最后说一层很多人没想到的:这件事改变的是独立开发的成本结构。
传统上,一个 SaaS 产品从"能跑"到"敢收钱",中间有一道隐形的墙:你得向客户承诺可用性。承诺可用性,就意味着你要么自己 24 小时待命(拿健康换),要么雇人轮班(拿钱换)。很多独立开发者的产品永远停在"免费试用"阶段,不是不想收费,是不敢——收了钱,半夜宕机就是违约。
Monitoring Agent 把这道墙变矮了。它没有消灭运维,但它把"从事故发生到开始处理"的响应时间(MTTR 里的 MTTR 前半段)压缩到了分钟级,而且不需要你醒着。这意味着一人开发者可以更早地对客户说"我的服务是可靠的"——不是因为你更努力了,而是因为你有了一个不睡觉的值班员。
当然,别把它想成"雇了个高级 SRE"。它更像是一个极其勤奋、但经验尚浅的初级运维:7×24 在岗,调查认真,修完会写报告,但复杂判断还得你把关。用好它的姿势,不是"开了就不管",而是"让它处理 80% 的常规事故,你只处理它搞不定的 20%"。这 80/20 的分工,恰恰是所有成熟 on-call 体系的样子——只不过以前分工的双方都是人,现在一方是 agent。
给 vibe coding 创作者的实操清单
如果你已经在 Replit 上跑着生产应用,上手路径官方已经给得很清楚:
- 第一步:把应用 publish,然后打开 Publishing settings,找到 monitoring alerts 和 auto-fix,打开。
- 第二步:auto-publish 先别开。让 agent 跑一两周,你只收邮件汇报,观察它的判断质量。
- 第三步:如果汇报持续靠谱,再开 auto-publish,并确保你知道去哪儿看它的变更记录和回滚(演示里每次修复都留了 checkpoint,这是你的安全绳)。
- 第四步:别把它当银弹。它处理的是"已知模式"的问题——5xx、变慢、部署失败。真正的架构级问题、业务逻辑错误,仍然需要你。
vibe coding 的上半场是"人人都能写代码",Replit 用 Agent 解决了;下半场是"人人都能运维一个产品",Monitoring Agent 是第一块拼图。写代码只是开始,养代码才是修行——现在,至少值夜班这件事,有人替你了。
值得玩味的是 Replit 博客结尾那句:"All you need is the idea and the ambition."(你所需要的,只是想法和野心。)这句话在两年前听起来像营销话术——因为那时你有想法,还得自己学会 React、自己配数据库、自己半夜修服务器。但当 coding agent 解决"写"、Monitoring Agent 解决"养"、security scanning 解决"防"、growth agent 解决"推",这句话正在一点点变成字面意义。Vibe coding 的终局,从来不是"写代码更快",而是"一个人就是一支队伍"。Replit 这次,是把队伍里的"运维"位置,先补上了。
一手来源:Replit 官方博客《Replit Monitoring Agent: Your very own software》,发布于 2026-10-22(页面标注 Published: 2026-10-22T20:24:13.430Z);交叉印证:Replit 团队成员 Carl C. 同日 LinkedIn 发文 "Today we're launching Monitoring Agent, your 24/7 on-call engineer!"(2026-10-22T21:26:20.669Z),以及 oossa.com 的独立报道。演示截图均取自 Replit 官方博客嵌入的演示视频。
评论 (0)
原始来源
相关文章
Vercel 开源 durable-harness,一套适配器加工具集,给 Pi、OpenCode、Codex、Claude Code 等现有 harness 外挂持久化能力:每步先记 intent 再记 outcome,turn 用队列兜底,崩溃后从日志断点续跑,已完成调用永不重跑、token 不重复计费。
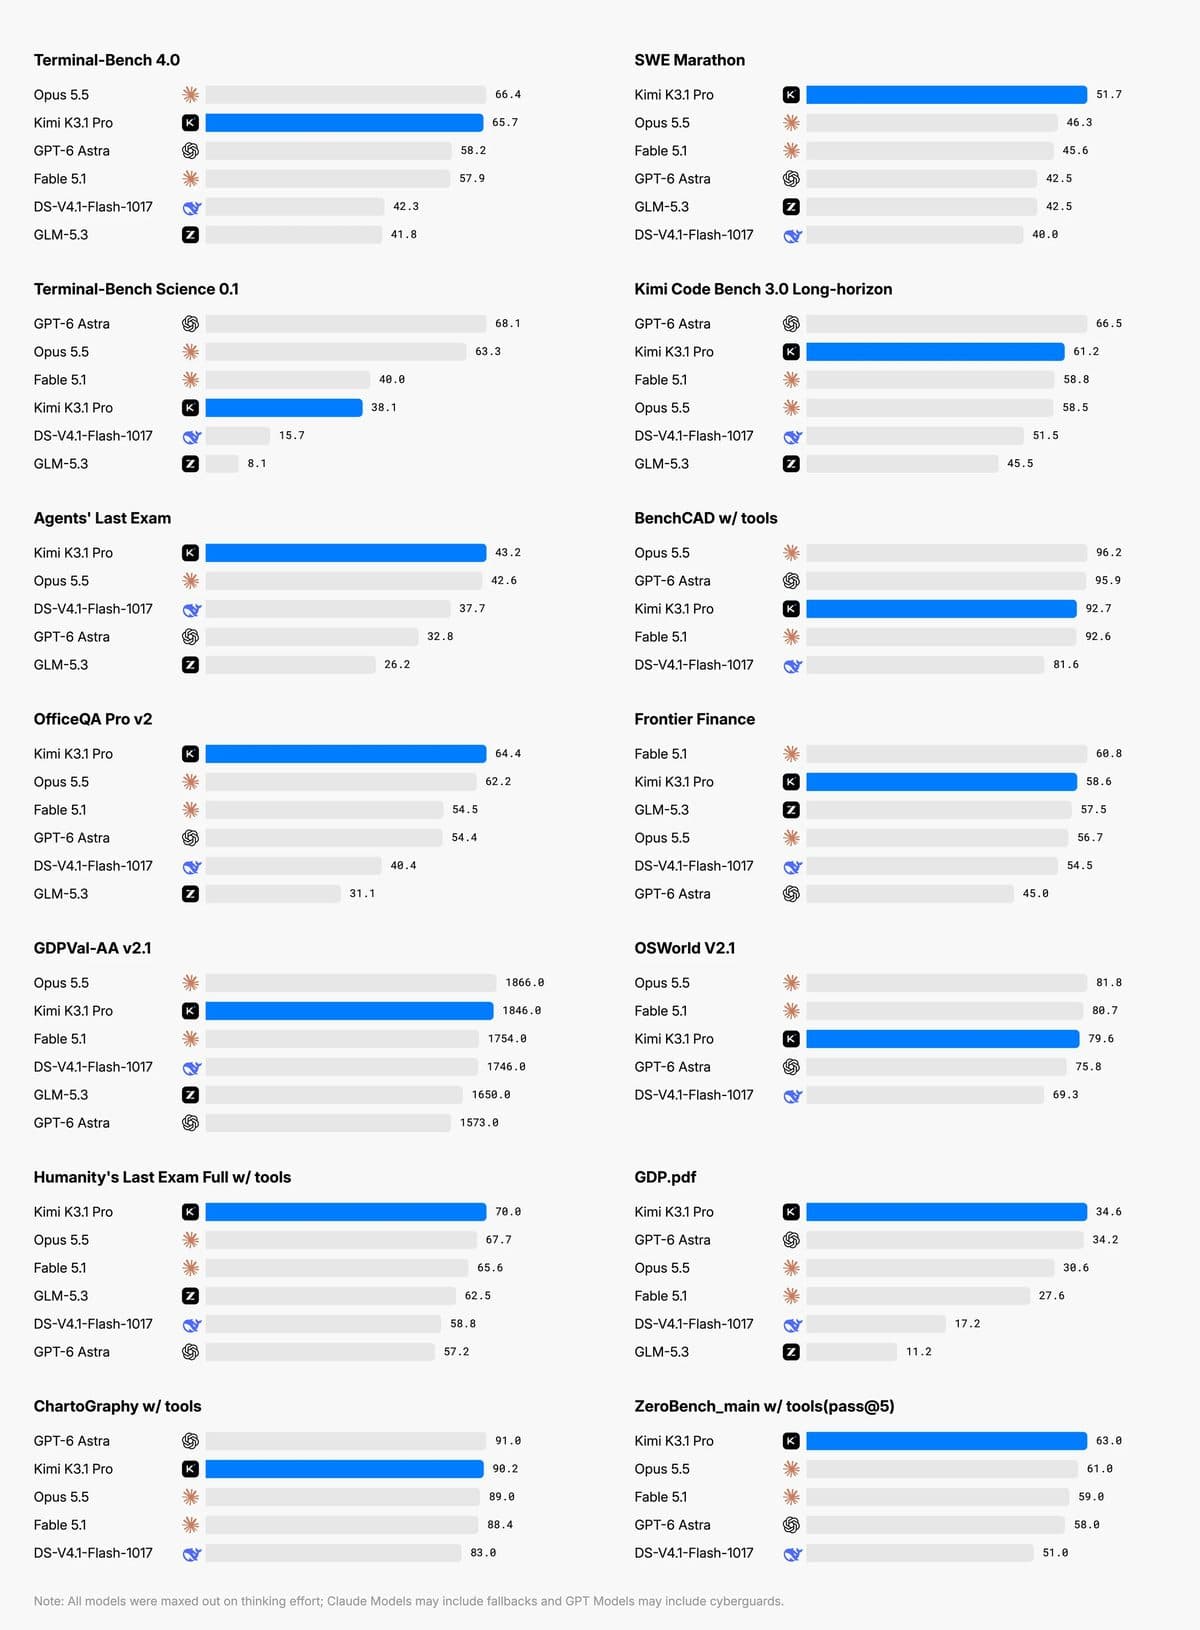
月之暗面发布 Kimi K3.1 Pro:Terminal-Bench 4.0 拿下 65.7%,只比 Claude Opus 5.5 低 0.7 分,API 降价三分之一,完整权重承诺 11 月 4 日前开放。官方还罕见地量化了开源与安全的 trade-off:为安全清洗掉的网络攻防数据,让内部漏洞基准从 90.5% 降到 81.0%。
AI 说“做完了”,和你理解的“做完了”往往不是一回事。这篇教你写五要素 DoD 任务卡、四类任务速查表、AI 自检 prompt 和 10 分钟人工验收流程,让返工从玄学变成清单。