国产开放权重再逼近前沿:月之暗面发布 Kimi K3.1 Pro,终端编码基准只差 Opus 5.5 零点七分
月之暗面发布 Kimi K3.1 Pro:Terminal-Bench 4.0 拿下 65.7%,只比 Claude Opus 5.5 低 0.7 分,API 降价三分之一,完整权重承诺 11 月 4 日前开放。官方还罕见地量化了开源与安全的 trade-off:为安全清洗掉的网络攻防数据,让内部漏洞基准从 90.5% 降到 81.0%。
划界说明:本轮另一篇 10-07 已发布的《Kimi K3 进 OpenAI 企业 Codex 渠道事件》(kimi-k3-openai-codex-channel-october-2026)讲的是渠道事件——Kimi K3 以第三方模型身份进入 OpenAI 的企业 Codex 分发渠道,主体是分发合作;本篇讲的是新模型发布——月之暗面推出 K3 系列的后训练升级版 Kimi K3.1 Pro 及 Highspeed 变体,主体是模型本身的基准、定价与开放权重承诺。两者是同一模型家族的两条独立新闻线,不重复。
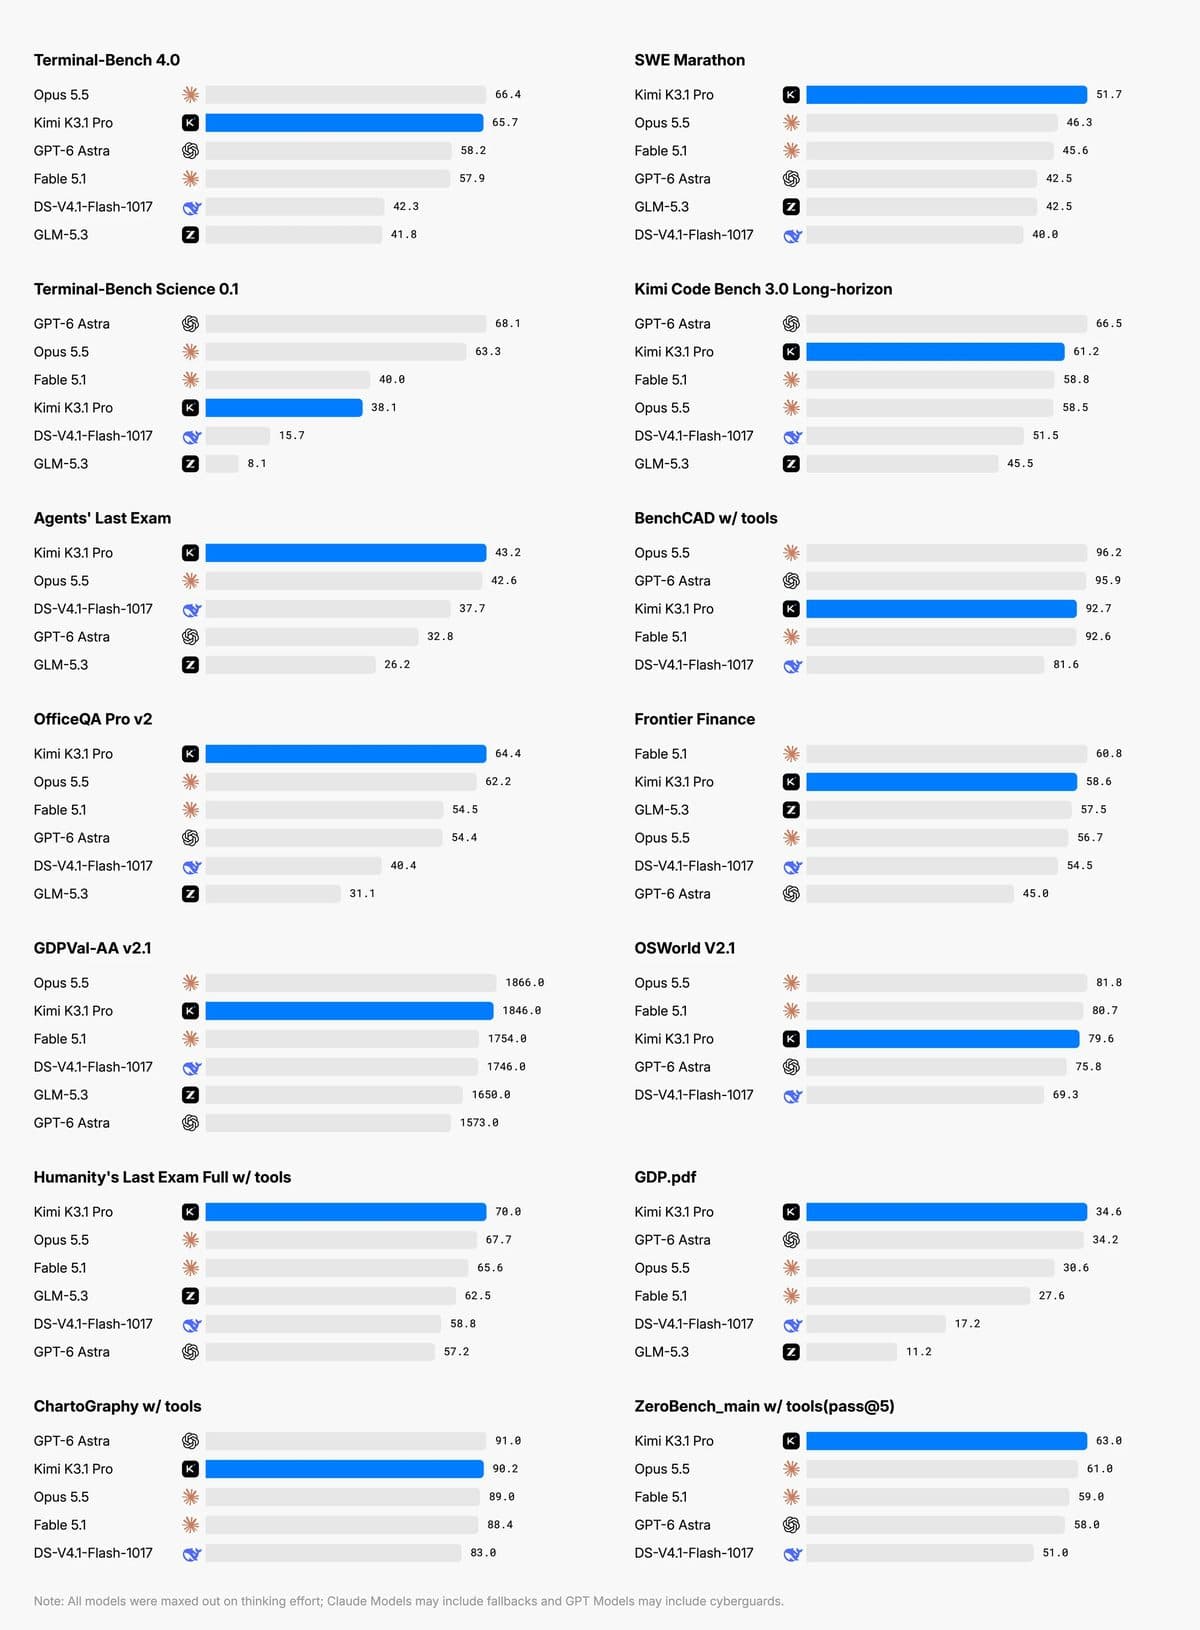
月之暗面在 10 月 23 日发布了 Kimi K3.1 系列的第一个模型 Kimi K3.1 Pro,官方称其为"迄今最强的 3T 级开放权重模型"。如果只看新闻稿里的数字,这个发布可以用一句话概括:在 Terminal-Bench 4.0 上,K3.1 Pro 拿下 65.7%,只比 Claude Opus 5.5 的 66.4% 低 0.7 个百分点,却甩开 GPT-6 Astra 的 58.2% 一大截——而这是一个承诺在 11 月 4 日前开放全部权重的模型。
数字很漂亮,但漂亮的数字这次附带了难得的阅读说明书:月之暗面在脚注里把测试方法交代得相当清楚。这篇文章就按三个层次展开——官方说了什么、这些数字该怎么读、以及发布背后藏着的商业算计和一次罕见的诚实。
这次发布到底是什么
K3.1 Pro 不是一个新架构的模型,而是 Kimi K3 的后训练升级版:基座不变,加的是"显著更大的后训练算力"。官方在 X 与 LinkedIn 确认了规格:2.8T 总参数、每 token 激活 104B 的 MoE 架构,1M token 上下文,多模态输入——骨架与 K3 相同,变化全部发生在强化学习阶段。官方的说法是,为了在"数百个下游领域"做大规模联合 RL,他们把 RL 框架、长上下文推理、训练效率、沙箱基础设施、rollout 调度和环境质量检查平台逐层优化了一遍,让每单位 RL 算力的投入都有"稳定、可预测的回报"。
同步发布的还有 Kimi K3.1 Pro Highspeed,官方称速度是 Pro 版的 2–3 倍,面向对延迟更敏感的交互与 agent 循环。这是一个独立的模型标识,不是简单的推理加速开关。
上线渠道覆盖了整个 Kimi 产品线:
- Kimi.ai 与移动端:iOS、Android、HarmonyOS 应用,以及网页端
- Kimi Work 桌面应用:3.1.0 及以上版本(Windows 与 Apple Silicon Mac)
- Kimi Code:用
/model命令切换选择 - Kimi API:模型标识
kimi-k3.1-pro与kimi-k3.1-pro-highspeed,支持 Zero Data Retention - Kimi Enterprise / Business:管理员需手动启用,发布时默认关闭
定价是这次发布里最直接的信号:Pro 版 $2 / 百万 input token、$10 / 百万 output token,缓存命中输入 $0.20;Highspeed 版翻倍,$4/$20。对比 K3 首发时的 $3/$15,全线降价三分之一。发布即日上线,权重却要等到 11 月 4 日——中间这两周的窗口,值得单独拿出来谈。
同一具骨架,更大的后训练:这次的提升从哪来
理解 K3.1 Pro 的关键,是理解它不是什么:它不是一次预训练规模的跃升。2.8T 总参数、104B 激活的 MoE 骨架与 K3 完全相同,1M 上下文也没变。所有的提升都发生在预训练之后——更大规模、更多领域的强化学习。研究后训练的 Nathan Lambert 在 X 上的评价一针见血:Moonshot 像是"搞明白了他们的 RL",K3 当初是一个底子极好的基座模型,但后训练做得相对轻;K3.1 Pro 就是把后训练这块短板补上了。
官方给出的证据是一个很有说服力的长程任务:在开源人体解剖模型 human-atlas(296 块骨骼结构、402 块肌肉)之上,K3.1 Pro 用 167 个任务、420 次独立评审,构建了一个人体步行动力学仿真器——包含训练与评估管线。它分析实验结果、诊断问题、迭代优化步态控制器,让仿真人从"几秒就摔倒"进步到"交替迈步连续行走 11.2 秒"。更有意思的是一个细节:当奖励塑形(reward shaping)无法改善手臂动作时,它没有继续调奖励函数,而是对仿真器动力学做了开环探测,定位并修正了肩部肌肉力臂计算中的 36 处错误,然后重新训练控制器。这种"不头铁调参、先去查仿真器本身有没有 bug"的行为,恰恰是长程 agent 任务里最难训练出来的能力。
这也解释了为什么提升几乎全部集中在 agentic 工作上。Artificial Analysis 的数据显示,K3.1 Pro 在 GDPval-AA(经济价值任务指数)上拿到 1846 Elo,比 K3 高出 312 分,排第三,仅次于 Opus 5.5 的 1866 和 Muse Wonder Full 的 1857;在 AutomationBench(SaaS 工作流)上从 58% 涨到 73%。纯知识问答类的提升则相对平淡——这是一个为"干活"优化的模型,不是为"考试"优化的。
产品侧也有配套动作:3D Make 随发布同步上线(kimi.ai 与 Kimi App 内),可以在线预览、编辑模型,下载用于 3D 打印,或导出为视频分享。结合 BenchCAD with tools 92.7% 的成绩(Opus 5.5 是 96.2%,差距不到 4 个点),Moonshot 显然想把"参数化 3D 建模"做成 Kimi 系的差异化招牌——从文本简述、草图或参考图直接生成可用的 3D 模型,再用 Blender/CAD 脚本细化,这条链路在开源模型里目前没有对手。
社区的第一反应:信数字,但留一手
发布当晚,Kimi K3.1 Pro 登上了 Hacker News 首页,讨论迅速过百条。评论区的态度很有代表性,可以总结为"信数字,但留一手":
- 幻觉率从 23.4% 降到 8.3% 被多人点名为"最受欢迎的改进",但紧跟着的下一句永远是"这是 Moonshot 自己的指标";
- 有人直接读出了网络安全专节的潜台词:Moonshot 等于承认"他们的 pipeline 能做出比发布版更强的模型";
- 也有失望的声音:既然开源版本阉割了网络攻防数据,那和某些美国模型的限制有什么区别?
- 最扎心的是一条经验之谈:除了 Anthropic 的模型,很少有模型的日常表现能对上它们的基准分数——基准和体感之间永远隔着一层。
- simonw 用他经典的"骑自行车的鹈鹕"SVG 测试跑了一遍,评价是"solid"(扎实)。
速度是另一个高频话题。有评论者实测 K3.1 Pro 比 K3 快了近一倍——K3 当初被诟病最多的就是"慢",部分原因是低效的思考过程。Artificial Analysis 的实测也显示 K3.1 Pro 比 GPT-6 Astra 和 Fable 5.1 更快。值得注意的是,K3.1 Pro 只支持思考模式,关闭思考的请求会被拒绝——"快"是在全程推理的前提下实现的,不是靠跳过思考换来的。
"0.7 分"的意义,和厂商自报数字的正确读法
先说结论:"开放权重只差闭源前沿 0.7 分"这个叙事是成立的,但只在 Moonshot 自己划定的赛道上成立。读懂这 0.7 分,需要同时看三个数:
| 基准 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD(with tools) | 92.7% | 96.2% | 95.9% |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | — | — |
| OfficeQA Pro v2 | 64.4(自称 SOTA) | — | — |
| Kimi Hallu Bench Hard(claim-level 幻觉率,越低越好) | 8.3% | 15.0% | 5.5% |
Terminal-Bench 4.0 是这一轮发布里分量最重的基准:它测的是编码 agent 在真实、资源受限的终端环境里完成任务的能力,用严格的任务专属测试打分,被多家实验室当作"能不能替我干活"的实用代理指标。在这里,65.7% 对 66.4%,差距确实小到可以忽略不计——尤其考虑到对手是 Anthropic 的旗舰闭源模型,而这是一个即将开放权重的模型。
但脚注必须一起读。Moonshot 在技术博客的 Footnotes 里写明:K3.1 Pro 自己的分数是用 Claude-Code harness 跑出来的,而对手的分数取的是"各家官方博客或官方排行榜上的最大值"。换句话说,自家模型用一套 harness 认真测了一遍,对手拿的是它们历史上最好的公开成绩。这不是造假——方法交代得很透明,但它意味着 0.7 分这个差距是在对自己最有利的比较口径下算出来的。真正的交叉验证要等 11 月 4 日权重发布后,社区用同一套 harness 跑一遍才有。
好在有一个独立的佐证已经先到了:Artificial Analysis 在发布当天就给出了 55 分的 Intelligence Index 评分,总排名第四,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5 与 Muse Wonder Full(56),领先 Claude Fable 5.1、GPT-6 Astra、Gemini 4 Argon(均为 53)。同一指数上 K3 只有 44 分,一代后训练直接拉了 11 分。AA 还独立测了 Terminal-Bench 4.0:K3.1 Pro 67%,超过了 Claude Sonnet 5.5 的 64%。厂商自报和独立第三方在同一个基准上指向同一个方向,这让 65.7% 这个数字的可信度高了不少。
读厂商自报基准的三条经验:第一,看脚注里的 harness 是否一致;第二,看对手分数的来源是"最新实测"还是"历史最大值";第三,找独立第三方的交叉验证。这次 Moonshot 在第一条上对自己有利、在第二条上写得明白,第三条有 Artificial Analysis 的 55 分托底——属于自报数字里比较干净的一份。
还有一个容易被忽略的细节:Kimi Code Bench 3.0 Long-horizon 是 Moonshot 的内部基准(61.2%,K3 为 55.95%),OfficeQA Pro v2 的 64.4 分" SOTA"也是自家赛道。内部基准的价值在于看纵向进步——从 K3 到 K3.1 Pro 的提升是真实的,但横向对比时要打折。幻觉率同理:claim-level 从 23.4% 降到 8.3% 降幅达 65%,但官方自己也注明这是"刻意构造的压力测试",不代表日常使用错误率。
定价战:Agent 编码的成本继续下探
如果说基准是面子,定价就是里子。K3.1 Pro 的价格表值得逐项读:
| 模型 | Input / 百万 token | Output / 百万 token | 缓存输入 / 百万 token |
|---|---|---|---|
| Kimi K3.1 Pro | $2 | $10 | $0.20 |
| Kimi K3.1 Pro Highspeed | $4 | $20 | $0.20 |
| Kimi K3(7 月首发) | $3 | $15 | $0.30 |
三点值得注意。第一,性能涨、价格降:比 K3 强出一截的模型,价格反而便宜了三分之一,这是典型的"用后训练红利补贴价格"的打法。第二,缓存输入 $0.20 对编码 agent 是关键——agent 循环里每一轮都要重发大段仓库上下文,缓存命中的输入才是真实成本的大头,$0.20 这个定价直接打在 agent 场景的七寸上。第三,Highspeed 的 $4/$20 定在了公开价目表上闭源旗舰的同一档,但承诺 2–3 倍速度——等于把"更快"单独拿出来卖,而不是把速度当免费赠品。
放在更大的图景里看:agent 编码的 token 成本正在以季度为单位下探。K3 到 K3.1 Pro 这一轮,官方 API 的输入输出价格双双下调三分之一,而能力反而逼近了最贵的闭源模型。对跑 agent 循环的团队来说,这意味着同样的预算能跑更多的 trial、更长的 horizon——而这恰恰是 K3.1 Pro 最擅长的长程任务类型。定价和能力在这里是互相成就的:便宜让长程 agent 跑得起,长程能力又让便宜有了意义。
还有一个容易被忽略的成本细节:Artificial Analysis 测得 K3.1 Pro 每个任务的输出 token 数比 K3 多了约 14%(55,000 对 48,000)——模型变强了,但也更"话痨"了。于是出现了一个微妙的抵消:token 单价降了三分之一,单任务的 token 消耗却涨了一截,最终 Intelligence Index 口径下每个任务的成本($1.98)与 K3 时代($2.00)基本持平。便宜的单价没有完全转化为便宜的任务,输出的膨胀吃掉了一部分降价红利。对重度 agent 用户来说,真正的省钱手段仍然是缓存命中($0.20 的输入 lane)和任务编排,而不是指望单价本身。
横向看,这一定价直接改写了"前沿编码能力"的价格锚。过去一年里,顶级编码模型的 API 价格基本锚定在"旗舰就该贵"的逻辑上;K3.1 Pro 用接近旗舰的基准成绩配上腰部价格,把锚往下拉了一大截。Highspeed 的 $4/$20 则反向操作——它验证了市场里确实存在"为速度付费"的意愿,Moonshot 选择把延迟做成明码标价的商品,而不是藏在免费 tier 里。这两种定价动作合在一起,说明 Moonshot 对自己的成本结构很有信心:后训练的投入是一次性的,推理的边际成本才是定价的底气。
网络安全专节:一次罕见的、被量化的诚实
这是整篇技术博客里最不寻常的一节,也是我认为这次发布真正值得被记住的部分。Moonshot 用了一整节讲他们为了开源版本的安全,主动把模型做弱了——而且把"做弱了多少"量化摆上了台面。
过程是这样的:随着后训练规模扩大,团队发现模型的漏洞研究能力在稳步提升。追查来源后发现,网络攻防相关内容嵌在通用 mid-training 语料里,RL 的环境混合里也有相关的任务——这是"用宽数据训练"的自然副产品。在内部模型的预实验里,如果不在 mid-training 和 RL 两个阶段都移除相关数据,下游的网络攻击能力会"显著"上升。于是他们为开源版本做了针对性清洗:两个阶段都识别并移除了 cyber-related 数据,同时保留通用编码任务以保证模型可用性。
关键的数字在这里:Moonshot 的内部基准 xdev-bench-hard(基于 Linux 内核、Node.js、JavaScriptCore 等真实披露漏洞构造的利用任务,pass@3),未做安全清洗的 checkpoint 能解出 90.5%,清洗后的 K3.1 Pro 是 81.0%——清洗的代价是 9.5 个百分点的攻击能力。作为参照,K3 在这个基准上只有 33.3%,而没有做类似承诺的 DeepSeek-V4.1-Flash 达到了 85.7%。
把这四个数排成一排,trade-off 就一目了然:
- 未清洗的 K3.1 Pro pipeline 上限:90.5%
- DeepSeek-V4.1-Flash(未承诺清洗):85.7%
- 公开发布的 K3.1 Pro(清洗后):81.0%
- 上一代 K3:33.3%
官方的立场表述得很直白:不发布会拉高攻击能力"绝对前沿"的开放权重;K3.1 Pro 的攻击性网络能力"按设计"低于自家 pipeline 能做出的水平,也低于已公开至少三个月的闭源前沿模型;同时他们打算"逐步"提高开放权重中的网络能力,因为防御方也需要双用途能力去审计代码——尤其是那些很少有人做安全评审的 legacy 系统。
为什么说这是罕见的诚实?因为主流厂商通常只说"我们做了安全评估",不说"我们把模型削弱了百分之几"。Moonshot 等于公开承认了两件事:第一,他们的训练流程本来能做出一个攻击能力更强的开放模型;第二,开源与安全的边界是厂商单方面划的,买家和社区无法审计这条线画在哪里。这是一种"透明的家长主义"——把 trade-off 量化给你看,但划线权不交出来。考虑到开放权重一旦发布就无法收回,这种"先清洗、再开源"的顺序本身,就是当前开源模型治理里最有争议也最实际的做法。
权重 11 月 4 日才开:API 先行两周的商业算计
发布时间线值得玩味:10 月 23 日 API 与全产品线先行,完整权重 11 月 4 日前发布,中间隔了两周。这两周不是工程延期——博客写的是"will be released by Nov 4",LinkedIn 帖子也明确"Open weights by Nov 4, 2026",是一个承诺日期,不是"尽快"。
算计很清晰:第一,两周的独家变现窗口。在权重公开之前,想用这个模型只有一条路——走 Kimi 的 API 和产品。HN 上发布当晚就登顶首页,Artificial Analysis 当天给出 55 分,热度最高的两周恰好是只能付费使用的两周。第二,生态预热。API 先行让开发者先把 kimi-k3.1-pro 接进工具链,等权重一开,自托管的需求已经被验证过一轮,社区量化、微调、部署的教程会自己长出来。第三,风险缓冲。网络安全专节里那套清洗流程,多两周的 API-only 窗口,等于多两周观察真实世界反馈的时间——万一清洗不到位,API 侧可以热修复,权重一旦放出去就没有回头路。
当然,代价也写在明面上:在权重发布之前,"开放权重模型"这个定语其实还没兑现。所有关于"最强开放权重"的叙事,目前都建立在一个承诺上。11 月 4 日是第一个真正的考验:权重是否会如期发布、许可证条款是什么、社区能否复现 65.7%——这三个问题任何一个出岔子,都会反噬这两周攒下的口碑。
还有一个现实的提醒:即便权重如期开放,"人人可下载"也不等于"人人可运行"。2.8T 总参数的 MoE 模型,Moonshot 官方口径是"K3 级别需要 64+ 加速器的 supernodes"才能跑起来——这是数据中心级的硬件,不是个人工作站能碰的。开放权重的真正受益者,首先是云厂商和有算力储备的大团队,他们会第一时间提供托管推理;其次是做量化、蒸馏的社区,权重是他们一切工作的起点。普通开发者最实际的受益路径,依然是 API 价格——而这恰恰是 Moonshot 已经提前给出来的部分。
接下来看什么
- 11 月 4 日的权重发布:是否如期、许可证是否真正开放、64+ 加速器 supernodes 的部署门槛意味着什么(这个量级的 MoE 自托管不是个人开发者能玩的,实际受益的是云厂商和有算力的大团队)。
- 独立复现:权重发布后,社区用统一 harness 跑 Terminal-Bench 4.0,65.7% 能不能站住。这是验证"0.7 分"叙事的唯一硬标准。
- Highspeed 的取舍:官方没有公布 Highspeed 独立的基准成绩,2–3 倍速度换了多少精度,$4/$20 是否划算,目前是未知数。
- 清洗线的后续:"逐步提高开放权重中的网络能力"具体怎么执行、由谁决定节奏——这条线以后每次发布都会被重新讨论。
K3.1 Pro 的真正意义不在于某一个基准数字,而在于它把开放权重和闭源前沿的距离压缩到了"一个模型版本"之内。过去两年的默认假设是:开放权重落后前沿一代,半年后以折扣价追上。K3.1 Pro 把这个时滞压成了一次后训练迭代的距离——如果 11 月 4 日权重如期兑现,"可下载的 AI"与"最好的 AI"之间就只差 Artificial Analysis 指数上的 3 分。这个距离,才是所有闭源实验室接下来要回答的问题。
评论 (0)
原始来源
相关文章
Vercel 开源 durable-harness,一套适配器加工具集,给 Pi、OpenCode、Codex、Claude Code 等现有 harness 外挂持久化能力:每步先记 intent 再记 outcome,turn 用队列兜底,崩溃后从日志断点续跑,已完成调用永不重跑、token 不重复计费。
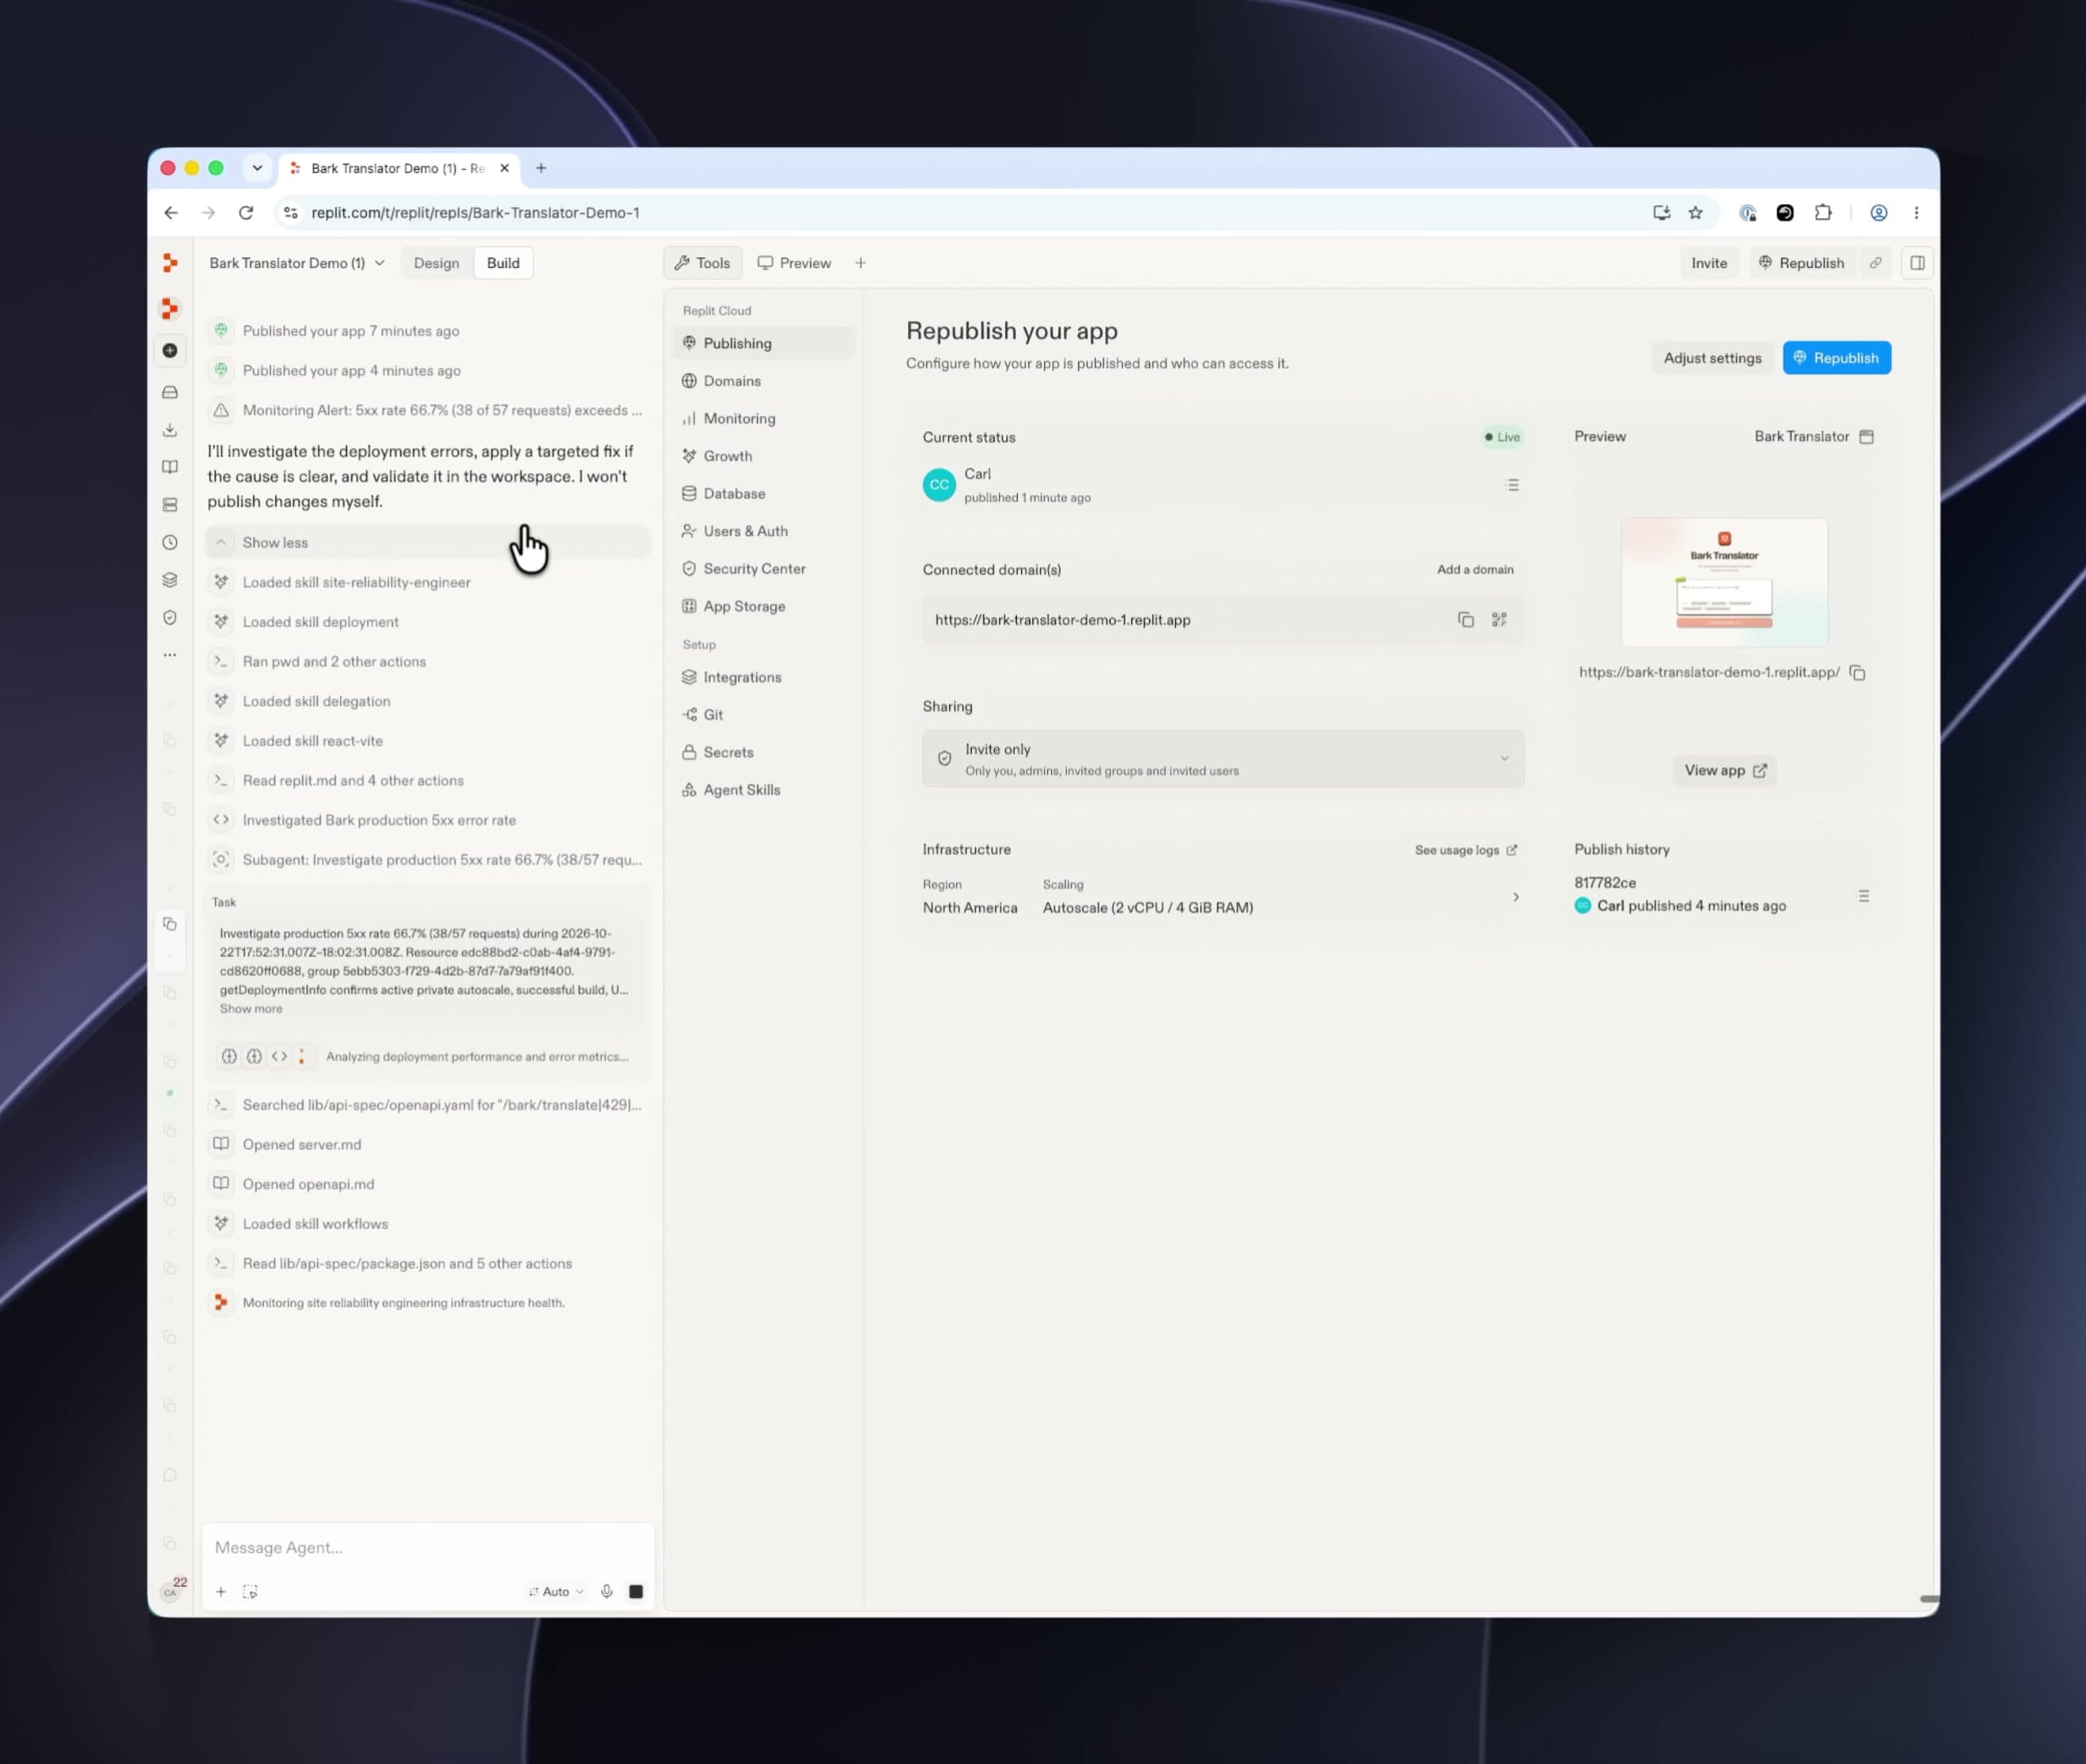
Replit 10 月 22 日发布 Monitoring Agent,给每个人的应用配一个 autonomous on-call engineer:告警一响,自动调查根因、验证修复、发邮件汇报,还能可选直发生产。官方演示用 Bark Translator 应用,5xx 误报(38/57 请求)2 分钟修完、留检查点。三层渐进授权看/修/发,是 vibe coding 从“写代码”到“养代码”的第一步。
llm-d 1.0 发布:IBM、Red Hat、Google、NVIDIA、CoreWeave 联手打造的开源分布式推理框架迎来 Day 2 能力——多租户 QoS、零停机升级、会话感知路由。IBM 演示:3000 个 coding agent,每百万 token 约 0.11 美元。本文拆解版本内容、"Kubernetes 时刻"类比,以及 vibe 开发者的自建 vs 调 API 成本账。