一个人项目的第一条流水线:5 个 Job 的 CI/CD 最小配置
资讯讲发布策略、运营讲首日冷启动,但没人讲第一步:一个人、没有 code review 的 vibe 项目,第一条 CI 流水线该长什么样。这篇给你 5 个 Job 的保留/砍掉决策表、一份可直接复制的 GitHub Actions 模板、预览部署与 AI 视觉验收、数据库迁移门禁、部署后 60 秒冒烟检查的完整 SOP,以及 4 个最常见的过度设计反模式。
vibe coding 让你一个人一周干出过去一个团队一个月的量。但有一个环节 AI 帮不了你:点下部署按钮那一刻,你心里那句"我确定这次没搞砸吗"。大团队靠 code review、QA 和值班兜底;你一个人,深夜三点让 agent 推了 40 个文件的重构,然后随手点了 deploy——这时候替你盯着的,只能是一条流水线。
这篇不讲发布策略(灰度、回滚那是另一篇的事),只讲第一步:从零搭起第一条 CI/CD 流水线的最小配置。5 个 Job,一份可直接复制的 GitHub Actions 模板,预览部署、迁移门禁、冒烟检查的完整 SOP,最后是 4 个最常见的过度设计。目标只有一个:今晚搭完,明早你敢在睡觉前点 merge。
为什么 vibe 项目更需要 CI/CD
先说一个反直觉的判断:团队越大,CI 越是"工程规范";你一个人,CI 越是"生存刚需"。大团队有人帮你 review,有人帮你点回归测试,你犯的错会被别人的眼睛拦下来。你没有第二双眼睛,流水线就是你的第二双眼睛。
更麻烦的是,AI 写代码的故障模式和人不一样。人犯错多是粗心:少了个分号、拼错变量名,review 时一眼就能看出来。AI 犯错是"自信地胡说":引用一个不存在的包还写得有模有样,重构时改了 A 文件的接口却漏掉 B 文件的三处调用,删掉一个"看起来没用"的环境变量——而这些代码的提交者(你)当时可能正在刷手机,根本没细看 diff。
三个现实把这件事推到"必须做"的程度。第一是频率:vibe 项目一天推 20 次是常态,靠人工每次检查发布既不现实也不可靠。第二是"我机器上能跑"陷阱:AI 在沙盒里跑通了,不代表生产能跑,依赖版本、Node 运行时版本、环境变量这三件套,本地和生产永远有 subtle 的差异。第三是成本:GitHub Actions 对公开仓库免费,私有仓库每月 2000 分钟免费额度,你一个人的项目一个月撑死用掉 300 分钟——"没时间搭"可能是真的,"太贵"一定是借口。
所以给第一条流水线定一个务实的目标:不是测试覆盖率 80%,而是凌晨三点 agent 推的代码,早上你醒来时要么是绿的,要么已经明确告诉你哪儿红了。CI 对一人项目来说不是工程化洁癖,是睡眠保险。
5 个 Job 的保留/砍掉决策表
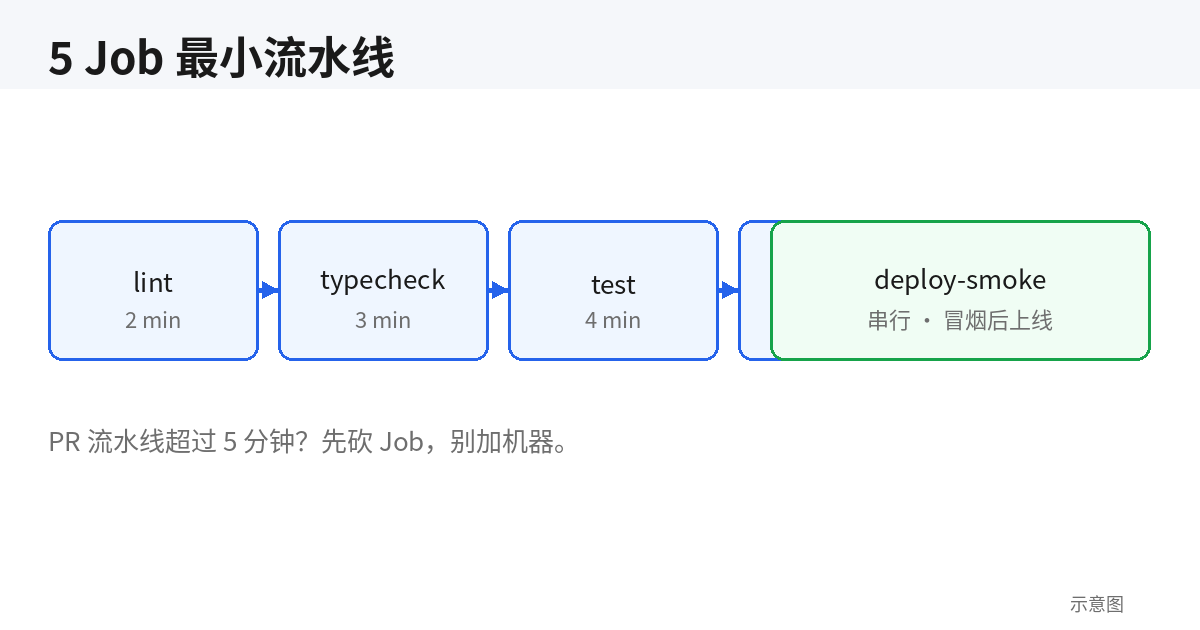
最小流水线不是"越少越好",而是"每个留下的 Job 都知道自己在替你看什么"。下面这张表,每个 Job 都给了保留条件和砍掉条件——照着你的项目现状打勾,5 分钟就能定下第一版配置。
| Job | 它替你看什么 | 留下的条件 | 砍掉的条件 | 时间预算 |
|---|---|---|---|---|
lint | 风格漂移和 AI 最爱留下的幽灵代码:未使用的 import、随手 console.log、满屏 any | 永远留。30 秒跑完,零借口 | 只有一种:这个仓库 7 天后就删 | ~30 秒 |
typecheck | AI 重构的第一大 bug 来源:改了类型定义,漏改三处调用,人眼 review 根本看不出来 | TypeScript 项目,或带类型注解的 Python 项目 | 纯 JS 原型、300 行内的单文件脚本且你打算重写 | 1–2 分钟 |
test | "错了会赔钱"的逻辑:金额计算、权限判断、核心纯函数 | 有这类关键逻辑 | 纯展示型落地页、营销站——build + 冒烟检查更划算 | 1–3 分钟 |
build | "本地能跑线上炸":缺依赖、环境变量没配、mac 不区分大小写而 Linux 区分的路径坑(AI 尤其爱在这栽) | 几乎永远留 | 纯静态 HTML,没有构建步骤 | 1–4 分钟 |
deploy-smoke | 部署真的活了:健康端点、关键页面、登录态 | 有用户在用的任何东西 | 定时脚本/爬虫——换成"跑完发心跳"的轻量检查 | ~60 秒 |
逐个说透里面的判断。
lint:别在规则上开会。一人项目的 lint 只有一条军规:用框架默认配置。ESLint 推荐配置、Biome 默认配置,开箱即用。规则争论是 5 个人以上的团队才配拥有的奢侈品,你的目标只是拦住那些"AI 写完自己都忘了"的残留物。把 no-unused-vars 和 no-console 打开,剩下的以后再说。
typecheck:vibe 项目 ROI 最高的 Job。为什么?因为 AI 最擅长"局部正确、全局不一致":它改 User 类型加了个必填字段,顺手改了当前文件的调用,却不知道另外三个文件也调了这个接口。测试不一定覆盖到,lint 看不见,只有 tsc --noEmit 会在 90 秒内把三处报错甩你脸上。TypeScript 项目没有这个 Job,等于开车不系安全带。
test:警惕 AI 写的"正确废话测试"。AI 生成的测试有个通病:断言实现细节而不是行为。你一重构,十几个测试全红,最后嫌烦一把全删了——这是很多 vibe 项目"有测试"变成"没测试"的真实路径。第一版测试只写 10 个左右的断言,全部对准"错了会赔钱"的纯逻辑:价格计算、折扣叠加、权限边界。UI 测试一个不写,留给后面的预览部署和冒烟检查。
build:把生产环境差异提前引爆。这个 Job 的价值不在"编译",而在"用和生产一致的环境编译"。Node 版本写死(见下一节模板),环境变量缺失要在 build 时炸,不要等到用户访问时才 500。特别提醒 mac 用户:文件名大小写问题只在 Linux runner 上现形,AI 生成 import ... from './UserCard' 而文件实际叫 usercard.tsx,本地跑得好好的,部署就 404。
deploy-smoke:下一节单独给模板,这里先定原则。它是整条流水线里唯一跑在"生产刚部署完"时刻的 Job,前面四个 Job 回答"代码对不对",它回答"线上活没活"。5 个断言、60 秒内跑完,细节见第 6 节。
最后是一条总闸:5 个 Job 全加起来,PR 级流水线超过 5 分钟就要砍东西。慢的流水线等于没有流水线——你会开始"不等结果就 merge",然后在某天凌晨为此还债。缓存依赖、并行跑 Job(lint/typecheck/test/build 相互不依赖,完全可以并行),这些不是优化,是底线。
GitHub Actions 最小 YAML 模板:复制即用
下面这份 .github/workflows/ci.yml 是按上一节决策表落地的最小可用版本。复制过去,改三处就能跑:Node 版本、包管理器命令、最后的部署脚本。注释里写了每个"看似随意"的选择背后的理由。
name: ci

on:
  push:
    branches: [main]
  pull_request:

# 同一分支有新 push,自动取消还没跑完的旧 run。
# 省 Action 分钟数,也省你盯着过期结果等的时间。
concurrency:
  group: ${{ github.workflow }}-${{ github.ref }}
  cancel-in-progress: true

jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: 20
          cache: npm
      - run: npm ci
      - run: npm run lint

  typecheck:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: 20
          cache: npm
      - run: npm ci
      # 即 tsc --noEmit,在 package.json 里配好这个 script
      - run: npm run typecheck

  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: 20
          cache: npm
      - run: npm ci
      - run: npm test -- --run

  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: 20
          cache: npm
      - run: npm ci
      - run: npm run build
        env:
          # build 时只给"构建期公开变量",真正的密钥
          # 只在 deploy job 里出现,别在这里泄漏
          NEXT_PUBLIC_SITE_URL: https://example.com

  deploy:
    needs: [lint, typecheck, test, build]
    # 只有 main 分支走部署,PR 只跑前面四个检查
    if: github.ref == 'refs/heads/main'
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      # 换成你的实际部署命令:vercel / fly / rsync / docker push
      - run: ./scripts/deploy.sh
      # 部署后 60 秒冒烟检查(第 6 节的脚本),失败则整条流水线变红
      - run: ./scripts/smoke.sh "$PROD_URL"
模板里藏了四个决定,逐个解释,免得你"优化"掉它们。
第一,npm ci 而不是 npm install。ci 严格按 lockfile 安装,装出来的依赖树每次都一样;install 会顺手升级小版本,"昨天还绿今天全红"的灵异事件,一半是它干的。vibe 项目依赖本来就是 AI 一路装过来的,lockfile 是你唯一的可复现性,别亲手扔掉。
第二,每个 Job 都独立 checkout + install,不搞产物传递。有人会觉得四个 Job 重复装四次依赖是浪费,想用 artifacts 把 node_modules 传来传去。别。并行跑四个 Job,总耗时取决于最慢的那个,install 的 40 秒在并行里几乎不增加总时长;但 artifacts 传递引入的是一整套新的失败模式(压缩、上传、下载、解压、版本对齐)。记住总闸:5 分钟内跑完就别折腾,等真超时了再优化。
第三,Node 版本写死 20,且和生产运行时对齐。模板里的 20 不是推荐值,是占位符——去看你的生产环境(Vercel 的 Node 版本设置、Dockerfile 的 FROM node:...、服务器上的 node -v),填成同一个数字。CI 和生产用不同大版本,是给自己埋"本地 20 能跑、生产 18 炸"的雷。
第四,concurrency 取消旧 run。你一天推 20 次,没有这个配置,第 3 次 push 的 CI 结果会被第 1、2 次的排队拖成 15 分钟前的旧闻。有了它,永远只有最新一次 push 在跑,Action 分钟数直接省一半。这是模板里最便宜的一行,ROI 最高。
Python 项目把 setup-node 换成 setup-python + cache: pip,typecheck 换成 pyright 或 mypy,骨架完全一样。Go/Rust 同理,换 setup action 即可——这份模板的价值在结构,不在语言。
预览部署:把"AI 视觉验收"变成标准动作
如果 5 个 Job 只能留一个"最超值"的,我会投给预览部署——不是因为它技术含量高,而是因为它解决的是 AI 时代特有的 bug 类型:静默的视觉破坏。
AI 改 CSS 是静默的。它调了个 flex 布局、换了个间距 token,lint 全绿、类型全绿、测试全绿,diff 里看着就是几行 className 变化。你肉眼 review?20 个文件的 PR,你根本不会逐行看样式 diff。等发现时,已经是用户截图发群里了。预览部署解决的就是这个:每个 PR 自动生成一个可点的链接,Vercel、Netlify、Cloudflare Pages 都是零配置自带,GitHub App 会在 PR 下方自动评论贴出链接。
光有链接还不够,要把它变成流程。做法分三步。第一步,在仓库的 PR 模板(.github/pull_request_template.md)里加一行 checklist:- [ ] 预览链接已打开,关键页面视觉确认无回归。别小看这一行,它把"看一眼预览"从自觉变成制度。
第二步,把视觉验收外包给 AI——对,让 AI 检查 AI 写的代码。话术模板可以直接用:"打开这个预览链接(附 URL),再打开 main 分支的预览链接做对比,截取首页、定价页、移动端 390px 宽度的三张截图,列出所有视觉差异,忽略文案变化,只报布局、错位、溢出、空白问题。" 你会发现 AI 找 CSS 回归比人仔细得多,因为它真的会逐像素对比描述。
第三步,一行命令的截图脚本,放在仓库里当公共设施:
# 先装一次:npx playwright install chromium
# 用法:./scripts/shot.sh <预览URL> <输出文件名>
npx playwright screenshot \
  --viewport-size=1440,900 \
  --full-page \
  "$1" "$2"
移动端再加一行 --viewport-size=390,844 的。AI 验收时直接调用这个脚本,截图文件路径固定,流程就闭环了。
保留/砍掉判断:任何有 UI 的项目都保留,这是 vibe coder ROI 最高的 CI 功能;纯 API、CLI、定时脚本项目砍掉,用第 6 节的冒烟检查代替。一个冷知识:预览部署的链接也是你发给朋友"帮我看看"的最佳载体——真人验收和 AI 验收可以并行,不冲突。
数据库迁移门禁:先在 staging 炸,再上生产
vibe 项目炸库有一个经典剧本,值得你提前背下来:agent 写了个 migration,把某个字段从可选改成必填,本地 SQLite 跑通了,测试全绿,CI 全绿,部署到生产——Postgres 表里有 3 万行旧数据的那个字段是 NULL,迁移直接锁表报错,回滚都找不到北。代码层面的 CI 拦不住这个,因为问题不在代码,在数据。
解法是给迁移单独设一道门禁,SOP 只有四步,今晚就能落地。
第一步:migration 文件必须进 PR,CI 里对着空库实跑一遍。在 CI 里加一个小 Job(或并到 test Job 里):起一个一次性的数据库容器,对空库执行全部 migration。Prisma 就是 prisma migrate deploy 对着测试库跑一遍,Drizzle 跑 drizzle-kit migrate,Alembic 跑 alembic upgrade head。这一步拦住的是"migration 文件本身写错了"——AI 生成 SQL 的手艺远不如它生成 TypeScript 的手艺,语法错误、引用不存在的表名,在这里现形。
第二步:staging 环境自动跑迁移,冒烟通过才放行生产。你需要一个 staging 环境——不用多花钱,同一台服务器/同一个 Vercel 项目下再建一个 preview 环境,连一个独立的 staging 数据库。部署流水线的顺序写死:部署 staging → 跑迁移 → 冒烟检查 → 部署生产 → 跑迁移 → 冒烟检查。staging 的数据量可以小,但表结构必须和生产一致。这一步拦住的是"迁移在真实数据上跑不动",比如上面那个 NULL 字段的坑。
第三步:破坏性变更走 expand-contract,分两次发布。删列、改列类型、加非空约束,这三类操作永远不要一次上线。标准姿势:第一次发布加新列、代码双写新旧两列;确认数据追平后,第二次发布删旧列、去掉双写。是的,这意味着你要发两次版,慢一天。但对比"线上炸库+丢数据+熬夜修",这一天是你花过最值的成本。让 AI 帮你写 migration 时,直接在提示词里加一句"用 expand-contract 模式,破坏性变更拆成两次迁移",它做得比你叮嘱一百遍靠谱。
第四步:铁律——永远不在生产上手敲迁移命令。迁移只能由流水线执行,不能 ssh 上去手跑。手跑的迁移没有记录、没有回滚路径、出了问题你都不知道当时到底执行了哪条语句。把这条写进你的部署脚本注释里,写给三个月后的自己看。
再补两个各生态一句话要点。Prisma 用户:CI 里跑 prisma migrate diff --from-empty --to-schema-datamodel prisma/schema.prisma 能发现"改了 schema 忘生成迁移"的漂移;Drizzle 用户:drizzle-kit check 干的是同一件事;Alembic 用户:给每个迁移手写 downgrade(),AI 生成的 downgrade 十有八九是错的,自己花两分钟看一眼。门禁的本质就一句话:让迁移在伤害不到用户的地方先炸一次。
部署后 60 秒冒烟检查:5 个自动断言
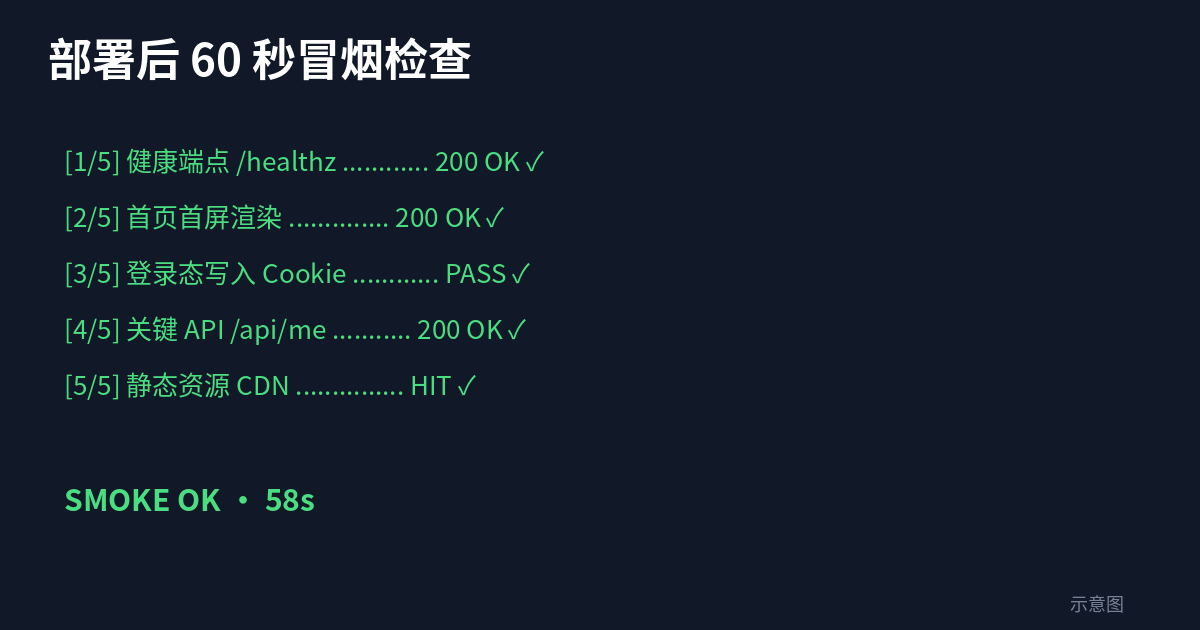
前面 5 个 Job(算上迁移门禁是 6 道)回答的都是"发布前代码对不对"。冒烟检查回答的是另一个问题:"线上真的活了,并且活得对吗"。它是整条流水线里唯一跑在"生产刚部署完"这个时刻的 Job,定位不是测试,是值班的 pager——5 个断言,60 秒内跑完,多一个都嫌多。
断言 1:健康端点返回 200,且数据库是通的。GET /api/health 必须返回 200,body 里 db 字段必须是 ok。注意后半句:只检查进程活着的健康端点是自欺欺人,多少次线上事故是"应用活着、数据库连不上",用户看到的全是 500。
断言 2:首页 200,且包含关键标识。光 200 不够——部署了个空白页、CDN 缓存了个旧 502 页面,状态码照样是 200。断言 body 里包含你的 <title> 或一句页面独有的文案 marker,确认"渲染出来的是我的站,不是一张皮"。
断言 3:关键转化页 200。每个产品都有那么一两个"挂了就等于没上线"的页面:定价页、结算页、核心功能页。列出来,逐个 curl。AI 最爱在重构路由时"顺手"改坏某个不常用的页面路径,而你的测试恰好没覆盖它。
断言 4:登录态走通。用测试账号调登录接口拿 token,再拿 token 调一个需鉴权的接口,期望 200。auth 中间件、JWT 密钥、cookie 域名,这三样是 AI 重构时的高危区,也是"首页看着一切正常、用户一登录就炸"的经典盲区。这个断言值千金。
断言 5:部署后 5 分钟内 5xx 数量为 0。查你的日志或监控 API(Sentry、Logtail、云厂商日志服务都有 API)。如果暂时没接监控,降级方案:对健康端点连续请求 3 次,带退避重试(5s → 10s → 20s),应对冷启动和滚动部署中的实例切换。
实现就是一个 bash 脚本 scripts/smoke.sh,任何一个断言失败就 exit 1,deploy job 变红,你收到失败通知。骨架如下,按自己站点的路径改:
#!/usr/bin/env bash
# 用法:./scripts/smoke.sh https://your-site.com
set -euo pipefail
BASE="$1"

fail() { echo "SMOKE FAIL: $1" >&2; exit 1; }

# 断言 1:健康端点 + 数据库连通(带退避重试,应对冷启动)
for i in 1 2 3; do
  BODY=$(curl -sf "$BASE/api/health") && break || sleep $((i * 5))
done
[ -z "${BODY:-}" ] && fail "health endpoint unreachable"
echo "$BODY" | grep -q '"db":"ok"' || fail "db not ok: $BODY"

# 断言 2:首页包含关键标识
curl -sf "$BASE/" | grep -q "<title>Your Site" || fail "homepage marker missing"

# 断言 3:关键页面
for path in /pricing /app/dashboard; do
  curl -sf -o /dev/null "$BASE$path" || fail "critical page $path not 200"
done

# 断言 4:登录态(测试账号的密码放 CI secrets 里)
TOKEN=$(curl -sf -X POST "$BASE/api/auth/login" \
  -H 'Content-Type: application/json' \
  -d '{"email":"smoke@test.local","password":"'"$SMOKE_PASSWORD"'"}' \
  | grep -o '"token":"[^"]*"' | cut -d'"' -f4)
[ -z "${TOKEN:-}" ] && fail "login failed"
curl -sf -o /dev/null -H "Authorization: Bearer $TOKEN" \
  "$BASE/api/me" || fail "authed request failed"

echo "SMOKE OK"
断言 5(5xx 计数)各家监控 API 不同,没法给通用脚本,原则是:有监控就查 API,没有就先用"健康端点连击 3 次"顶着,等接了 Sentry 再补。记住冒烟检查的自我修养:超过 60 秒、超过 5 个断言的,就不是冒烟检查,是 E2E——请出门左转看下一节的反模式第四条。
反模式:4 个最常见的过度设计
流水线搭起来之后,最大的敌人不是"没覆盖到",而是"过度设计"。一人项目的 CI 死法里,被复杂性压垮的比被 bug 炸掉的多。下面四个,每一个我都见过真实案例,每一个的"正确姿势"都比"错误姿势"短一半。
反模式 1:测试矩阵。Node 16/18/20 × Ubuntu/macOS/Windows,全组合跑一遍,9 个 Job 起步。问一句:你部署在几个运行时上?答案是一个(你的 Dockerfile 里写死的那个,或 Vercel 给你的那个)。你部署在哪个运行时,就测哪个运行时,矩阵剩下的 8 个组合烧的都是你的免费分钟数。保留矩阵的唯一理由:你在发布 npm 包给全世界用,别人的环境你控制不了。一人项目?单版本,写死,对齐生产,结束。
反模式 2:环境过多。dev、staging、qa、preprod、canary,五个环境配下来,CI yaml 比业务代码还长。真相是:每多一个环境,配置漂移的风险就翻一倍,而你没有运维团队去对齐它们。一人项目的标准答案是 staging + prod 足够,qa 的位置由 PR 预览部署顶掉(第 4 节)。环境少,恰恰意味着每个环境都被认真对待。
反模式 3:通知轰炸。每个 Job 成功都往 Slack 发一条"✅ lint passed",一天 20 次 push,频道里 100 条绿勾。一周后你把通知频道静音了——然后真正的失败告警也被一起静音了。正确姿势:只通知失败,且失败通知里带直达失败 log 的链接,一次点击就能看到报错。成功的流水线最好的通知就是没有通知。
反模式 4:全量 E2E 每个 push 都跑。Playwright 50 条用例跑 20 分钟,flaky 率 10%,于是流程退化成"红了就重跑,绿了就 merge"——E2E 在这个时候已经失去了全部意义,还顺手教会了你无视红灯。正确姿势:3–5 条核心链路的 E2E,只在 PR 合入 main 之前跑一次;push 到 feature 分支不跑,日常靠第 6 节的 60 秒冒烟检查兜底。E2E 是奢侈品,按奢侈品的频率用。
四个反模式背后是同一句话:一人项目的 CI,简单是 feature,不是将就。你维护流水线的时间,是从写业务代码的时间里扣的。
今晚就能落地的清单
读到这里,行动清单只有四项,按顺序做,今晚就能跑起来:第一,把第 3 节的 YAML 复制到 .github/workflows/ci.yml,改掉 Node 版本和部署命令,推一次看它变绿;第二,写 scripts/smoke.sh,先实现断言 1–4,断言 5 等接了监控再补;第三,打开 Vercel/Netlify 的 PR 预览(大概率已经开了),在 PR 模板里加那行视觉验收 checklist;第四,给数据库加上 staging 门禁,migration 从此只走流水线。
顺序也有讲究:先让流水线跑起来、变绿,再让它变聪明。第一版甚至可以只有 lint + build + smoke 三个 Job——"不完美但每天都在替你看"的流水线,碾压"设计完美但下周才上线"的流水线。
最后回到开头那个问题。CI 的终极指标不是覆盖率,不是 Job 数量,是一个很私人的问题:今天晚上,你敢不敢在睡觉前点下那个 merge。敢,这条流水线就值了。
相关文章
vibe coding 一周就能做出浏览器扩展,但上架商店是另一套游戏规则。本文一次讲透三家商店选型、MV3 迁移 5 大坑、权限最小化、隐私政策模板、商店物料 SOP、被拒急救包与发版灰度,帮一人开发者把扩展真正送进商店。
AI 改代码最怕改 A 坏 B。本篇是《AI 测试策略》的执行层续篇:用 Playwright 加 5 条黄金路径、data-testid 约定与 GitHub Actions,一小时搭起一人团队的 E2E 回归护城河,每周只花 1 小时维护,免费额度内跑完,并附可直接复制的配置、测试与 CI 代码。
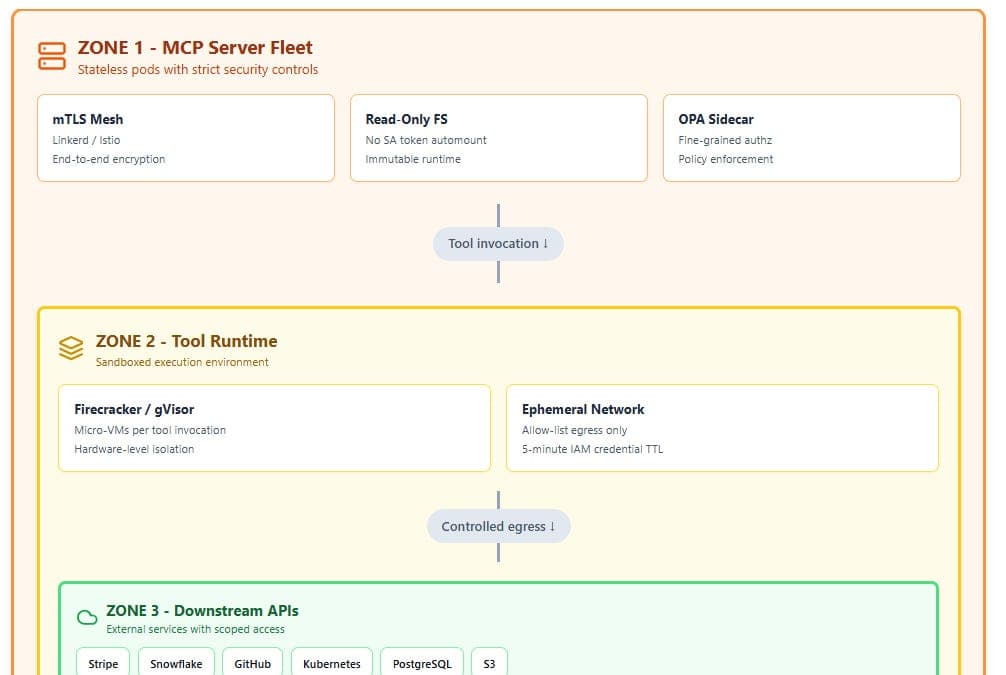
谷歌、摩根大通、Weaviate、法国 DINUM、印尼 Tangerang 市政府——五支互不相关的安全团队,各自独立确认并修复了自家 MCP 服务器里的同一个 SSRF 漏洞。独立研究者 Syed Anas Mohiuddin 的十月更新指出:这是协议设计的结构性缺陷,而非某家的实现问题。本文拆解 Protocol Pivoting 攻击原理、对比五家修复方案,并给 vibe coder 一份最小防御清单,附 10 月 23 日 MCPCon 演讲前瞻。