三个月后你连自己都看不懂:vibe 项目的 ADR 架构决策记录实战
AI 写代码快,决策散落更快。本指南给一人团队引入 ADR(架构决策记录):一份真实五段式模板、'只记不可逆'原则(每月 2-3 篇)、让 AI 起草的 prompt、以及每季度复审与 superseded 考古层。
开篇先划界:ADR 管"为什么",不跟"怎么做"抢活
站内已经有 AGENTS.md 指南和 spec-driven 开发指南——它们管的是"怎么做"(工作流、规范、执行)。这篇讲的是"为什么这么做":当初为什么选 Postgres 而不是 SQLite?为什么鉴权用 JWT 而不用 session?这些决策的理由,三个月后连你自己都想不起来,AI 就更不知道了。ADR(Architecture Decision Records,架构决策记录)就是给"为什么"建一个档案室。本文只讲决策记录,不复述工作流规范。
AI 写代码越快,"为什么"丢得越快
vibe coding 有一个隐形税:代码产出速度提高了 10 倍,但决策的"半衰期"没变。你让 AI "选个数据库",它 30 秒给你搭好 Postgres, migration 跑通,测试全绿。你很满意,继续往下写。三个月后,用户量上来了,你想起一个问题:当初为什么是 Postgres?是因为需要 JSONB?还是因为 AI 随手选的?如果答案是后者,现在切 SQLite 能省一台服务器的钱——但你不敢切,因为你不记得当初排除了哪些选项、踩过哪些坑。
更常见的是 agent 会话的"失忆循环":你新开一个会话,让 AI 重构支付模块,它问"这里为什么用 Stripe 而不用 Paddle?"你解释一遍;下周另一个会话,又问一遍。同样的问题,每次都要重新支付解释成本。代码里的注释写"是什么",文档写"怎么用",但"为什么是这个而不是那个"——这个知识没有地方住,于是它住在你的脑子里,而你的脑子是全团队最不可靠的存储。
ADR 解决的就是这个问题:用一种轻到不烦、重到有用的格式,把"不可逆的决策及其理由"记下来,存进仓库,跟代码一起版本化。
ADR 长什么样:一份真实模板
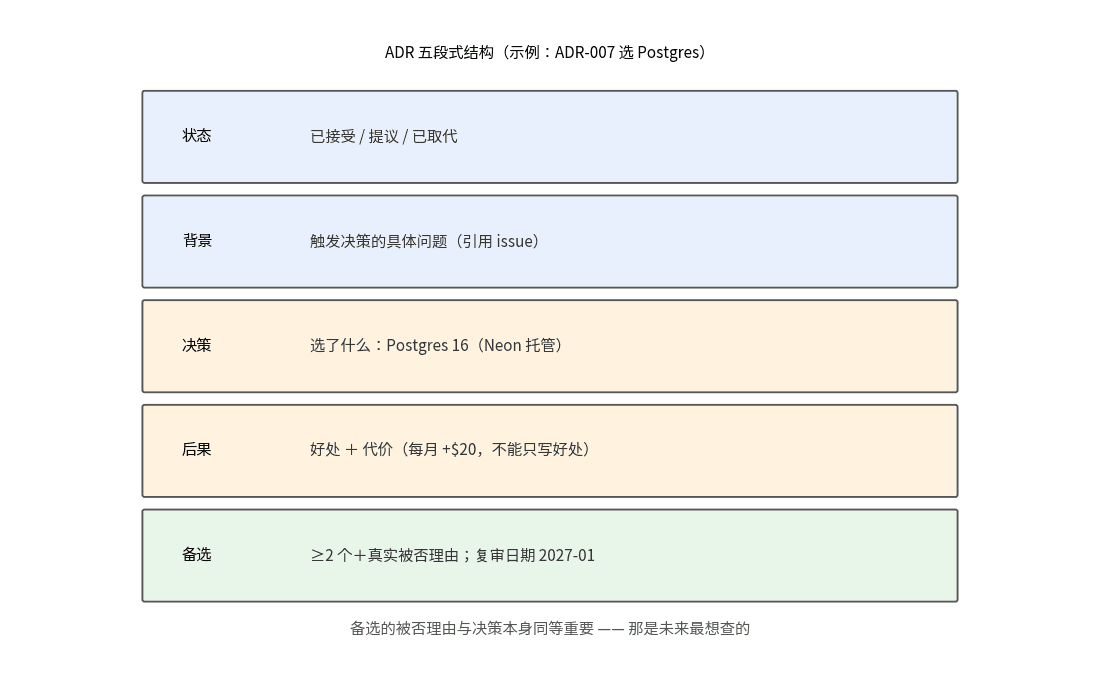
ADR 的经典格式来自 Michael Nygard,只有五个部分。一人团队可以再砍,但别砍出骨头。下面是一份真实可用的例子:
# ADR-007:在 Postgres 与 SQLite 之间选择 Postgres

- 状态:已接受(2026-10-16)
- 背景:用户量突破 2000 后,SQLite 在高并发写下出现锁等待;
  且未来 6 个月计划上多租户,需要行级安全策略(RLS)。
- 决策:生产环境使用 Postgres 16(Neon 托管),开发环境保持
  SQLite(零配置、测试快),通过 Drizzle 抽象抹平差异。
- 后果:
  - 好:并发写不再排队;RLS 可用;备份有 PITR。
  - 坏:每月多 ~$20 托管成本;本地开发需 docker 起 Postgres
    (见 devcontainer 指南)。
- 备选:
  - 纯 SQLite + WAL:被否,写并发天花板仍在,且 RLS 无解。
  - 自建 Postgres:被否,一人团队不值得为省 $20 背运维债。
- 复审:2027-01 复审,若用户量未达 1 万,考虑降回纯 SQLite。注意这份记录的三个特点。第一,备选和被否理由跟决策本身同等重要——"为什么不用 X"是未来你最想知道的,也是 AI 最容易重复踩坑的。第二,后果诚实写坏处,每月多 20 美元这种"小代价"现在看着不起眼,续费三年就是 720 美元,写下来才不会自我美化。第三,带复审日期——决策不是墓碑,是租约,到期重审。
 ADR 五段式文档结构图:状态、背景、决策、后果、备选与复审日期
图 1:ADR 文档五段式结构——状态、背景、决策、后果(含代价)、备选与复审日期,备选的被否理由与决策同等重要。
何时写:只记"不可逆"的,一人团队每月 2-3 篇足矣
ADR 最大的坑是写太多。判断标准只有一个:这个决策逆转起来贵不贵?选数据库、选鉴权方案、选 monorepo 还是多仓库、选自研还是买 SaaS——逆转成本以"周"计,值得一篇 ADR。变量命名、代码风格、某个函数的实现方式——逆转成本以"分钟"计,不值得,让它烂在 git log 里。
一个实用的触发器清单,满足任意一条就写:1)换掉它要动 3 个以上文件;2)它影响钱(成本、定价、供应商);3)它影响安全或合规;4)你向 AI 解释过两次以上同一个"为什么"。第 4 条是 vibe 时代的特色:凡是需要你重复解释的,就是该进 ADR 的。
存放位置:docs/adr/,文件名 0007-postgres-over-sqlite.md(编号递增,标题 slug 化)。再配一个 docs/adr/README.md 当索引表:编号、标题、状态、日期四列。新会话的 AI 读一遍索引,就获得了你三个月的决策记忆——这比任何"项目记忆插件"都可靠,因为它是你亲手写的、带理由的。
让 AI 替你起草 ADR(但你来拍板)
写 ADR 最烦的是"坐下来写"这个动作。vibe 时代的正确姿势是反过来的:让 AI 在每次大重构或技术选型后自动生成草稿,你只做 5 分钟的 review 和拍板。prompt 可以这样写:
根据本次会话的改动,生成一份 ADR 草稿存到 docs/adr/ 下一个新编号:
1. 状态先标"提议",别替我拍板;
2. 背景写清楚触发这次改动的具体问题(引用 issue 或报错);
3. 备选至少列 2 个,写出每个被否的真实理由,不要编;
4. 后果必须包含代价(成本/复杂度/运维负担),不许只写好处;
5. 给出复审日期建议。
review 清单(5 分钟):备选的被否理由是真实的还是 AI 编的?(这是最容易注水的地方)代价写全了吗?复审日期合理吗?三条都过,把"提议"改成"已接受",commit。注意第 3 条的"不要编"——AI 为了凑数会发明一些你没考虑过的备选,review 时删掉,保持 ADR 的诚实。
 ADR 五段式文档结构图:状态、背景、决策、后果、备选与复审日期
图 2:ADR 生命周期——提议 → 讨论/拍板 → 已接受 → 落地 → 到期复审(维持 / 修订 / 标记为 superseded)。
ADR 的三种反模式(别这么写)
反模式一:写成"实施日志"。"10-16 把数据库从 SQLite 换成 Postgres,改了 12 个文件"——这是 git log 干的事,不是 ADR。ADR 回答"为什么换",不回答"怎么换的"。检验方法:遮住"决策"段,如果剩下的内容跟 git log 没区别,这篇 ADR 就是废的。
反模式二:备选只写空气。"备选:无"或者"备选:继续用 SQLite(不好)"——这种备选等于没写。备选的价值在于记录"被否的真实理由",而真实理由往往藏着未来的复活机会:比如"自建 Postgres 被否是因为一人团队背不起运维债"——等你团队到 5 个人那天,这条被否理由自动失效,ADR 自己会提醒你重审。写空气备选,等于亲手埋掉未来的路标。
反模式三:一次写完,永不复审。没有复审日期的 ADR 是只写不读的文档,三个月后跟不存在一样。强制规则:每篇 ADR 必须有复审日期,状态为"已接受"的 ADR 过了复审日期还没重读,CI 里加一条 lint 让它变红——docs/adr 下任何文件的复审日期早于今天,就报错。纪律进流水线,就不需要靠记性。复审时别只看"要不要改",更要看"当初的假设哪些被证伪了"——被证伪的假设是团队最值钱的学习资产,值得单独记一笔。
决策也会过期:每季度重读一次
ADR 不是写完就供起来的。每季度花 30 分钟,把 docs/adr/ 从头读一遍,问三个问题:当初的背景还成立吗?代价还在付吗?有更好的选项出现了吗?结论有三种:维持(更新复审日期)、修订(出一篇新 ADR 引用旧编号,旧的状态标为 superseded)、撤销(决策被推翻,记录原因——撤销记录本身也是知识)。
superseded 机制是 ADR 最被低估的设计:它保留了完整的决策考古层。一年后你想知道"我们为什么从自研切到买 SaaS",git 历史里躺着 ADR-003(自研,已被取代)和 ADR-011(买 SaaS,引用 003),因果链完整。这比翻三个月的聊天记录找"当初谁说的"可靠 100 倍。
ADR 与 AGENTS.md 的联动:让"为什么"自动喂给 AI
ADR 写进 docs/adr/ 只是第一步,第二步是让它进入 AI 的工作记忆。做法很简单:在 AGENTS.md(或 CLAUDE.md)里加三行:"做技术选型前,先读 docs/adr/README.md 的索引;遇到与已接受 ADR 冲突的方案,先问我,不要自作主张换;大重构完成后,按 ADR 模板起草一份状态为'提议'的记录。"这三行把 ADR 从"静态文档"变成了"agent 的决策约束"。
效果是立竿见影的:以前你要反复解释"为什么不用 Paddle",现在 AI 在动手前自己会去查 ADR-004,看到"被否理由:Paddle 的 webhook 延迟在促销期间超过 30 秒",它就不会再提这个方案。更进一步,你可以在每次季度复审时让 AI 先通读全部 ADR 并输出"过期嫌疑清单"(背景已变化、代价已翻倍、备选已消失的三类),你只做最后的拍板——连复审本身都可以半自动化。你的决策记忆,第一次有了不依赖你本人在场的载体。一人团队的知识管理,终点不是"都记在脑子里",而是"脑子里的东西都有地方住"——ADR 就是"为什么"的住处。
一句话:AI 负责把"怎么做"跑得飞快,你负责把"为什么"记得牢。ADR 就是你的决策外接硬盘——每月 2-3 篇,每篇 5 分钟 review,换来的是三个月后的你不再对着代码问"当初是哪个天才选的这个"——这就是 ADR 的回报。
评论 (0)
相关文章
你的代码跑在三个互不相同的环境里:本机、新开的 agent 会话、CI。本文讲 vibe 项目的开发环境标准化:devcontainer.json 全模板(Node+Postgres 逐字段解释)、nix flakes 终极形态,以及 15 分钟最小可行版。
AI 生成的代码没有可靠性概念,一切都靠'感觉挺快'。本指南给一人团队补上 SRE 决策层:SLI/SLO/错误预算三概念一人版、两档烧蚀率告警、最小实现(一个 SQL + 一个 cron + 状态页一句话),以及'预算烧完就冻结发版'的纪律。
AI 生成的下单代码从不考虑并发:两个用户同时点购买,库存变负、余额被 double-spend。本篇从竞态三现场讲起,覆盖事务隔离级别选型、乐观锁(version 列)与悲观锁(SELECT FOR UPDATE)的取舍、幂等键防重放、热点写入的队列串行化,以及 Prisma / Drizzle 的事务实战代码,开箱即用的落地清单。