慢多少算事故:vibe 项目的错误预算(SLO)实战
AI 生成的代码没有可靠性概念,一切都靠'感觉挺快'。本指南给一人团队补上 SRE 决策层:SLI/SLO/错误预算三概念一人版、两档烧蚀率告警、最小实现(一个 SQL + 一个 cron + 状态页一句话),以及'预算烧完就冻结发版'的纪律。
开篇先划界:这篇讲"定标准",不讲"测"和"看"
站内已经有三篇相邻的指南,先把分工说清楚,免得你读重了:k6 压测指南讲"怎么测出系统的极限"(手段),上线第一周监控指南讲"上线后看什么指标"(手段),慢查询指南讲"数据库慢了怎么查"(手段)。这篇讲的是另一层:慢多少算事故?——给核心链路定下可度量的可靠性标准(SLO),配上错误预算,再配上"预算烧完就冻结发版"的纪律。这是 SRE 的决策篇,不是工具篇。
为什么一人团队需要这个?因为 AI 生成代码的默认状态是"没有可靠性概念"。它会给你写出 P99 延迟 8 秒的查询、偶发 500 的支付回调、以及"我感觉挺快"的主观验收。而"感觉"是最贵的度量方式——它总是在用户流失之后才告诉你真相。
三个概念,一人团队版
SLI(服务水平指标):你选定的度量。比如"下单接口的成功率""首页的 P99 延迟"。一人团队只给核心链路定 SLI:下单、支付、登录。博客的"关于我们"页面不需要 SLI。
SLO(服务水平目标):SLI 要达到的数值。比如"下单成功率 99.9%""P99 延迟 < 800ms"。注意 SLO 不是 100%——100% 是许愿,99.9% 是工程。
错误预算(Error Budget):100% − SLO,就是你"允许搞砸"的额度。99.9% 的 SLO 意味着每月允许 43 分钟的故障时间(30 天 × 0.1% ≈ 43.2 分钟);99.95% 是 21.6 分钟;99% 是 7.2 小时。错误预算是这三个概念里最重要的一个,因为它把"可靠性"翻译成了一种货币:预算没花完,你可以大胆发版、上新功能;预算花完了,停下手里的一切,先还可靠性这笔债。
这个"货币"隐喻是一人团队最需要的纪律。没有错误预算时,你的决策是情绪化的:"这个 bug 好像挺严重,要不要 hotfix?""新功能再不上用户要跑了"。有了错误预算,决策变成算术:预算还剩 60%,新功能继续上;预算只剩 5%,冻结发版,全员(就是你)修可靠性。Google SRE 的原话是"用错误预算来调和产品开发和运维之间的结构性冲突"——一人团队里,这个冲突发生在你一个人的左右脑之间,预算就是裁判。
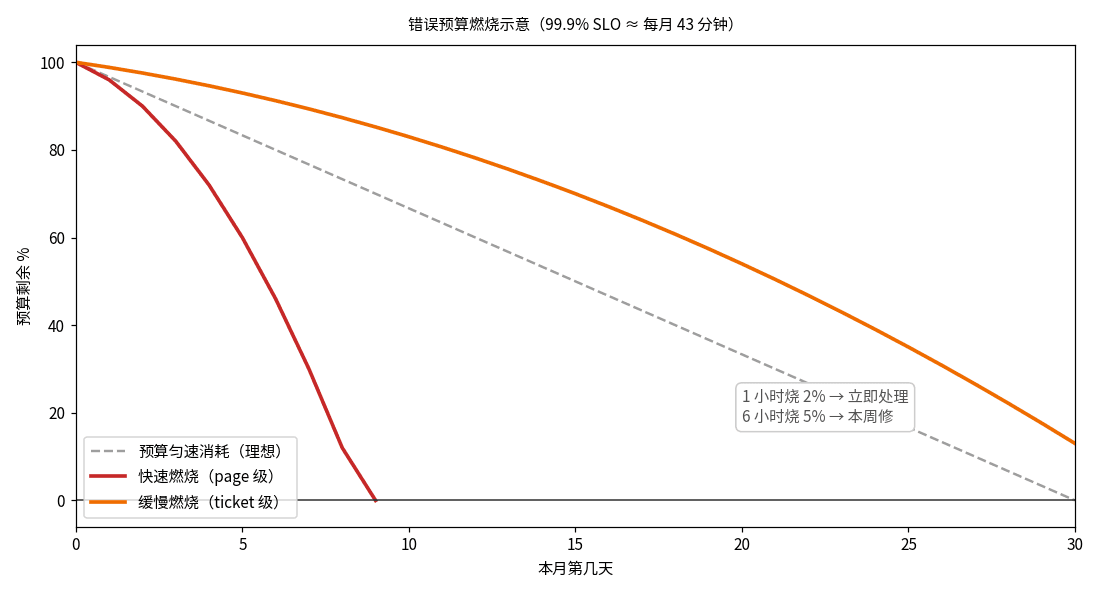
 错误预算燃烧图:月度预算随故障消耗,标注快速燃烧与缓慢燃烧告警线
图 1:错误预算燃烧示意——预算总量(99.9% SLO ≈ 每月 43 分钟)随故障消耗,快速燃烧与缓慢燃烧触发不同级别的告警。
告警分级:别让"阈值告警"半夜叫醒你
定完 SLO,最常见的错误是配阈值告警:"错误率 > 1% 就报警"。阈值告警有两个毛病:一是它不知道你的预算还剩多少(月初 1% 和月末 1% 完全不是一回事),二是它分不清"正在烧预算"和"已经烧完了"。
正确姿势是烧蚀率(burn rate)告警,分两档:
快速燃烧告警(page 级):过去 1 小时烧掉了 2% 的月度预算。换算一下:99.9% SLO 下,1 小时烧 2% 预算 ≈ 错误率飙到约 14%。这种速度 2 天就能烧光整月预算,必须立即处理——打电话、起床、回滚。
缓慢燃烧告警(ticket 级):过去 6 小时烧掉了 5% 的预算。这是"温水煮青蛙"型故障:错误率长期在 2-3% 晃悠,阈值告警觉得"还行",但按这个速度月底预算必穿。不用起床,但要建 ticket,本周内修。
一人团队可以把这套逻辑简化成一条 SQL + 一个 cron(见下文最小实现),不用上 Prometheus 的 multiwindow 全套。关键是观念转变:告警的对象不是"指标超过了某个数",而是"预算正在以某种速度消失"。前者是温度计,后者是油表——开车的人看油表。
最小实现:一个 SQL + 一个 cron + 状态页一句话
别被 SRE 的术语吓到,一人团队的 SLO 落地可以极简:
1. 一个 SQL(算 SLI)。假设你的请求日志表里有 success boolean 和 created_at,下单成功率 SLI 就是:
-- 过去 30 天下单成功率(SLI)
SELECT
  SUM(CASE WHEN success THEN 1 ELSE 0 END)::float / COUNT(*) AS success_rate,
  COUNT(*) FILTER (WHERE NOT success) AS failed_count
FROM request_logs
WHERE route = 'POST /api/orders'
  AND created_at > NOW() - INTERVAL '30 days';
-- success_rate >= 0.999 即 SLO 达标;预算剩余 = (success_rate - 0.999) / 0.001
2. 一个 cron(算 burn rate + 告警)。每小时跑一次上面的 SQL,按 1 小时窗口再算一遍:如果 1 小时窗口的失败数超过"月度预算的 2%",发 page 级通知(短信/电话);如果 6 小时窗口累计超过 5%,建 ticket。通知通道用你已有的(Serverless 成本指南里讲过,别为告警再搭一套系统)。
3. 状态页一句话。在你的状态页(哪怕只是一个 /status 路由)上写:"下单成功率 SLO 99.9%,本月预算剩余 62%。"这句话有两个读者:用户(出问题时他知道你在度量,而不是在"感觉"),和你自己(每天看一眼,预算就是你的发版红绿灯)。
进阶一步:把"预算剩余"接进你的发版流程。预算 < 20% 时,CI 自动给 main 分支加一个 required check:"error-budget-ok",需要你手动确认才能合并新功能 PR。纪律一旦变成代码,就不需要意志力了。还有一个低成本增强:每天早上让 cron 把"昨日预算消耗"推送到你的手机( Bark / Server 酱都行),连续三天消耗为 0 说明系统很稳,连续三天消耗 > 1% 说明有慢性问题在烧——很多"突发大故障"其实是慢性燃烧的最后一根稻草,早看见早处理。
 错误预算燃烧图:月度预算随故障消耗,标注快速燃烧与缓慢燃烧告警线
图 2:SLO 落地决策流——定 SLI → 定 SLO → 算预算 → 配两档烧蚀率告警 → 预算耗尽冻结发版。
SLO vs SLA:一字之差,责任天壤
在定 SLO 之前,先分清两个缩写,别在客户面前说错话。SLO 是你给自己定的目标,达不达标是你内部的事,预算烧完了你自己冻结发版。SLA(服务水平协议)是你跟客户签的合同,写进合同、带赔偿条款——达不到要赔钱/赔服务时长。
一人团队的铁律:可以有 SLO,轻易不要签 SLA。SLA 的每一行字都是未来的负债:99.9% 的 SLA 意味着你承诺了每月最多 43 分钟故障,超了就要按合同赔。一旦签了,你的 on-call 就不再是"尽力而为",而是"违约风险"。除非大客户拿订单逼你签,否则把 SLA 挡在门外,用"状态页 + SLO 公示"代替——既给了客户透明度,又没把自己变成 24 小时待命的赔偿机器。
如果你真的要签(比如企业客户的采购流程硬性要求),三条保命:1)SLA 只覆盖你控制得了的链路(你的 API 成功率,不包括上游云厂商的故障——写清排除条款);2)赔偿只赔"服务时长"不赔现金(credit 比 refund 便宜一个数量级);3)SLA 的数字永远比你的内部 SLO 松一档(内部 SLO 99.9%,对外 SLA 只敢签 99.5%),留出缓冲带。
从 99.9% 到 99.99%:每多一个 9 的代价
很多人定 SLO 时有个冲动:数字越大越专业。来看一张诚实的代价表(按 30 天算):
99% → 每月允许 7.2 小时故障。单机 + 每日备份就能达到,一人团队的起点。
99.9% → 43 分钟。需要健康检查 + 自动重启 + 异地备份,投入约 1-2 天工程量。
99.95% → 21.6 分钟。需要多可用区、数据库主从,投入按周计。
99.99% → 4.3 分钟。需要全链路冗余、混沌演练、专职 on-call——这不是一人团队该碰的数字。
规律很残酷:每多一个 9,可靠性成本大约翻 10 倍,而用户感知到的收益却在递减。从 99% 到 99.9%,用户从"每周都遇到故障"变成"每月遇到一次",感知极强;从 99.95% 到 99.99%,用户一年里多遇到的故障从 4 次变成 1 次——他根本记不得。一人团队的理性选择:核心链路 99.9%,非核心 99%,把省下来的工程时间拿去做新功能。记住,SLO 是花钱买的,每一个 9 都有标价。
三个常见坑
坑一:给所有接口定 SLO。一人团队最多 3 个 SLO:下单/支付/登录(或你的核心链路等价物)。SLO 的数量和你的 on-call 人数成正比——你只有一个人,3 个是上限。多定的 SLO 不会带来更多可靠性,只会带来更多半夜的短信。
坑二:SLO 定成 99.99% 显得专业。99.99% 每月只允许 4.3 分钟故障,你的单机 Postgres 重启一次就超了。SLO 必须是你"踮脚能够到"的数字,不够就先定 99.5%(每月 3.6 小时),达标三个月再收紧。SLO 是拿来指导行动的,不是拿来装裱的。
坑三:预算烧完了继续上新功能。这是错误预算唯一的铁律,也是最难执行的一条。对抗人性的方法是把它写进流程(上面的 CI required check),而不是写进备忘录。记住 SRE 的经典排序:预算充足时,可靠性工作让位给新功能;预算耗尽时,新功能让位给可靠性。没有中间态。
一句话:k6 告诉你系统"能跑多快",监控告诉你系统"现在怎么样",而错误预算告诉你"还敢不敢发版"。前两者是仪表盘,最后一个是方向盘——一人团队开车,方向盘比仪表盘重要。
评论 (0)
相关文章
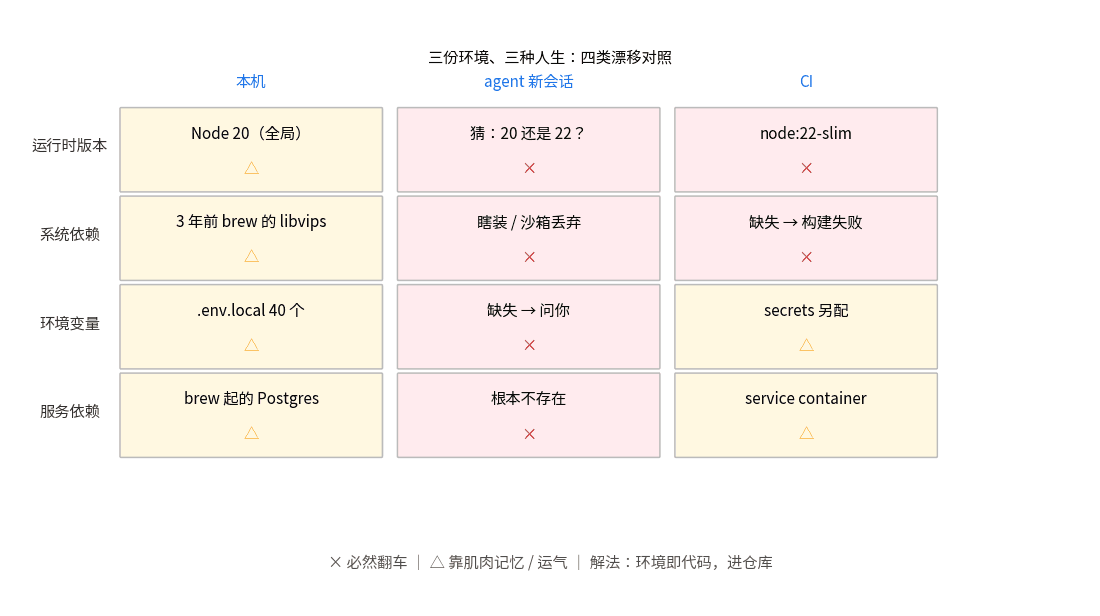
你的代码跑在三个互不相同的环境里:本机、新开的 agent 会话、CI。本文讲 vibe 项目的开发环境标准化:devcontainer.json 全模板(Node+Postgres 逐字段解释)、nix flakes 终极形态,以及 15 分钟最小可行版。
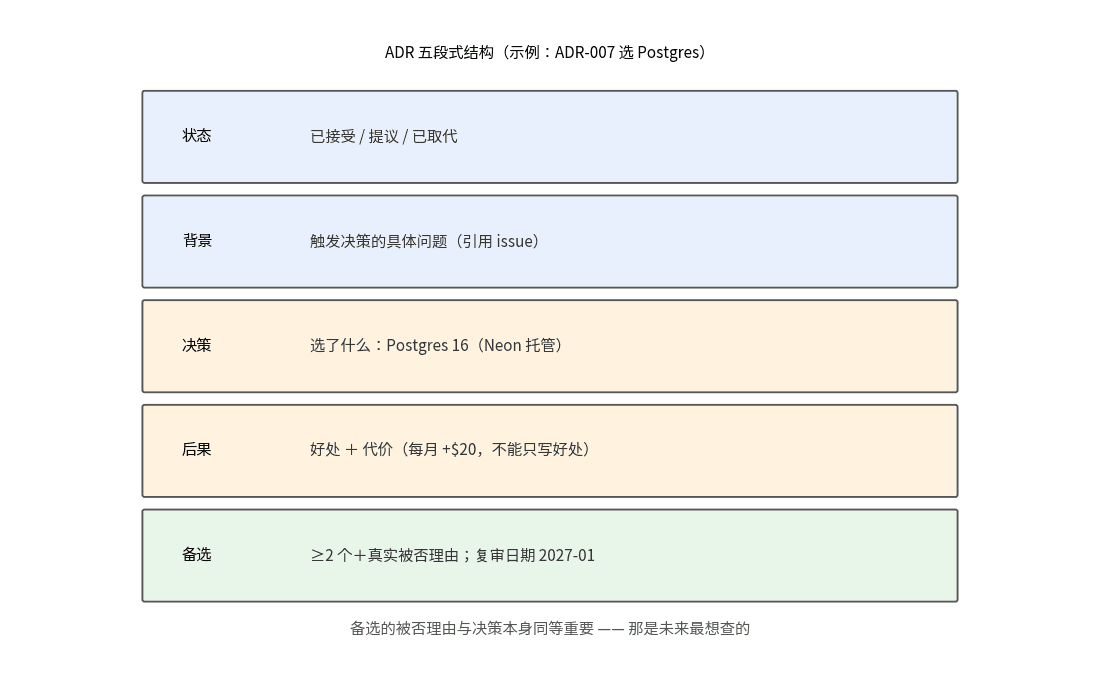
AI 写代码快,决策散落更快。本指南给一人团队引入 ADR(架构决策记录):一份真实五段式模板、'只记不可逆'原则(每月 2-3 篇)、让 AI 起草的 prompt、以及每季度复审与 superseded 考古层。
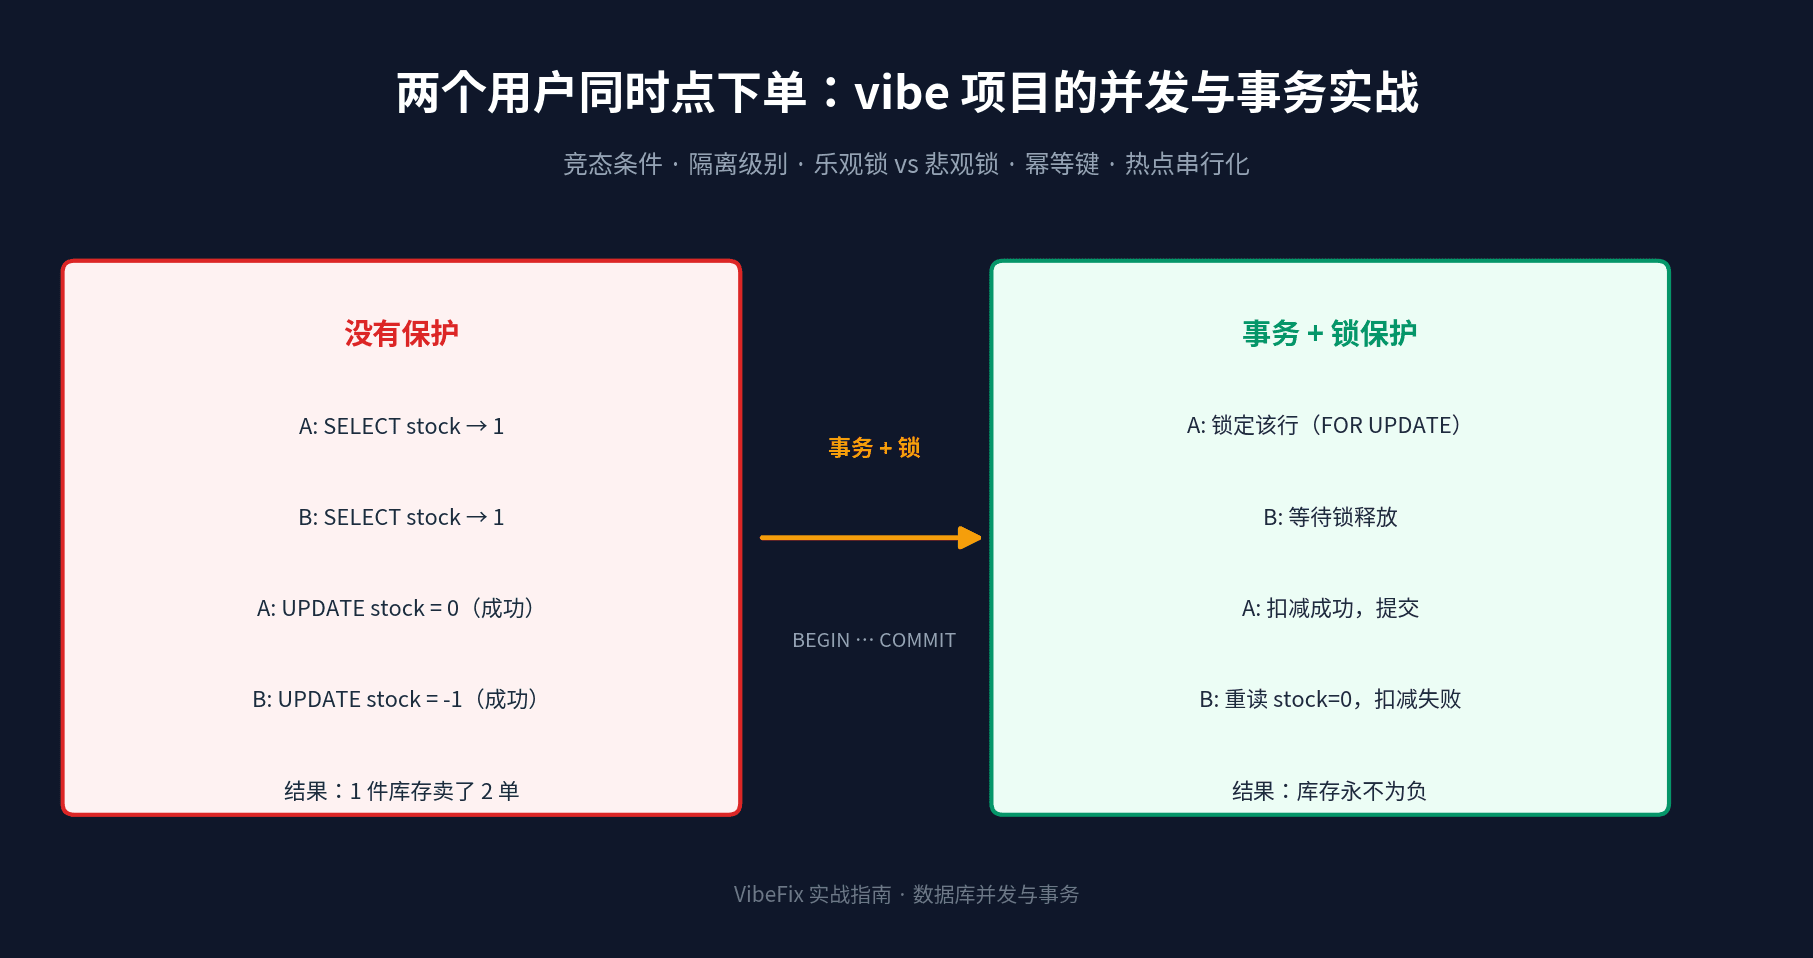
AI 生成的下单代码从不考虑并发:两个用户同时点购买,库存变负、余额被 double-spend。本篇从竞态三现场讲起,覆盖事务隔离级别选型、乐观锁(version 列)与悲观锁(SELECT FOR UPDATE)的取舍、幂等键防重放、热点写入的队列串行化,以及 Prisma / Drizzle 的事务实战代码,开箱即用的落地清单。