两个用户同时点下单:vibe 项目的并发与事务实战
AI 生成的下单代码从不考虑并发:两个用户同时点购买,库存变负、余额被 double-spend。本篇从竞态三现场讲起,覆盖事务隔离级别选型、乐观锁(version 列)与悲观锁(SELECT FOR UPDATE)的取舍、幂等键防重放、热点写入的队列串行化,以及 Prisma / Drizzle 的事务实战代码,开箱即用的落地清单。
先划清边界,再讲正事。本文讲的是数据库与业务层的并发控制:两个请求同时改同一行数据时,怎么保证钱和库存不出错。这和站内 cycle49 那篇资讯《anthropic-claude-dynamic-workflows-october-2026》完全不是一回事——那篇讲的是"一次跑 1000 个子 agent"的 agent 编排并发(任务怎么拆分、怎么并行调度),是计算资源的并行;本文讲的是数据竞争(race condition),是同一份数据被两个写操作同时碰。同一个词"并发",在两个语境下是两门课。
另一个互链:站内指南《vibe-project-credits-ledger-billing-guide》(credits 积分账本)里有一节"幂等扣减",讲的是同一笔扣费被重复执行时如何只扣一次——那是防重放,解决的是"同一个请求来了两次";本文第四节讲的幂等键是同一套思想的通用版,而第一到第三节讲的是"两个不同的请求同时来了"。两者正交,一个系统里通常要同时用上。
为什么 vibe coder 尤其需要这一课?因为 AI 生成的 CRUD 代码几乎从不考虑并发。AI 给你写的下单接口通常是这个形状:先 SELECT 查库存,再在代码里判断够不够,最后 UPDATE 扣减。单人测试时完美运行,上线后第一个促销夜,两个用户在同一秒点下"购买",你的库存就变成了负数。不是 AI 写错了逻辑,而是它没告诉你:"读出来、算一算、写回去"这三步不是原子操作,两个请求可以插进对方的空隙里。
一、竞态条件的三个真实事故现场
现场 1:库存超卖
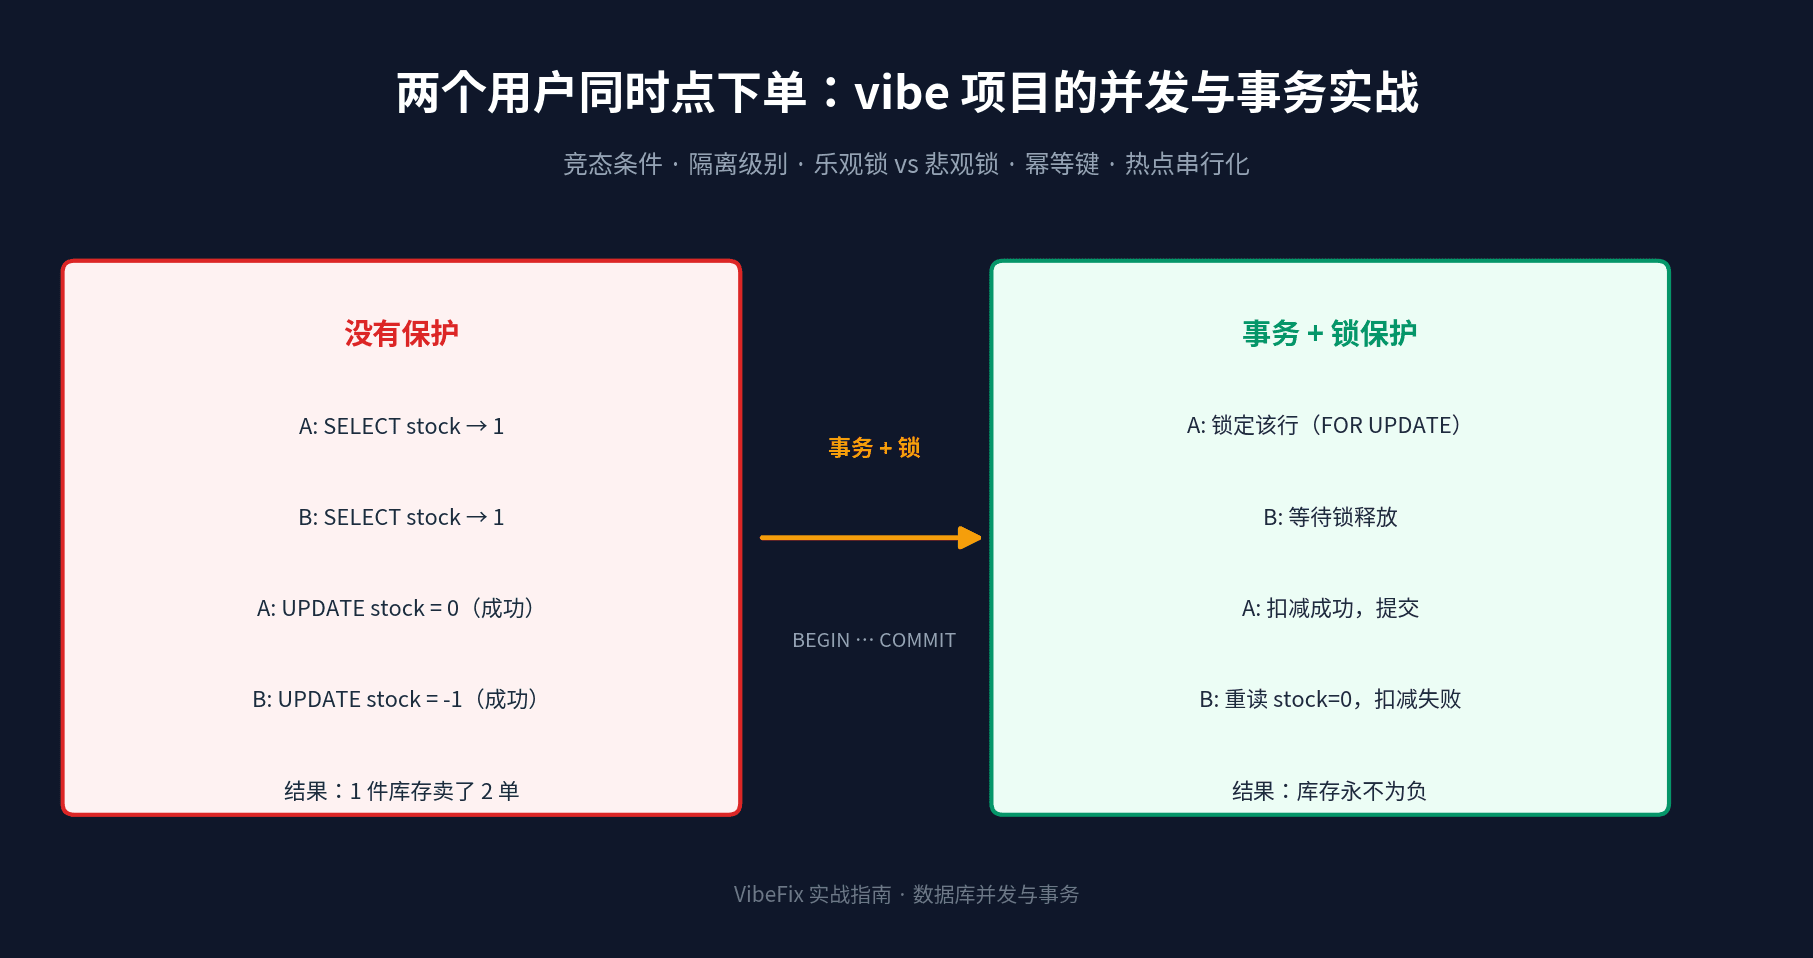
商品只剩 1 件。用户 A 和用户 B 在同一毫秒点下单。两个请求都执行 SELECT stock,都看到 1;都判断"够卖";都执行 UPDATE stock = 0。最终库存是 0——但订单有 2 个。你多卖了一件不存在的货,接下来是退款、客服和差评三连。
现场 2:余额 double-spend
用户钱包余额 100 元。用户同时发起两笔 80 元的提现(两个手机、或者一次点击发了两次请求)。两个请求都读到余额 100,都通过"余额 ≥ 80"的校验,都扣减。最终余额 -60,用户白嫖了 60 元。credits 账本篇里讲的幂等扣减防的是"同一笔提现请求重试两次",而这里防的是"两笔不同的提现请求同时执行"——后者靠幂等键是防不住的,因为幂等键本来就不一样。
现场 3:重复提交
用户填完表单连点三次"提交",或者网络抖动导致浏览器重发了 POST。三个请求带着不同的请求体(或相同的请求体但没有幂等键)到达后端,各自 INSERT 一条订单。用户收到三份确认,仓库发出三件货。这是最常见、也最容易被误认为"前端防抖就能解决"的问题——前端防抖防不住网络重发和 API 被直接调用。
三个现场的共同病根:检查和执行之间有一条缝。数据库只保证"单条语句"是原子的,不保证"你先查、我再改"这个组合是原子的。想把组合变原子,就要请出本文的主角:事务和锁。
并发与事务实战指南封面:无保护的竞态导致超卖,事务加锁保护后库存永不为负" alt="竞态条件时序图:库存为1时用户A和用户B并发下单,双方都读到1并扣减成功,库存变成-1">图 1:竞态时序。A、B 都读到库存=1,各自的"读-改-写"在没有隔离的情况下交错执行,最终超卖。二、事务到底在承诺什么:ACID 的一人团队版
事务(transaction)是数据库给你的四个承诺,记住它们的"人话版"就够了:
- 原子性(Atomicity):事务里的所有语句要么全做、要么全不做。下单时"扣库存 + 建订单 + 扣余额"三条语句,任何一条失败,前面做的全部回滚。不会出现"钱扣了、订单没建"的半吊子状态。
- 一致性(Consistency):事务结束时,数据从一个合法状态到另一个合法状态。比如你给库存列加了
CHECK (stock >= 0)约束,任何想把库存写成负数的事务都会被整个拒绝。 - 隔离性(Isolation):并发执行的事务互相看不见对方的中间状态。这是本文的核心战场,也是最复杂的一个。
- 持久性(Durability):一旦提交(COMMIT),断电也不丢。WAL(预写日志)保证的,你不用管细节,但要知道"提交返回成功"之后数据就是安全的。
隔离级别:你要选的其实只有两个
SQL 标准定义了四个隔离级别,区别在于允许出现哪些"并发异常":
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| 读未提交(Read Uncommitted) | 可能 | 可能 | 可能 |
| 读已提交(Read Committed) | 不可能 | 可能 | 可能 |
| 可重复读(Repeatable Read) | 不可能 | 不可能 | 标准允许,PG/MySQL 实际防住* |
| 可串行化(Serializable) | 不可能 | 不可能 | 不可能 |
*号展开说一句,因为这是面试和实战都常踩的坑:标准说可重复读允许幻读,但 PostgreSQL 的可重复读用的是快照隔离,同一个事务里看到的是事务开始时的一致快照,基本碰不到幻读;MySQL InnoDB 的可重复读用 next-key lock(间隙锁)防幻读。两家都比标准更严格,但实现方式不同。Postgres 的可串行化用的是 SSI(可串行化快照隔离),冲突时会直接报错 40001 serialization_failure,你的代码必须 catch 住重试——这是用可串行化的代价。
选型建议(Postgres 方言,一人团队版):
- 默认不动:Postgres 默认就是读已提交(Read Committed),对 95% 的 vibe 项目够用。脏读已经被防住了,剩下的并发问题用锁和幂等键解决,比调隔离级别更精准。
- 报表/对账类读事务:用可重复读。一个事务里多次 SELECT 看到的数据完全一致,不会被中途提交的写操作搅乱。credits 账本篇里的对账查询就是典型场景。
- 别轻易用可串行化:它把"判断能不能串行"的工作推给了运行时,冲突就抛 40001 让你重试。写对重试逻辑的成本,比直接用行锁更高。除非你的业务真的要求"结果等价于某种串行执行"(比如复杂的资金清算),否则行锁 + 幂等键的组合更可控。
- 读未提交:Postgres 里它和读已提交行为一样(PG 根本没实现真·读未提交),MySQL 里允许脏读。结论:别用。
一句话总结:隔离级别管的是"读到什么",锁管的是"谁先写"。超卖、double-spend 这类"写写冲突",靠隔离级别是防不住的(读已提交下两个事务照样能同时读到 stock=1),必须上锁。这就是下一节的内容。
三、乐观锁 vs 悲观锁:两种"谁先写"的答案
两个事务要改同一行,数据库必须决定谁先谁后。两种哲学:
- 悲观锁:"冲突一定会发生,我先把行锁住再说。" 用
SELECT ... FOR UPDATE给行加排他锁,别人想改这行就排队等。冲突高时最稳,但锁住的期间别人都在等,吞吐下来了;锁拿得不好还会死锁。 - 乐观锁:"冲突很少发生,先各改各的,提交时检查。" 给表加一个
version列(整数,每次更新 +1)。更新时带上WHERE id = ? AND version = ?,如果返回"命中 0 行",说明有人先改了,重读再试。无锁,吞吐高,但冲突高时重试 storm 会把 CPU 打满。
乐观锁实战:version 列(SQL 方言)
先看最底层的 SQL 长什么样,理解了它,ORM 的写法都只是语法糖:
-- 表结构:多一个 version 列,默认 0
ALTER TABLE products ADD COLUMN version INTEGER NOT NULL DEFAULT 0;

-- 业务代码:读出 (stock, version) = (1, 7),算好新库存 0,然后:
UPDATE products
SET stock = 0, version = version + 1
WHERE id = 'sku-123' AND version = 7;
-- 返回"命中 1 行" → 成功;"命中 0 行" → 有人先改了,重读重试关键点:检查和更新在同一条语句里,这条语句本身是原子的,缝被焊死了。注意 version = version + 1 必须写在 SET 里让数据库自己加,不能在代码里算好 version = 8 传进去——后者在极端交错下仍可能 ABA(虽然概率极低,但"让数据库算"是零成本的正确)。
悲观锁实战:SELECT FOR UPDATE(SQL 方言)
BEGIN;
-- 锁住这一行:其他事务想改它(或也 FOR UPDATE 它)就排队等
SELECT stock FROM products WHERE id = 'sku-123' FOR UPDATE;

-- 在代码里判断库存够不够,然后扣减
UPDATE products SET stock = stock - 1 WHERE id = 'sku-123';
COMMIT;  -- 锁在这里释放
三条铁律,违反任何一条都会出事:
- 锁必须在事务里拿:
FOR UPDATE的锁在事务提交/回滚时释放。如果你的框架是自动提交模式(每条语句一个事务),锁刚拿到就释放了,等于没锁。 - 事务必须短:从 BEGIN 到 COMMIT 之间不要调外部 API、不要等用户输入。锁住的行会阻塞所有想改它的请求,一个慢事务能把整张表拖成串行。
- WHERE 必须走索引:
WHERE id = ?走主键索引,只锁一行;如果 WHERE 没走索引,Postgres 会退化成锁全表(甚至触发表级锁),并发直接归零,还容易死锁。
Prisma 实战(方言:Prisma + PostgreSQL)
Prisma 有两种武器,对应两种场景。先说最简单的:纯计数器扣减,直接用原子操作,连事务都不用开:
// 方言:Prisma Client。decrement 是原子操作,数据库自己算,无竞态
await prisma.product.update({
  where: { id: "sku-123" },
  data: { stock: { decrement: 1 } },
});
但"先判断够不够、再扣"需要读-改-写,就得上事务。Prisma 的交互式事务写法:
// 方言:Prisma。注意:交互式事务要求连接支持会话语义,
// PgBouncer 的 transaction pooling 模式下每个查询可能落到不同连接,
// 会报事务错误 —— 用直连或 PgBouncer session 模式(Supabase 可选 session 池)
const order = await prisma.$transaction(async (tx) => {
  // 悲观锁:Prisma 没有 FOR UPDATE 的原生 API,用 $queryRaw 透传 SQL
  const rows = await tx.$queryRaw<{ stock: number }[]>`
    SELECT stock FROM "Product" WHERE id = ${productId} FOR UPDATE`;
  if (rows[0].stock < qty) throw new Error("OUT_OF_STOCK");

  await tx.product.update({
    where: { id: productId },
    data: { stock: { decrement: qty } },
  });
  return tx.order.create({ data: { productId, qty } });
}, {
  maxWait: 5000,   // 等连接池的最长等待
  timeout: 10000,  // 事务整体超时:防止慢事务长期占锁
});
乐观锁在 Prisma 里长这样,注意用 updateMany 才能拿到"命中行数":
// 方言:Prisma。update 返回实体但不告诉你是否命中 WHERE 的 version 条件,
// updateMany 返回 { count },count === 0 即版本冲突
async function decrementStockOptimistic(productId: string, qty: number, retries = 3) {
  for (let i = 0; i < retries; i++) {
    const p = await prisma.product.findUniqueOrThrow({ where: { id: productId } });
    if (p.stock < qty) throw new Error("OUT_OF_STOCK");
    const r = await prisma.product.updateMany({
      where: { id: productId, version: p.version },  // 版本对上才更新
      data: { stock: p.stock - qty, version: { increment: 1 } },
    });
    if (r.count === 1) return;           // 成功
    // count === 0:有人先改了,重读重试
  }
  throw new Error("STOCK_CONFLICT_RETRY_EXHAUSTED");
}
Drizzle 实战(方言:Drizzle ORM + PostgreSQL)
Drizzle 对 SQL 的贴合度更高,for("update") 就是 FOR UPDATE 的直译:
// 方言:Drizzle ORM。db.transaction 回调抛异常即回滚
import { eq, sql } from "drizzle-orm";

await db.transaction(async (tx) => {
  // SELECT ... FOR UPDATE:行级排他锁
  const [row] = await tx
    .select({ stock: products.stock })
    .from(products)
    .where(eq(products.id, productId))
    .for("update");
  if (!row || row.stock < qty) throw new Error("OUT_OF_STOCK");

  // 让数据库自己做减法:原子,无竞态
  await tx
    .update(products)
    .set({ stock: sql`${products.stock} - ${qty}` })
    .where(eq(products.id, productId));

  await tx.insert(orders).values({ productId, qty });
});
乐观锁版本同样直白:
// 方言:Drizzle ORM
const [p] = await db.select().from(products).where(eq(products.id, productId));
if (p.stock < qty) throw new Error("OUT_OF_STOCK");
const updated = await db
  .update(products)
  .set({ stock: p.stock - qty, version: sql`${products.version} + 1` })
  .where(eq(products.id, productId).and(eq(products.version, p.version)));
// Drizzle 的 update 不直接返回命中行数:
// 用 .returning({ id: products.id }),返回空数组即版本冲突,重读重试
怎么选:三条经验法则
- 读多写少、冲突罕见(如用户改个人资料、后台改商品标题):乐观锁。无锁开销,代码多几行重试逻辑即可。
- 写冲突频繁、但不是热点(如普通商品下单、优惠券领取):悲观锁
FOR UPDATE+ 短事务。重试 storm 比排队更伤。 - 单行被疯狂写(秒杀库存、全局计数器、排行榜):两种锁都不够,锁竞争本身会成为瓶颈。看第五节:队列串行化。
还有一个新手常问的:"我直接把隔离级别调到可串行化,是不是就不用锁了?" 答案是:能防,但代价是运行时抛 40001 让你重试——你省掉了写锁代码,却要写重试代码,还要处理"重试时外部 API 被调了两次"的副作用(发短信、调支付网关都不能重放)。锁是"排队",可串行化是"撞了再退回去重来",后者通常更贵。
四、幂等键:防的是"同一个请求来了两次"
锁解决的是"两个不同的请求同时写",幂等键解决的是"同一个请求被执行了两次":用户连点提交、浏览器重发 POST、支付网关的 webhook 重试、你自己的失败重试。credits 账本篇里"幂等扣减"那节是这套思想在扣费场景的落地,这里给通用版。
核心机制就一句话:给每个写操作配一个客户端生成的唯一键,数据库用唯一约束保证它只被执行一次。
-- 方言:PostgreSQL。key 是主键 = 天然唯一约束,冲突即"执行过"
CREATE TABLE idempotency_keys (
  key        TEXT PRIMARY KEY,
  status     TEXT NOT NULL,            -- processing | succeeded | failed
  response   JSONB,                    -- 成功时的响应快照:重放时直接返回
  created_at TIMESTAMPTZ NOT NULL DEFAULT now()
);
// 方言:TypeScript + Postgres。先 INSERT 抢键,抢到才执行,抢不到读快照返回
async function idempotent<T>(key: string, fn: () => Promise<T>): Promise<T> {
// 1. 尝试占位:ON CONFLICT DO NOTHING,原子
const inserted = await db`
INSERT INTO idempotency_keys (key, status) VALUES (${key}, 'processing')
ON CONFLICT (key) DO NOTHING RETURNING key`;
if (inserted.length === 0) {
// 2. 键已存在:等它完成(轮询或 LISTEN/NOTIFY),然后返回存档的响应
const rec = await waitForDone(key);
if (rec.status === "succeeded") return rec.response as T;
throw new Error("IDEMPOTENT_RETRY_OF_FAILED");
}
try {
// 3. 只有抢到键的进程执行真正的业务
const result = await fn();
await db`UPDATE idempotency_keys
SET status = 'succeeded', response = ${JSON.stringify(result)}::jsonb
WHERE key = ${key}`;
return result;
} catch (e) {
await db`UPDATE idempotency_keys SET status = 'failed' WHERE key = ${key}`;
throw e;
}
}
// 调用方:key 由客户端生成(如下单按钮点击时 uuid),随请求传进来
await idempotent(`order:${clientRequestId}`, () => createOrder(...));几个实战细节:
- key 必须由客户端生成:服务端生成的 key 防不住"请求没发出去、客户端重试"的情况。前端在点击瞬间生成 uuid,放在请求头(如
Idempotency-Key,Stripe 就是这么设计的)或请求体里。 - "先查后插"有竞态:不要写成"先 SELECT 看看 key 在不在,不在再 INSERT"——两个并发请求会同时看到"不在",然后都执行。必须用
INSERT ... ON CONFLICT DO NOTHING让唯一约束做仲裁,约束冲突本身就是原子的。 - status 要区分 processing/succeeded/failed:第二个请求到达时,第一个可能还在执行。读到 processing 就等待(短轮询或 Postgres 的 LISTEN/NOTIFY),不要直接报错,也不要再执行一次。
- key 要有 TTL:幂等表会无限膨胀。按业务定保留期(订单 24 小时、支付 7 天),过期 key 允许复用或归档删除。
- 幂等键和锁正交:幂等键防重放,锁防并发写。一个下单接口里,幂等键包在最外层(防重复提交),事务+行锁包在里面(防超卖)。图 2 最下面那条"可叠加"就是这个意思。
五、热点行:当锁本身成为瓶颈
秒杀开始的 10 秒,10 万人同时抢 500 件库存。就算用了 FOR UPDATE,所有请求也在同一行上排队:锁等待把连接池占满,超时、重试、再超时,数据库被"排队的人群"踩死。这叫热点行(hot row)问题,解法不是"更好的锁",而是"不要并发写"——用队列把并发写变成串行写。
架构很简单:写请求先进队列(Redis Stream / BullMQ / 云厂商的队列服务),单个消费者按顺序一条一条扣减。因为同一时刻只有一个写者在碰那行数据,竞态从根上消失了。
// 方言:TypeScript + BullMQ(Redis 队列)。生产者:只管入队,立刻返回"排队中"
import { Queue } from "bullmq";
const orderQueue = new Queue("seckill", { connection: redis });

// 接口层:校验参数 → 入队 → 返回排队状态(不要在这里碰数据库库存行)
await orderQueue.add("deduct", { productId, userId, qty, idempotencyKey });

// 消费者:单并发,按顺序执行,里面用事务+行锁(此时已无竞争,锁只是兜底)
import { Worker } from "bullmq";
new Worker("seckill", async (job) => {
  await idempotent(job.data.idempotencyKey, () =>
    deductStockInTransaction(job.data)   // 第三节的事务代码,原样复用
  );
}, { connection: redis, concurrency: 1 });  // 关键:热点 key 的消费者并发为 1
但要注意队列不是银弹,它把问题从"数据库锁"转移到了三个新地方:
- 队列本身的顺序保证:Redis Stream 的消费者组是多消费者分片的,热点 key 必须路由到同一个消费者(按 key hash 分区,或像上面一样单消费者)。BullMQ 默认是竞争消费,热点场景要显式控制并发。
- 用户体验变成异步:"下单"不再是同步返回成功,而是"已排队,请稍后查询结果"。前端要做轮询或 WebSocket 推送结果,这是产品层面的取舍。
- 简单的计数器别上队列:如果只是"点赞数 +1"这种不需要先读后判断的场景,
UPDATE ... SET likes = likes + 1单条语句就是原子的,或者 RedisINCRBY(单线程,原子),根本不需要队列。队列是给"先判断、再扣减"的热点流程准备的。
六、死锁、锁超时与重试:锁的阴暗面
上了锁,就要面对锁的三个阴暗面。AI 生成的代码几乎从不处理它们,而线上事故的另一半来自这里。
死锁:两个事务互相等对方
事务 A 锁了行 1、想锁行 2;事务 B 锁了行 2、想锁行 1。互相等待,永远等下去。Postgres 会检测到并主动杀掉其中一个(报错 40P01 deadlock_detected),MySQL 同理。防死锁只有一招:所有事务按相同的顺序加锁。比如批量扣减多件商品时,先把商品 id 排序再逐行 FOR UPDATE,两个事务的加锁顺序一致,就死锁不起来。这是代码规范问题,写进团队的 checklist。
锁超时:别让一个慢查询拖死所有人
默认情况下,被阻塞的事务会一直等,等到天荒地老(并占着连接池的连接)。给等待加个上限:
-- 方言:PostgreSQL。会话级设置:等锁超过 3 秒就报错,而不是无限等
SET lock_timeout = '3s';
-- 语句级设置:整个事务超过 10 秒还没提交就回滚(防慢事务长期占锁)
SET statement_timeout = '10s';
Prisma 的 $transaction({ timeout }) 和 Drizzle 的事务对应的是 statement 级别的超时思想。原则:锁的等待时间必须有上限,超时的请求快速失败、让用户重试,比整个服务被拖死好一万倍。
重试:哪些错值得重试
不是所有错误都能重试。白名单很短,记死它:
- 可重试:
40001(序列化失败,PG 可串行化)、40P01(死锁,被杀的那个)、55P03(锁超时)、乐观锁的版本冲突(count=0)。重试前加抖动退避(100ms、200ms、400ms…随机抖一下,避免所有重试又撞到一起)。 - 不可重试:唯一约束冲突(
23505,数据问题,重试 100 次也一样)、OUT_OF_STOCK这类业务校验失败、任何已经执行了外部副作用的操作(发了短信、调了支付)——重试它们等于重复副作用,这类操作必须包在幂等键里(第四节)。
七、一人团队的落地清单
理论讲完了,落到你今晚就能改的代码上。按优先级排序:
- 先给所有"先查后改"的接口加测试:写个脚本并发 50 次调你的下单/扣费接口,看库存会不会变负、余额会不会 double-spend。先复现,再修。没复现过的并发问题,修了也不知道修没修对。
- 纯计数器用原子操作:Prisma 的
decrement/increment、SQL 的SET x = x - 1、Redis 的DECRBY。一行代码,零竞态。 - "判断再扣"用事务 + 行锁:
FOR UPDATE+ 短事务 + WHERE 走索引。Prisma 用$transaction+$queryRaw,Drizzle 用.for("update")。 - 所有写接口加幂等键:key 客户端生成,
INSERT ... ON CONFLICT DO NOTHING仲裁,status 分 processing/succeeded/failed,key 设 TTL。 - 热点行走队列:秒杀、全局计数器这类单行高频写,入队串行化,消费者并发按 key 控制为 1,前端改成异步查询结果。
- 锁加规范:多行加锁先排序防死锁;
lock_timeout和事务超时必须设;重试只重试白名单错误,带抖动退避。 - 隔离级别默认不动:Postgres 读已提交够用;对账类读用可重复读;可串行化是最后手段。
最后回扣一下开头:AI 写代码快,但它默认活在"一次只有一个用户"的真空里。并发控制是把你的 vibe 项目从"demo 能跑"推向"线上敢卖"的分水岭——库存、余额、订单这三样东西,错一单都是真金白银。下次 AI 给你生成"先 SELECT 再 UPDATE"的代码时,你就知道缺的那几行应该长什么样了。
评论 (0)
相关文章
项目上线后 API 的 p99 从 300ms 涨到 3 秒,问题八成在数据库。本文给你一套闭环打法:用 pg_stat_statements 揪出真凶、5 分钟读懂 EXPLAIN、按查询模式选 B-tree/GIN/BRIN/部分索引/覆盖索引、避开 AI 代码的 6 个经典慢查询坑,再用 CREATE INDEX CONCURRENTLY 安全上线。每周 15 分钟巡检清单附后。
头像存在 ./uploads 里,上线第一周就翻车?本文讲预签名 URL 直传、公开/私有/图片变体三种存法、R2 零流出费选型,以及孤儿文件清理、环境隔离、存量迁移的全套实战,附上线 checklist。
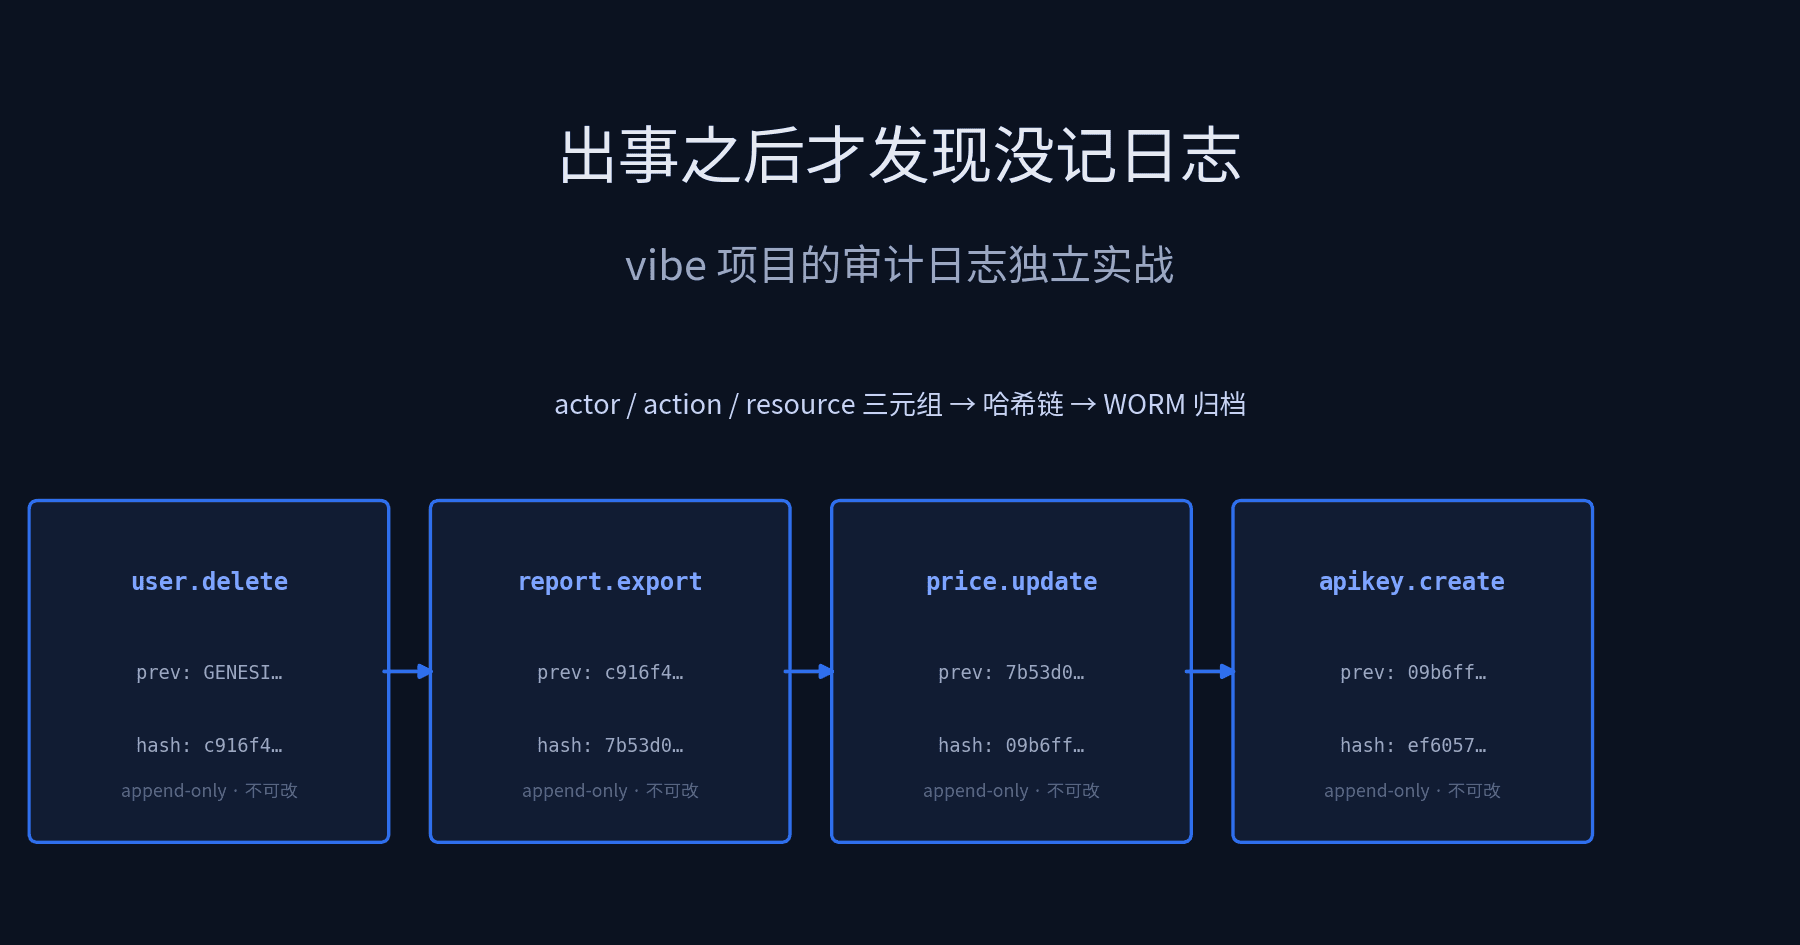
审计日志≠业务日志≠运维日志。本文是审计日志独立实战:actor/action/resource 三元组数据模型、哈希链+WORM 不可变存储、“谁删了数据/谁导出了报表/谁改了价格”三类取证查询、删除权 vs 审计留存的法务平衡,以及一人团队一个下午能落地的最小实现(中间件+归档脚本,附可运行代码)。